

Измерения: размерности, свойства и иерархии
Измерения являются контекстной опорой для фактов в витрине данных. Их задача - описать бизнес-объекты и события так, чтобы аналитика и визуализация давали понятные и воспроизводимые выводы. В рамках этой главы мы рассмотрим, как правильно проектировать размерности, какие свойства и ограничения им присущи, какую роль играют иерархии в агрегациях и анализе, а также как управлять изменениями в размерностях по мере эволюции бизнес-процессов. В технической модели мы сосредоточимся на архитектуре, схемах, алгоритмах и протоколах интеграции, чтобы обеспечить воспроизводимость и качество витрины.
Размерности - это не просто набор атрибутов. Это семантический слой, который задаёт гранулярность фактов, поддерживает эффективные агрегации и обеспечивает устойчивость к изменениям бизнеса. Важной темой является разделение естественных ключей и суррогатных ключей, а также грамотная реализация изменений размерностей через SCD (Slowly Changing Dimensions) и связанные паттерны. Глубже explored будет вопрос проектирования иерархий - как организовать атрибуты так, чтобы пользователи могли легко переходить от общего к детализированному, выполнять drill-down и roll-up, а системы витрины могли выполнять быстрые агрегации и оптимизированные запросы.
Краткое содержание главы
- Роль размерностей в витрине данных, их связь с фактами, гранулярность и семантика атрибутов.
- Типы иерархий размерностей, их характеристики и сценарии использования в агрегациях.
- Управление изменениями размерностей: суррогатные ключи, SCD, паттерны реализации и влияние на производительность.
- Архитектура витрины: схемы и принципы интеграции размерностей в Star и Snowflake, а также роли CDC и ELT.
- Практические рекомендации по реализации, тестированию и управлению качеством размерностей.
Концепции размерностей: атрибуты, гранулярность и семантика
Размерность представляет собой контекст, в котором факты получают значение. В типовой витрине данных размерности классифицируются по предметной области: время, продукт, клиент, география, организация и т. д. Каждый атрибут размерности несёт смысловую нагрузку: название товара, код клиента, регион продажи, тип канала продаж и пр. Важной характеристикой размерности является гранулярность: она должна соответствовать потребностям анализа и быть согласована с гранулярностью фактов. Неправильная гранулярность приводит к избыточной детализации (нагромождение объемов данных) или, наоборот, к потере аналитического смысла (недостаточная детализация агрегаций).
Сверхважный аспект - разделение бизнес-ключа и суррогатного ключа. Бизнес-ключ (натуральный ключ) - это уникальный идентификатор бизнес-объекта (например, product_id). Он может меняться со временем из-за переименований, изменений кода категорий и переструктурирования бизнеса. Суррогатный ключ представляет собой неизменяемый технический идентификатор (обычно числовой или генерируемый UUID), который позволяет историровать изменения и поддерживать линейную версию размерности. Этим обеспечивается способность хранить историю изменений без риска дублирования и конфликтов на уровне бизнес-ключа.
В рамках технической реализации важно учитыватьSCD и связанные подходы к версиионин размерностей. С точки зрения архитектуры, размерности должны поддерживать:
- идентификацию текущего состояния (is_current);
- временные атрибуты (effective_from, effective_to);
- механизмы обновлений (SCD Type 2 как базовый метод сохранения истории);
- контроль целостности и внешних зависимостей (линии данных к фактам, динамические атрибуты).
Рассматривая интеграцию и схемы витрины, следует помнить: размерности - это не просто таблицы атрибутов, это слой, который формирует контекст и качество анализа. Поэтому проектирование размерностей требует тесного взаимодействия между бизнес-аналитиками, архитекторами данных и инженерами по данным.
Пример проектирования атрибутов размерности можно представить так: для размерности «Продукт» выделяются атрибуты бизнес-ключ (product_id), наименование (product_name), категорию (product_category), подкатегорию (product_subcategory), бренд (brand), а также характеристики, влияющие на аналитические запросы (price_group, color, size). Требование к атрибутам - ясность семантики, неизменность значения в рамках версии, и поддержка истории, когда атрибут изменяет своё значение.
С точки зрения интеграции и протоколов обмена данными важно обеспечить согласованность форматов данных и временных штампов. Рекомендовано использовать стандарт ISO 8601 для временных значений и единые кодировки региональных форматов. CDC (Change Data Capture) становится обычной практикой для инкрементной загрузки размерностей, минимизируя задержки между изменениями источника и витринной модели. При этом важно обеспечить надёжное управление версиями и аудит изменений, чтобы восстановление после сбоев было воспроизводимым.
-- Пример структуры размерности "Продукт" с суррогатным ключом и SCD-2
CREATE TABLE dim_product (
  product_sk BIGINT PRIMARY KEY,
  product_id VARCHAR(50) NOT NULL,
  product_name VARCHAR(200),
  product_category VARCHAR(100),
  product_subcategory VARCHAR(100),
  brand VARCHAR(100),
  color VARCHAR(50),
  size VARCHAR(20),
  effective_from TIMESTAMP WITHOUT TIME ZONE NOT NULL,
  effective_to TIMESTAMP WITHOUT TIME ZONE NOT NULL,
  is_current BOOLEAN NOT NULL,
  -- дополнительный атрибут для проверки изменений
  hash_attrs VARCHAR(64)
);

CREATE SEQUENCE dim_product_sk_seq START WITH 1 INCREMENT BY 1;

-- Индикатор текущей версии
CREATE UNIQUE INDEX ux_dim_product_current ON dim_product(product_id, is_current);
С этим подходом мы отделяем изменение атрибутов от идентификации записей, что обеспечивает совместимость с агрегациями и историческим анализом. Вопрос о стратегии обновления (Type 1, Type 2, Type 3 и т. д.) становится вопросом бизнес-траектории: какие изменения требуют сохранения истории, какие - нет. В большинстве случаев для ключевых размерностей выбирают SCD Type 2, чтобы сохранить полный контекст изменений и не разрушать существующие анализы.
Иерархии размерностей: структура, чистота и использование
Иерархии размерностей определяют, как атрибуты агрегируются и как пользователи переходят от общих понятий к детализированным. С практической точки зрения иерархии бывают:
- уровневые (level-based) - предопределённые уровни и атрибуты, например: Год → Квартал → Месяц → Дата;
- родительско-детские (parent-child) - произвольные деревовидные структуры, например география (страна → регион → город) или сотрудники (руководитель → подчинённый);
- не равномерные иерархии (ragged или unbalanced) - разные узлы имеют разную глубину; это естественно отражает реальные бизнес-модели и требует поддержки в отчетности.
Важно различать полноту и полноту анализа: в некоторых случаях предпочтительна строгая иерархия с фиксированными уровнями (упрощение агрегаций, предсказуемые планы загрузки), в других - гибкая иерархия, которая позволяет отражать реальные случаи без искусственных ограничений. В любом случае иерархии должны поддерживать:
- корректную агрегацию по уровням (roll-up) и детальную разбивку (drill-down);
- корректную обработку пропусков и различий в уровне детализации (ragged hierarchies);
- возможность сохранения исторического контекста при изменении структуры и атрибутов (например, изменение категорий продукта).
Проектирование иерархий требует согласования между бизнес-логикой и технической реализацией. Пример: в размерности «Время» часто реализуют уровни Year → Quarter → Month → Day, что позволяет строить быстрые годовые и квартальные агрегаты, одновременно сохраняя возможность анализа по дням. В географии можно поддерживать как country → region → city, так и более сложные «географические контуры» на уровне клиентов и офисов. Необходимо учитывать влияние на производительность: глубокие иерархии требуют аккуратного индексирования и поддержки агрегаций на уровне БД, а иногда - создание предсчитанных агрегатов (summary tables) для ускорения запросов.
Алгоритмы обхода и агрегации по иерархиям важны как для аналитических пользователей, так и для механизмов ETL/ELT. В системах DIMENSION типичные запросы:
- агрегация по уровню (например, продажи по месяцам);
- drill-down к следующему уровню (к примеру, переход от месяца к конкретному дню);
- roll-up данных вверх по всей иерархии для стратегического анализа.
Рекомендовано проектировать иерархии так, чтобы:
- ключевые уровни определялись явно и поддерживались системой слежения за версиями размерностей;
- существуют согласованные правила агрегации, чтобы пользовательские отчеты и автоматизированные процедуры могли помимо этого работать без дополнительных изменений;
- для non-strict и ragged иерархий предусмотрены средства в слоях представления данных (включая справочные таблицы и представления, которые нормализуют структуру на момент запроса).
-- Пример запроса агрегации продаж по уровню месяца с поддержкой нестрогих иерархий
SELECT
  d.month_key,
  SUM(f.amount) AS total_sales
## FROM fact_sales f
JOIN dim_date d ON f.date_key = d.date_key
GROUP BY d.month_key;
Именно на уровне логического проектирования иерархий формируются возможности удобной навигации пользователей в BI-приложениях, а также позволяют системам управления данными оптимизировать запросы и кэширование агрегатов. В рамках техники важно:
- поддерживать согласованность атрибутов размерности с атрибутами фактов;
- обеспечивать корректную обработку изменений в иерархии без нарушения исторических данных;
- внедрять механизмы валидации и тестирования для проверки корректности агрегаций по вершинам и подуровням.
Суррогатные ключи и управление версиями размерностей: SCD и паттерны
Суррогатные ключи служат символьной изоляцией от бизнеса и позволяют независимо управлять идентичностью размерности и её состояниями. Они необходимы для сохранения истории изменений и поддержки устойчивых связей с фактами. Ключевые концепции включают:
- суррогатный ключ (SK) как уникальный технический идентификатор размерности;
- естественный ключ (NK) - бизнес-ключ, который может изменяться;
- версии и временные интервалы записи (effective_from, effective_to);
- флаг текущей версии (is_current) для упрощения выборки «последней версии».
Наиболее популярные паттерны управления версиями размерностей относятся к SCD (Slowly Changing Dimensions). Основные типы:
- SCD Type 1 - перезапись атрибутов, без сохранения истории; подходит для атрибутов, которым не требуется история.
- SCD Type 2 - добавление новой версии строки при изменении атрибутов; сохраняется история изменений.
- SCD Type 3 - добавление нового атрибута «предыдущего» значения; ограниченная история.
- SCD Type 4 - использование отдельной исторической таблицы для изменений.
- SCD Type 6 - гибридный подход, часто сочетающий элементы Type 1, Type 2 и Type 3.
Из практики следует, что для критически важных размерностей, влияющих на аналитическую гибкость (например, продукт, клиент, география), предпочтителен SCD Type
2. Он сохраняет все версии атрибутов и позволяет восстанавливать траекторию изменений. Однако для менее динамичных атрибутов, где история не нужна или несущественна, можно использовать SCD Type 1 или Type 3.
Алгоритм реализации SCD Type 2 в рамках витрины может быть описан так:
- при поступлении новой версии бизнес-ключа ищется текущая активная запись для данного NK;
- если атрибуты не изменились с момента последнего обновления, ничего не делается;
- если изменились атрибуты, создается новая запись с новым суррогатным ключом, устанавливается effective_from = текущая дата, effective_to = бесконечность (или заданная «практика»), is_current = true;
- существующая запись обновляется: effective_to = текущая дата минус один день, is_current = false.
Для иллюстрации приведён упрощённый SQL-ориентированный сценарий, который демонстрирует логику SCD Type 2 в PostgreSQL-подобной среде. Он не претендует на универсальность, но отражает принцип.
-- Стратегия: staging-модель принимает новые данные; dim_product — текущая версия
-- Шаг 1: загрузить новые данные в staging.dim_product
-- Шаг 2: для каждого бизнес-ключа product_id проверить наличие текущей версии и сравнить атрибуты
-- Шаг 3: если есть изменения, вставить новую версию и пометить старую как историческую

## WITH new AS (
  SELECT s.product_id, s.product_name, s.product_category, s.brand,
         NOW() AS now_ts
  FROM staging.dim_product s
),
old AS (
  SELECT d.product_id, d.product_name, d.product_category, d.brand, d.product_sk
  FROM dim_product d
  WHERE d.is_current = TRUE
)
INSERT INTO dim_product (product_sk, product_id, product_name, product_category, brand,
                         effective_from, effective_to, is_current)
SELECT NEXTVAL('dim_product_sk_seq'), n.product_id, n.product_name, n.product_category, n.brand,
       NOW(), TIMESTAMP '9999-12-31 00:00:00', TRUE
## FROM new n
JOIN old o ON n.product_id = o.product_id
## WHERE n.product_name  o.product_name
   OR n.product_category  o.product_category
   OR n.brand  o.brand;

## UPDATE dim_product
SET effective_to = NOW() - INTERVAL '1 second', is_current = FALSE
WHERE is_current = TRUE
  AND EXISTS (
## SELECT 1 FROM new n
## WHERE n.product_id = dim_product.product_id
## AND (n.product_name  dim_product.product_name
           OR n.product_category  dim_product.product_category
           OR n.brand  dim_product.brand)
  );
Важной частью является обеспечение целостности между размерностью и фактами. При изменении версии размерности на текущий момент факт-таблицы сохраняют свои ссылки на суррогатный ключ, что обеспечивает точную связь между контекстом и событиями. Архитектура должна поддерживать idempotent-операции: повторная загрузка одних и тех же данных не должна приводить к дублированию версий или несогласованности.
С учётом практик аналитики и реальных сценариев следует помнить:
- длина жизни версии и период времени должны быть понятны пользователям и документированы в метаданных;
- выбор между SCD Type 2 и альтернативами определяется частотой изменений в атрибутах и требованиями к анализу;
- переход на потоковую загрузку (CDC) требует аккуратного проектирования, чтобы не пропустить пропусков и поддержать корректные версии.
Яркое преимущество SCD Type 2 - возможность обеспечить когда нужно полную историческую правдоподобность и корректные временные контекстные запросы. Но это требует дополнительных условий по качеству данных, управлению версиями и мониторингу процессов загрузки.
Архитектура витрины: схемы, протоколы и интеграции
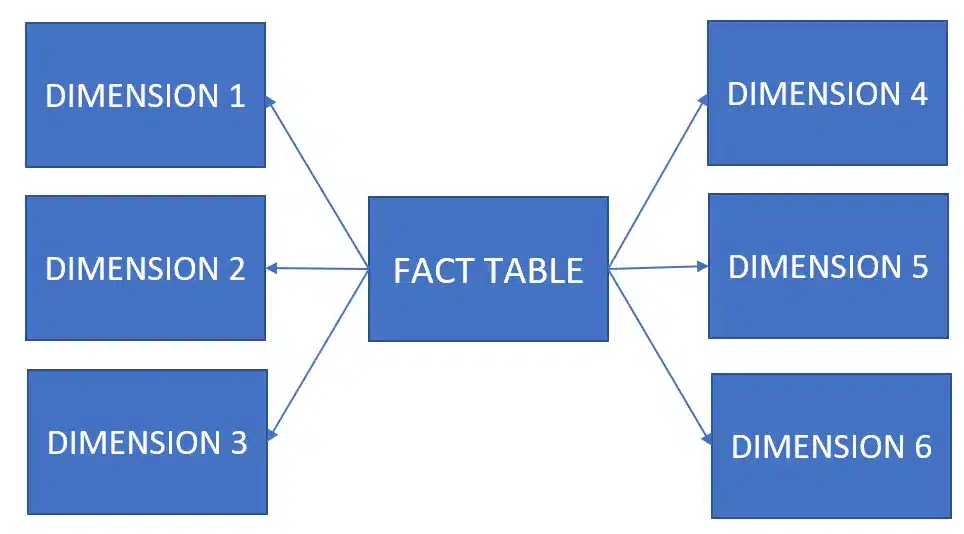
Проектирование витрины данных требует взвешенного выбора схемы и организации загрузки размерностей в связке со схемой фактов. Две основополагающие схемы - Star и Snowflake - предоставляют разные компромиссы между простотой запросов, нормализацией данных и степенью повторного использования атрибутов.
- Star-схема характеризуется денормализованными размерностями: факт-таблица соединяется напрямую с размерностями без дополнительных связей. Это упрощает SQL-запросы и может привести к более быстрым отвеченным запросам, особенно на больших объёмах данных и при необходимости быстрого отображения на дэшбордах. Однако размерности могут дублировать данные и иметь меньшее нормирование.
- Snowflake-схема нормализует размерности за счёт дополнительной нормализации - размерности разбиваются на подтаблицы, что снижает избыточность, облегчает консистентность атрибутов и обеспечивает гибкость в управлении, но усложняет SQL-запросы и может снизить производительность без правильной индексации и кэширования.
В реальных проектах часто применяют гибридный подход: критически важные размерности сохраняют в денормализованном виде в Star-образной форме, остальные атрибуты - в нормализованных подтаблицах Snowflake. Такой баланс обеспечивает оптимальный компромисс между производительностью и управляемостью.
Ключевые элементы архитектуры витрины данных:
- архитектура загрузки: ETL или ELT с поддержкой инкрементных загрузок через CDC; важно обеспечить идемпотентность и корректную обработку повторных событий.
- управление метаданными: поддержка дата-словарей, линейки данных, версий размерностей, документации соответствий между NK и SK и бизнес-ключами.
- управление качеством данных: валидаторы на этапе загрузки, проверки целостности и полноты, тесты репликации и контроль изменений.
- контракты данных и обмен сообщениями: стандарты форматов, расписания загрузки, устойчивость к сбоям и совместимость версий.
- инфраструктура и платформа: выбор платформы базы данных (например, PostgreSQL), использование инструментов ELT/BI (dbt как инструмент оркестрации трансформаций), развертывание в облаке и поддержка сценарием реального времени.
Потребности интеграции дана в нескольких направлениях:
- управление изменениями и CDC-каналы: изменения из источников, например ERP или CRM, в режиме непрерывности или по расписанию;
- согласование временных рамок: атрибуты размерностей задают временные контекстные рамки, которые должны совпадать с бизнес-временем в отчётах;
- единая идентификация: суррогатные ключи должны оставаться константными на протяжении времени, даже если NK меняется.
Практические технические моменты включают в себя:
- выбор подхода к загрузке (ETL против ELT) и организация «staging»-слоя для минимизации рисков;
- индексацию размерностей и факт-таблиц для ускорения запросов;
- использование кэширования и агрегатов на уровне хранения или слоя BI;
- управление изменениями в иерархиях и атрибутах без потери совместимости исторических данных.
Ниже приводится ориентир к реализации на примере популярной архитектуры: использование Star-схемы с CDC-потоком и ELT-процессами на базе базы данных, поддерживающей полноценные транзакции и MERGE-операции (например, PostgreSQL 15+ или Snowflake). В качестве инструментов интеграции можно упомянуть dbt как слой трансформаций и orchestrator для планирования загрузок.
-- Пример MERGE-процедуры для инкрементной загрузки размерностей
MERGE INTO dim_product AS d
## USING staging.dim_product AS s
ON d.product_id = s.product_id AND d.is_current = TRUE
WHEN MATCHED AND (
  d.product_name  s.product_name OR
  d.product_category  s.product_category OR
  d.brand  s.brand
)
THEN
  UPDATE SET effective_to = CURRENT_DATE - INTERVAL '1 day', is_current = FALSE
## WHEN NOT MATCHED THEN
  INSERT (product_sk, product_id, product_name, product_category, brand,
          effective_from, effective_to, is_current)
  VALUES (NEXTVAL('dim_product_sk_seq'), s.product_id, s.product_name, s.product_category,
          s.brand, CURRENT_DATE, '9999-12-31', TRUE);
Для обеспечения корректности интеграции и устойчивости к сбоям важно:
- реализовать idempotent-загрузку: повторная загрузка не должна приводить к дублированию версий;
- использовать транзакции и точку восстановления (checkpointing) на этапах загрузки;
- внедрить мониторинг загрузок и автоматические тесты качества данных;
- документировать контракты и схемы соответствий между источниками и витриной.
На уровне инструментов можно упомянуть следующие подходы:
- PostgreSQL как база данных для прототипирования и референсной реализации;
- dbt как инструмент трансформации и контроля качества моделей размерностей и фактов;
- Apache Spark или аналогичные движки для больших массивов данных и сложных трансформаций со скоростью реального времени.
В рамках открытых технологий и российских практик можно упомянуть ограниченное число примеров: PostgreSQL и dbt хорошо известны и широко применяются в отраслевых проектах, в том числе в российской экосистеме, где они обеспечивают гибкость и контроль над процессами трансформации и качеством данных.
Реализация и операционная практика: процессы, тестирование и управление изменениями
Реализация размерностей требует комплексного подхода к процессам, архитектуре, качеству данных и управлению изменениями. В этом разделе рассматриваются практики, которые обеспечивают надёжность витрины данных и позволяют бизнесу регулярно получать точный контекст для аналитики.
- Инжиниринг данных и интеграции: организация staging-слоя, каналы CDC, планирование загрузок и выдерживание единых временных рамок. Важно обеспечить одномоментную доступность версий размерностей для аналитиков и корректное обновление фактов в связке с текущими версиями размерностей.
- Управление качеством данных: набор правил валидации атрибутов (типы данных, диапазоны значений, уникальность NK), тесты целостности связей между размерностями и фактами, а также проверки на «слепляющие» несоответствия между текущими версиями размерностей и их историческими данными.
- Метаданные и управление версиями: документация словаря данных, линейка изменений (data lineage), версии моделей и атрибутов, требования к сохранению истории. Необходимо обеспечить доступ к метаданным для аналитиков и разработчиков.
- Governance и безопасность: контроль доступа к размерностям, управление правами на обновления и просмотр, аудит запросов и изменений, чтобы соблюсти требования регуляторики и корпоративной политики.
- Практики тестирования и выпуска: автоматические тесты на корректность SCD-типов, на соответствие атрибутам и иерархиям; деплой через повторяемые пайплайны; мониторинг задержек и ошибок.
- Архитектурная устойчивость: проектирование под рост объёмов и изменений бизнес-процессов, поддержка горизонтального масштабирования и резервирования.
В рамках реализации размерностей, упор делают на подходах к тестированию и верификации: тесты должны проверять не только целостность данных, но и корректность поведения при изменениях в схеме размерностей, в ветках истории и в режимах агрегации. Это критично для обеспечения доверия к витрине.
Практические рекомендации:
- применяйте SCD Type 2 там, где история критична для бизнес-аналитики; используйте Type 1 или Type 3 там, где история не нужна или может быть заменена одной точкой доступа.
- проектируйте размерности с явной поддержкой версий и временных интервалов, чтобы обеспечить корректную агрегацию и анализ.
- реализуйте единый контракт данных между источниками и витриной: форматы, временные штампы, кодировки и политики агрегаций.
- используйте инструменты для управления трансформациями и метаданными (например, dbt для моделей и тестов, и средства мониторинга загрузок и качества данных).
- применяйте оптимизацию производительности: правильно организуйте индексы по NK и SK, глядя на запросы, кэширование результатов и создание агрегатов на уровне слоя витрины.
Key takeaways
- Размерности предоставляют контекст и поддерживают анализ, влияя на агрегацию и восприятие фактов.
- Суррогатные ключи и SCD позволяют сохранять историю изменений и обеспечивают устойчивость витрины к изменениям бизнес-ключей.
- Иерархии размерностей - ключ к эффективным агрегациям и удобной навигации пользователей; они требуют балансирования между жесткостью уровней и гибкостью родственно-детских связей.
- Архитектура витрины должна сочетать Star и Snowflake в зависимости от требований к скорости запросов и консистентности атрибутов.
- Интеграция и операции над размерностями требуют продуманных процессов CDC, ELT/ETL, контроля качества и управляемых метаданных.
- Практическая реализация требует тестирования на уровне альгоритмов SCD, согласования между источниками и витриной и поддержки мониторинга загрузок и изменений.
FAQ
- Что такое размерность в витрине данных и зачем она нужна?
Размерность - это набор атрибутов, который описывает контекст фактов, например время, продукт, клиент и география. Она нужна для анализа по различным грануляциям, позволяет выполнять агрегации и drill-down, а также обеспечивает устойчивость к изменениям бизнес-ключей через суррогатные ключи и версии.
- Чем суррогатный ключ отличается от естественного ключа и почему он важен?
Естественный ключ является бизнес-идентификатором и может изменяться; суррогатный ключ - стабильный технический идентификатор, который не зависит от бизнес-изменений. Это позволяет надежно связывать факты с размерностями и сохранять историю изменений без конфликтов.
- Какие типы SCD наиболее часто встречаются и когда их применять?
Наиболее распространены SCD Type 1 (overwrite без сохранения истории) и Type 2 (создание новой версии записи). Type 2 предпочтителен, когда необходимо сохранить полный контекст изменений и поддерживать точные временные запросы. Type 3 подходит для ограниченной истории через добавление предыдущего значения как отдельного атрибута.
- Как проектировать иерархии размерностей для эффективной аналитики?
Иерархии должны поддерживать как предсказуемую агрегацию по уровням, так и гибкость для неравномерных структур. Явные уровни упрощают агрегацию и визуализацию; родственно-детские и ragged иерархии требуют специальных представлений и тестирования, чтобы корректно обрабатывать drill-down и roll-up.
- Какие архитектурные схемы лучше использовать в витрине: Star или Snowflake?
Star-схема обеспечивает простые запросы и быстрые ответы за счет денормализации. Snowflake - лучшая связность и консистентность, экономит место за счет нормализации. В реальных проектах часто применяют гибрид: критические размерности в Star, более сложные или большие атрибуты - в Snowflake-подтаблицах.
- Какой паттерн лучше для реализации CDC и инкрементной загрузки размерностей?
CDC в сочетании с ELT-пайплайнами - предпочтительная практика для минимизации задержек и сохранения истории. Включение staging-моделей, контроль версий, и идемпотентные обновления снижают риски дублирования и несогласованности.
- Какие практики обеспечивают качество данных в размерностях?
Ключевые практики: проверки целостности связей между размерностями и фактами, тесты на соответствие бизнес-ключей, валидации атрибутов, мониторинг изменений и регламентированные процедуры аудита. Обязательны Metadata и data lineage для прозрачности.
- Какие инструменты чаще всего применяют в технической реализации размерностей?
Обычно применяют PostgreSQL или Snowflake в качестве платформы, dbt для управления трансформациями и тестами, а также инструменты для CDC и оркестрации загрузок. Эти инструменты дают баланс между контролем, производительностью и возможностью масштабирования.
- Как подходить к миграциям размерностей и версий?
Необходимо планировать миграции с сохранением истории и минимизацией простоев. Включают разработку новых версий в staging, тестирование на исторических данных, последовательное переключение версий и документирование изменений в метаданных.
- Что важно помнить при проектировании витрины для больших объемов данных?
Необходимо тщательно проектировать схему, обеспечить эффективное индексирование, поддерживать идемпотентность загрузок, внедрять агрегаты и кэширование, а также организовать мониторинг качества и задержек. Архитектура должна быть адаптивной к росту объема и росту числа атрибутов размерностей без потери производительности.


