

Введение: цели курса и аудитория
В современных организациях витрина данных выступает связующим звеном между бизнес-терминами и техническими источниками данных. Эта глава задаёт рамки курса, формулирует цели обучения и очерчивает аудиторию, для которой данная дисциплина наиболее актуальна. В контексте тематики «Моделирование витрин данных: факты, измерения и семантика» особый акцент делается на архитектуре, схемах, алгоритмах и протоколах интеграции, которые позволяют обеспечить устойчивую эксплуатацию витрины данных в условиях динамичного бизнес-изменения и роста объёма данных.
Цель данного курса состоит в том, чтобы участники приобрели способность конструировать витрины данных, отвечающие требованиям скорости доступа, точности, воспроизводимости и управляемости. В рамках этого курса рассматриваются не только принципы моделирования фактов и измерений, но и механизмы объединения бизнес‑семантики с техническими данными, построения универсального словаря терминов и обеспечения совместимости между различными источниками. В итоге слушатели должны уметь проектировать архитектуру витрины с учётом бизнес-целей, выбирать подходящие модели данных, выстраивать надежные конвейеры обработки и разрабатывать политики качества, управления данными и безопасности.
Аудитория курса формируется вокруг нескольких ролей, чьи задачи пересекаются в рамках проекта по моделированию витрин данных. Во‑первых, это архитекторы данных и инженеры данных, ответственные за проектирование слоёв, выбор моделей и реализацию конвейеров обработки. Во‑вторых, бизнес-аналитики и аналитики данных, которым необходим доступ к понятной бизнес‑семантике и точным метрикам. В‑третьих, владельцы продуктов данных и менеджеры проектов, работающие над дорожной картой внедрения витрины, управлением изменениями и соответствием регуляторным требованиям. В‑четвёртых, специалисты по качеству данных и управлению метаданными, которые обеспечивают устойчивость и прослеживаемость данных от источника до презентации. Наконец, руководители информационной безопасности и соответствия, чья роль заключается в определении политик доступа, защиты персональных данных и аудита.
Для технической аудитории курсанты получают системный взгляд: как архитектурные решения поддерживают бизнес-цели, какие схемы и паттерны применяются на уровне проектирования, какие алгоритмы стоят за обработкой больших объёмов данных, какие протоколы позволяют интегрировать разнородные источники, и как обеспечить надёжность и масштабируемость витрины. Для менеджеров и стейкхолдеров фокус смещается на обоснование инвестиций, оценку риска и практическое планирование реализации: какие этапы работ, какие критерии успеха, какие показатели и как их отслеживать.
Курс выстраивается вокруг трёх взаимосвязанных смысловых осей: (1) архитектура витрины данных и семантика - как организовать слои и обеспечить единое понимание терминов; (2) модели данных и схемы фактов/измерений - как выбирать и проектировать структуры для разных предметных областей; (3) интеграция и операционная практика - как строить конвейеры данных, обеспечивать качество и управлять изменениями. В рамках технической ориентации особое внимание уделяется конкретным архитектурным решениям, схемам, алгоритмам и протоколам интеграции, а при необходимости - примерам кода, иллюстрирующим принципы реализации.
- Краткое содержание главы
- Цели курса, ожидаемые результаты и аудитория
- Роль семантики, словаря терминов и конформированных измерений
- Архитектурные принципы витрины данных и базовые модели данных
- Интеграция данных: конвейеры, CDC, потоковая обработка и качество данных
- Организация внедрения и управление проектами витрины данных
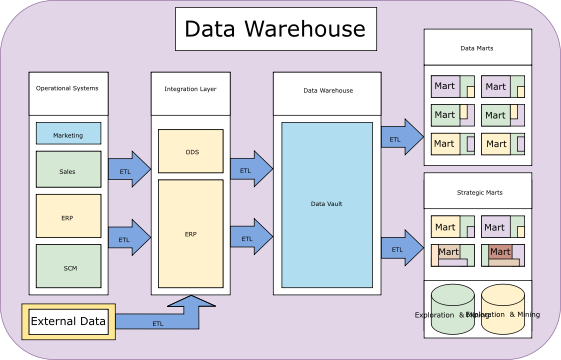
Архитектура витрины данных: слои и семантика
Архитектура витрины данных строится как многослойная система, где каждый слой имеет свои задачи, требования к качеству и темп обработки. В типичной конфигурации можно выделить следующие уровни: суррогатно‑ключевые и референтные данные на стейджинге; сырые данные (raw) для аудита и воспроизводимости; очищенные и согласованные данные (cleansed/conformed); семантический слой, связывающий бизнес‑термины с техническими атрибутами; и слой представления, через который пользователи получают доступ к аналитическим моделям и метрикам. В рамках технической дисциплины важно понимать, как эти слои взаимодействуют, какие требования предъявляются к каждому из них и какие компромиссы возникают при проектировании.
Семантика в витрине данных выступает не только как набор определений, но и как механизм обеспечения согласованности и интерпретации данных. Бизнес‑термины, измерения и правила расчётов должны быть чётко задокументированы в словаре терминов и связаны с конкретными столбцами, таблицами и агрегатами. Роль семантического слоя состоит в том, чтобы устранить фрагментацию, возникающую из-за различий между источниками данных, и обеспечить единое представление metrics, которое однозначно понимается как бизнес‑пользователями, так и системами отчетности.
Разумная архитектура предусматривает хранение версий моделей и метаданных, поддерживающих прослеживаемость: история изменений схем, правила агрегаций, источники данных и контекст рисков. Эффективная витрина требует от архитектора определения политики версионирования, дедупликации данных, обработки изменений схем и устойчивости к сбоям. При проектировании следует учитывать типы источников: транзакционные системы, логи событий, внешние базы данных, облачные хранилища и потоковые каналы. Ключевые паттерны включают разделение слоёв на «базовый» (raw), «очищенный» (trusted/cleansed) и «согласованный» (conformed), а также использование конформированных размерностей и бизнес‑мэппинга в семантическом слое.
Пересечение архитектуры и технологий требует внимательного выбора инструментов и соглашений. Например, для хранения и обработки больших таблиц часто применяются колоночные форматы и оптимизированные движки: Apache Iceberg или Apache Parquet в сочетании с аналитическими движками. Для потребностей временных рядов и быстрых питоновских запросов - распределённые движки и хранилища типа ClickHouse, Snowflake или аналоги в рамках облачных экосистем. В рамках протоколов и интеграций критичны алгоритмы обеспечения идемпотентности и детерминированного поведения конвейеров: повторная обработка данных без дублирования и согласование времени событий. В качестве примера можно привести базовую схему витрины, ориентированную на продажи, с определением фактов и размерностей, а также гласящий о семантике слой, который переводит бизнес‑термины в технические столбцы и вычисления.
CREATE TABLE dim_date (
  date_key INT PRIMARY KEY,
  date DATE,
  year INT, month INT, day INT,
  quarter INT
);

CREATE TABLE dim_product (
  product_key INT PRIMARY KEY,
  product_id VARCHAR(20),
  name VARCHAR(100),
  category VARCHAR(50),
  brand VARCHAR(50)
);

CREATE TABLE dim_store (
  store_key INT PRIMARY KEY,
  store_id VARCHAR(20),
  name VARCHAR(100),
  region VARCHAR(50)
);

CREATE TABLE fact_sales (
  sale_key BIGINT PRIMARY KEY,
  date_key INT REFERENCES dim_date(date_key),
  product_key INT REFERENCES dim_product(product_key),
  store_key INT REFERENCES dim_store(store_key),
  quantity INT,
  amount DECIMAL(18,2),
  discount DECIMAL(5,2)
);
Такой пример иллюстрирует базовую реализацию звезды: факты связываются с конформированными размерностями, что обеспечивает единое определение ключевых терминов на уровне всей витрины. В реальных проектах добавляются дополнительные размерности (customer, channel, campaign) и расширяются таблицы для поддержки агрегаций по временным периодам, сегментации аудитории и сверке метрик.
Модели данных: выбор подхода и принципы проектирования
Моделирование витрин данных опирается на несколько базовых паттернов, каждый из которых имеет свои сильные и слабые стороны в контексте масштабируемости, скорости доступа и управляемости. Прежде всего, доминирующим подходом остаётся денормализация вокруг измерений в рамках так называемой звездчатой схемы (star schema). В ней факты соединяются с конформированными размерностями через ключи, что упрощает запросы и ускоряет агрегации. Однако для некоторых предметных областей применима снежинка (snowflake) - когда размерности нормализованы, что снижает дублирование, но может потребовать более сложных запросов и повышения вычислительной нагрузки.
Альтернативой традиционным схемам является Vault-архитектура в духе Data Vault, ориентированная на масштабируемость в условиях частых изменений источников и необходимости аудита. Data Vault разделяет сущности на Hubs (основные бизнес‑объекты), Links (связи) и Satellites (погружение в контекст изменений). Этот подход хорошо подходит для больших и часто обновляющихся сред, где важна прослеживаемость, гибкость адаптации и возможность независимой эволюции слоёв. В рамках курса рассматриваются сценарии, где выбор подхода обусловлен частотой изменений в источниках, требованиями к истории изменений и степенью консолидации размерностей. Важно помнить: не существует единого «лучшего» решения; оптимальный выбор зависит от предметной области, требований к скорости запроса и организационных факторов, включая степень готовности к управлению семантикой.
Концептуальная семантика витрины - это не только сопоставление слов и столбцов, но и управление единицами измерения, правило формирования метрик и единый контекст для анализа. Следует предусмотреть конформированные измерения, единый смысл единиц измерения и четкие правила агрегаций: как рассчитывается валовая прибыль, как учитываются скидки, как агрегируются временные интервалы. В рамках архитектурной практики особое внимание уделяется совместимости между бизнес‑терминами и данными источников, а также способности семантического слоя предоставлять «перевод» между разными бизнес‑контекстами в рамках единой витрины.
С практической точки зрения ключевые принципы проектирования включают:
- Конформированность размерностей: размерности, представляющие одну и ту же сущность в разных subject areas, должны иметь согласованные версии и правила агрегации.
- Управление версиями метрик и правил расчётов: поддерживать историю изменений формул расчётов и обеспечивать обратную совместимость.
- Баланс между денормализацией и нормализацией: denormalization ускоряет доступ к аналитическим запроcам, normalization снижает избыточность и обеспечивает консистентность.
- Управление временем: поддержка временных версий измеряемых величин и корректная работа с Slowly Changing Dimensions (SCD) для исторических данных.
- Контекст и доверие: формирование бизнес‑контекста через словарь терминов, сопоставления источников и аудит изменений.
С учетом данных принципов архитекторы данных определяют траекторию для внедрения витрины поэтапно: начиная с базовых предметных областей, затем вводят конформированные размерности и расширяют набор фактов, параллельно выстраивая семантику и метаданные. Практические решения должны сопровождаться дорожной картой миграций между текущими источниками и целевой витриной, с учётом рисков консолидации данных и производительности запросов.
Интеграция данных и протоколы обработки: ETL/ELT, CDC, стриминг
Одной из критических задач при проектировании витрины данных является построение надёжного конвейера обработки данных. В техническом контексте важны три взаимосвязанных аспекта: выбор подхода к трансформации данных (ETL vs ELT), методы интеграции изменений источников (CDC) и архитектура обработок в потоковом режиме. ETL (Extract-Transform-Load) и ELT (Extract-Load-Transform) отражают разные подходы к размещению вычислительных затрат. В ETL большая часть трансформаций выполняется до загрузки в витрину, что может снизить нагрузку на целевое хранилище и упростить качество данных на входе, но требует более мощной промежуточной инфраструктуры. В ELT трансформации происходят уже после загрузки в целевое хранилище, что подходит для гибких аналитических сред и может использовать потенциал современных аналитических движков (массивная обработка данных, кэширование, параллельные операции). Выбор подхода следует обосновывать не только производительностью, но и требованиями к прозрачности трансформаций, аудируемости и скорости развертывания.
CDC (Change Data Capture) обеспечивает детекцию и передачу изменений из источников в витрину без повторной загрузки всего набора данных. Это особенно важно для поддержания актуальности фактов и измерений в условиях частых обновлений в операционных системах и логи событий. CDC может работать в сочетании со стримингом: события от источников попадают в потоковую обработку (например, через Apache Kafka или аналогичные брокеры), а затем - в целевое хранилище и семантический слой. В условиях больших потоков данных требуется скоординированное управление временем, порядком обработки и идемпотентностью операций.
Современные конвейеры обработки обычно реализуют сочетание батчевых и стриминговых механизмов: батчевые загрузки применяются для инкрементальной загрузки по запланированным окнам, стриминг - для реального времени и near‑real‑time аналитики. Важной частью архитектуры становится разделение зон ответственности между источниками, агентами инжекции, слоями преобразований и хранилищем. В рамках данного курса рассматриваются сценарии, в которых грамотная реализация протоколов обеспечивает достаточную скорость обновления витрины без ущерба для консистентности и аудируемости.
Для иллюстрации практики интеграции можно рассмотреть следующий кейс: загрузка продаж из операционной системы через CDC в staging, затем через ELT-процессы в конформированные размерности и факт‑таблицу. В качестве примера приведён упрощённый сценарий на SQL и потоках данных. В реальном проекте это дополняется обработкой ошибок, повторной обработкой, мониторингом и инструментами управления качеством.
MERGE INTO dw.fact_sales AS target
USING staging.sales AS source
ON target.sale_key = source.sale_key
WHEN MATCHED THEN UPDATE SET
  target.quantity = source.quantity,
  target.amount = source.amount,
  target.discount = source.discount
WHEN NOT MATCHED THEN INSERT (
  sale_key, date_key, product_key, store_key, quantity, amount, discount
) VALUES (
  source.sale_key, source.date_key, source.product_key, source.store_key,
  source.quantity, source.amount, source.discount
);
Такой фрагмент демонстрирует принцип идемпотентности и корректной синхронизации между источниками и витриной: повторная обработка не приводит к дублированию записей, а обновления вносят актуальные изменения. В реальности алгоритмы будут сопровождаться механизмами контроля времени, проверками целостности и мониторингом задержек конвейера.
Управление качеством данных, метаданными и семантикой
Качественные данные служат основой надёжной аналитики. В рамках витрины данных управление качеством включает определение требований к точности, полноте, консистентности и своевременности данных, а также внедрение процессов мониторинга, тестирования и исправления ошибок. В техническом плане важна интеграция с системами управления метаданными и семантикой, чтобы бизнес‑контекст сохранялся на протяжении всего жизненного цикла данных.
Метаданные играют роль «культурного кода» витрины: они описывают источники, логику трансформаций, правила расчётов и контекст бизнес-терминов. В рамках практики рекомендуется использовать централизованный словарь терминов и сопоставления, создавая единый контекст для аналитиков и пользователей. Для обеспечения прослеживаемости и аудита применяются подходы к версионированию моделей, отслеживанию изменений схем, бизнес‑правил и источников. Для этого применяются открытые и индустриальные решения: Amundsen и Apache Atlas - примеры metadata‑акадём, поддерживающие поиск, линейность и lineage; dbt - инструмент моделирования и документации, помогающий держать документацию в актуальном состоянии и автоматически связывать бизнес‑термины с техническими объектами.
Семантика витрины данных - это мост между бизнес‑терминами и данными. Наличие бизнес‑словаря, конформированных мер и единых версий измерений позволяет аналитикам формировать сопоставления между различными источниками и предметными областями. Важны правила согласования единиц измерения, валют, временных шкал, и единиц валютных курсов, чтобы агрегаты оставались сопоставимыми на протяжении горизонтов сравнения. В рамках архитектуры следует внедрять процедуры тестирования и валидации, включая тесты на согласованность фактов и размерностей, и автоматическую проверку соответствий между семантикой и данными источников.
Практические инструменты и подходы: для каталогизации и поиска метаданных применяются открытые решения, такие как Amundsen или Apache Atlas, которые улучшают видимость и доступность данных. Для документирования моделей и вычислений - dbt, предоставляющий механизм документации и тестирования моделей. Важно сочетать данные инструменты с корпоративной политикой управления данными и соответствия требованиям регуляторов. В этом контексте роль методологий управления качеством данных, бизнес-правил и линейности становится не менее значимой, чем техническая реализация конвейеров и моделей данных.
Внедрение и эксплуатация: управление проектами, команды, риски
Переход к витрине данных - это не только техническая реализация. Это организационный процесс, требующий формализации ролей, процессов и управления изменениями. В рамках этого раздела выделяются ключевые компоненты: роли и ответственности, этапы внедрения, принципы управления изменениями и мониторинга, а также риски и способы их минимизации.
Роли в проекте включают: data architect, data engineer, data modeller, data steward, analytics translator, product owner и security/compliance officer. Каждый член команды вносит вклад в конкретные артефакты: архитектурные решения, схемы данных, правила семантики, тесты качества, документацию и управление безопасностью. Управление изменениями - это систематический подход к планированию, внедрению и оценке изменений в источниках, моделях и правилах. Этапы внедрения следует строить по спринтам, с целью быстрых пилотных витрин, перехода к расширению и - при необходимости - масштабированию.
Операционная сторона включает мониторинг производительности конвейеров, качество данных и доступность витрины. Важно внедрять процессы аварийного восстановления, тестирования на проникновение и контроль доступа, а также обеспечение соблюдения регуляторных требований и принципов минимизации доступа. В рамках технического содержания нами рассматриваются вопросы устойчивости и производительности: выбор правильной платформы хранения, оптимизация запросов, кэширование и индексовая стратегия, а также баланс между затратами и скоростью анализа.
Наконец, на этапе внедрения важна стратегия быстрого выигрыша: определить ограниченное число предметных областей для пилотирования, сформировать дорожную карту и оценить бизнес‑пользовательский отклик. Это позволяет собрать раннюю обратную связь, внести коррективы в семантику и архитектуру и затем масштабировать витрину по мере роста объёма данных и требований бизнес‑пользователей. В рамках методологии проекта следует уделять внимание управлению рисками: рискам несоответствий между источниками, задержкам конвейеров, сложности миграций и требованиям к безопасности. Наконец, следует фиксировать уроки и формировать культуру совместной разработки и непрерывного улучшения.
Key takeaways
- Витрина данных представляет собой многоуровневую архитектуру, в которой бизнес‑семантика и технические данные интегрируются через слои от raw до semantic, обеспечивая единый контекст для анализа.
- Моделирование ориентировано на факты и измерения с использованием паттернов звездчатой схемы, снежинки или Data Vault, в зависимости от частоты изменений источников и требований к аудиту.
- Семантика и словарь терминов необходимы для единообразного восприятия метрик и расчётов, что достигается через конформированные размерности, управление версиями правил и прослеживаемость.
- Интеграция данных строится на сочетании подходов ETL/ELT и CDC, поддерживаемых потоковой обработкой, чтобы обеспечить актуальность витрины и устойчивость к ошибкам.
- Управление качеством данных, метаданными и семантикой - критический элемент, обеспечивающий доверие к аналитике и согласованность между источниками.
- Внедрение витрины данных - это организационный процесс: четко определённые роли, управляемые процессы изменений, пилотирование и постепенный масштаб, поддерживаемый мониторингом и безопасностью.
- Практическая реализация требует баланса между архитектурной надёжностью, скоростью доступа к данным и эффективной эксплуатационной поддержкой.
FAQ
- Что такое витрина данных и чем она принципиально отличается от хранилища данных?
Витрина данных - это не только место хранения данных, но и архитектурная концепция, объединяющая данные из разных источников вокруг бизнес‑словаря и семантики для поддержки аналитики. Основное различие от типичного хранилища данных состоит в фокусе на бизнес‑терминах, конформированных измерениях и единых правилах расчётов. Витрина предназначена для быстрого доступа к аналитическим результатам и для обеспечения совместимости между различными предметными областями. Хранилище данных может служить основой для витрины, но витрина добавляет слой семантики, управление версиями и прослеживаемость данных, что критично для масштабируемой аналитики.
- Какие архитектурные слои наиболее критичны в витрине данных?
Критически важны слои raw, cleansed/conformed, semantic и presentation. Raw‑слой обеспечивает аудит и полноту данных как есть. Cleansed/Conformed - единое и согласованное представление данных, готовое к анализу; здесь соблюдаются правила конформности размерностей и единицы измерения. Semantic слой содержит бизнес‑термины, метрики и правила расчётов, выступая мостом между техническими столбцами и бизнес‑пользователями. Presentation слой - это интерфейсы, аналитические витрины, панели и модели потребления данных. В рамках архитектуры также важны слои хранения и оптимизации (storage/compute) и потоковые конвейеры.
- Как выбрать между звездой, снежинкой и Data Vault?
Выбор зависит от частоты изменений источников, требований к аудиту и масштаба. Звезда обеспечивает простые и быстрые запросы, улучшает читаемость и быстро внедряется. Снежинка снижает дублирование за счёт нормализации размерностей, но усложняет запросы. Data Vault ориентирован на эволюцию в условиях частых изменений, обеспечивает хорошую прослеживаемость и масштабируемость, особенно в больших средах. В реальных проектах часто начинается с звезды, затем добавляются элементы снежинки для сложных размерностей, а Data Vault применяется для новых областей, где критична история изменений и прозрачность происхождения данных.
- Какие паттерны интеграции и обработки рекомендуется применять?
Рекомендуется сочетание этапов: батчевые загрузки для стабильной загрузки больших объёмов и CDC/стриминг для поддержания актуальности данных в режиме near‑real‑time. Применение CDC позволяет отражать изменения источников в витрину без повторной загрузки. Стриминг обеспечивает своевременную аналитическую доступность, особенно в сценариях продаж, маркетинга и обслуживания клиентов. Важно обеспечить идемпотентность операций и строгий контроль версий, чтобы повторная обработка не портила целостность витрины.
- Как обеспечить единый словарь терминов и семантику?
Необходимо создать бизнес‑словарь и сопоставления между терминами и столбцами моделей, держать их в централизованном каталоге метаданных и регулярно обновлять в соответствии с изменениями в источниках. Инструменты Amundsen и Apache Atlas помогают в организации метаданных и прослеживаемости; dbt - в документации и тестировании моделей, связывая термины с конкретными объектами витрины. Важна дисциплина документирования и автоматизация тестов на соответствие между семантикой и данными, чтобы быстро выявлять расхождения.
- Какие шаги следует предпринять для пилотного внедрения витрины данных?
Начать следует с выбора одной-двух управляющих доменов (например, продажи и клиенты) и создания минимальной, но рабочей витрины с конформированными размерностями и базовым набором фактов. Затем внедрить базовые правила качества данных, семантику и документацию, чтобы обеспечить понятную бизнес‑интерпретацию. Постепенно расширять предметную область, добавлять новые измерения и источники, интегрировать мониторинг и аудит. Важно формировать команду, включающую архитекторов, инженеров, аналитиков и стейкхолдеров, и обеспечивать координацию между бизнес‑и техническими сторонами.
- Какие риски обычно возникают на старте проекта витрины данных?
Риски включают фрагментацию семантики и терминов, несогласованность между источниками, низкую качество данных, задержки конвейеров и сложности внедрения метаданных. Ещё один риск - чрезмерная сложность архитектуры, которая препятствует быстрому получению первых результатов. Для снижения рисков следует внедрять пилоты, документироватьж semantическую карту и правила преобразований, устанавливать мониторинг, ограничивать первоначальный охват и постепенно масштабировать витрину по мере зрелости процессов.
- Какие инструменты и продукты особенно полезны в технической реализации?
Выбор инструментов зависит от контекста, однако традиционно применяются: Apache Kafka для потоков данных, Apache Spark или подобные движки для обработки, dbt для моделирования и документации, Apache Iceberg для управления таблицами и поддержания версий, а также решения для хранения и аналитики вроде ClickHouse или облачных платформах. Для управления метаданными и семантикой - Amundsen или Apache Atlas; для обеспечения качества данных - инструменты тестирования данных и мониторинга процессов. В рамках курса подчёркнута роль не только выбранного набора инструментов, но и согласованных подходов к архитектуре и управлению.
- Как измерять успех витрины данных?
Успех измеряется в скорости и точности доступа к данным, устойчивости к изменениям источников, доле бизнес‑пользователей, активно использующих витрину, и качестве принимаемых решений. KPI могут включать время цикла от запроса до доступа к результатам, долю успешно обработанных изменений, уровень дефектов качества данных, уровень удовлетворенности пользователей и соответствие требованиям безопасности и соответствия. Важно установить прозрачные метрики и регулярно пересматривать их в рамках управляемого процесса модернизации витрины.
- Какие ошибки чаще всего возникают на старте и как их избежать?
Распространённые ошибки включают неопределённость семантики на старте, незавершённый словарь терминов, перегружение витрины слишком большим объёмом без пилотов, игнорирование контроля качества и прослеживаемости, а также недостаточное вовлечение бизнес‑пользователей в процесс моделирования. Чтобы избежать подобных проблем, рекомендуется начать с пилотного блока, формировать единый словарь, внедрять процедуры тестирования и документации, и обеспечивать активную вовлечённость стейкхолдеров на всех этапах проекта.


