

Кейсы архитектурной миграции: переход на Lakehouse/MPP-платформы
Логика перехода на Lakehouse и объекты MPP-платформ строится на объединении преимуществ хранения данных и вычислительных мощностей: унифицированный формат хранения, поддержка транзакций, управляемая метадата и гибкая схема. Глава посвящена практическим кейсам миграции: как проектировать архитектуру, какие схемы и алгоритмы применяются, какие интеграции необходимы и как управлять рисками в условиях больших объемов аналитических запросов.
В ходе рассмотрения мы опираемся на концепции Lakehouse как единого слоя хранения с поддержкой ACID, Time Travel и управляемой схемой, а также на паттерны миграции - от монолитных хранилищ к гибкому, масштабируемому конструкту. Приведены принципы проектирования схем, подходы к конвейерам данных и механизмы контроля качества и безопасности на этапе перехода. В итоге демонстрируются типовые кейсы миграции и рекомендации по выбору инструментов для конкретной бизнес-задачи.
- Архитектура Lakehouse и MPP: принципы, транзакционность, единая метадата и разделение вычислений от хранения.
- Стратегии миграции: планирование этапов, парадигмы dual-write и backfill, минимизация даунтайма и рисков.
- Модели данных и схемы: разделение Bronze-Silver-Gold, управление схемной эволюцией и семантикой.
- Интеграции и конвейеры: CDC, ELT-потоки, обработка потоковых и пакетных данных, контроль качества.
Архитектурные принципы миграции на Lakehouse/MPP
Главное преимущество миграции к Lakehouse - возможность сохранения исторической точности и целостности данных при росте нагрузки и объёма. Lakehouse обеспечивает единый уровень хранения, где данные формализованы в открытых форматах (например, Parquet) и сопровождаются есть ACID-транзакциями, журналируемостью и возможностью обращения к прошлым версиям (Time Travel). В контексте MPP-платформ это позволяет разделить вычисления и хранение, масштабировать вычисления независимо от объема данных и поддерживать параллельную обработку без обструкций. При этом важно правильно спроектировать слой метаданных: integrity checks, lineage, schema evolution и управление доступами.
С точки зрения архитектуры базовые принципы распределяются по нескольким слоям:
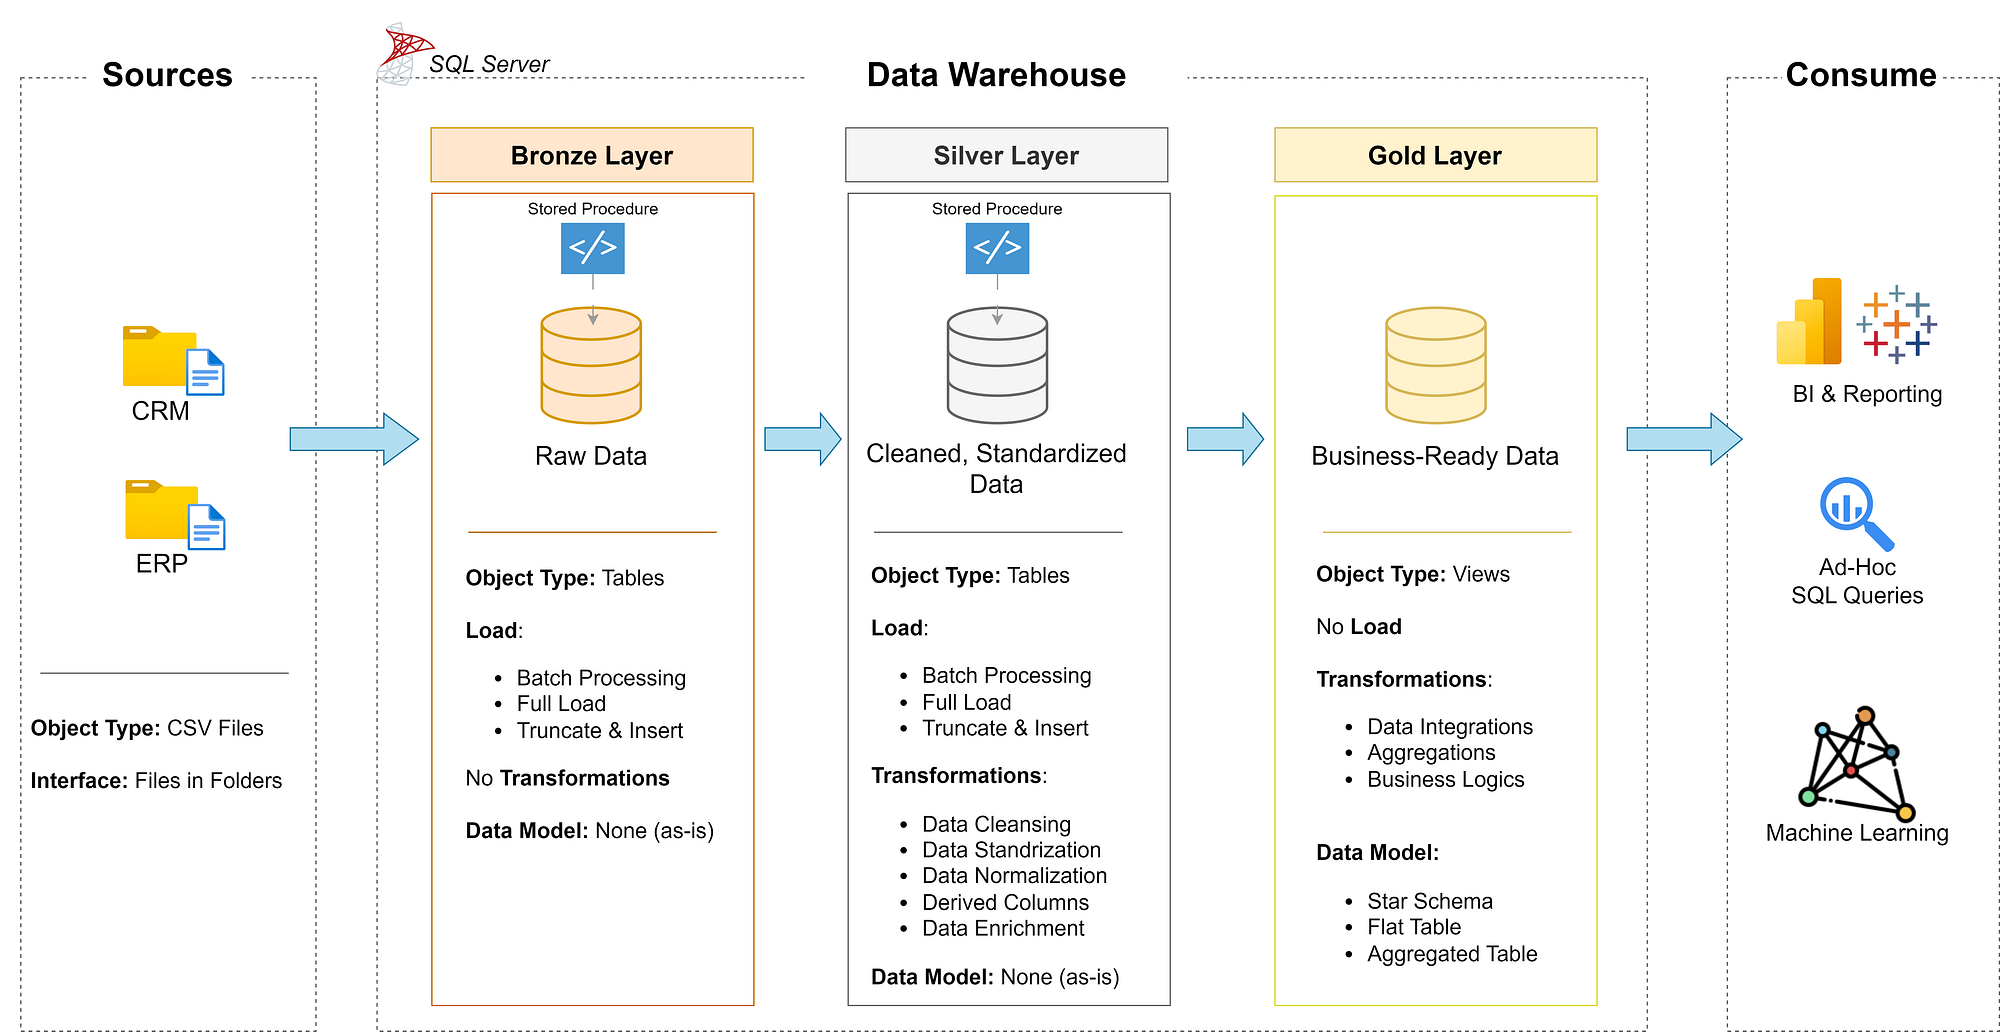
- слой RAW/ Bronze: хранение исходных данных в формате, близком к источнику, с минимальной трансформацией. Этот слой обеспечивает полноту данных и возможность повторной загрузки.
- слой SILVER: очищенная, нормализованная и обогащенная информация, готовая к аналитическим запросам. Здесь применяются паттерны контроля качества, дедупликации и базовой агрегации.
- слой GOLD: готовые бизнес-метрики и представления для аналитиков и приложений BI. В этом слое формируются унифицированные семантики и согласованные витрины.
Важно закрепить концепцию разделения транзакций и вычислений. В Lakehouse это достигается за счет использование форматов файлов, поддерживающих транзакционные логи (Delta Lake, Apache Iceberg, Apache Hudi) и управляемых схем. Для MPP-платформы это означает, что операции MERGE, UPDATE, DELETE могут выполняться на уровне таблиц, обеспечивая консистентность данных даже в условиях высоких скоростей загрузки и конкурентности запросов.
Паттерны миграции данных
В первую очередь следует определить стратегию миграции: параллельная загрузка нового слоя, параллельная конвертация существующих наборов и постепенное переключение потребления. Ряд компаний реализуют подход dual-write: данные пишутся одновременно в старую систему и в новую Lakehouse-структуру. Этот паттерн уменьшает риск пропуска данных и упрощает cutover, однако требует строгого согласования согласованности и механизмов борьбы с конфликтами данных.
Для длительных миграций полезны backfill-режимы: заполнение Silver/GOLD слоев на основе Bronze данных в фоновом режиме, с последующей верификацией соответствия между двумя слоями. В контексте больших данных это позволяет снизить риск простоя и обеспечить непрерывность аналитики.
— Пример паттерна dual-write (упрощённо):
1. Приёмник данных (CDC/CDC-подсистема) получает изменения из источника и пишет в Bronze таблицу новой платформы.
2. Асинхронный конвейер преобразует Bronze → Silver, применяя бизнес-правила и валидацию.
3. Финальный слой Gold формируется на основе Silver, и потребители перенаправляются на новый слой.
— Пример backfill-генерации Silver-таблицы:
MERGE INTO silver_sales AS s
USING bronze_sales AS b
ON s.transaction_id = b.transaction_id
WHEN MATCHED THEN UPDATE SET
  s.amount = b.amount,
  s.currency = b.currency,
  s.status = b.status
WHEN NOT MATCHED THEN INSERT (transaction_id, amount, currency, status)
VALUES (b.transaction_id, b.amount, b.currency, b.status);
Переход на Lakehouse обычно сопровождается выбором одного из двух базовых сценариев: постепенная миграция по бизнес-подразделениям с сохранением текущей архитектуры на старой платформе до момента полного снятия нагрузки; либо полная миграция за одно или два цикла обновлений с заранее согласованными критериями завершения. В любом случае критически важны:
- прозрачность согласованности между системами;
- контроль качества данных на каждом слое;
- план запуска и аварийного отката;
- мониторинг затрат на хранение и вычисления.
Модели данных и схемы: подходы к проектированию в Lakehouse
Lakehouse меняет роль традиционных схем. Вместо единой монолитной схемы для всего хранилища целесообразно внедрять многослойную архитектуру и управляемую схему evolvable schema. В качестве ориентиров можно применять концепцию Bronze-Silver-Gold, где Bronze - это сырые данные, Silver - очищенные и согласованные данные, Gold - бизнес-витрины и показатели.
- Bronze: хранение данных в нативном формате источников без сильной трансформации. В этом слое сохраняются Rac дубликаты, изменённые объекты и временные данные, что позволяет использовать backfill и повторный импорт.
- Silver: нормализация и стандартизация ключевых бизнес-объектов, консолидация по тематикам. Здесь применяются правила пре-агрегаций, расчёты по ключам и кросс-ссылки между доменами.
- Gold: агрегаты и витрины для аналитиков и прикладного ПО. В Gold часто реализуются материализованные представления, предикаты фильтрации и бизнес-индикаторы.
Существенно учитывать поддержку схемной эволюции и совместимости старых и новых форматов. Lakehouse позволяет хранить схему эволюций в виде версии, хранить историю изменений и делать откат к предыдущей версии. Это критично при миграции, когда новые источники и новые форматы данных могут требовать изменений в семантике полей и типов.
— Пример организации Silver таблиц с схемной эволюцией:
CREATE TABLE silver_customers (
  customer_id STRING,
  name STRING,
  email STRING,
  phone STRING,
  updated_at TIMESTAMP,
  schema_version INT
) USING delta;
— Пример версии и миграции схемы (упрощённо):
ALTER TABLE silver_customers ADD COLUMN loyalty_status STRING;
-- Обновление данных с учётом новой схемы:
UPDATE silver_customers SET loyalty_status = CASE WHEN spend_last_year > 1000 THEN 'Gold' ELSE 'Standard' END;
Важно помнить, что выбор конкретной модели зависит от доменной области и требований к аналитике. В некоторых случаях целесообразно сохранять дополнительные денормализованные витрины (Gold) с преднастроенными агрегатами для конкретных бизнес-процессов, что позволяет ускорить исполнение критически важных запросов и снизить нагрузку на общий слой.
Архитектурные шаблоны схемирования
- Silver как единая семантическая конструкторская платформа: определение доменных ключей, стабильных идентификаторов и правил согласования.
- Gold как слой бизнес-метрик и витрин: предвычисление KPI, сегментов и кластеров, поддержка соглашений об именовании и дефинициях, согласованных между командами.
- Введение слоя семантического моделирования: единый слой бизнес-логики, который может быть реализован через материализованные представления или виртуальные витрины на уровне Lakehouse.
Потребуется также продуманная система метаданных и линейной трассируемости данных. Метаданные должны включать источники, схему, версию, периодичность обновления и соответствие стандартам качества. В рамках MPP-платформ это особенно важно, поскольку масса одновременных запросов должна относится к корректному источнику и корректной версии данных.
Интеграции и конвейеры: ELT, CDC и качество данных
Успешная миграция требует согласованной стратегии интеграции источников, обработки и доставки данных. В Lakehouse для больших данных характерны следующие подходы:
- CDC и потоковые источники: Debezium, Kafka и сопутствующие коннекторы для потоковых загрузок. Эти технологии позволяют минимизировать задержку между изменениями в источнике и доступностью изменений в Lakehouse.
- ELT-потоки: современные движки позволяют выполнять трансформации непосредственно на целевой платформе, что упрощает архитектуру и снижает задержку. В рамках этого подхода внимание уделяется эффективной оптимизации запросов и минимизации перепроходов по данным.
- Инструменты конвейеров: Apache NiFi, Apache Airflow, а также облачные оркестраторы (AWS MWAA, GCP Composer, Azure Data Factory) - они управляют зависимостями, расписанием и мониторингом.
- Контроль качества данных (DQA): в каждом слое внедряются правила валидации, тесты соответствия схемам и автоматическая генерация уведомлений при отклонениях. В Lakehouse часто применяют тесты качества данных и автоматическое сохранение версий данных.
Ключ к эффективной интеграции - баланс между скоростью загрузки данных и степенью трансформации. Чем раньше выполняются чистки и стандартизации, тем выше вероятность снижения ошибок на Gold-слое, но слишком ранние преобразования могут ограничивать полноту источников. Поэтому часто применяют архитектуру "deferred transformation": Bronze → поток данных, Silver - промежуточная очистка и унификация, Gold - готовые бизнес-витрины.
— Пример конвейера ELT (псевдокод):
## FROM source.topic INTO bronze_events
TRANSFORM USING a set of rules INTO silver_events
AGGREGATE INTO gold_metrics;
— Пример CDC-интеграции (упрощённо):
1. Debezium detects insert/update/delete.
2. События публикуются в Kafka.
3. Spark Structured Streaming читает Kafka и обновляет bronze_events.
4. ELT-пайплайн превращает bronze->silver->gold в Lakehouse.
Безопасность и доступ - неотъемлемая часть миграции. Необходимо продуманно распланировать модели доступа: на уровне данных, на уровне столбцов, и на уровне вычислений. В Lakehouse это достигается за счет поддержки политик безопасности, ролей и ACL, а также разделения прав между слоями и окружениями (разработка/продакшн).
Этапы миграции, риски и управление проектом
Успешная миграция требует структурированного подхода к планированию, принятию решений и управлению изменениями. Практика показывает следующие ключевые этапы:
- Текущее состояние и целевая архитектура. Выполнить аудит инфраструктуры, включительно с объемами данных, источниками и SLA. Выделить критичные витрины и определить набор KPI для миграции.
- Выбор технологического стека и паттернов. Определить набор Lakehouse-технологий (форматы файлов, движки, конвейеры) и соглашения по схемам для Bronze/Silver/Gold.
- Переходные сценарии. Разработать стратегию dual-write, backfill и cutover. Определить критерии готовности к переключению потребителей на новую платформу.
- Управление качеством и безопасностью. Обеспечить тестирование, кросс-сверку данных между старыми и новыми источниками, внедрить политики доступа и мониторинг соответствия.
- Мониторинг и эксплуатация. Реализовать мониторинг задержек, ошибок ETL, цены на хранение и вычисления. Встроить алерты и регламент проведения аудитов.
- Организационные изменения. Внедрить новые роли: архитекторы данных, инженерные команды, операторы конвейеров и центр компетенций по governance. Обеспечить обучение и документацию для устойчивых процессов.
Потоки миграции требуют синхронного управления рисками, поскольку любые задержки в конвертации могут привести к недоступности аналитики. Важной частью является горизонтальная и вертикальная масштабируемость: возможность расширения вычислительных мощностей по мере роста запросов и корректного распределения нагрузки между Bronze/Silver/Gold слоями.
Ниже приводится набор ключевых практик:
- Планируйте миграцию по доменам, а не по технологическим слоям. Это упрощает координацию зависимостей и ускоряет достижение конечной цели.
- Внедряйте концепцию временной синхронизации. Привязывайте к каждому набору данных версию и дату обновления, чтобы можно было отследить источник изменений.
- Реализуйте мониторинг согласованности между старыми и новыми источниками на критичных витринах.
- Обеспечьте доступность операционных команд к ошибкам и инцидентам, чтобы минимизировать простой и ускорить восстановление.
Практический кейс миграции: переход на Lakehouse на базе Snowflake/Databricks
Рассмотрим гипотетический, но реалистичный кейс крупной телекоммуникационной компании, которая объединяет данные по звонкам, сетевым событиям и биллингу в единый Lakehouse-платформенный контур. Исходно существовала монолитная архитектура, где данные хранились в проприетарном продукте и в отдельных витринах. Цель - снизить задержки аналитики, повысить гибкость и обеспечить единый доступ к данным для BI и ML моделей.
Архитектура миграции ориентирована на переход к Bronze-Silver-Gold паттерну, с использованием Delta Lake как формата хранения и Snowflake/Databricks как MPP-платформы. Bronze содержит сырые записи источников: логи звонков, туннели сетевых событий, транзакции биллинга. Silver - нормализованные и унифицированные сущности: клиенты, устройства, события, платежи. Gold - бизнес-метрики: ARPU, churn, SLA-качество связи, коэффициенты конверсии по сегментам.
- На этапе планирования проведена инвентаризация источников и контрактов на доступы. Определены ключевые домены и владельцы данных. Были сформированы требования к задержке обновления и доступности для BI и ML.
- Реализован паттерн dual-write: данные пишутся в старую систему и в Bronze Lakehouse, чтобы обеспечить бесшовный переход и минимизировать риск потери данных.
- В процессе backfill Silver-слоя применены данные из Bronze с проверкой согласованности: уникальность контрактов, целостность идентификаторов клиентов, корректность дат и сумм.
- В Gold-слое реализованы витрины по бизнес-метрикам и поддержан процесс обновления на основе ежедневной загрузки и стримингового конвейера для критичных показателей в реальном времени.
Пример кода: создание Bronze и Silver таблиц и простого MERGE для обновления Silver на основе Bronze данных.
— Создание Bronze таблицы:
CREATE TABLE bronze_events (
  event_id STRING,
  source STRING,
  payload STRING,
  event_ts TIMESTAMP
) USING delta;

— Создание Silver таблицы:
CREATE TABLE silver_events (
  event_id STRING,
  source STRING,
  payload_map MAP,
  event_ts TIMESTAMP,
  schema_version INT
) USING delta;
— MERGE из Bronze в Silver (упрощённый сценарий):
## MERGE INTO silver_events AS s
USING (SELECT event_id, source, payload, event_ts FROM bronze_events) AS b
ON s.event_id = b.event_id
## WHEN MATCHED THEN UPDATE SET
  s.payload_map = map_from_entries(array('payload' , b.payload)),
  s.event_ts = b.event_ts,
  s.schema_version = COALESCE(s.schema_version, 1) + 0
WHEN NOT MATCHED THEN INSERT (event_id, source, payload_map, event_ts, schema_version)
VALUES (b.event_id, b.source, map_from_entries(array('payload', b.payload)), b.event_ts, 1);
Данный кейс демонстрирует не столько конкретный набор технологий, сколько принципы: как организовать поток данных, как обеспечить единый слой аналитики и как управлять изменениями в схемах. В реальных условиях выбор платформы - Snowflake, Databricks или другая MPP-система - зависит от требований к задержке, объему данных и специфике нагрузки. Важной составляющей остаётся стратегическое управление затратами на хранение и вычисления, а также поддержка качества и безопасности данных.
Key takeaways
- Lakehouse объединяет хранение и вычисления: ACID-транзакции, единая метадата и поддержка схемной эволюции.
- Миграция - это управляемый процесс: план по стадиям Bronze/Silver/Gold, dual-write и backfill снижают риски простоя.
- Правильная схема данных в Lakehouse обеспечивает устойчивые витрины для аналитики и ML, с явной версией и lineage.
- Интеграции CDC и ELT-потоков позволяют сохранять актуальность данных и снижать задержки в аналитике.
- Мониторинг, качество данных и governance - критически важны на всех этапах миграции.
- Выбор инструментов зависит от требований к задержке, масштабируемости и бизнес-логике, но принципы архитектуры остаются общими.
- Постепенная миграция по доменам и четкая политика доступа помогают управлять рисками и обеспечить устойчивый переход.
FAQ
- Что такое Lakehouse и чем он отличается от традиционного хранилища данных?
Lakehouse - это архитектурная парадигма, объединяющая преимущества data lake и data warehouse: хранение больших массивов неструктурированных и структурированных данных в открытых форматах, дополненное транзакционностью, схемной эволюцией и оптимизациями для аналитических запросов. В отличие от классических хранилищ, Lakehouse обеспечивает единый слой хранения и единый слой обработки, что позволяет снижать издержки, ускорять аналитические конвейеры и упрощать доступ к данным для BI и ML.
- Какие форматы и технологии чаще всего применяются в Lakehouse?
На практике применяются форматы файлов, оптимизированные для аналитики, такие как Parquet, ORC. Для транзакционности используются управляемые журналы изменений и версионирование таблиц: Delta Lake, Apache Iceberg и Apache Hudi - открытые проекты, поддерживающие ACID и трансформации на уровне таблиц. В качестве вычислительной платформы часто выбирают Snowflake, Databricks, Google BigQuery или экосистемы AWS/Azure/GCP, в зависимости от потребностей в задержке и интеграциях.
- Какие основные паттерны миграции применяются на практике?
Типичные паттерны: dual-write (одновременная запись в старую и новую систему), backfill (постепенная конвертация исторических данных в Silver/Gold слои), cutover с поэтапным переключением потребителей. Важно обеспечить согласованность между слоями и чётко определить пороги готовности для переключения.
- Как организовать данные в Lakehouse для аналитики?
Рекомендуется многослойная архитектура Bronze-Silver-Gold: Bronze - данные источников в исходном формате; Silver - очищенные и нормализованные единицы, готовые к аналитическим применениям; Gold - витрины и метрики для бизнес-потребителей. Такая структура способствует независимому обновлению слоев и ускоряет ответы на задачи из BI и ML.
- Какие риски сопровождают миграцию и как их минимизировать?
Риски включают пропуск данных, задержки в конвертации, несогласованность между старыми и новыми источниками, а также перерасход бюджета на вычисления. Их минимизируют через детальный план миграции, тестирование на уровне целевых витрин, внедрение контроля качества и мониторинга, а также организацию governance и ролей.
- Какие подходы к качеству данных применяются в ходе миграции?
Применяются автоматические тесты соответствия схемам, проверка консистентности между Bronze и Silver, верификация уникальности ключей и периодическая сверка агрегатов. Также поддерживаются политики версии данных и lineage, чтобы можно было проследить источник изменений и вернуть данные к предыдущим версиям при необходимости.
- Как оценивать экономическую целесообразность миграции?
Необходимо моделировать затраты на хранение, вычисления и лицензии, оценивать экономию за счет ускорения аналитики и сокращения дублирования данных, а также учитывать стоимость перехода и времени простоя. В рамках Lakehouse появляется возможность динамического масштабирования вычислений по требованию, что может существенно снижать среднюю стоимость эксплуатации при росте нагрузки.
- Что важно учесть при выборе между Delta Lake и Iceberg?
Оба проекта поддерживают ACID и версионирование. Выбор зависит от инфраструктуры, экосистемы облака, поддержки конкретных функций (оптимизации и индексов, time travel) и совместимости с существующими пайплайнами. Delta Lake хорошо интегрируется с Databricks и экосистемой Apache Spark, Iceberg часто предпочтителен при независимой многоплатформенной эксплуатации и гибкости в моделировании схем.
- Как обеспечить безопасный доступ к данным на Lakehouse?
Необходимо внедрить строгие политики доступа на уровне таблиц и столбцов, использовать роли и группы, а также применять шифрование и аудит доступа. Governance-слой должен включать:DLP-политики, мониторинг аномалий доступа и регулярные аудиты соответствия требованиям защиты данных.
- Какие практические индикаторы готовности проекта миграции?
Решения о готовности обычно опираются на: полноту загрузки Bronze, уровень консистентности между Bronze и Silver, задержку выполнения Gold-витрин, стабильность и производительность конвейеров, доступность критичных витрин для пользователей и соответствие требованиям SLA. Регулярно проводятся пилоты на ограниченной области и постепенно расширяют охват до полной миграции.


