

Почему колоночные форматы Parquet и ORC не подходят для ML-нагрузок: контекст проблемы
В современных корпоративных средах данные становятся основным активом для разработки и эксплуатации моделей машинного обучения (ML). Однако выбор формата хранения оказывает существенное влияние на производительность и экономическую эффективность ML-пайплайнов. Колоночные форматыParquet и ORC популярны благодаря эффективному считыванию столбцов при аналитических запросах: они поддерживают сжатие, векторизацию чтения и колоночное кодирование, что ускоряет операции типа соединений, группировок и агрегаций. Но задачи ML часто выходят за рамки типичной аналитики: итеративные обучающие алгоритмы, богатые признаки и временные контексты создают требования, с которыми парадигма колонок сталкивается с ощутимыми ограничениями.
Во-первых, ML-алгоритмы, в особенности градиентный спуск и его вариации, требуют многократного прохода по тем же данным для обновления параметров. В классических SQL-аналитических сценариях такие многократные сканы редко необходимы, поскольку данные чаще используются в рамках одноразовых операций, например, группировок и агрегирования. В колоночных форматах структура хранения ориентирована на одноразовое сканирование больших блоков данных. Это означает, что повторные проходы по тем же столбцам могут приводить к значительным накладным расходам на десериализацию, возврат к кэшам и повторную загрузку метаданных.
Во-вторых, ML-трансформации требуют доступа к нескольким столбцам одновременно и выполнения сложных вычислений над ними - нормализации, комбинирования признаков, взаимодействий между признаками и временных окон. Колоночные хранилища, оптимизированные для пакетной обработки и проекций больших наборов столбцов, часто вынуждают последовательности операций к чтению большого объема метаданных и последующему сериализованию/десериализации значимых фрагментов данных. В результате производительность ML-операций может существенно страдать по сравнению с системами, специально ориентированными на векторные и временные данные.
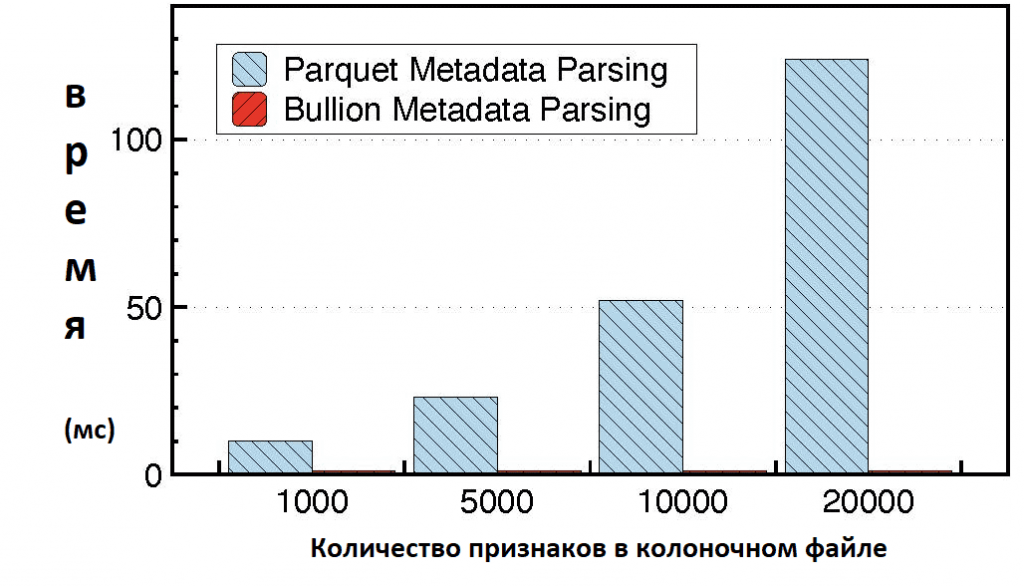
Разреженность и широкий характер признаков в ML добавляют дополнительных сложностей. В ML-датасетах часто встречаются разреженные матрицы и крайне широкий набор признаков, где каждый признак занимает отдельный столбец. В Parquet и ORC время чтения метаданных растет практически линейно с числом признаков; для очень широких и разреженных таблиц затраты на десериализацию и анализ метаданных становятся значительными, что может нивелировать преимущества колоночной организации.
Наконец, вопросы регуляторики и управления данными в ML-циклах создают уникальные требования к обновлениям и удалению данных. Колонночные форматы исторически ориентированы на чтение, а не на частые вставки и удаления отдельных строк. В современном контексте регуляторы данных, такие как GDPR, CCPA/CPRA и VCDPA, требуют не только аудита и доступа к данным, но и возможность их физического удаления в заданные сроки. Реализация такой возможности в колоночном формате встречает сложности: физическое удаление может потребовать переработки больших фрагментов файлов из-за блочного сжатия и оркестрации чтения по столбцам. В результате возникают вопросы совместимости с регуляторной политикой и требованиями к управлению жизненным циклом данных в ML-пайплайнах.
Ниже мы подробно рассмотрим эти проблемы, соотнося их с архитектурой и особенностями Parquet и ORC, а затем перейдём к альтернативам и практикам, которые лучше подходят для ML-нагрузок.
- Важность итеративности в обучении и ограниченность одноразовых сканов
- Необходимость совместного доступа к множеству столбцов и сложных преобразований
- Влияние разреженности, ширины и динамики признаков на производительность
- Регуляторные требования к обновлению и удалению данных в контексте ML
- Роль метаданных и их влияние на скорость доступа к признакам и вычисления
Ключевые выводы: колоночные форматы Parquet и ORC действительно эффективны для SQL-аналитики, но их модели хранения не отражают требования современных ML-структур, где скорость итераций, гибкость трансформаций и точное соблюдение политики удаления становятся критичными для производительности и соответствия.
Отличия ML-нагрузок от традиционной аналитики: требования к данным и вычислительным паттернам
ML-нагрузки отличаются по набору требований к данным и вычислениям от типичных аналитических сценариев. Чтобы проектировать эффективные платформы хранения данных для ML, необходимо системно выделить эти различия и превратить их в архитектурные решения.
Во-первых, характер циклов обучения: ML-алгоритмы работают в рамках итеративных оптимизационных процедур, которые повторяют чтение подмножеств данных, пересчёт признаков и обновление параметров на каждом шаге. Это требует поддержки эффективных механизмов повторного доступа к данным, кэширования релевантных фрагментов и минимизации затрат на повторную десериализацию большого числа столбцов. Традиционная аналитика чаще опирается на разово-сканированные данные, где одна операция завершает пакет вычислений и освобождает ресурсы.
Во-вторых, процесс нормализации и масштабирования признаков. В ML часто выполняются преобразования, такие как масштабирование по каждому признаку, центрирование, создание взаимодействий между признаками (например, попарные взаимодействия или полиномиальные признаки). Эти операции требуют доступа к широкому спектру столбцов и их взаимной корреляции, что противоречит натуре колонок, которые эффективнее читают изолированные столбцы без развернутого взаимодействия. Эффективная реализация таких трансформаций требует продуманной поддержки форматов данных, которые допускают хранение и быстрое извлечение сложных типов данных, например векторов признаков, временных окон и т. п.
В-третьих, работа с временными контекстами и последовательностями. Ряд ML-задач - от рекомендаций до прогнозирования временных рядов - требует хранения и эффективной обработки последовательностей признаков. В ML-практике часто используются переменные окна, скользящие параметры, а также хранение длинных векторов признаков (например, клики за прошлые n секунд). Традиционные колоночные форматы не проектировались для эффективного представления и извлечения таких последовательностей в рамках одной операции. Это требует специальных структур данных и кодующих схем и, иногда, встроенной поддержки временных рядов на уровне формата хранения.
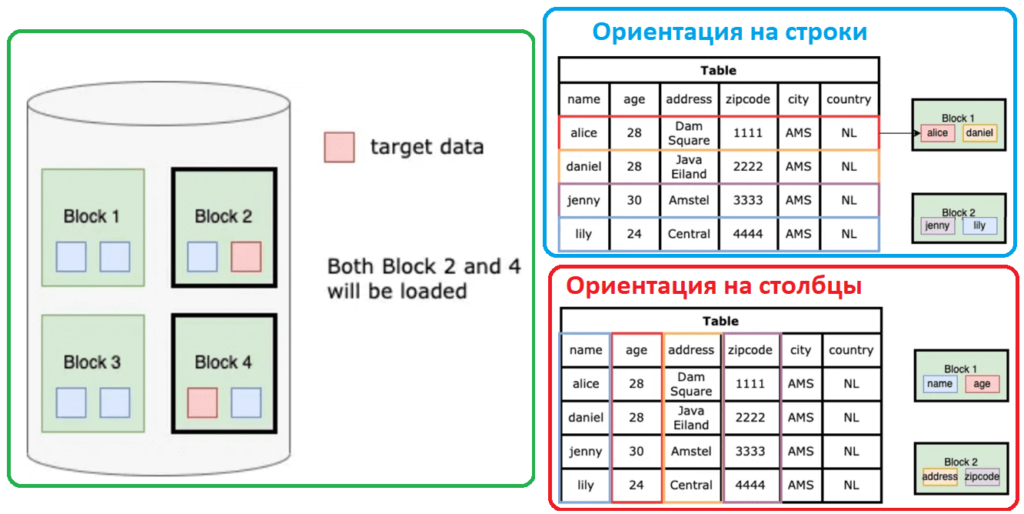
В-четвёртых, обработка разреженности и высокодименсиональных данных. Векторизация признаков часто приводит к разреженным представлениям; в этом случае эффективное хранение и чтение разреженности критично для производительности. Обратно к подходу традиционной аналитики - там чаще работают с плотными матрицами и не-высокодименсионализированными наборами. Колоночные форматы умеют эффективно хранить разреженные данные, но требуют дополнительных механизмов для быстрого доступа к значимым признакам без тяжёлой десериализации всего столбца.
В-пятых, частые обновления и динамика датасетов. В ML жизненный цикл данных может включать частые добавления новых наблюдений, корректировки значений и удаление устаревших данных. В колоночных форматах такие операции не столь эффективны из-за блокового архивирования и сжатоcти, что заставляет рассматривать альтернативы или дополнительные слои кэширования и индексации. Системы ML-ориентированной архитектуры должны поддерживать быстрые обновления признаков в хранилище, минимизируя время простоя и поток IO.
Наконец, регуляторные требования и контроль доступа. В ML-окружениях часто работают с персональными данными и чувствительными признаками. Это накладывает требования к аудиту, глобальным и локальным политикам доступа, а также к праву на удаление данных. Архитектура хранения должна не только обеспечивать точную идентификацию и контроль доступа к данным, но и поддерживать механизмы удаления в рамках регуляторных окон без нарушения целостности и производительности.
Резюме: ML-нагрузки предъявляют к данным и вычислениям требования, выходящие за рамки традиционной аналитики. Они требуют поддержки итеративности, совместного доступа к множеству признаков, эффективного обращения с разреженностью и временной динамикой, быстрой инкрементной обработки обновлений, а также строгого соблюдения регуляторных норм. Понимание этих различий - фундамент для выбора архитектурных и форматов хранения, ориентированных на ML.
- Итеративность и повторные проходы по данным
- Расширенная трансформация признаков и их взаимодействия
- Векторизация и разреженность признаков
- Широкие таблицы и временные окна
- Частые обновления и вопросы удаления данных
- Регуляторные требования и аудит

Архитектура Parquet и ORC: принципы хранения, кодирования и доступа к метаданным
Форматы Parquet и ORC строят горизонтально-колоночную архитектуру хранения, оптимизированную для SQL-аналитики. Их основа - разделение данных на структуры, которые обеспечивают эффективное сжатие, быстрое считывание нужных столбцов и поддержание богатой метаинформации о данных.
Структура Parquet и ORC обладает следующими элементами:
- Row Groups (для Parquet) и Slices/Stripe-like сегменты (для ORC): физические блоки данных внутри файлов, которые обеспечивают границы для считывания и параллелизма. Каждый блок содержит набор столбцов и сопровождается локальными индикаторами статистики по столбцам.
- Column Chunks (часть Parquet) и Colums внутри блоkов (для ORC): внутри каждого Row Group структурируются данные по столбцам, что позволяет считывать только те столбцы, которые необходимы для конкретного запроса.
- Encoding и Compression: различные режимы кодирования, такие как Dictionary Encoding (словарное кодирование), Run-Length Encoding (кодирование длин последовательностей), Bit-Packing и другие адаптивные техники. Сжатие (Snappy, Zstd, Gzip и пр.) снижает занимаемое пространство на диске и снижает нагрузку на сеть.
- Metadata и Footer: в конце файла хранятся метаданные, включая схему, статистику по столбцам и ссылки на блоки. Эти данные облегчают выборочное чтение и планирование выполнения запросов.
- Nested Types: поддержка структурированных типов (STRUCT, LIST, MAP) с детальной сериализацией вложенных данных. Это важно для сложных признаков, которые часто встречаются в ML-пайплайнах.
Эти принципы создания и доступа к данным обеспечивают эффективное чтение больших объемов наборов столбцов без необходимости загрузки всей строки целиком. Однако они также порождают вызовы для ML: необходимость одновременного доступа к множеству столбцов, связанные с временными окнами и сложными преобразованиями, и сложности обновления данных в рамках блочно-упакованных структур.
- Row Groups/Blocs, columnar storage, и независимость чтения по столбцам
- Метаданные как источник скорости: статистика и схемы
- Вложенные типы и их влияние на сериализацию/десериализацию
- Сложности обновлений в колоночных форматах и влияние на регуляторные требования
- Архитектурная совместимость Parquet/ORC с современными аналитическими и ML-пайплайнами (Spark, Trino, Presto)
Декомпозиция технических компонентов и их взаимодействия в колоночных форматах
Ключевая идея колоночных форматов состоит в выделении слоёв вычисления и хранения, чтобы оптимизировать доступ к данным по столбцам и минимизировать объем считываемой информации. Архитектура может быть рассмотрена как набор взаимосвязанных компонентов:
- Формат файлов и кодировок: Parquet/ORC представляют собой набор файлов, внутри которых данные разделены на Row Groups/Segments, где каждый столбец кодируется независимо и может быть закодирован с использованием словарной кодировки, delta-кодирования или иных схем.
- Метаданные и каталогизация: footer/метаданные файлов содержат схему данных, статистику по столбцам и информацию о разделении. Эти данные используются системами обработки запросов (Spark, Trino и т. п.) для планирования чтения и оптимизации выполнения.
- Доступ к данным и десериализация: движки обеспечивают чтение только требуемых столбцов и их декодирование. Это минимизирует I/O и позволяет эффективное использование кэш-памяти. Однако для ML вам часто нужно читать множество столбцов одновременно и выполнять вычисления, для чего может потребоваться дополнительные слои кэширования и на стороне сервера, и на стороне клиента.
- Инструменты обработки и движки исполнения: Apache Spark, Apache Flink, Trino/Presto, Hive и др. выступают как абстракции, которые читают данные из форматов Parquet/ORC и подготавливают DataFrame/таблицы для последующих вычислений, включая машинное обучение.
- Метаданные о признаках и метаданные о потоках: для ML критично иметь базовую и расширенную метаинформацию о признаках, их типах, размерности, взаимосвязях, наличия пропусков и корреляциях. В традиционной аналитике эти данные часто ограничиваются статистикой столбцов, однако для ML требуется более глубокий слой метаданных.
-Регуляторная и аудитная подсистема: управление версиями наборов данных, доступом, прослеживаемостью изменений и политиками удаления должно быть встроено или поддержано на уровне платформы.
Эта декомпозиция демонстрирует, как компоненты работают вместе: файлы форматов обеспечивают сохранность и доступ к данным, движки исполнения - планирование и выполнение, а слои управления метаданными и регуляторной политикой - контроль над жизненным циклом данных и соответствие требованиям.
- Архитектурная модульность и слои абстракций
- Эффективность чтения столбцов vs. вычислительные паттерны ML
- Взаимодействие форматов и движков (Spark, Trino, др.)
- Роль метаданных в ускорении вычислений и регуляторной совместимости
Механизмы и требования машинного обучения к данным: итеративность, нормализация, признаки и взаимодействия
Машинное обучение требует уникальных подходов к подготовке и обработке данных. Основные механизмы и требования к данным включают:
- Итеративность обучения: большинство алгоритмов обучаются через повторные проходы по данным. Градиентный спуск и его вариации требуют многократного доступа к одной и той же выборке признаков с обновлением параметров модели. Это создает высокий спрос на локальные и распределенные кэши, а также на способы эффективного повторного доступа к данным без затрат на повторную загрузку и десериализацию.
- Нормализация и стандартизация признаков: многие алгоритмы требуют приведения признаков к одинаковому масштабу. Это означает, что данные должны быть доступны для предобработки, часто на стороне хранилища или в ближайшем слое вычисления. Реализация таких операций должна учитывать возможность чтения из множества столбцов и их привязки к конкретным операциям.
- Признаки и взаимодействия: ML часто предполагает создание новых признаков или взаимодействий между признаками (например, логарифмические преобразования, полиномиальные взаимодействия). Это требует гибкости в хранении и доступе к широким таблицам признаков и их комбинациям. Поддержка таких операций в формате хранения или рядом с ним должна быть эффективной и не приводить к чрезмерной нагрузке на сеть и CPU.
- Временные и контекстные признаки: данные часто завязаны на временные контексты и последовательности (например, окна прошлых событий, временные серии). Хранение и доступ к таким структурам должны быть оптимизированы для низкой задержки чтения и плавного масштабирования.
- Разреженность и высокая размерность: многие признаки являются разреженными или имеют очень большое число признаков. Эффективное представление таких данных подразумевает хранение в формате, поддерживающем разреженные матрицы и эффективное извлечение ненулевых элементов без нагрузки на пропускную способность.
- Обновление и непрерывный приток данных: ML-пайплайны часто включают обновления и добавления новых наблюдений в реальном времени или near-real-time режимах. Это требует архитектурных решений, которые позволяют вставки и частичные обновления без значительных затрат на переработку уже сохранённых данных.
- Регуляторная согласованность: практики хранения должны поддерживать механизмы удаления данных и соблюдения сроков хранения, а также аудита действий пользователей и процессов обработки данных.
Понимание этих механизмов в контексте подходящих хранений данных формирует критерии выбора между Parquet/ORC и альтернативами. В частности, следует рассмотреть: поддерживает ли формат хранение и эффективное извлечение векторов признаков и временных окон; существует ли нативная поддержка разреженных структур; как оформляются обновления и удаления; каким образом форматы взаимодействуют с инструментами ML-пайплайнов (например, векторные операции в рамках Spark MLlib, PyTorch, TensorFlow).
- Итеративность и требования к повторным чтениям
- Нормализация и функциональные трансформации признаков
- Векторные и временные признаки, их хранение и доступ
- Поддержка разреженных данных и широких матриц
- Влияние архитектуры на задержку и пропускную способность
- Регуляторные и аудиторные требования к данным
Ограничения колоночных форматов для ML: одноразовое сканирование, разреженность, ширина таблиц, обновления
Несмотря на сильные стороны Parquet и ORC, для ML существуют конкретные ограничения, которые требуют внимания на уровне архитектуры и инфраструктуры:
- Одноразовое сканирование и повторная десериализация: колоночные форматы оптимизированы под пакетную обработку, но итеративные ML-алгоритмы часто требуют повторной загрузки одного и того же набора столбцов в рамках каждой эпохи обучения. Это может приводить к повторной десериализации и расчётам, что снижает производительность по сравнению с подходами, фокусирующимися на минимизации повторного чтения.
- Разреженность и ширина таблиц: для ML часто нужны очень широкие таблицы с большим количеством признаков и характерной разреженности. Чтение и десериализация большого числа столбцов может оказаться неэффективным, особенно если многие столбцы пусты или не используются в конкретной эпохе. Метаданные и планирование чтения должны поддерживать выборочное извлечение признаков без избыточной загрузки.
- Обновления и удаление строк: блочная организация и сжатие колоночных форматов усложняют частые вставки и удаления строк. В некоторых случаях требуется удаление данных в соответствии с регуляторными регламентами, что может привести к переработке файлов и снижению производительности. Для ML это особенно важно, когда данные удаляются на уровне личной информации и требуется соблюдение «право на удаление» (right to be forgotten).
- Векторизация и работу с сложными типами: многие ML-алгоритмы работают с векторами признаков, последовательностями и временными окнами. В текущих реализациях Parquet/ORC поддержка таких сложных типов реализована косвенно и не оптимизирована для постоянной работы в реальном времени, что требует дополнительных слоёв кэширования, преобразования и, возможно, альтернативных форматов.
- Регуляторные требования и согласованность: вектора удаления и логика “мягкого удаления” (logical deletion) не всегда удовлетворяют требованиям физического удаления, установленным регуляторными актами. Это создает риск для соблюдения требований к удалению и аудиту.
Эти ограничения подталкивают к рассмотрию альтернатив, а также к созданию архитектурных слоев поверх колонно‑форматов, которые способны компенсировать недостатки в контексте ML.
- Ограничения одноразового сканирования и необходимость повторных проходов
- Проблемы с разреженностью и шириной признаков
- Вопросы обновления данных и удалений
- Поддержка сложных типов и векторных структур
- Вопросы соответствия регуляторным требованиям и безопасного удаления
Векторизация и разреженность: специфические требования ML и влияние на хранение данных
Векторизация и разреженность - ключевые концепты в современных ML задачах, особенно в рекомендательных системах, обработке естественного языка и компьютерном зрении в контексте структурированных данных. Эффективное хранение таких структур требует специальных подходов, которые не всегда полностью поддержаны базовыми колоночными форматами.
- Векторные признаки: многие признаки представляют собой векторы фиксированной длины (например, list
или массивы чисел). В Parquet/ORC такие векторы обычно кодируются как повторяемые элементы или как списки, что требует дополнительной логики для эффективной выборки и последующих вычислений. Поддержка прямого чтения векторных признаков без распаковки даёт преимущества в скорости, но требует соответствующей реализации в формате и в движке. - Разреженность и дельта-кодирование: для разреженных данных характерно хранение только ненулевых элементов и их индексов. В существующих колоночных форматах поддержка таких структур реализуется через словарное и дельта-кодирование, однако эффективность может зависеть от размера словаря и структуры индексов. В ML-истории дельта-кодирование может быть оптимизировано под конкретные окна и паттерны поведения пользователей, что требует адаптивных схем кодирования на уровне хранения.
- Временные окна и последовательности: в ML важны скользящие окна и временные контексты. Хранение таких данных в чисто столбцовых форматах может приводить к дополнительным накладным расходам на навигацию между столбцами и временными контекстами. В альтернативных системах, ориентированных на ML, возможна прямая поддержка векторизированных последовательностей и окон на уровне формата.
- Влияние на ввод-вывод и CPU: разреженность и векторизация требуют разумного баланса между размером хранения и скоростью обработки. Векторизованные чтения требуют минимизации распаковок и конвертаций типов, чтобы снизить CPU-накладные расходы и ускорить обучение.
Практическая рекомендация: для ML‑нагрузок целесообразно иметь гибридный подход. Использовать колоночные форматы как основы для больших, стабильных наборов признаков, где требования к обновлениям минимальны, и дополнять их специальными слоями, поддерживающими векторные данные и разреженность, либо рассмотреть альтернативные форматы, ориентированные на ML (например, Bullion, Nimble) для наиболее динамичных и сложных признаков.
- Признаки-векторы и задачи разреженности
- Временные окна и их представление в хранилище
- Эффективные схемы представления индексов и значений
- Баланс между количеством столбцов и скоростью доступа
- Подход "гибридного хранения": колоночный слой плюс ML-оптимизированные слои
Обеспечение согласованности и обновления данных: вставки, удаления и регуляторные требования
Согласованность данных в ML-пайплайнах - ключ к надежности и воспроизводимости моделей. В сочетании с регуляторными требованиями это превращается в задачу управления жизненным циклом данных на уровне всей экосистемы.
- Вставки и добавления: ML-данные часто пополняются новыми наблюдениями. Эффективная инфраструктура должна поддерживать быстрые вставки и минимальную задержку при обновлении признаков. В колоночных форматах вставки могут потребовать переработки блоков данных или перераспределения парадигмы хранения.
- Обновления: как правило, обновления значений признаков происходят в процессе подготовки данных и повторной обработки. В рамках колонно-форматов обновления строк требуют манипуляций с блоками и, возможно, переработки соседних данных, особенно если обновления затрагивают индексы и статистику столбцов.
- Удаления и регуляторные требования: GDPR, CCPA, CPRA и VCDPA требуют не только доступ к данным, но и их удаления в заданные сроки. В колонно-форматах физическое удаление может требовать перезаписи больших файлов, что неэффективно. Удаление обычно реализуется через вектор удаления (logical deletion) - маркировку строк как удалённых. Но такие подходы не выполняют физического удаления, что может конфликтовать с регуляторными требованиями. Поэтому развиваются решения, которые стремятся к балансу: поддержка векторных индикаторов удаления в сочетании с механизмами физического удаления после некоторых проходов или архивирования.
- Версионирование и аудит: хранение версий датасетов и отслеживание изменений - важная часть соответствия регуляторным нормам. Архитектуры должны обеспечивать детальный аудит доступа к данным, изменений и удалений, обеспечивая возможность «править» (modify) данные в рамках аудита без утечки информации или нарушения конфиденциальности.
Понимание этих механизмов способствует проектированию слоёв хранения и процессов ETL/ELT, которые минимизируют риск сбоев и регуляторные риски.
- Вставки, обновления и удаления в ML-пайплайнах
- Векторизация удаления и физическое удаление
- Аудит и версионирование данных
- Соблюдение сроков удаления и регуляторная совместимость
Регуляторные требования и удаление данных: GDPR, CCPA, CPRA, VCDPA и векторы удаления
Регуляторные требования в отношении персональных данных становятся критическим аспектом проектирования систем хранения для ML. Ниже - основные принципы и их практическая реализация в контексте колоночных форматов.
- GDPR (General Data Protection Regulation) и право на доступ и удаление: регламент требует возможности предоставлять гражданам доступ к их данным и их удаление в определённые сроки. Это требует аудита, контроля доступа и оперативного физического удаления. В колоночных форматах удаление может быть реализовано через вектор удаления, но физическое удаление требует особой обработки и чаще всего переработки файлов данных.
- CCPA/CPRA (California Consumer Privacy Act / California Privacy Rights Act): расширяют право на удаление и ограничение сбора данных, а также вводят требования к уведомлениям. Архитектура должна поддерживать оперативное применение политики удаления и отслеживание состояния удаления.
- VCDPA (Virginia Consumer Data Protection Act) и аналогичные региональные регламенты: дополнительные требования к сбору, хранению и удалению данных, включая ML-нагрузки, где персональные признаки могут входить в наборы данных.
Механизмы удаления в колоночных форматах, такие как вектор удаления (delete vectors), позволяют маркировать строки как удалённые без перезаписи файла. Это ускоряет удаление и снижает IO-нагрузку, но не обеспечивает физическое стирание данных. В рамках регуляторной ответственности может потребоваться последующее физическое удаление данных или управление их жизненным циклом протягом заданного срока. В этой связи целесообразно рассмотреть сочетание подходов:
- Логическое удаление с повышенным контролем доступа и аудита
- Периодическое физическое удаление по расписанию и безопасная переработка файлов
- Архитектура управления жизненным циклом, поддерживающая политики retention и deletion в рамках правовых требований
- Встраивание в пайплайны ML политик минимизации хранения чувствительных признаков и режимов доступа
Резюме: регуляторные требования в ML-проектах требуют сочетания продуманной политики удаления, аудита и контроля доступа, а также поддержки технологий, позволяющих двигаться между быстрым логическим удалением и управляемым физическим удалением данных по регламенту.
- Правовые требования к удалению и аудиту
- Вектор удаления как средство ускорения удаления
- Необходимость физического удаления в рамках регуляторных окон
- Архитектурные паттерны для соблюдения GDPR/CCPA/CPRA/VCDPA
Метаданные и их влияние на производительность: чтение метаданных, десериализация, накладные расходы
Метаданные играют ключевую роль в производительности чтения данных и исполнении запросов. В колоночных форматах метаданные включают схему, типы данных, статистику по столбцам и структуру файлов. Однако, доступ к метаданным может стать узким место в ML-пайплайнах, где часто требуется быстро определить, какие столбцы необходимы, и как их декодировать.
- Статистика столбцов: позволяют движкам оптимизировать планы выполнения (например, исключить сканы столбцов с пропусками, применить статистическую фильтрацию). В ML, где влияние признаков на модель может быть сложным, статистика полезна, но не всегда достаточно для оптимизации трансформаций и векторизации.
- Десериализация и форматы: векторные признаки и сложные типы часто требуют дополнительной обработки при десериализации. Стоимость десериализации может быть высока, особенно при разрежённых данных и больших объемах признаков.
- Накладные расходы на метаданные: чтение и анализ метаданных, включая схемы и структуры вложенных типов, может занять значительное время, особенно при очень широких таблицах. Для ML, где часто требуется доступ к множеству столбцов, эти накладные расходы усиливаются.
- Кэширование и многократное использование метаданных: хороший стратегический подход - кэширование метаданных на уровне движка обработки данных, чтобы минимизировать повторные обращения к файловой системе. Это особенно важно для повторной эксплуатации признаков в рамках эпох ML.
Заключение: метаданные являются критичными для производительности, но в ML они требуют дополнительной доменной информации (например, признаков, их типов и взаимодействий) для эффективного преобразования и обучения. В рамках архитектурной стратегии следует обратить внимание на оптимизацию чтения метаданных и на возможность хранения расширенных метаданных на уровне форматов и слоев хранилища.
- Метаданные как источник ускорения
- Стоимость чтения и десериализации
- Эффективные подходы к кэшированию и планированию выполнения
Альтернативы и архитектурные решения под ML-нагрузки: Bullion и Nimble
С учётом ограничений Parquet и ORC для ML-нагрузок развиваются специализированные архитектуры и форматы, нацеленные на эффективное хранение и обработку признаков и векторов.
- Bullion: колоночная система хранения, адаптированная под ML-рабочие нагрузки. В Bullion основной фокус - оптимизация соответствия данных и кодирования длинных последовательностей разрежённых признаков, эффективное управление проекциями широких таблиц, а также квантование признаков прямо в хранилище. Bullion предлагает каскадную архитектуру кодирования, которая сочетает разные схемы сериализации и обеспечивает прямой доступ к метаданным на нижнем уровне файлов. Основная идея - устранение накладных расходов на чтение метаданных и улучшение скорости доступа к признакам для ML, включая векторные данные и временные окна.
- Nimble: альтернативная архитектура хранения, ориентированная на ML-векторы и динамическое управление признаками. Nimble предполагает интеграцию в ML-пайплайны как слой хранения, который может поддерживать векторы признаков, их квантование и эффективное извлечение для итеративного обучения. В Nimble может быть реализована поддержка таких операций, как хранение временных окон, скользящих признаков и их прямой доступ без многократной десериализации.
Сравнение и выбор между Parquet/ORC, Bullion и Nimble следует рассматривать по нескольким критериям:
- Поддержка признаков и векторов: насколько формат естественно поддерживает векторы признаков, временные окна и разреженность.
- Производительность итеративной обработки: как быстро можно повторно считывать данные по эпохам обучения, без избыточной десериализации.
- Обновления и удаление: насколько быстро и безопасно реализуются вставки, обновления и удаление в рамках регуляторных требований.
- Интеграции и экосистема: совместимость с Spark, Trino, ML-пайплайнами и инструментами для управления данными и моделью.
Bullion демонстрирует возможность значительного повышения производительности для ML‑работы за счет специализированной кодировки и управления метаданными, в то время как Nimble фокусируется на расширенной поддержке векторов признаков и эффективной работе с временными окнами. В сочетании с технологической инфраструктурой Data Lake / LakeHouse и инструментами Spark и Trino эти архитектуры могут обеспечить более предсказуемые сроки обучения, меньшие затраты на IO и улучшенную регуляторную соправа.
- Bullion: фокус на векторных признаках, разреженности и временных окнах
- Nimble: поддержка ML-векторных структур и быстрые обновления признаков
- Сценарии выбора в зависимости от нагрузки: стабильные наборы признаков vs динамические и разреженные признаки
- Интеграции в экосистему: Spark/Trino и данные в Data Lake / LakeHouse
Интеграция технологических стеков и синергия между слоями: Data Lake, LakeHouse, Spark, Trino и др.
Эффективная архитектура хранения для ML требует взаимосвязи между слоями: хранилища данных, вычислительными движками, инструментами управления данными и ML-обучения. В этом контексте архитектуры Data Lake, LakeHouse и сопровождение поверх них являются основой.
- Data Lake: традиционная концепция централизованного хранилища сырых данных, включая структурированные, полуструктурированные и неструктурированные данные. Data Lake обеспечивает масштабируемость и гибкость, но может страдать от проблем с управлением схемой и качеством данных.
- LakeHouse: концепция, объединяющая лучшие стороны Data Lake (масштабируемость и гибкость) и Data Warehouse (структурированность, транзакционность и консистентность). LakeHouse обеспечивает ACID‑совместимость и единое место для хранения данных и моделей. В LakeHouse возможно хранение обучающихся наборов данных и признаков, а также интеграцию с инструментами ML и аналитики.
- Spark: широко применяемый движок для обработки больших данных. Он поддерживает работу с Parquet/ORC и интегрируется с MLlib - модулем для ML. Spark обеспечивает гибкую обработку данных, включая сложные преобразования признаков и поддержку графий, временных окон и векторизации.
- Trino (ранее Presto): распределённый движок для выполнения SQL-запросов над большими данными. Он хорошо интегрируется с Parquet/ORC, и может служить слоем дешёвого доступа к данным из ML-процессов.
- Catalog и управление метаданными: Hive Metastore, AWS Glue и другие каталоги играют роль в управлении схемами, версионностью и совместной работой между системами. Метаданные в каталоге обеспечивают согласованность между слоями хранения и вычисления.
Синергия между слоями достигается через:
- Адаптацию схем и правил доступа к данным: единая политика доступа и разделение по ролям, поддержка аудита и журналирования.
- Общий формат хранения признаков и набора данных: согласование форматов и версий между Data Lake, LakeHouse и ML-пайплайнами.
- Неформальные индексы и кэширование: кэширование часто запрашиваемых признаков в слоях вычисления и в промежуточных слоях.
- Обеспечение управления жизненным циклом: retention policies, deletion scripts, правовые требования должны быть согласованы между слоями и источниками данных.
- Встраивание ML-операций в ETL/ELT-процессы: данные подготавливаются и агрегируются для обучения, а затем используются для обучения и валидации моделей.
Практические принципы интеграции:
-
Использовать LakeHouse как единое место для хранения «базовых» датасетов, признаков и результатов обучения
-
Совместно управлять схемами и версиями в каталоге
-
Распределить задачи на слои: Data Lake для хранилища, Spark/Trino для вычислений и подготовки данных, ML-платформы для обучения и валидации
-
Обеспечить консистентность сетей и доступ к данным между слоями
-
Data Lake / LakeHouse
-
Spark и Trino
-
Каталоги метаданных и схем
-
Обеспечение регуляторной совместимости и аудита
-
Практические паттерны для организации признаков и обучающих данных
Практические кейсы применения в реальных ML-сценариях
Реальные кейсы демонстрируют, как архитектурные решения влияют на эффективность ML-пайплайнов и бизнес-результаты.
- Кейсы в клиентской рекомендации: хранение и обработка длинных последовательностей кликов и взаимодействий, где признаки - векторы, а window-подходы применяются для формирования временных контекстов. В таких задачах хорошо работают VL (vectorized learning) подходы и ML-ориентированные форматы, которые позволяют ускорить итеративный процесс обучения.
- Кейсы в здравоохранении: анализ медицинских данных, включающих чувствительные признаки, регуляторную политику и необходимость актуального удаления данных. Архитектура должна обеспечивать соответствие требованиям GDPR и аналогичных регуляторных актов.
- Кейсы в банковской сфере: обнаружение мошенничества и риск-менеджмент, с большими потоками признаков и временными рядами. В таких случаях важно мгновенное получение доступа к признакам и поддержка молниеносной обработки в связке с ML-пайплайнами.
- Кейсы в телеком-индустрии: оптимизация сетевых и клиентских услуг на основе последовательных и векторных признаков, где молниеносная обработка признаков и управляемое удаление данных необходимы для соответствия требованиям к приватности и аудиту.
- Кейсы в розничной торговле: анализ поведения покупателей и персонализация предложений на основе широких и разрежённых наборов признаков.
Эти кейсы демонстрируют, что ML-проекты выигрывают от архитектур, которые поддерживают векторные признаки, временные окна и быстрые обновления, а также гибко реагируют на регуляторные требования.
- Кейсы по ML-пайплайнам и признакам
- Кейсы по регуляторному соответствию
- Кейсы по интеграции в LakeHouse и распределенные вычисления
- Кейсы по производительности и экономике
Применение в экономических секторах: банковский сектор, телеком, розничная торговля, здравоохранение
- Банковский сектор: ML-решения для кредитного скоринга, мошенничества и операционного риска требуют высокой точности и прозрачности. Важно сочетать высокую скорость доступа к признакам с управлением жизненным циклом данных и аудируемостью.
- Телекоммуникации: множество признаков по пользователям и устройствам, временные окна, поведенческие сигналы. Архитектура хранения должна поддерживать быстрое извлечение признаков в реальном времени и эффективное обновление.
- Розничная торговля: персонализация и рекомендации формируют объём данных с большим количеством признаков и вариаций. Важна поддержка широких таблиц и временных окон, а также эффективные механизмы удаления и архивирования данных по регуляторным требованиям.
- Здравоохранение: хранение чувствительных признаков и наборов данных требует строгих правил конфиденциальности и соответствия регуляторным требованиям. Встроенные механизмы удаления, аудита и защиты данных должны быть частью архитектуры.
Эти сектора демонстрируют, как архитектура хранения для ML должна адаптироваться под специфические требования регуляторики, скорости и конфиденциальности. В каждом секторе важны баланс между производительностью, стоимостью хранения и соответствием нормативам.
- Банковский сектор: точность, аудит, скорость доступа к признакам
- Телекомы: реальное время, временные окна, поведенческие признаки
- Розничная торговля: широкие таблицы, персонализация, регулятивная совместимость
- Здравоохранение: конфиденциальность, удаление, аудит
Анализ рисков и ограничений с метриками эффективности: производительность, точность, стоимость, регуляторные риски
Управление рисками в ML-проектах требует определения и контроля ключевых показателей эффективности (KPI):
- Производительность: скорость загрузки признаков, время до первого куска данных, задержка между эпохами обучения, пропускная способность IO, эффективность сжатия.
- Точность модели и соответствие данным: корректность признаков, качество подготовки данных, устойчивость к шуму в данных и соответственно точность моделей.
- Стоимость: затрат на хранение, обработку, инфраструктуру и запуск пайплайнов. В ML-хранилищах важна экономичность в отношении IO-операций и вычислений.
- Регуляторные риски: соответствие GDPR/CCPA/CPRA/VCDPA, сроки удаления, аудитирование, управление правами доступа и сохранением данных.
Рекомендации по управлению рисками:
-
Внедрить многоуровневую стратегию хранения признак-слоёв (layered feature store) с поддержкой версий, аудита и политики удаления.
-
Использовать альтернативные форматы (Bullion, Nimble) для динамичных признаков и временных окон, а Parquet/ORC - для устойчивых признаков.
-
Реализовать детальную политику retention и удаления, согласовав её с регуляторными требованиями и бизнес-процессами.
-
Вести мониторинг производительности по секциям пайплайна: чтение metadata, скорость доступа к признакам, время обучения, затраты на хранилище.
-
KPI по производительности и затратам
-
KPI по регуляторным требованиям и аудитам
-
KPI по точности и устойчивости моделей
-
KPI по управлению жизненным циклом данных
Конкурентный анализ решений и их дифференциация: Parquet/ORC vs Bullion vs Nimble
- Parquet/ORC: продвинутые колоночные форматы, отлично подходят для SQL-аналитики и пакетной обработки. Их сильные стороны - эластичное масштабирование, поддержка вложенных типов и эффективное сжатие. Но они не оптимизированы для итеративной ML-настройки признаков, де-факто ограничены в частоте обновления и работе с широкими разреженными структурами.
- Bullion: ML-ориентированная колоночная система, заточенная под сложные признаки и разреженные данные. Предлагает продвинутые режимы кодирования и квантования признаков, эффективную работу с временными окнами и прямой доступ к метаданным. Это решение хорошо подходит для сценариев, где признаки меняются динамично и требуются быстрые вычисления на уровне сегментов данных.
- Nimble: архитектура, ориентированная на хранение и обработку векторных признаков и ML-специфических структур. В Nimble приоритет - максимальная скорость доступа к признакам, эффективная обработка векторных операций и поддержка сложных типов данных для ML.
Дифференциация решений:
- Интенсивность векторной обработки и поддержка разреженности
- Поддержка временных окон и последовательностей признаков
- Специализация на обновлениях и управлении жизненным циклом
- Регуляторные инструменты и аудит
- Интеграции с Spark/Trino и экосистемой LakeHouse
- Стоимость владения и сложность внедрения
Выбор между решениями зависит от характера ML-нагрузки: если проект обладает стабильными признаками и ограниченным числом обновлений, Parquet/ORC может быть достаточно. При этом для динамичных наборов признаков, требуетющих ускоренной итеративной обработки, векторизация и расширенная работа с признаками, Bullion и Nimble могут принести существенные преимущества.
- Какие признаки и какие режимы обновления
- Нужна ли поддержка временных окон и векторов признаков
- Регуляторные требования и аудит
- Интеграции в существующую стековую экосистему
- Экономика владения
Перспективы развития и направления исследований в области хранения для ML
Перспективы в области хранения данных для ML включают развитие форматов и механизмов, нацеленных на удовлетворение растущих требований ML-пайплайнов:
-
Расширение поддержки векторных типов и временных структур на уровне форматов хранения. Включение нативной поддержки многомерных векторов признаков и временных окон может снизить расходы на десериализацию и ускорить вычисления.
-
Развитие гибридных форматов, которые комбинируют сильные стороны колоночного хранения и нереляционных структур. Это позволит объединять преимущества пакетной аналитики и итеративного обучения.
-
Улучшение механизмов удаления данных и поддержки физического удаления в рамках регуляторных требований без существенного влияния на производительность. Это может включать более гибкие схемы кодирования, позволяющие отделить удаляемые строки от остальных данных без перерасхода IO.
-
Эффективное объединение ML-пайплайнов и хранилищ признаков через LakeHouse-архитектуру; активное развитие каталогов, версионности и аудита, облегчение повторного использования признаков.
-
Внедрение аппаратной поддержки и ускорителей: NBV, GPU-кэширование, аппаратное ускорение кодирования/декодирования, а также оптимизация под современные ускорители для векторных операций.
-
Нативная поддержка векторных данных
-
Гибридные форматы и смешанные подходы
-
Физическое удаление данных и регуляторика
-
Архитектура LakeHouse и управление признаками
-
Аппаратное ускорение и ускорители
Заключение
Хранение данных для машинного обучения - область, где классические колоночные форматы Parquet и ORC показывают сильные стороны в контексте аналитики, но сталкиваются с значимыми ограничениями в задачах ML. Итеративность обучения, сложные и разреженные признаки, временные контексты, обновления и строгие регуляторные требования требуют пересмотра подходов к архитектуре хранения. В ответ на эти вызовы развиваются ML-оптимизированные форматы и системы, такие как Bullion и Nimble, которые дополняют колоночные хранилища, соответствуя характеристикам современных ML-пайплайнов.
Оптимальная стратегия состоит в сочетании слоёв: использовать Parquet/ORC как базовую платформу для устойчивых, нечасто изменяемых признаков, в сочетании с ML-оптимизированными альтернативами для динамичных и разрежённых признаков; строить архитектуру LakeHouse с интеграциями в Spark и Trino; поддерживать регуляторные требования через продуманное управление данными и аудит.
Эта концепция обеспечивает не только высокую производительность и экономическую эффективность, но и соответствие регуляторным требованиям, прозрачность и управляемость, необходимые для современных корпоративных ML‑инициатив. В дальнейшем развитие форматов, поддержка векторных структур и усиление интеграций с инструментами обработки данных будут определять темп прогресса в области хранения данных для ML и цифровой трансформации бизнеса.
- Подытог по ключевым концепциям и практикам
- Векторная обработка признаков и разреженность как драйвер архитектур
- Регуляторные требования как фактор дизайна
- Роль Bullion и Nimble в эволюции хранения для ML
- Взгляд в будущее: синергия форматов, слоёв и вычислительных технологий
Вопрос-Ответ:
- Вопрос: Какие форматы хранения предпочтительнее для итеративного ML?
Ответ: В сценариях с интенсивной итеративностью лучше сочетать Parquet/ORC для базовых признаков и ML‑ориентированные решения вроде Bullion/Nimble для динамичных и разрежённых признаков, чтобы минимизировать повторные сканы и ускорить обновления. - Вопрос: Как обеспечить соответствие GDPR при использовании колонночных форматов?
Ответ: Реализуйте вектор удаления с аудитом и планами физического удаления, применяйте политики retention, версионирование данных и интегрируйте эти механизмы в архитектуру LakeHouse. - Вопрос: Какие аспекты следует учитывать при выборе между Parquet/ORC и Bullion?
Ответ: Оценка должна включать поддержку векторов признаков и временных окон, частоту обновлений, потребность в физическом удалении, способность работать с регуляторными требованиями, а также интеграцию с существующей экосистемой. - Вопрос: Какой роль играет метаданные в производительности ML‑пайплайнов?
Ответ: Метаданные критичны: они ускоряют ветвление планов, выборку признаков и минимизируют десериализацию. Расширенные метаданные, включая структурированные признаки, временные контексты и статистику, повышают эффективность обучения. - Вопрос: Какие перспективы развития хранения для ML стоит наблюдать в ближайшие годы?
Ответ: Ожидается усиление нативной поддержки векторных данных и временных окон, развитие гибридных форматов и механизмов физического удаления, рост LakeHouse‑архитектур и углубление интеграции с ускорителями и ML‑платформами.


