

Реальное время: настройка и практики near real-time аналитики
Современные требования к аналитике требуют не только высокоскоростных запросов, но и способности носить данные в модельном виде практически в реальном времени. Apache Doris как распределенная OLAP-база данных спроектирована под такие сценарии: параллельная обработка, эффективная компрессия столбцовых форматов и быстрый путь от потока данных к интерактивным дашбордам. Глава фокусируется на практиках настройки и эксплуатации near real-time аналитики в Doris: архитектурные принципы, конвейеры загрузки, управление латентностью и качество данных, мониторинг и сценарии внедрения.
Near real-time аналитика подразумевает достижение минимальной задержки между событиями в источнике данных и их видимостью в аналитических запросах. В Doris это достигается за счет продуманной архитектуры MPP, оптимизации загрузки данных и гибких механизмов обновления сегментов. В контексте реального применения важны как технические решения по ingestion и хранению, так и процессы оперативной эксплуатации: мониторинг, автоматизация, устойчивость к сбоям и возможность быстрого масштабирования.
Краткое содержание главы
- Архитектура Doris и принципы реализации near real-time: какие слои задействованы, как организована параллельная обработка и репликация.
- Конвейеры загрузки данных и источники: потоковые источники, CDC, микро-архитектура загрузки и стратегии устранения задержек.
- Оптимизация загрузки и управления латентностью: партиционирование, уплотнение сегментов, настройка параметров загрузки и константы времени видимости.
- Консенсус, консистентность и корректность данных: модели гарантии, последовательность обновлений, обработка ошибок и повторные попытки.
- Мониторинг, диагностика и эксплуатационные практики: метрики, алерты, трассировка запросов и нагрузочного тестирования.
- Интеграции и сценарии внедрения: практики внедрения Doris в существующие пайплайны и примеры архитектурных решений.
Архитектурные основы near real-time в Doris
Doris строится на распределенной архитектуре с разделением функций между Frontend (FE) и Backend (BE). FE отвечает за хранение метаданных, планирование запросов и управление схемами, тогда BE выполняет хранение факта данных, параллельную обработку запросов и репликацию сегментов. Такая структура обеспечивает горизонтальное масштабирование и возможность horizontally масштабировать как ingestion, так и вычисления.
Особенно важны для near real-time аспекты:
- параллельная обработка: запросы распараллеливаются по сегментам и партициям, что позволяет достигать интерактивности даже на больших объемах;
- колонная организация хранения: сжатие и векторизация ускоряют сканирование нужных столбцов при агрессивных фильтрах;
- механизмы инкрементного обновления: Doris поддерживает режимы загрузки данных, которые делают видимыми новые данные относительно текущего состояния репликации;
- консистентность и временные метки: в реальном времени часто критично сохранять порядок обновлений для корректной агрегации по временным окнам.
Ключевым преимуществом является возможность гибкой настройкиCommodity-пути загрузки: данные могут поступать потоками через потоковые конвейеры и выдерживать микро-батчи в рамках заданных окон латентности. В архитектуре Doris предусмотрены тонкие нити между ingestion и запросами: сегменты, которые попадают в любую партию, индексируются и становятся видимыми для запросов в пределах заданной латентности, что особенно важно для дашбордов и мониторинга в реальном времени.
Для практической реализации следует помнить об особенностях репликации и локальности данных. Репликация в Doris обеспечивает отказоустойчивость и стабильную доступность, однако она может влиять на латентность записи. В ситуации near real-time важно балансировать между уровнем репликаций, временем компрессии и задержками консолидированной записи. В этом контексте разумна политика выбора числа реплик для целевых кластеров: больше реплик - выше устойчивость к сбоям, меньше - ниже задержки на запись. Оптимальные параметры следует подбирать под характер нагрузки: интенсивные потоки событий, разделение по временным окнами, частота обновлений и требования по SLA.
Важно также отметить схему управления схемами и эволюцией схем. В реальном времени любые изменения структуры таблиц могут повлиять на доступность данных и на совместимость с текущими загрузками. Таким образом, применяются стратегии обратимой эволюции схемы: добавление столбцов без блокировок, поддержка дефолтных значений и пошаговые миграции с минимальным влиянием на текущие потоки.
Настройки и принципы
- использование партиций по времени или по другим критериям позволяет ограничить сканируемый объем при запросах и ускорить обработку.
- выбор формата столбцов и типов, оптимизированных под агрегацию и фильтрацию по временным окнам.
- балансировка между латентностью ingest и латентностью запроса: увеличение размера микро-батчей может снизить нагрузку на сеть и перевести латентность в приемлемые рамки, но риск задержки для очень частых обновлений.
Конвейеры загрузки данных и источники
Real-time и near real-time аналитика требует четко очерченных конвейеров ingestion данных. Doris поддерживает несколько сценариев загрузки, которые можно комбинировать в единой архитектуре:
- потоковые источники: data streams из Kafka, Pulsar или других систем публикуются в конвейер, после чего данные попадают в Doris через механизмы ingestion. Подход обеспечивает минимальные задержки между событием и отображением в аналитике, но требует строгого контроля порядка и идемпотентности загрузок.
- CDC-потоки: CDC-источники позволяют регистрировать изменения в исходных системах (например, измененные строки из оперативной базы). В Doris CDC-данные оборачиваются в обновления и применяются к аналитическим таблицам, что облегчает синхронизацию между операционными системами и аналитическим слоем.
- микро-батчи и пакетная передача: для случаев, когда цель - баланс между задержкой и надлежащей консистентностью, можно использовать микро-батчи с ограниченным временем задержки. Это снижает стоимость частых коммитов и упрощает контроль консистентности.
- загрузка в хранилище (HDFS/S3) как источник для ближнего к реальному времени экспедирования: данные выгружаются в объектное хранилище и затем загружаются в Doris через Stream Load или Broker Load. Такой подход хорошо подходит для исторических архиваций и документирования цепочек событий.
Практические принципы организации конвейеров:
- проектирование конвейера с учётом порядка событий: гарантировать, что последовательность обновлений сохраняется корректно для окон времени или агрегатных функций.
- обеспечение идемпотентности загрузок: повторные попытки должны приводить к одному и тому же состоянию таблицы.
- выпуск сигнала готовности данных: после загрузки данных в Doris должно быть понятно, какие сегменты обновлены и какие окна времени уже доступные для анализа.
- мониторинг задержек на каждом узле конвейера и на уровне загрузки Doris: чем выше задержки на входе, тем выше задержка к видимости в запросах.
Можно привести упрощенный образец потока интеграции: источник CDC → обработчик изменений → микро-батчи → Doris через потоковую загрузку. Обработчик изменений обеспечивает сортировку, компрессию и коррекцию ошибок, после чего данные попадают в Doris и становятся доступными для анализа через интерактивные запросы.
Оптимизация загрузки и управление латентностью
Чтобы реальная аналитика была действительно ближней к реальному времени, необходимо оптимизировать каждый элемент конвейера загрузки и хранения данных.
- Партиционирование по времени: разделение таблиц на временные партиции позволяет ограничить диапазон данных, который нужно сканировать для конкретного запроса. Это снижает задержку и повышает пропускную способность.
- Управление сегментами и компрессией: Doris использует сегменты данных; их объединение и уплотнение должно происходить без блокировок и без сильной задержки для текущих запросов. Регулярное сжатие данных снижает требования к дисковому пространству и ускоряет сканирование.
- Настройки микро-батчей: размер и частота микробатчей должны соответствовать характеру нагрузки. Микробатчи слишком маленькие приводят к большему number of IO операций, слишком крупные - к задержкам ввода и обработки.
- Эволюция схем без простоя: добавление новых столбцов или изменение типов следует делать без отклонений в доступности данных. Важна стратегия дефолтных значений и нулевых значений, чтобы существующие загрузки не ломались.
- Конфигурация потокового канала: буферы и ретрансляторы должны обладать разумной задержкой и устойчивостью к перегрузкам, чтобы не вызывать лавин в задержках при пиковых нагрузках.
Реалистичные рекомендации для инженерной команды:
- тестирование новых параметров на стейдж-среде с emulate-данными, близкими к боевым пакетам;
- введение ограничений скорости ingest и квот, чтобы не перегружать кластер;
- настройка политики резервного копирования и аварийного восстановления на случай сбоев конвейера;
- внедрение сигналов «где мы сейчас» по каждому конвейеру: ingestion, консолидация, видимость в запросах.
Обеспечение консистентности и латентности
Near real-time требует баланса между латентностью и корректностью данных. Doris поддерживает механизмы, которые помогают сохранять ожидаемую целостность и порядок обновлений при различных сценариях загрузки.
- последовательность обновлений: в рамках потоков и CDC важно поддерживать порядок событий в пределах окна времени или в рамках ключевых таблиц. Данные должны быть доступны в предсказуемом виде и без «разбросов» по времени, которые затрудняют агрегацию.
- режим консистентности: выбор между более строгими и более гибкими настройками зависит от бизнес-требований. В некоторых случаях допустима eventual-consistency на коротких интервалах, в других - необходим строгий порядок обновлений.
- обработка ошибок и повторные попытки: повторные загрузки должны быть идемпотентны и не приводить к дублированию. Встроенные механизмы обработки ошибок помогают быстро восстанавливать поток без потери данных.
- видимость данных: после загрузки сегменты становятся доступными для выполнения запросов. Важна синхронизация между операционными источниками и аналитической частью, чтобы не было рассинхронности в представлениях по времени.
- архитектурные подходы к задержке: можно настраивать «окна» (windows) для агрегаций, чтобы минимизировать влияние задержек на агрегаты реального времени, сохраняя точность и согласованность вычислений.
Практические сценарии:
- для real-time дашбордов применяются окна скользящего суммирования и средних на временных интервалах в пределах пары секунд - для таких окон важно минимизировать задержку от ingest до отображения.
- для бизнес-аналитики в реальном времени часто требуется сочетание краткосрочных окон (минуты) и долгосрочных горизонтов (часы, дни); архитектура должна поддерживать параметры агрегации и перерасчета без задержек повторной загрузки.
Практики мониторинга и диагностики
Эффективная near real-time аналитика невозможна без глубокого мониторинга всех компонентов конвейера загрузки и выполнения запросов.
- метрики ingestion: скорость поступления событий, размер очередей, задержки на входе и выходе конвертера, уровень ошибок загрузки, частота повторных попыток.
- метрики исполнения запросов: латентность выполнения запросов, распределение времени выполнения, загрузка узлов BE и FE, пропускная способность сети между компонентами кластера.
- консистентность и задержки данных: индикаторы задержки между исходом изменений и их видимостью в таблицах Doris, показатели задержек по каждому окну времени.
- мониторинг ресурсов: использование CPU, памяти, сетевых каналов, ввода-вывода на диске, а также kesehatan дисковых пулов и балансов нагрузки между узлами.
- инструменты и виджеты: Prometheus/Grafana обычно применяются для сборки и визуализации метрик, JVM-метрик, состояния кластера и устойчивости к сбоям. Встроенные дашборды Doris также могут служить точкой входа для поверхностной оценки.
Практика: внедрять алерты по порогам пропускной способности и задержек, а также автоматизированные проверки последовательности операций. Регулярные стрес-тесты и регрессионные тесты на ingestion помогают обнаруживать деградацию на ранних этапах.
Интеграции и сценарии внедрения
Doris хорошо подходит для интеграции в современные дата-платформы, где присутствуют конвейеры событий и оперативной аналитики. Практические сценарии внедрения включают:
- real-time дашборды поверх событийных данных: прямой поток из источников сообщений в Doris, с агрегацией по временным окнам и быстрым откликом на изменения в источнике.
- консолидация данных из оперативных систем в единый аналитический слой: CDC-потоки собирают изменения и применяют их к аналитическим таблицам Doris, что упрощает сопоставление данных из разных источников.
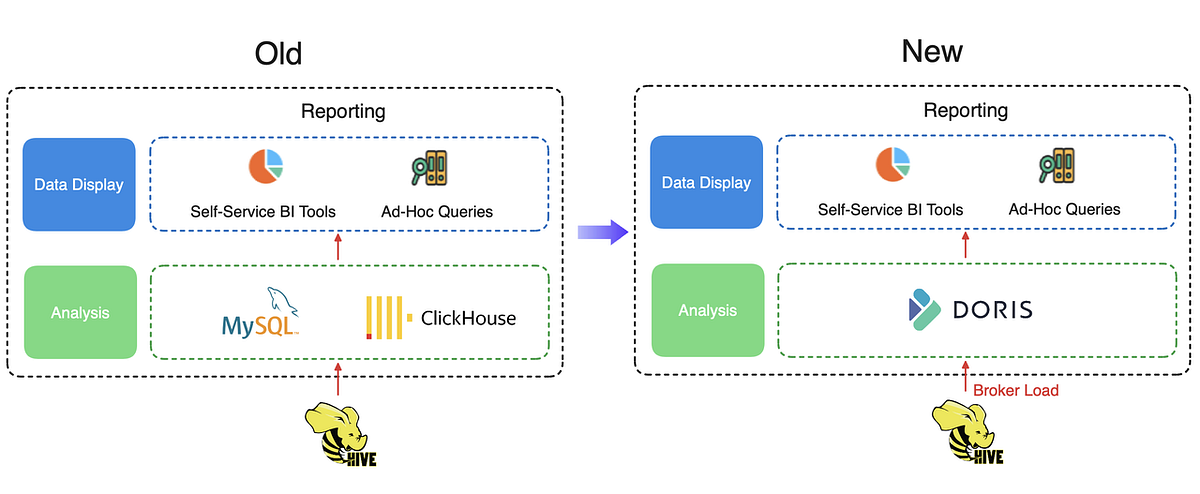
- модернизация существующих систем: замещение устаревших OLAP-слоев Doris и интеграция с существующими пайплайнами через единый конвейер загрузки и совместную схему данных.
- масштабируемые архитектуры для региональных и глобальных приложений: репликация и распределение нагрузки по нескольким дата-центрам обеспечивают доступность и минимальные задержки для пользователей по всему миру.
Иногда целесообразно ограничиться одним из сценариев в первый этап проекта, а затем постепенно расширять конвейеры и подключать новые источники. При выборе интеграций следует учитывать совместимость форматов, требования к порядку обновлений и ограничения по задержкам.
Key takeaways
- near real-time аналитика в Doris достигается за счет сочетания архитектурной поддержки MPP, эффективного хранения столбцов и продуманных конвейеров ingestion.
- потоковые источники и CDC являются ключевыми компонентами для быстрого обновления данных, однако требуют идемпотентности и контроля порядка событий.
- оптимизация загрузки опирается на партиционирование по времени, разумную компрессию и балансировку между размером микробатчей и задержками ввода.
- консистентность должна соответствовать бизнес-требованиям: возможно введение окон и режимов видимости данных, чтобы обеспечить predictable behavior для аналитики в реальном времени.
- мониторинг и диагностика должны охватывать все элементы конвейера: ingestion, выполнение запросов, задержки и ресурсы кластера; автоматические алерты и стресс-тесты необходимы для поддержания SLA.
- интеграции Doris в существующие пайплайны требуют четкой архитектурной дорожной карты, выбора сценариев внедрения и поэтапного расширения функциональности.
- правильное проектирование процессов, документация и управление изменениями схемы существенно снижают риск простоя и допускают рост объема данных и пользователей.
FAQ
- Что такое near real-time аналитика в Doris и чем она отличается от обычной OLAP-аналитики?
- Near real-time аналitika в Doris ориентирована на минимальную задержку между событием в источнике и его отображением в аналитике. В отличие от пакетной или слишком задержанной OLAP-аналитики, здесь акцент на потоковых конвейерах, микро-батчах и быстром доступе к обновленным данным. Архитектура Doris поддерживает параллельную обработку и репликацию, что позволяет сохранять высокую скорость загрузки и интерактивную латентность запросов, необходимую для дашбордов и оперативной аналитики.
- Какие источники данных лучше использовать для near real-time в Doris?
- Для потоковой аналитики подходят источники сообщений, такие как Kafka или Pulsar, с CDC-потоками из оперативных систем. Важно обеспечить порядок обновлений внутри окон времени и идемпотентность загрузок. Для исторической поддержки и дополнительных слоев данных применяются загрузки из HDFS/S3 через Stream Load или Broker Load. Выбор зависит от частоты обновлений, требований к консистентности и доступной инфраструктуры.
- Какой подход к загрузке данных обеспечивает минимальную латентность?
- Эффективный подход - комбинирование потоковой загрузки с микро-батчингом. Микробатчи уменьшают частоту обращений к бекэндам и позволяют сгладить пики трафика, а параллельная обработка в BE ускоряет видимость данных. Важно настроить размер батча, задержки и порядок обновлений в рамках окон времени, чтобы балансировать задержку и точность.
- Как обеспечить консистентность данных при реальном времени?
- Необходимо определить требования к порядку обновлений и выбрать подходящий режим видимости. В Doris можно применить оконные агрегации и последовательность обновлений для конкретных ключей, поддерживая union-таблицы и корректное применение изменений. Обработка ошибок и повторные попытки должны быть идемпотентными, чтобы избежать дублирования.
- Какие метрики наиболее важны для мониторинга near real-time архитектуры Doris?
- Важны метрики ingestion: скорость поступления, задержки на входе, размер очередей и частота ошибок загрузки. Также критичны метрики исполнения запросов: задержка, распределение времени выполнения и нагрузка на BE/FE. Мониторинг ресурсов: CPU, память, I/O, сеть и состояние кластера. Наличие дашбордов и алертов по SLA помогает поддерживать реальное время.
- Какие трудности встречаются при внедрении near real-time в действующую систему?
- Основные трудности: согласование транзакционных границ между источниками и аналитикой, поддержка порядка обновлений в потоках, идемпотентность загрузок, а также управление ростом объема данных и временем отклика при пиковых нагрузках. Решения включают проектирование конвейеров с явной версией схемы, тестирование на стейдж-средах и постепенное внедрение.
- Как выбрать параметры партиционирования для реального времени?
- Рекомендовано партиционирование по времени и по характерным ключам бизнес-процесса. Это снижает количество сканируемых данных для типичных запросов, ускоряет агрегацию и уменьшает латентность. Важно заранее продумать политики архивирования и очистки старых данных, чтобы не повредить производительность.
- Какие существуют подходы к масштабированию Doris под near real-time?
- Масштабирование по горизонтали за счет добавления BE-узлов и перераспределения сегментов. В случае глобальных сценариев - географическая дистрибуция и локальные кластеры с агрегацией на уровне глобального вида. Важна корректная настройка репликации и балансировки нагрузки, чтобы сохранить латентность и устойчивость.
- Какие риски и как их минимизировать?
- Риски: задержки на входе в конвейер, несоблюдение порядка обновлений, дублирование данных, перегрузка кластера во время пиков. Меры снижения: идемпотентные загрузки, строгие проверки последовательности, ограничение скорости ingest, автоматизация аварийного восстановления, резервы ресурсов и регулярный стресс-тест.
- Какие открытые решения и интеграции полезны вместе с Doris?
- В малой форме можно упомянуть интеграции с Kafka/Pulsar для потоковых данных и CDC-источниками, а также возможность использования облачных хранилищ (S3/HDFS) для долговременного архива и загрузок. В рамках российского контекста можно рассмотреть открытые инструменты для мониторинга и интеграции, но следует ограничить число примеров одним-два, чтобы сохранить фокус на функциональности Doris и не перегружать материал.
Глава охватывает принципы, которые позволяют проектировать и эксплуатировать near real-time аналитические решения на базе Apache Doris под реальные бизнес-задачи. Правильная комбинация архитектурных решений, долговременных конвейеров, продуманной стратегии мониторинга и эффективной интеграции с источниками данных позволяет достигать не только высокой скорости аналитики, но и устойчивости к сбоям, расширяемости и управляемости в условиях динамичной операционной среды.


