

Архитектура Data Vault
Этот курс посвящён проектированию корпоративного хранилища данных на базе Data Vault и раскрывает его как гибкую и масштабируемую архитектуру для работы с историчными данными. Он показывает, как строить DWH, устойчивый к изменениям источников и бизнес-требований.
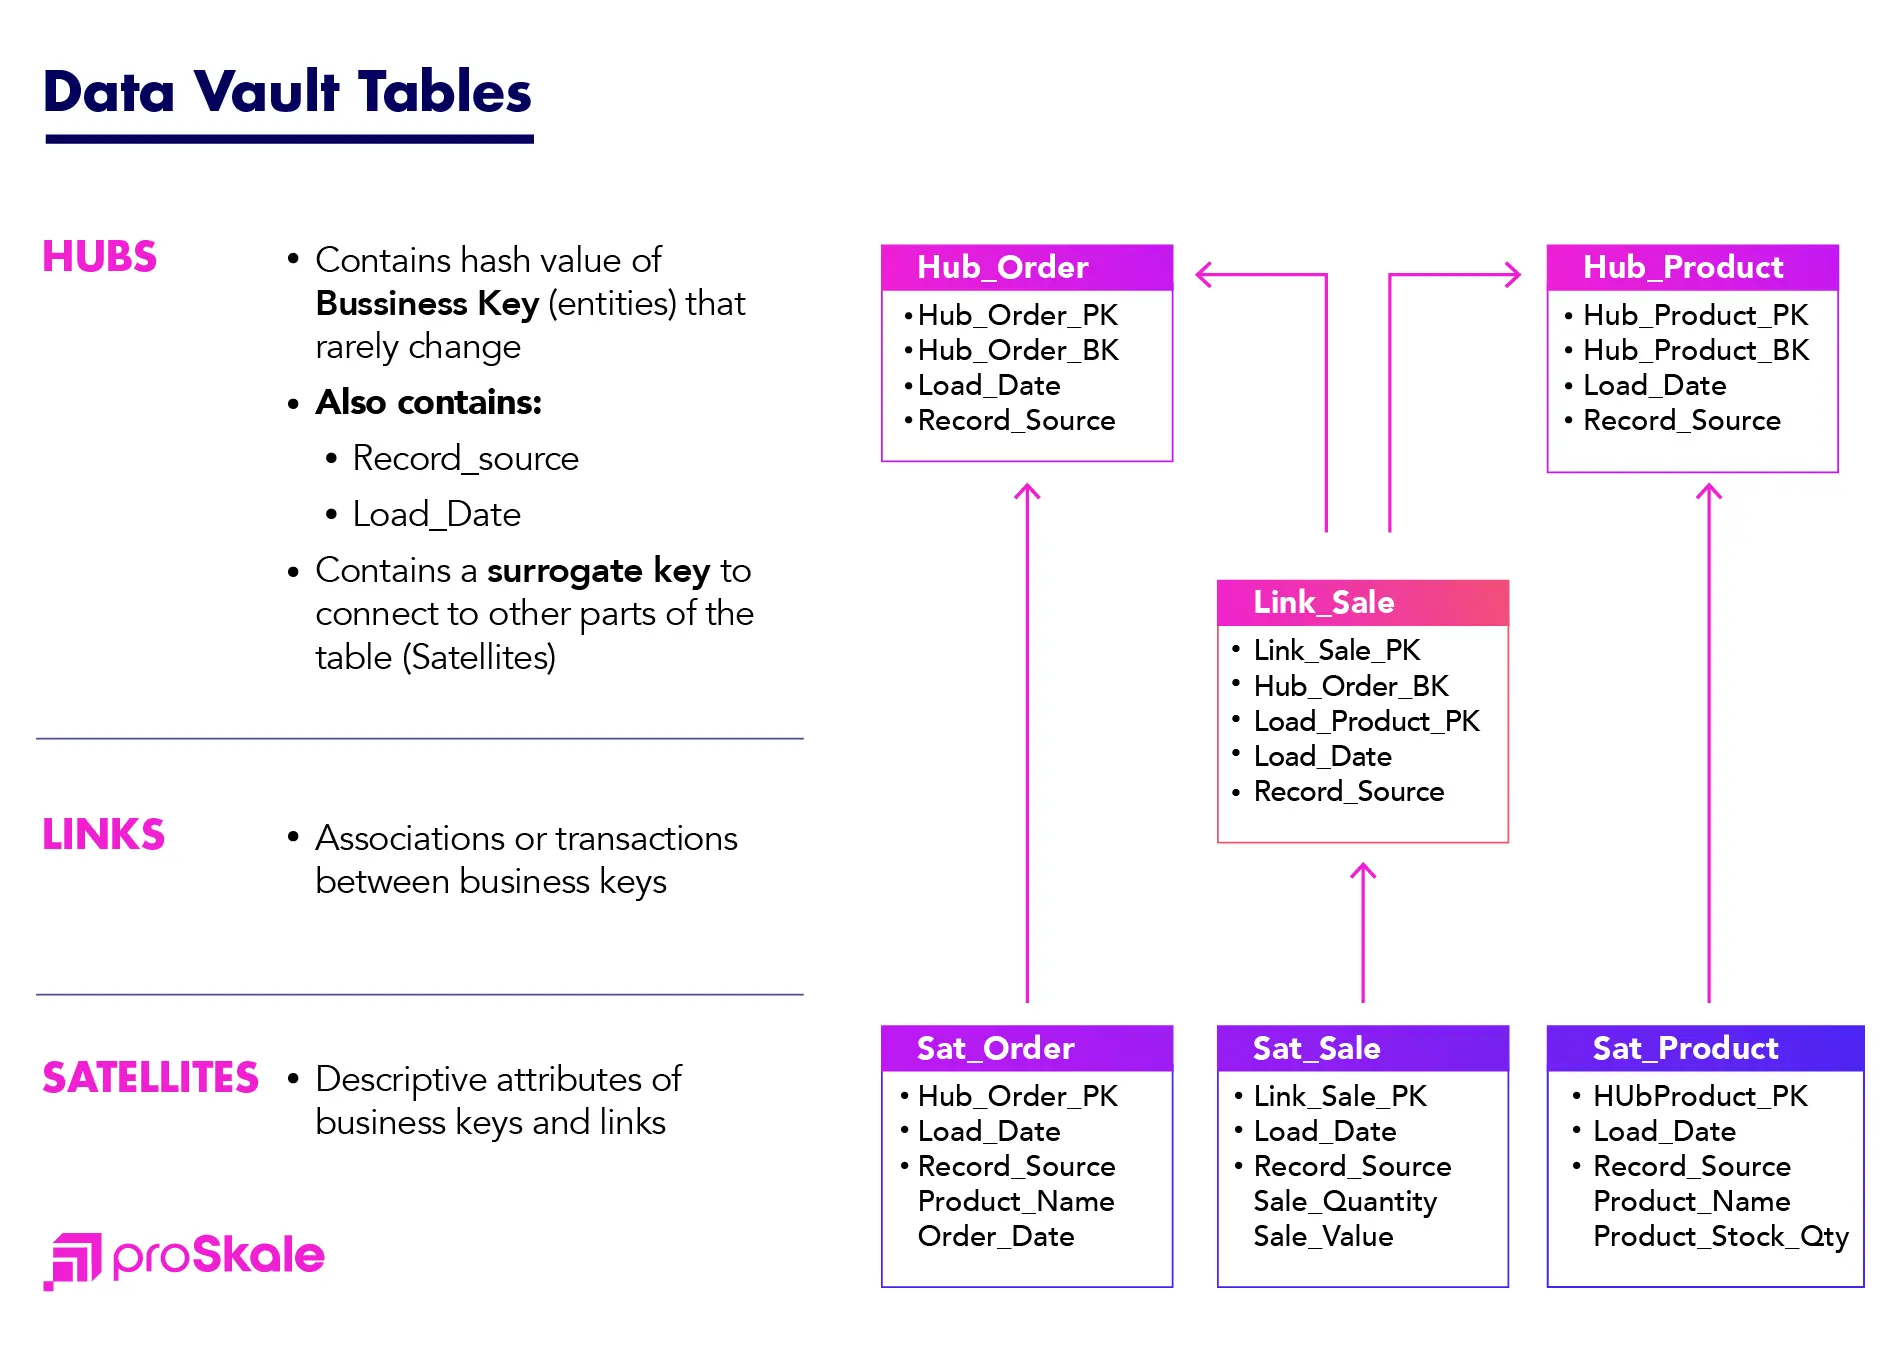
Рассматриваются основные элементы модели (HUB, LINK, SATELLITE), управление метаданными, историзация данных и построение слоёв Raw и Business Vault. Особое внимание уделяется интеграции с BI-системами и автоматизации загрузки данных.
Курс даёт системное понимание Data Vault и помогает применять его в реальных enterprise-проектах.
- Введение в архитектуру Data Vault: цели, принципы и контекст
- Терминология и базовые концепции Data Vault
- Data Vault в корпоративной архитектуре данных: взаимодействие с EDW, DW и BI
- Data Vault 2.0: принципы гибкости, масштабируемости и управляемости
- Архитектурные парадигмы моделирования: DV, Kimball и Inmon
- Стратегия внедрения Data Vault: дорожная карта и управленческие решения
- Архитектура слоев Data Vault: Staging, Raw Vault, Business Vault и Information Vault
- Архитектура Data Vault: Core DV - HUB, LINK, SATELLITE
- Управление ключами: бизнес-ключи, суррогаты и hash-ключи
- Историзация и версияция в SATELLITE
- Управление временем: PIT (Point-In-Time) и архивирование изменений
- Метаданные Data Vault: источники, lineage и impact analysis
- Архитектура управления метаданными и каталогами данных
- Связи HUB-LINK-SAT и паттерны отношений в DV
- Паттерны загрузки: ETL против ELT и конвейеры данных
- Интеграционные источники и паттерны: ERP, CRM, файлы, стриминг
- Batch и streaming конвейеры: архитектура обработки данных
- Управление качеством данных в DV: profiling, валидация и QC
- Тестирование Data Vault: unit-тесты, тесты качества данных
- Безопасность и контроль доступа: RBAC, data masking и шифрование
- Соответствие требованиям и регуляторика: GDPR/CCPA, retention политики
- Стандарты, протоколы и технологии обмена данными: API, Kafka, ODBC/JDBC, REST
- Архитектура автоматизации и DevOps для Data Vault: CI/CD и metadata-driven development
- Инструменты и стек технологий Data Vault: базы данных, хранилище, ETL/ELT, инструменты автоматизации DV
- Реализация проекта Data Vault: планирование, архитектурные решения и миграции
- Внедрение DV на практике: пилоты, минимально жизнеспроводный продукт, масштабирование
- Эксплуатационная модель DV: мониторинг, SLA, incident management и observability
- Производительность и масштабирование Data Vault: параллелизм, партиционирование и hashing
- Архитектура зрелости Data Vault: уровни зрелости, KPI и дорожная карта
- Практические кейсы применения DV: финансы, телекомы, розничная торговля и производство
- Интеграция DV с BI системами: semantic layer, data marts и отчётность
- Риски, ограничения и типичные ошибки в проектах Data Vault
- Роли и компетенции команды: архитекторы, инженеры данных, аналитики, governance
- Развитие и поддержка: эволюция архитектуры, управление изменениями
- Перспективы и тренды в Data Vault: автоматизация, AI/ML и Open Metadata


