

Архитектура Dagster: ключевые компоненты и их взаимодействие
Dagster выступает как комплексная платформа для оркестрации данных, ориентированная на ясную зависимость и управляемость процессов обработки. Основная идея состоит в том, чтобы отделить определение бизнес-логики преобразований от механики выполнения, конфигураций и инфраструктуры. В рамках Dagster используются специфические абстракции, позволяющие строить повторяемые, тестируемые и наблюдаемые конвейеры данных: от определения графа преобразований до обеспечения надёжного исполнения, хранения состояний и интеграции с внешними системами.
Архитектура Dagster поддерживает эволюцию от «одиночных скриптов» к масштабируемым конвейерам: данные проходят через серию шагов, каждый из которых имеет явные входы и выходы, зависимости по данным и ресурсы для доступа к внешним системам. В центре внимания - управляемость зависимостей, воспроизводимость и способность к монитору и отладке. В качестве ядра выступают концепции графов, задач и репозиториев, окружённых конфигурационной моделью и механизмами исполнения, журналирования и мониторинга.
- В Dagster определение пайплайна строится как граф задач (ops/solids) с явными зависимостями данных и внешними ресурсами. Это обеспечивает прозрачность зависимостей и позволяет легко воспроизводить результаты на разных окружениях.
- Архитектура поддерживает разделение «определения» и «исполнения»: конфигурации, ресурсы и IO-менеджеры описывают контекст выполнения, а сами пайплайны фокусируются на логике данных.
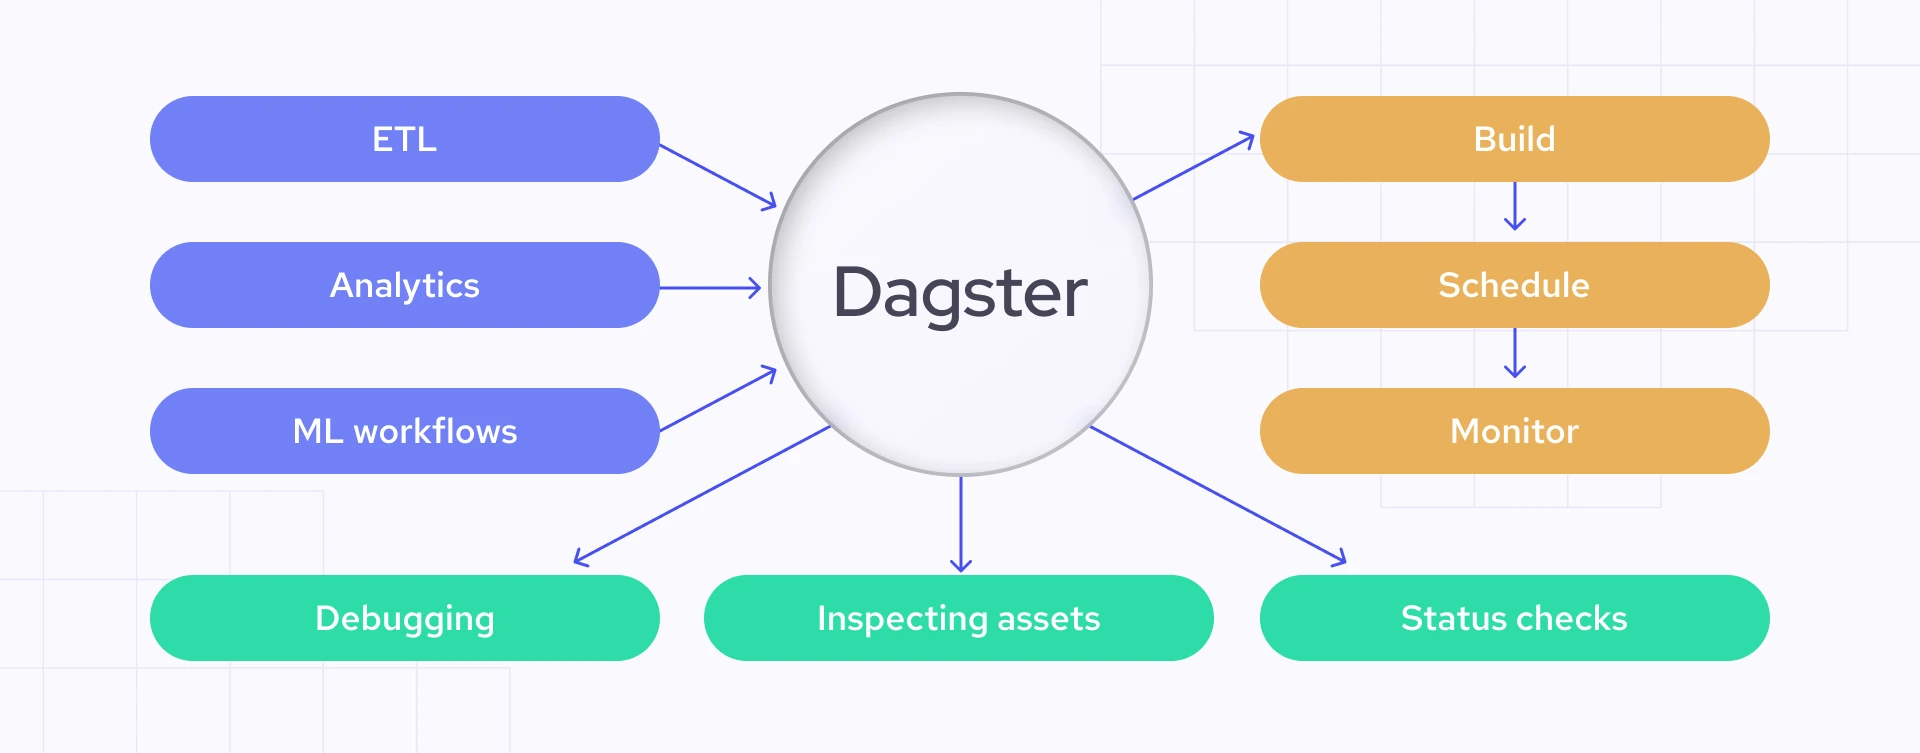
- Поддержка наблюдаемости через Dagit, журнал событий и инспекцию lineage позволяет аналитикам и инженерам быстро идентифицировать узкие места и непредвиденные изменения в данных.
Ключевые понятия, которые будут подробно рассмотрены далее, образуют каркас архитектуры Dagster и служат ориентиром для проектирования надёжной инфраструктуры данных.
- Архитектура Dagster задаёт структурный каркас, в котором репозитории, пайплайны и ресурсы образуют единое целое, поддерживаемое планировщиком и механизмами исполнения.
- В рамках архитектуры важны три слоя: определение (описывает бизнес-логика и зависимости), инфраструктура исполнения (планирование, запуск, управление контекстом) и наблюдаемость (логирование, метрики, lineage).
- Набор компонент, таких как IO-менеджеры, ресурсы и конфигурация, обеспечивает повторяемость и возможность переноса пайплайнов между окружениями без изменений бизнес-логики.
- Подход Dagster к зависимостям, повторному использованию и модульности упрощает внедрение лучших практик грамотного разделения обязанностей в командной работе.
Архитектура Dagster: концепции и сущности
Dagster оперирует несколькими фундаментальными сущностями, каждая из которых имеет чёткое назначение и место в экосистеме:
- Ops и Graphs (Solids и Pipelines в ранних версиях): базовые единицы вычислений. Ops - это отдельная задача, Graph - объединение операций в единый граф зависимостей. Совокупность графов формирует Graph/Job, который является исполняемым конвейером.
- Job (или Graph) и Repository: Job** - исполняемая единица, содержащая набор ops и определений ресурсов и IO-менеджеров. Repository объединяет несколько Jobs, активный набор возможностей и конфигураций, упрощая модульность и повторное использование.
- Resources и IOManager: ресурсы предоставляют внешние сервисы (базы данных, очереди, API) и контекст исполнения. IOManager отвечает за абстракции ввода-вывода данных между шагами графа, обеспечивая единый путь к сохранению и чтению промежуточных данных.
- Run и RunLauncher: Run фиксирует конкретную попытку выполнения пайплайна с заданной конфигурацией. RunLauncher управляет запуском и планированием процессов исполнения, включая параллелизм и обработкуRetries.
- Config и ModeDefinition: конфигурация задаётся через структуру, которая валидируется на этапе компоновки. ModeDefinition определяет набор ресурсов и IO-менеджеров, применяемых во время исполнения, поддерживая экологическую изоляцию между средами (development, staging, production).
- Asset и Asset Catalog (Lineage): концепция активов позволяет моделировать данные как объекты, превращение бизнес-логики в прозрачно отслеживаемые активы. Lineage обеспечивает трассировку источников и зависимостей между активами.
- Scheduler и Sensor: планировщик и сенсоры внедряют автоматическое триггерование выполнения пайплайнов на основе временных или событийных условий.
Эта совокупность сущностей образует устойчивую архитектуру, поддерживающую гибкость и устойчивость к изменениям требований. Понимание взаимосвязей между ними - ключ к эффективной эксплуатации Dagster в рамках большой организации.
## Простой пример: определение ресурса и опа, использование в пайплайне
from dagster import op, job, resource

@resource
def postgres_resource(_init_context):
    ## Реализация подключения к БД
    return object()  # упрощено

@op(required_resource_keys={"postgres"})
def load_data(context):
    db = context.resources.postgres
    ## Выполнение запроса и возврат результатов
    return ["sample_data"]

@job(resource_defs={"postgres": postgres_resource})
def etl_job():
    load_data()
Приведённый пример демонстрирует базовый паттерн: ресурс обеспечивает контекст исполнения, Ops выполняют бизнес-логику и образуют исполнительную цепочку в рамках одного Job.
Важно отметить, что архитектура Dagster допускает эволюцию к более продвинутым моделям. Так, вместо «solids» в современных версиях применяются «ops», однако принцип разделения обязанностей и явной зависимости сохраняется. В современном Dagster переход на Graphs и Asset-ориентированность позволяет строить конвейеры, которые легче тестировать и сопровождать на протяжении всего жизненного цикла проекта.
Исполнение и планирование: от графа к запуску
Исполнение Dagster начинается с формирования плана выполнения на основе графа задач и текущей конфигурации. Планировщик анализирует зависимости между операциями, распределение контекста выполнения и доступ к ресурсам, затем формирует ExecutionPlan - набор шагов, которые необходимо выполнить для достижения результата. В этом процессе ключевыми являются:
- Контекст выполнения: каждый шаг опирается на своего рода контейнер контекста, который обеспечивает доступ к ресурсам, IO-менеджерам и конфигурации. Контекст позволяет изолировать side effects и сохранять чистую логику вычислений.
- Распределение задач: Dagster поддерживает параллельное выполнение там, где зависимости позволяют; планировщик организует распараллеливание и управляет очередями, чтобы не перегрузить окружение.
- Контроль целостности: механизмы retries, транзакционные тесты и детальное журналирование позволяют обеспечить устойчивость к сбоям и повторное воспроизведение вычислений.
- Планирование и триггеры: Scheduler и Sensor позволяют инициировать выполнение по расписанию или в ответ на внешние события (например, появление нового файла в хранилище).
Эта часть архитектуры тесно связана с концепцией ModeDefinition и ResourceDefinition. Конфигурации режимов определяют набор доступных ресурсов, IO-менеджеров и параметров трассировки, что упрощает обеспечение согласованности поведения пайплайнов в разных окружениях. Разделение логики и исполнения позволяет легко переносить пайплайны между локальными машинами, кластерами и облачными средами без изменения бизнес-логики.
- ExecutionPlan - ключевой артефат исполнения: он формирует маршрут выполнения, учитывая зависимости данных и доступность ресурсов.
- Run и RunLauncher управляют жизненным циклом: создание, мониторинг, перезапуск и завершение, при этом каждый Run сохраняет контекст выполнения и результаты.
- Стабильная архитектура исполнения требует продуманных политик повторного выполнения, чтобы повторение операций было Idempotent и безопасно.
Хранение состояния, журналирование и наблюдаемость
Устойчивость и прозрачность процессов зависят от качественного хранения состояния и событий выполнения. Dagster предлагает несколько слоёв хранения и мониторинга:
- Run Storage: хранение записей о каждом прогони и его контексте. Реализации включают в себя InMemory (для тестирования), SQLite (локальное развитие) и Postgres/MySQL (продакшн). Выбор конкретной реализации влияет на скорость запросов и масштабируемость.
- Event Log: хранение детальных событий во время выполнения каждого шага. Это даёт возможность детального воспроизведения трассировки исполнения и аудита.
- Asset Catalog и Lineage: связь между операциями и данными, моделируемая через AssetKey и lineage-метаданные. Позволяет видеть, какие активы зависят от каких источников и как меняются данные со временем.
- Observability: Dagit** - веб-интерфейс Dagster, который обеспечивает визуализацию графов, текущее состояние исполнения, доступ к журналам и детальный разбор ошибок. Помимо Dagit, можно интегрировать внешние инструменты мониторинга (Prometheus, Grafana) через кастомные метрики и хуки.
- Logging и метрики: единая стратегия логирования и сбора метрик упрощает диагностику и позволяет централизацию логов. В реальных проектах важно определить политики сохранения, ротации и архивирования журналов.
Эффективная конфигурация хранения и наблюдаемости тесно связана с архитектурой репозиториев и режимов. Правильно подобранная стратегия хранения снижает риск потери данных и ускоряет восстановление после сбоев, а хорошо продуманная наблюдаемость - это не просто «пользовательский интерфейс», но источник оперативной информации для команд инженеров и аналитиков.
Ресурсы, IO-менеджеры и конфигурации
Одним из фундаментальных преимуществ Dagster является явное управление контекстом исполнения через ресурсы и IO-менеджеры. Эти механизмы обеспечивают единообразный доступ к внешним системам и устойчивость к изменяемым окружениям:
- ResourceDefinition: абстрагирует подключение к внешнему сервису (база данных, API, пакет обработки). Ресурсы инкапсулируют логику и конфигурацию и могут зависеть друг от друга.
- IOManager: стек абстракций для ввода-вывода промежуточных данных между шагами. IOManager обеспечивает сохранение и восстановление данных между операциями и поддерживает универсализацию форматов хранения.
- Config и Type system: Dagster использует декларативную модель конфигурации, где каждый элемент графа определяется валидируемыми схемами. Это обеспечивает конфигурационную прозрачность и упрощает тестирование.
- ModeDefinition: единый контекст выполнения, объединяющий набор доступных ресурсов и IO-менеджеров. В разных окружениях можно определить разные режимы, не меняя бизнес-логику пайплайна.
- Dependency injection через контекст: построение контекстов выполнения позволяет легко подменять реализации ресурсов для тестирования и разработки без модификации кода пайплайна.
Эти механизмы позволяют архитекторам и инженерам данных создавать повторяемые, безопасные и тестируемые пайплайны. Принцип заключается в том, что все внешние зависимости и форматы данных выводятся на достаточно ясную грань - изменение конфигурации не требует переписывания логики обработки.
## Пример: Ivy-совместимый ресурс и IOManager
from dagster import IOManager, IOManagerDefinition, InputContext, OutputContext

class SimpleIOManager(IOManager):
    def handle_output(self, context: OutputContext, obj):
        ## сохраняем результат во временное хранилище
        ...

    def load_input(self, context: InputContext):
        ## загрузка входных данных
        return ...

def define_io_manager():
    return IOManagerDefinition.temporary_resource(SimpleIOManager())
Такой пример иллюстрирует базовую схему использования IOManager: внешняя реализация может быть заменена для локального тестирования или перехода на полноценное хранилище данных без изменения логики пайплайна.
Интеграции и паттерны архитектуры
Dagster поддерживает широкую экосистему интеграций, что существенно упрощает внедрение в реальных предприятиях. Реализации подключаемых компонентов включают:
- Интеграции с хранилищами и базами данных: PostgreSQL, Snowflake, BigQuery и другие реализации IO-блоков позволяют прозрачно обмениваться данными между Dagster и хранилищами. Важна концепция IOManager и соответствующих адаптеров под конкретный формат хранения.
- Интеграции с системами очередей и обработки событий: Kafka, Celery или другие брокеры сообщений. Это обеспечивает реактивность пайплайнов на внешние события и асинхронную обработку.
- Интеграции для мониторинга и управления: Dagit, Prometheus, Grafana. Эти инструменты позволяют визуализировать прогресс выполнения, хранение и анализ метрик, что критично для эксплуатации в production.
- Сравнение с альтернативами: хотя Dagster обладает уникальным подходом к управлению зависимостями и наблюдаемостью, в некоторых случаях возможно наличие сочетаний с другими инструментами оркестрации, например Apache Airflow для orchestration на уровне задач в рамках большой экосистемы. Важно документировать, какие роли выполняют Dagster и внешние системы в конкретной постановке задач.
В рамках продуктовой стратегии и методологии внедрения рекомендуется следовать паттернам аккуратной миграции: сначала локальное развитие и тестирование, затем расширение среды до staging, и только после - в production. Важно зафиксировать требования к конфигурациям, управления версиями и совместимости между версиями Dagster и внешними сервисами.
Пример архитектуры реального проекта
Для иллюстрации концепций приведём пример архитектуры среднего размера проекта. В рамках проекта есть несколько повторяющихся конвейеров, связанных между собой через общий набор источников данных и целевых хранилищ. Архитектура может выглядеть примерно так:
- РепозиторийDagster содержит набор Jobs: загрузка сырых данных, трансформации, агрегирования, загрузка в аналитическое хранилище.
- Ресурсы реализуют доступ к базам данных и облачным хранилищам, а IOManager обеспечивает единый путь к сохранению промежуточных результатов.
- В средах development и staging применяются разные Modes: development - упрощенная конфигурация, production - защищённые сертификаты и расширенная observability.
- Планировщик запускает регулярные задания через Scheduler, а Sensor следит за событиями изменения данных, инициируя прогонки.
- Dagit используется как основная точка мониторинга и отладки; интеграция с внешними системами мониторинга позволяет централизованно собирать метрики и логи.
ASCII-схема архитектуры:
Dagster Repository
├─ ETL_Projects
│ ├─ daily_sales_job
│ ├─ user_events_job
│ └─ product_catalog_job
├─ Resources
│ ├─ postgres
│ ├─ s3
│ └─ api_clients
├─ IOManagers
│ └─ local_fs_io_manager
└─ Schedules_Sensors
├─ daily_schedule
└─ ingest_sensor
Такая схема демонстрирует ключевые узлы и их взаимосвязи: репозиторий организует Jobs, каждый Job использует ресурсы и IO-менеджеры; планировщики обеспечивают автономное выполнение по расписанию или по сигналам событий. В реальных условиях вносится дополнительная детализация: версионирование конфигураций, политика обработки ошибок, каналы уведомлений и аудит изменений данных.
Key takeaways
- Dagster строит конвейеры на явно заданных зависимостях между операциями, используя графы, ресурсы и IO-менеджеры для управления контекстом исполнения.
- Репозитории и режимы позволяют структурировать код и конфигурации, облегчая миграцию между окружениями и повторное использование компонентов.
- Управление состояниями и событийной логикой обеспечивает воспроизводимость и надёжность: Run, RunLauncher, Event Log, Asset Lineage и Dagit как основное средство наблюдаемости.
- Ресурсы и IO-менеджеры формируют единый контракт для взаимодействия с внешними системами и хранилищами, снижая связность между бизнес-логикой и инфраструктурой.
- Интеграции с BI-хранилищами, системами уведомлений и мониторинга позволяют выстраивать эффективную эксплуатацию конвейеров в production.
- Внедрение Dagster требует планирования по окружениям и конфигурациям: ModeDefinition и конфигурационные схемы позволяют адаптироваться к разработке, тестированию и продакшену без изменения кода пайплайна.
- Важность observability не менее критична, чем сами вычисления: качественный мониторинг, география и lineage помогают быстро обнаруживать и исправлять несоответствия в данных.
FAQ
- В чём основное отличие Dagster от традиционных систем оркестрации задач?
Dagster проектирован вокруг явной зависимости данных и управления контекстом исполнения. В отличие от систем, которые фокусируются на расписании или очередях задач, Dagster подчеркивает графовую структуру вычислений, модульность ресурсов и IO-менеджеров, а также богатую observability через Dagit и lineage. Это обеспечивает более прозрачную отладку, повторяемость и устойчивость к изменениям инфраструктуры.
- Какие ключевые абстракции следует понять сначала?
Начните с Ops/Graphs (или solids/ Pipelines), репозитория, ресурса и IOManager. Понимание того, как данные проходят через граф и как ресурсы предоставляют доступ к внешним системам, создаёт прочную основу для дальнейшей архитектуры и расширения пайплайнов.
- Как Dagster обеспечивает воспроизводимость?
Воспроизводимость достигается через явную конфигурацию, фиксацию зависимостей и состояния исполнения, наличие стойкого журнала событий и детального lineage. Run-объекты фиксируют конкретную конфигурацию и контекст, что позволяет повторно запустить пайплайн с теми же входами и ожидать сопоставимые результаты.
- Как организовать эффективную Observability?
Используйте Dagit как главный инструмент мониторинга, настраивайте журналирование и метрики, интегрируйте внешние системы мониторинга (Prometheus, Grafana). Важна единая стратегия хранения журналов и устойчивость к большому объёму данных с возможностью архивирования.
- Какие паттерны конфигурации применимы для разных окружений?
ModeDefinition позволяет определить набор ресурсов и IO-менеджеров, соответствующий окружению (development, staging, production). Конфигурации должны быть валидируемы и совместимы между версиями пайплайнов, чтобы минимизировать риск ошибок при развертывании.
- Какие технические ограничения стоит учитывать?
Dagster хорошо масштабируется на уровне логики и конфигураций, но реальная производительность зависит от реализации IO-менеджеров и ResourceDefinition. В production следует использовать надёжные хранилища, продуманную стратегию резервного копирования и прав доступа, а также обеспечить мониторинг и алерты на сбои.
- Как выбрать стратегию хранения для Run и Event Log?
Выбор зависит от объёма данных и требований к скорости восстановления. Для локального development достаточно InMemory или SQLite, но для production предпочтительнее Postgres или аналогичное решение, обеспечивающее устойчивое хранение и эффективные запросы к журналам и lineage.
- Как Dagster работает с большими командами?
Разделение на репозитории и модули, совместная работа через версионирование конфигураций, тестирование отдельных Ops и графов, а также внедрение строгих паттернов CI/CD позволяют командам разворачивать новые конвейеры без влияния на существующую инфраструктуру.
- Какие примеры интеграций наиболее полезны на практике?
Интеграции с хранилищами (PostgreSQL, Snowflake, BigQuery), облачными хранилищами (S3, GCS) и системами очередей (Kafka) встречаются чаще всего. Эти интеграции позволяют реализовать удобные паттерны перемещения данных, обеспечения консистентности и эффективной загрузки между окружениями.
- Какие шаги предпринять для перехода на Dagster в существующем проекте?
Начните с локального моделирования базовых пайплайнов и ресурсов, затем постепенно добавляйте репозитории и режимы. Распишите конфигурации для development и production, включите Dagit в процесс мониторинга, настройте журналирование и lineage. Постепенно мигрируйте существующие пайплайны, сохраняя совместимость логики обработки данных и обеспечивая прозрачность зависимостей.
Глава охватывает архитектурные основы Dagster и их применение на практике: от теоретических концепций до конкретных реализаций и интеграций. Следуя принципам модульности, конфигурационной дисциплины и наблюдаемости, команда сможет разворачивать устойчивые, тестируемые и воспроизводимые конвейеры данных, адаптируемые под требования бизнеса и инфраструктуру организации.


