

Истории изменений и топики Debezium: нейминг, партиционирование и ретенция
Debezium - это мост между источниками данных и потоковыми системами, реализующий Change Data Capture (CDC) и публикующий изменения в Kafka. В рамках данной главы рассматриваются две ключевые составляющие работы Debezium с точки зрения эксплуатации и проектирования CDC-пайплайнов: история изменений (schema history) и сами CDC-ивенты, каждый из которых публикуется в отдельном топике. Важность грамотного нейминга, продуманного партиционирования и продуманной ретенции трудно переоценить: эти решения напрямую влияют на задержку обработки, согласованность и стоимость хранения. Рассматриваются архитектурные принципы, на них базируются операционные решения в реальном Prod-окружении, а также практические сценарии интеграции с Kafka и другими стриминговыми системами.
Краткое введение
- Нейминг топиков Debezium задаёт единые правила идентификации источников изменений, упрощает мониторинг и аудит, снижает риск конфликтов между коннекторами в больших кластерах.
- История схем (schema history) изолирована в специальном топике и должна быть устойчивой к частым обновлениям: её хранение и политика очистки существенно влияют на скорость восстановления коннектора после сбоев.
- Партиционирование и ключи событий определяют распределение нагрузки и порядок обработки изменений на уровне потребителей. Правильная схема ключей обеспечивает локализацию изменений по ключу и стабильность порядка.
- Ретенция топиков должна соответствовать рабочим сценариям потребления: для CDC-ивентов характерна долгосрочная хранение в отдельных топиках, а история схем - компактирование и ограничение по времени.
Краткое содержание главы
- Архитектура истории изменений и топиков Debezium: структура данных, связь между schema history и CDC-событиями.
- Нейминг топиков и конвенции именования: паттерны для изменённых данных и истории схем, влияние на мониторинг и операцию.
- Партиционирование и ключи изменений: выбор ключа, влияние на порядок обработки и балансировку нагрузки.
- Ретенция и управление жизненным циклом топиков: политика хранения для событий и для истории схем.
- Практические сценарии интеграции: как сочетать Debezium со стеком Kafka, Flink, Spark, ksqldb и т.д.
- Операционная практика: конфигурации, наблюдение, тестирование и обеспечение устойчивости.
Архитектурные основы истории изменений и топиков Debezium
Debezium строит CDC-пайплайн через концепцию двух уровней данных: поток изменений по конкретной таблице (CDC-события) и схема изменений (history of schema). Каждый коннектор Debezium, развёрнутый через Kafka Connect, публикует изменения в Kafka топики и хранит эволюцию схем в отдельной истории. Это позволяет коннектору без потери контекста восстанавливать структуру данных после сбоев, а потребителям - корректно распознавать форматы значений при обработке изменений.
-
Change events: для каждой таблицы публикуются сообщения с ключом, который обычно состоит из первичного ключа (или набора ключей, если есть составной PK). Значение несёт данные о вставке, обновлении или удалении. Название топика формируется по схеме, описанной ниже, и обеспечивает локализацию событий на уровне таблиц.
-
Schema history: отдельный топик, который хранит серийный журнал изменений схем баз данных, используемый для воспроизведения и восстановления структуры таблиц при старте коннектора. Восстановление в случае перезапуска требует доступа к этому топику для реконструкции корректной схемы.
-
Важно помнить: история схем не предназначена для длительного анализа, она нужна для воспроизведения структуры в момент изменений и при повторной инициализации пайплайна. Её политику хранения следует выстраивать так, чтобы обеспечить необходимый буфер времени для восстановления, но не перегружать кластер ресурсоёмкими данными.
Типичные принципы реализации
-
Непосредственная зависимость между именованием серверов/коннекторов и тем, как будут называться ключи и топики. В большинстве сценариев применяют единый префикс, отражающий окружение (dev/qa/prod) и идентификатор коннектора.
-
История схем должна быть реплицирована и проконтролирована через отдельный топик с понятной политикой очистки. Это обеспечивает устойчивость к сбоям конфигурации и совместную работу разных потребителей, которые могут потреблять историю для анализа или аудита.
-
Для дифференциации коннекторов и баз данных часто применяют pattern: {prefix}.{server}.{database}.{table}, а историю схем - {prefix}.{server}.{database}.schema_history. Такой подход упрощает мониторинг и трассировку по источнику изменений.
Нейминг топиков: подходы к именованию изменений и истории
Правильный нейминг топиков Debezium - залог прозрачности эксплуатации и легкости обслуживания. Он влияет на мониторинг, поиск инцидентов и упрощает разграничение трафика между различными коннекторами и окружениями.
- Change event topics: naming pattern часто задействует префикс topic.prefix и server/database/table, например: cdc.prod.orders.orders - для изменений в таблице orders базы данных orders на сервере prod.
- Schema history topic: отдельный топик, обычно выглядящий как cdc.prod.orders.schema_history или cdc.prod.orders_schema_history, чтобы отделить его от обычных изменений и позволить конфигурировать уникальные политики хранения.
Рекомендованные конвенции
- Используйте один центральный префикс для всего набора CDC-топиков в окружении: например, cdc.
. . для таблиц и cdc. . . .schema_history для истории схем. - Для разных баз данных можно продолжать сохранять структурированную иерархию: сервер - база данных - таблица. Это упрощает фильтрацию и сбор метрик по конкретному источнику.
- При наличии нескольких коннекторов с общим префиксом используйте уникальные имена коннекторов (name property в Kafka Connect) и портфели окружения, чтобы избежать коллизий.
Таблица: примеры нейминга топиков
| Topic type | Naming pattern | Purpose | Example |
|---|---|---|---|
| Change event topic | {prefix}.{server}.{database}.{table} | CDC-события по конкретной таблице | cdc.prod.orders.orders |
| Schema history topic | {prefix}.{server}.{database}.schema_history | Хранение истории схем | cdc.prod.orders.schema_history |
- Примечание: значение prefix может задаваться свойством topic.prefix в конфигурации Debezium. В сложных сценариях полезно включать окружение и идентификатор коннектора, чтобы обеспечить изоляцию и независимое управление retention для разных пайплайнов.
Преимущества такого подхода
- Прозрачность и управляемость: по топику можно определить источник, окружение и предмет изменений.
- Легкость мониторинга: метрики по топикам можно агрегировать по паттерну и быстро выявлять узкие места.
- Гибкость в развёртывании: можно отдельно масштабировать темы изменений и тему истории, подстраивая retention и задачи потребителей.
Специфика настройки: имя коннектора и серверная идентификация
- serverName (или идентификатор коннектора) - ключевой параметр, который должен быть уникальным в рамках кластера. Дублирование имен приводит к коллизиям топиков и путанице при мониторинге.
- При выборе имени коннектора следует учитывать среду, принадлежность к конкретному источнику и развёртываемый набор баз данных. В продовых окружениях целесообразно включать коммеморативные признаки источника (например, бизнес-юнит или географию).
Важный момент по историям: история схем чаще всего хранится в топике с политикой очистки, ориентированной на компактирование. При этом CDC-события обычно не компактируются, чтобы сохранять последовательность изменений и полноту истории. Разделение политик очистки обеспечивает баланс между размером топиков и функциональностью.
## Пример минимальной конфигурации Debezium (MySQL) для иллюстрации нейминга
name: inventory-connector-prod-orders
connector.class: io.debezium.connector.mysql.MySqlConnector
database.hostname: db-prod
database.port: 3306
database.user: debezium
database.password: ****
database.server.id: 184054
database.server.name: prod
database.include.list: orders
table.include.list: orders.orders
topic.prefix: cdc
database.history.kafka.bootstrap.servers: kafka:9092
database.history.kafka.topic: cdc.prod.orders.schema_history
Важно отметить, что конкретные названия и параметры зависят от версии Debezium и используемого коннектора (MySQL, PostgreSQL, MongoDB и т.д.). Однако принципы остаются общими: единый префикс, понятная иерархия и чёткие разделения между историей схем и событиями изменений.
Партиционирование и ключи изменений
Партиционирование топиков в Kafka определяет параллелизм обработки и потребительскую пропускную способность. В контексте Debezium рекомендуется следующая логика:
- Ключи сообщений: Debezium использует ключи на основе первичных ключей таблицы. Для таблиц с одиночным PK этот PK становится ключом Kafka. Для составных PK ключ представляет собой агрегированное значение по ключам строк. Это обеспечивает, что все изменения одной строки обрабатываются в одном разделе и порядка события соблюдается для конкретной сущности.
- Партиционирование: количество партиций должно быть достаточным для пропускной способности конкретной топики CDC по таблице. Рекомендации варьируются: для таблиц с высоким трафиком - 6-12 партиций или больше; для таблиц с умеренным трафиком - 3-6 партиций. Важно балансировать число партиций с размером кластера Kafka и скоростью потребителей.
- Sticky partitioning: современные версии Kafka используют «sticky partitioner» по умолчанию, что уменьшает перераспределение партиций и снижает задержки. Но если у вас есть хорошо выраженная дисбалансировка по PK, можно сохранять Key-based partitioning для сохранения порядка и распределения нагрузки.
Практические рекомендации
- Всегда используйте стабильный ключ: если PK изменяется или есть частые обновления PK, это может привести к перераспределению нагрузки и задержкам. В идеале PK не меняются и остаются уникальным идентификатором.
- Для крупных таблиц с широкими составными PK необходимо обеспечить единый кодировочный формат ключа, чтобы равномерно распределять по партициям. Рассмотрите сериализацию JSON или других бинарных форматов, если это улучшает производительность.
- Избегайте использования чистого попугайного рандома (round-robin) в качестве партиционирования на уровне продюсера Debezium. Ключ должен определять партицию для сохранения порядка обработки конкретной сущности, если это важно для потребителя.
- В отношении топиков истории: если вы используете компактную очистку (compact) для схемы, это снижает нагрузку на хранение, но не забывайте, что история нужна для восстановления - выберите retention, достаточный для времени, необходимого для ваших сценариев доступа к метаданным (например, 30 дней или больше в зонах с регулятивными требованиями).
Сценарии и интеграции
- Для обработки CDC событий на реальном времени многие потребители выбирают потоковую обработку через Kafka Streams, Flink или Spark Structured Streaming. В таких пайплайнах важно, чтобы ключи сохраняли локализацию изменений по сущности и чтобы топики имели достаточное число партиций.
- В случаях использования ksQldb (ksqldb) или SQL-станций поверх Kafka, соблюдение единой схемы именования и консистентного разделения по таблицам упрощает построение запросов и масштабирование.
- При использовании нескольких окружений (dev/qa/prod) полезно отделять ретенцию и политики очистки между окружениями, чтобы избежать взаимного влияния и переполнения кластеров.
Политика хранения и ретенции
- Изменения CDC (change event topics): рекомендуется устанавливать retention.ms и cleanup.policy в зависимости от сценария потребления. Для живой аналитики и реального времени держать потоковую историю на протяжении долгого срока может быть полезно, но удерживать данные слишком долго может стать дорогим. Часто применяют retention в диапазоне 7-90 дней, исходя из требований бизнеса и регуляторных норм.
- История схем (schema history topic): хранение следует ограничить и сделать компактированным (cleanup.policy=compact). Это обеспечивает устойчивость при обновлениях схем без чрезмерного роста топика, поскольку в большинстве случаев требуется только последняя версия схемы для восстановления состояния.
- Политика очистки топиков должна соответствовать целям потребления. Для CDC-ивентов удаление (delete) не рекомендуется, если потребительские пайплайны должны держать историю изменений в течение долгого времени. Однако для некоторых случаев можно сочетать: удаление старых почтовых сообщений в рамках SLA и использование внешнего хранилища (data lake/warehouse) для архивирования.
Ретенция и жизненный цикл топиков
Глобальные принципы:
- CDC-топики: держать достаточную ретенцию, чтобы потребители могли догнать и обработать задержки, особенно в условиях всплесков и миграций потребителей. В производстве часто выбирают 7-30 дней или больше, если потребление происходит медленно или требуется аудит.
- Schema history: компактирование и ограничение времени хранения. Рекомендуется держать на уровне нескольких недель, если восстановление коннектора должно занимать минимальное время, а обновления схем происходят редко. В реальности роль этой топики - обеспечить возможность повторного bootstrap коннектора без потеряной информации о структуре таблиц.
- Чистка и копирование: для исторических данных целесообразно создать отдельные дубликаты в Data Lake, чтобы не полагаться исключительно на Kafka, который оптимизирован для стриминга, а не для долговременного архива. Это упрощает ретраверс и аудио проверки изменений.
Технические детали
-
Change event topics: cleanup.policy = delete (по умолчанию). Это обеспечивает естественную последовательность событий и их удаление после истечения retention.
-
Schema history topic: cleanup.policy = compact. Компакция сохраняет последнее значение по каждому ключу схемы, позволяя держать только актуальную схему.
-
Таблица соответствий retention и сценариев можно оформить так:
| Topic type | Recommended cleanup policy | Typical retention guidance | Примечание |
|---|---|---|---|
| Change events | delete | 7-90 дней в зависимости от требований | Долгосрочное хранение может потребовать внешних архивов. |
| Schema history | compact | 14-180 дней или больше | Компактация сохраняет последнюю схему; архив по внешнему хранилищу для аудита. |
Практические соображения по эксплуатации
-
Мониторинг lag по Debezium: задержка между источником изменений и публикуемыми событиями может указывать на узкие места в коннекторе, сеть или нагрузку на брокер. Включение метрик JMX/Prometheus поможет держать finger on the pulse.
-
Учет задержек при обновлениях схем: любые изменения схемы должны отражаться в schema history; при длительных миграциях необходимо планировать паузу в изменениях и корректно обновлять конфигурацию.
-
Тестирование конфигураций: в DEV и STAGING следует проводить сценарии миграций схем и больших изменений данных, чтобы убедиться в корректной обработке ключей и допустимости порядка изменений.
## Пример конфигурации для управления ретенцией и очисткой
## Change events (CDC)
cleanup.policy=delete
retention.ms=604800000  # 7 дней
segment.bytes=1073741824

## Schema history
cleanup.policy=compact
retention.ms=1209600000  # 14 дней
segment.bytes=1073741824
Практические сценарии интеграции с Kafka и стриминговыми системами
-
Интеграция с Kafka Streams и Flink: Debezium предоставляет поток изменений, который можно обогатить и агрегировать на уровне стримового процессинга. Правильная организация ключей и топиков обеспечивает локализацию состояния и минимизацию задержек.
-
ksQldb и кросс-системная аналитика: SQL-уровни поверх Kafka позволяют быстро строить представления и запросы по данным CDC. В таких сценарияхNaming и структура топиков упрощают построение запросов и мониторинга.
-
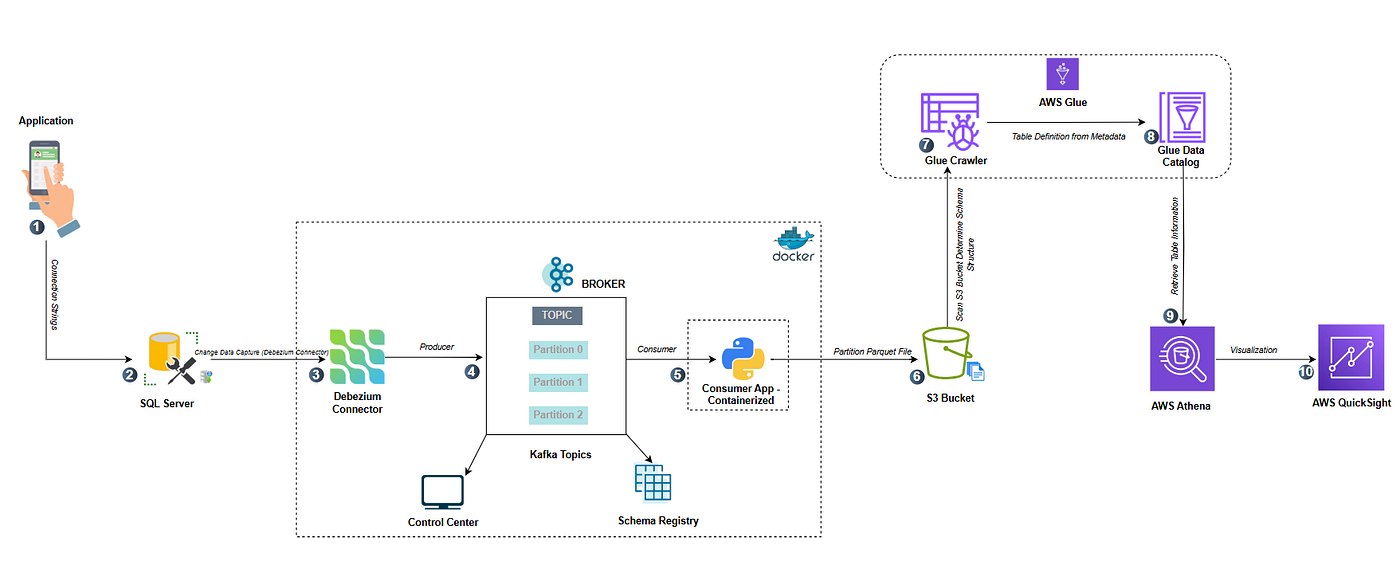
Архитектура data lake/warehouse: CDC-пайплайны Debezium часто служат входной точкой для загрузки данных в data lake. В этом сценарии стоит держать исторические топики и архивировать данные в HDFS/С3-совместимую схему, чтобы сохранить полноту и доступ к линейной последовательности изменений.
Операционная практика
- Управление коннекторами: обеспечьте уникальные имена коннекторов и используйте понятные окружения. Контролируйте BLUE/green-деплой и миграции конфигураций через централизованный подход к управлению параметрами.
- Наблюдаемость: мониторьте задержки, количество сообщений и lag на уровне топиков и коннекторов. Визуализация через Grafana/Prometheus, Alerting на задержке и росте санкций обеспечивает раннее обнаружение проблем.
- Тестирование и внедрение: тестируйте новые схемы и конфигурации в staging окружении, включая сценарии миграций схем и ошибок сети, чтобы убедиться, что degrader не нарушит консистентность событий.
Key takeaways
- История изменений Debezium и CDC-топики должны иметь ясную иерархию именования: Change events - по серверу/базе/таблице, история схем - отдельно, с понятным суффиксом.
- Релевантное партиционирование строится на стабильных ключах, обычно на основе первичных ключей таблиц, обеспечивая локализацию событий и упорядоченность.
- Политика ретенции для CDC-ивентов должна соответствовать потребностям потребителей и возможным сценарием архива, а история схем - компактироваться для минимизации затрат, но сохранять возможность восстановления схем.
- Интеграция Debezium с Kafka и стриминг-системами требует продуманной архитектуры топиков и согласованности между naming, партиционированием и ретенцией.
- Эффективная операционная практика включает мониторинг задержек, управление конфигурациями коннекторов, тестирование в staging и архивирование в внешние хранилища для долгосрочного хранения изменений.
- Грамотная настройка и поддержка нейминга топиков упрощают аудит, мониторинг, масштабирование и устойчивость CDC-пайплайна.
- Важно помнить: история схем и CDC-ивенты** - разные по цели данные; их нужно хранить с разными стратегиями очистки, чтобы не перегружать кластер и обеспечить быструю и безопасную реконструкцию состояния.
FAQ
- Какие принципы выбрать для нейминга CDC-топиков Debezium в большом кластере?
В больших средах полезно отделять окружение и источник изменений: используйте префикс топика, включающий окружение, сервер и базу, например, cdc.prod.server1.sales.orders. Историю схем храните отдельно с суффиксом schema_history, например cdc.prod.server1.sales.schema_history. Это облегчает мониторинг, аудиты и безопасно разделяет нагрузки между коннекторами.
- Как определить оптимальное число партиций для CDC-топиков?
Оптимальное число партиций зависит от нагрузки на конкретную таблицу. Для таблиц с высокой пропускной способностью разумно назначить 6-12 партиций; для меньшей нагрузки - 3-6. Важно сохранить порядок относительно ключа и не перегрузить кластер. Всегда учитывайте общую емкость кластера и требования потребителей.
- Что лучше: хранение истории схем в компактном топике или в обычном?**
История схем должна быть компактирована, чтобы хранить только последнюю версию схем по каждому ключу, что экономит место и ускоряет восстановление. Однако для аудита можно сохранять копии старых версий в внешнем хранилище. CDC-события лучше хранить в обычных топиках с delete-ретенцией, чтобы сохранить полный ход изменений.
- Как обеспечить безопасный порядок изменений при использовании составных ключей?
Используйте составной ключ как единый Kafka-ключ. Это позволяет держать порядок по ключу в рамках одной партиции. Также следует избегать частых изменений ключа и поддерживать стабильность структуры PK для предотвращения перераспределения нагрузки.
- Какие настройки полезно держать для мониторинга задержки CDC?
Включите метрики Debezium (JMX/Prometheus) и мониторьте lag по каждому топику изменений и по коннектору. Метрики полезны для выявления проблем с сетью, узкими местами в коннекторе и задержками потребителей. Визуализируйте задержки на уровне топика и на уровне коннектора.
- Как сочетать Debezium с ksqldb и потоковыми системами?
Выбирайте единый pattern именования и целостную схему ключей, чтобы запросы и транзакционные истории могли быть легко реализованы в ksQldb. При этом соблюдайте корректную ретенцию и избегайте агрессивной компактации CDC-топиков, которые писать невозможно, поскольку это нарушает CDC-постоянство.
- Что учитывать при миграции схем и изменений в продакшн?
Выполните план миграции в staging, чтобы проверить совместимость старых и новых схем. Убедитесь, что schema history обновляется корректно и коннектор способен воспроизвести момент перехода без потери изменений. При необходимости проведите временную паузу изменений и обновление коннектора в controlled manner.
- Как организовать архивирование изменений в внешний хранилище?
Настройте процессинг или потоковую обработку данных, чтобы копировать CDC-события в Data Lake/Warehouse (например, S3/Parquet) для долгосрочного хранения, чтобы не зависеть от retention Kafka. Это обеспечивает аудит и ретривал данных без перегрузки кластера Kafka.
- Какие риски связаны с неправильной ретенцией историй схем?
Долгое хранение истории схем без контроля может привести к перегрузке кластера при частых изменениях. С другой стороны, слишком короткая ретенция может привести к невозможности восстановления после сбоя. Подход - компактирование и разумная ретенция с резервным копированием в external storage.
- Можно ли использовать альтернативы Debezium для CDC в рамках Kafka?
Debezium - один из наиболее зрелых и поддерживаемых инструментов CDC для разных СУБД и тесно интегрирован с Kafka Connect. В некоторых сценариях можно рассмотреть альтернативы, но для полноценной синхронизации в рамках Kafka Debezium остаётся одним из наиболее надёжных и документированных решений. При этом стоит учитывать требования к совместимости, архитектуре и поддержке в вашей экосистеме.


