

Архитектура наблюдаемости: дашборды потоков, аналитика изменений и отчетность
Обеспечение наблюдаемости CDC-пайплайнов на базе Debezium требует целостного подхода к измерению, сбору, агрегации и визуализации сигналов на каждом этапе потока: от источника изменений до потребителя в аналитике. В реальном времени это означает синхронизацию данных о задержках, пропускной способности, эволюции схем и согласованности, а также предоставление оперативной и регуляторной отчетности для бизнес-пользователей и инженеров.
В данной главе рассматриваются принципы проектирования архитектуры наблюдаемости для систем на базе Debezium и Change Data Capture, стратегии построения дашбордов потоков, методы аналитики изменений и отчетности, а также практические паттерны внедрения и интеграции в существующий стек технологий. Особое внимание уделяется тому, как обеспечить достоверность сигнальных данных, минимизировать задержки и избежать ошибок из-за эволюции схем или асинхронности между компонентами.
- Архитектура наблюдаемости: сигналы, форматы данных, хранение и протоколы.
- Дашборды потоков: KPI, сценарии мониторинга, визуализация и интеграции.
- Аналитика изменений и отчетность: drift, версионирование событий, регуляторные требования.
- Инфраструктура и интеграции: стек Debezium-Kafka-инструменты мониторинга.
- Практические примеры реализации и паттерны развёртывания.
Архитектура наблюдаемости потоков данных
Наблюдаемость CDC-пайплайна строится на нескольких уровнях: сбор сигналов на источник изменений (Debezium, база данных-источник), транспортировка через брокер сообщений (Apache Kafka), нормализация и контрактование схем (Schema Registry), потребители и конвертация в аналитические представления. Эффективная архитектура охватывает не только метрики и трассировки, но и логику обработки ошибок, повторного воспроизведения потоков и поддержки схемной эволюции.
Источники сигналов
Ключевые источники сигналов в контексте Debezium включают:
- Метрики Debezium и коннекторов: задержка публикации изменений, частота изменений, количество ошибок коннектора.
- Метрики Kafka: задержка потребителей, lag по партизану (consumer group lag), пропускная способность топиков CDC.
- Логи и трассировки: трассировки коннекторов, микросервисов-обработчиков, потребителей.
- Эволюция схем: новости об изменении структуры таблиц, изменения типов данных, добавление/удаление столбцов.
- Метрики параллелизма и нагрузки: число задач коннектора, распределение по базам данных и таблицам.
Эти сигналы должны собираться централизованно и сохраняться в линии времени, чтобы можно было проследить "путь" изменений от источника до конечной аналитической модели. Важное внимание уделяется сопоставлению временных меток: системные часы источника, время события в Debezium, время записи в Kafka и время потребления downstream‑складов.
Хранилище сигнальных данных
Наблюдаемость требует двух типов хранилища:
- Коробочные метрики и трассировки, которые публикуются в системы мониторинга (Prometheus, OpenTelemetry Collector, Jaeger, Zipkin).
- Исторические сигналы об изменениях и эволюции схем в формате событий или таблицах мониторов (data lake, timeseries базы, специализированные хранилища).
Практически выбираются сочетания:
- Prometheus + Grafana для метрик в реальном времени и алертинга.
- OpenTelemetry для трассировки и распределённой трассировки через коннекторы и потребители.
- Нормализованные журнальные данные (logs) и исторические сигналы об изменениях схем в Data Lake или хранилища аналитики (например, Parquet в S3/ADLS).
Форматы и схемы данных
Debezium генерирует события в формате на основе схем базы данных (обычно JSON или Avro через Kafka Connect). Эволюция схем требует совместимости: поддержка регистров схем, версионирование и управление "передвижением" типа данных без потери совместимости downstream систем. В частности:
- Использование Schema Registry или аналогичного сервиса для полиморфной поддержки схем и эволюции.
- Встроенная поддержка ключей событий (ключи CDC, например, первичные ключи таблиц) для идентификации версий и устранения дубликатов.
- Контракты потребителей: строгая версия схем и совместимость (backward/forward).
Важно обеспечить стратегию миграции схем: как потребители будут реагировать на новые поля, как использовать дефолтные значения, как обрабатывать удаление столбцов без разрушения бизнес-логики.
Протоколы и интеграции
Эффективная наблюдаемость требует использования стандартных протоколов и совместимых инструментов:
- OpenTelemetry: сбор трассировок, метрик и контекстной информации по всей цепочке CDC.
- Prometheus: сбор и агрегация временных рядов, создание алертов.
- Kafka-трассировки и métrics: мониторинг lag, throughput и ошибок в топиках CDC.
- Инструменты визуализации: Grafana для дашбордов, панели мониторинга производительности.
- Инструменты для управления схемами: Schema Registry, конвенции нумерации версий схем.
Наблюдаемость должна быть встроена в конвейер на этапе проектирования: сигналы должны жить в одном месте, где инженер может легко их изучать, связывать с бизнес‑метриками и быстро реагировать на отклонения.
Пример конфигураций и паттернов мониторинга
Конфигурации мониторинга должны быть описаны в централизованном виде и версионированы как часть кода инфраструктуры. Ниже приведён упрощённый пример конфигурации Debezium и мониторинга в виде JSON-коннектора и метрик Prometheus. Пример не претендует на полноту и служит иллюстрацией паттерна.
{
  "name": "inventory-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "tasks.max": "4",
    "database.hostname": "db1",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "dbz",
    "database.server.id": "184054",
    "database.include.list": "inventory",
    "database.history.kafka.bootstrap.servers": "kafka:9092",
    "database.history.kafka.topic": "dbhistory.inventory",
    "transforms": "route",
    "transforms.route.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.route.regex": "([^.]+)\\.(.*)",
    "transforms.route.replacement": "$1_$2",
    "producto.metrics.bootstrap.servers": "prometheus:9090",
    "producto.metrics.topic": "cdc.metrics"
  }
}
В приведённом фрагменте демонстрируется базовая структура конфигурации Debezium с несколькими аспектами: параллелизм через tasks.max, указание источника, истоки исторических данных и потенциальное подключение к мониторингу. Реальные конфигурации требуют согласования с политиками безопасности, сетевой сегментации и требованиями к доступу к данным.
| Сигнал | Описание | Цель использования |
|---|---|---|
| latency | задержка между событием изменений и его записью в Kafka | мониторинг задержки и SLA |
| lag | отставание консумера между консьюмером и топиком | алертинг на перегрузку downstream |
| error_rate | доля ошибок коннектора | оперативная диагностика неисправностей |
| schema_version | текущая версия схемы таблицы | контроль эволюции схем |
Уровень дизайна архитектуры должен предполагать не только сбор сигналов, но и их корреляцию между различными слоями пайплайна: от базы данных источника к консьюмеру, от потока изменений к бизнес‑потребителю.
Архитектура дашбордов потоков
Дашборды для потоков изменений строятся на принципах видимости критичных бизнес‑показателей и технических KPI. Важно сочетать оперативную видимость с исторической, чтобы оперативники могли управлять инцидентами, а аналитики - проводить ретроспективу.
Принципы дизайна дашбордов
- Фокус на KPI: задержка (latency), задержка репликации (replication lag), пропускная способность (throughput), количество изменений по таблицам, доля ошибок.
- Гибкость с учётом доменной области: для разных доменов требуются свои меры по SLA и регуляторной отчетности.
- Разделение по контекстам: технический контекст (коннектор, топик, источник), бизнес-контекст (таблица/сущность, сервис-потребитель).
- Обеспечение контекстной связности: возможность перехода от дашборда к трассировке и логам для детального разбора.
Типовые дашборды
- ДашбордPipeline: обобщенная картина задержек, ошибок и пропускной способности по всем коннекторам и топикам CDC.
- DatarowLatency: задержка обработки каждого события на уровне консьюмеров, с разбивкой по таблицам.
- SchemaEvolution: количество изменений схем и актуальная версия схемы по источникам.
- DownstreamConsumption: метрики потребителей данных: количество потребленных записей, средняя задержка от потока к аналитике.
- Alarms & Health: статус здоровья по узлам инфраструктуры, алерты по порогам задержек и ошибок.
Инструменты визуализации и интеграции
- Grafana: визуализация time-series метрик, создание алертов и панелей, связанных с источниками. Подключение к Prometheus и/или другим источникам.
- Grafana Loki/Tempo: для корреляции логов и трассировок с дашбордами по событиям CDC.
- OpenTelemetry: единая телеметрия для распределённых транзакций и коннекторов.
- Управление контекстом: связывание бизнес‑идентфикаторов (order_id, user_id) с потоками изменений для глубокого анализа.
Пример архитектурной диаграммы (описание)
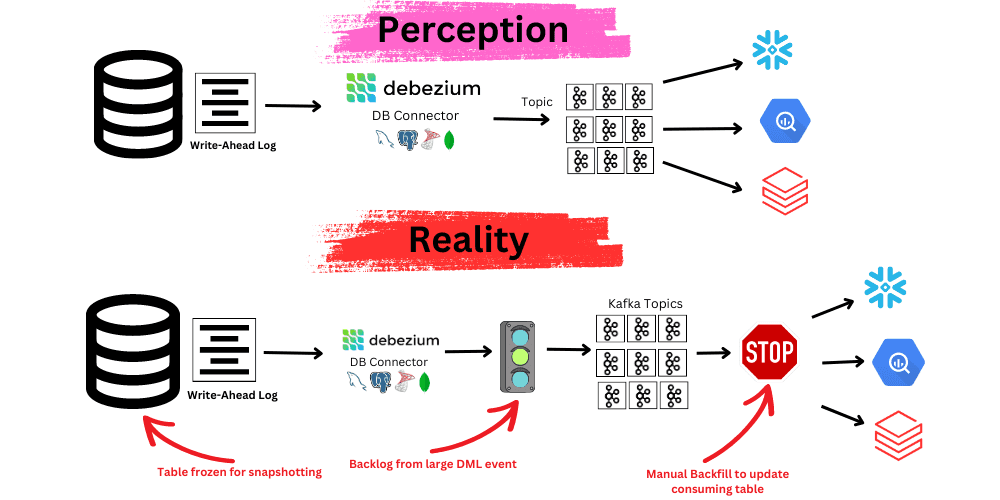
С точки зрения архитектуры наблюдаемости, цепочка состоит из источника изменений (база данных), Debezium/Коннектор, Kafka как транспорт, Schema Registry для версионирования схем, downstream‑слой аналитики (data lake, warehouse) и панели мониторинга. Между компонентами размещаются сигналы трассировки и метрик, которые собираются в Prometheus/OpenTelemetry и визуализируются в Grafana. Важным элементом является связь между сигналами одного шага и следом в другом: например, повышение lag на топике может коррелировать с ростом ошибок коннектора и спадыми требования к SLA по бизнес‑сущности.
Аналитика изменений и отчетность
Аналитика изменений фокусируется на том, как именно происходят изменения в данных и как это отражается в downstream‑потребителях и бизнес‑потребителях. Включает анализ эволюции схем, версионирование событий, а также сценарии, связанные с регуляторной отчетностью.
Аналитика изменений
- Подсчёт объема изменений: количество изменений по таблицам и топикам, распределение по операциям (CREATE/UPDATE/DELETE).
- Контроль версии схем: отслеживание изменений схем и совместимость между версиями для downstream‑потребителей.
- Drift и консистентность: мониторинг несоответствий между ожидаемой схемой и фактическими полями событий, обнаружение пропусков полей и пустых значений.
- Идентификация ошибок схемы: обработка невалидных форматов, неправильных типов данных и несоответствий между версиями.
Отчетность и соответствие
- SLA и регуляторная отчетность: предоставление сводок по задержкам, доступности и точности обновлений, экспорт статистики в регуляторные системы.
- Архитектура для отчетности: построение атомарной области данных (data mart) для CDC‑источников, чтобы отдел аналитики мог формировать сводные отчёты без влияния на операционные пайплайны.
- Контроль качества данных: данные об изменениях и валидационные правила на стороне потребителей, чтобы обеспечить полноту и точность.
Архитектура данных для отчетности
- Использование инкрементальных загрузок в аналитические слои с поддержкой версии схем, чтобы избежать повторной загрузки больших объёмов.
- Нормализация на доменной модели: чтобы бизнес‑модули могли использовать единые ключи и идентификаторы изменений.
- Метрики согласованности, кросс‑ссылки и аудит: обеспечение трассируемости изменений от источника к итоговой отчетности.
Инфраструктура и интеграции
Рациональная инфраструктура наблюдаемости предполагает тесную интеграцию между Debezium, Kafka и инструментами мониторинга. Это обеспечивает единый контракт по сигналациям и упрощает диагностику.
Интеграции в стек Debezium-Kafka-Мониторинг
- Debezium Connector API и Kafka Connect: настройка обработки ошибок, повторной попытки и реализации стратегий Idempotent Records.
- Kafka metrics и consumer lag: мониторинг с Prometheus для топиков CDC и потребителей.
- Schema Registry: единый контракт форматов, поддержка эволюции схем без потери обратной совместимости.
- Визуализация: Grafana dashboards, объединяющие метрики, трассировки и логи.
Безопасность, соответствие и качество данных
- Контроль доступа: ограничение прав к конфигурациям коннекторов и к данным в топиках CDC.
- Контроль целостности: проверка целостности сообщений и детектирование ошибок в схемах.
- Управление версиями и регламенты: строгие процедуры версионирования схем и деплоя обновлений.
Развертывание и операционные практики
- Непрерывная интеграция и доставка (CI/CD) для конфигураций Debezium и мониторинга.
- Канонические метрики и алерты: стандартные пороги, позволяющие быстро реагировать на аномалии.
- Резервирование и отказоустойчивость: репликация коннекторов и топиков, сценарии восстановления.
Практические примеры реализации
В этом разделе приводятся примеры конфигураций и паттернов развёртывания, помогающие закрепить принципы, изложенные выше, и являются отправной точкой для реального проекта.
- Конфигурация Debezium MySQL коннектора (минимальный пример)
- Конфигурация мониторинга и алертинга в Prometheus/Grafana
- Паттерны развёртывания: централизованный контроль конфигураций, канон со схемами и версионированием, разделение сред
{
  "name": "inventory-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "tasks.max": "4",
    "database.hostname": "db1",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "dbz",
    "database.server.id": "184054",
    "database.include.list": "inventory",
    "database.history.kafka.bootstrap.servers": "kafka:9092",
    "database.history.kafka.topic": "dbhistory.inventory",
    "transforms": "route",
    "transforms.route.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.route.regex": "([^.]+)\\.(.*)",
    "transforms.route.replacement": "$1_$2"
  }
}
Данная конфигурация демонстрирует базовый сценарий: параллелизация через tasks.max, указание источника, история изменений, маршрутизация топиков и интеграция с конвейером Kafka. В реальном проекте добавляются параметры аудита, мониторинга и усиленная безопасность.
Key takeaways
- Наблюдаемость CDC‑пайплайна требует целостного подхода к сигналаам на каждом уровне: источник изменений, транспорт, схемы и потребители.
- Эволюция схем должна поддерживаться через версионирование и регистры схем, чтобы снизить риски при обновлениях базы.
- Механизмы мониторинга задержек, лагов и ошибок должны быть встроены в архитектуру и связаны с бизнес‑контекстом через связывание ключевых идентификаторов.
- Дашборды потоков должны сочетать технические KPI и бизнес‑показатели, чтобы обеспечить полезную диагностику и оперативное принятие решений.
- Важно обеспечить подход к регуляторной отчетности через архитектуру данных для отчетности и единые каналы экспорта сигнала в регуляторные системы.
- Инфраструктура наблюдаемости требует единого контракта по сигналам, централизованного хранения и согласованной стратегии алертинга.
- Реализация и развёртывание должны поддерживать безопасность, конфиденциальность и аудит, с чёткими процедурами миграции схем и ролями доступа.
FAQ
Вопрос: Что такое Change Data Capture и зачем нужна наблюдаемость для Debezium?
Change Data Capture - это механизм отслеживания изменений в базе данных и передачи их в другие системы в виде событий. Наблюдаемость обеспечивает прозрачность этого потока: отслеживает задержки, эволюцию схем, ошибки коннекторов и состояние потребителей, что позволяет оперативно реагировать на проблемы и поддерживать регуляторные требования.
Вопрос: Какие основные сигналы следует собирать для CDC‑наблюдаемости?
Основные сигналы включают задержку (latency) и лаг потребителя, throughput по топикам CDC, ошибки коннекторов, изменения схем (версии), а также трассировки и логи связанных сервисов. В сочетании они дают полное представление о здоровье пайплайна и качестве данных.
Вопрос: Какую роль играет Schema Registry в наблюдаемости?
Schema Registry обеспечивает единый контракт форматов и поддержку эволюции схем. Это важно для детекции drift и корректной обработки изменений на downstream‑слоях. Наблюдаемость без контракта об эволюции схем будет неполной и рискованной.
Вопрос: Какие дашборды наиболее полезны для команд ?
Дашборд Pipeline для общей картины, DatarowLatency для детального анализа задержек на уровне таблиц, SchemaEvolution для контроля эволюции схем и DownstreamConsumption для потребителей. Эти панели позволяют быстро локализовать проблему и определить, на каком уровне она возникает.
Вопрос: Как обеспечить регуляторную отчетность в контексте CDC?
Необходимо создать data mart/аналитическую зону, которая хранит версии схем, параметры изменений и историю событий. Включение SLA‑показателей, аудита изменений и экспорт готовых наборов метрик в регуляторные системы обеспечивает соответствие требованиям.
Вопрос: Какие инструменты чаще всего применяются для наблюдаемости Debezium‑CDC?
На практике применяют Prometheus для метрик и алертинга, Grafana для визуализации, OpenTelemetry для трассировок, Schema Registry для управления схемами и Kafka для транспортировки потоков изменений. В некоторых случаях добавляют Elasticsearch/Loki для логов и Tempo для распределённых трассировок.
Вопрос: Как минимизировать риски при эволюции схем?
Рекомендуется внедрить версионирование схем, окна миграции, дефолтные значения для новых полей и явную стратегию обработки удаления столбцов. Это снижает вероятность ошибок downstream‑консьюмеров и уменьшает простои.
Вопрос: Какие паттерны развертывания полезно применить в Observability?
Централизованный контроль конфигураций коннекторов, канонические среды (dev/stage/prod) с одинаковыми правилами мониторинга, применение IaC для инфраструктуры мониторинга и CI/CD для обновлений коннекторов и панелей наблюдаемости.
Вопрос: Как связать сигналы наблюдаемости с бизнес‑контекстом?
Связать необходимо через идентификаторы бизнес‑сущностей (например, order_id, customer_id) и связывать их с соответствующими изменениями в CDC. Это позволяет строить бизнес‑ориентированные дашборды и проводить корелляционный анализ между бизнес‑показателями и потоками изменений.
Вопрос: Какие подводные камни чаще всего встречаются при внедрении наблюдаемости CDC?
Неправильная синхронизация времени между компонентами, Nichtкорректное управление версиями схем, отсутствие централизованного хранения сигналов, слабый алертинг и недостаточная корреляция между сигналами. Важно заранее определить сигналы и контракт данных, чтобы избежать расхождения между реальным состоянием пайплайна и тем, что отображается в дашбордах.
Вопрос: Какие шаги предпринять для начала проекта наблюдаемости CDC?
Определить ключевые бизнес‑цели и KPI, выбрать инструменты мониторинга и хранения сигналов, зафиксировать политики версионирования схем, внедрить базовые дашборды и алертинг, затем постепенно расширять набор сигналов и dashboards, ориентируясь на реальные инциденты и регуляторные требования.


