

Этапы внедрения Debezium и CDC: дорожная карта для организаций
Debezium как платформа Change Data Capture (CDC) позволяет получать изменения из баз данных в режиме реального времени и распространять их в потоки событий. Правильное проектирование, внедрение и эксплуатация CDC-решения требуют системного подхода: от архитектурных решений до операционных практик, обеспечения качества данных и соответствия требованиям безопасности. В данной главе изложена дорожная карта для организаций, желающих перейти от теории к стабильной рабочей системе потоковой репликации изменений с Debezium.
Debezium открывает новые возможности в цифровой трансформации: снижение задержек между событиями в БД и аналитическими потребителями, упрощение интеграций между системами и ускорение принятия решений. Однако успешная реализация требует четкого определения целей, выбора подходящих компонентов и эффективного управления изменениями в источниках данных, формате сообщений, а также в инфраструктуре и операциях. В рамках главы рассматриваются принципы архитектуры, последовательность действий на каждом этапе внедрения, практические рекомендации по построению надежной конвейерной архитектуры и инструменты для контроля качества данных, мониторинга и безопасности.
- Определение целей проекта и выбор масштабируемой архитектуры CDC
- Инвентаризация источников данных и проектирование конвейера изменений
- Развертывание инфраструктуры, настройка коннекторов и режимов мониторинга
- Тестирование, контроль качества данных и управление изменениями схем
- Интеграции Debezium с потоковыми платформами и потребителями
Архитектура Debezium и CDC: принципы и решения
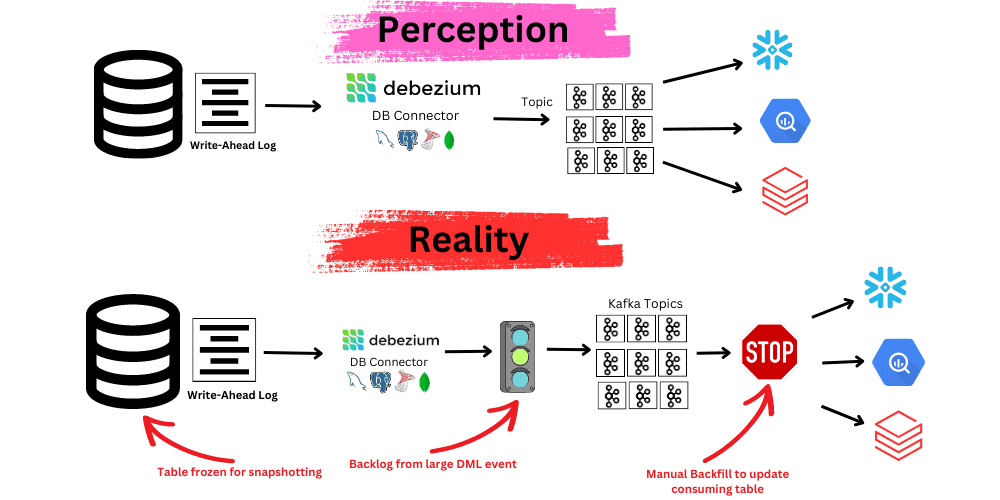
Debezium реализует CDC через коннекторы к различным системам управления базами данных, схему изменений и передачу событий в шину потоков, чаще всего основанную на Apache Kafka. В основе архитектуры лежат несколько ключевых компонентов: база изменений, коннекторы CDC, инфраструктура для оркестрации коннекторов, топики Kafka и потребители событий. Эффективная архитектура требует единообразной модели данных, управления схемами и устойчивого операционного режима.
-
Компоненты Debezium и роль CDC
Debezium состоит из набора коннекторов (MySQL, PostgreSQL, MongoDB и др.), которые подключаются к источникам изменений и генерируют события в виде последовательности изменений в формате JSON или Avro. Коннектор запускается внутри сред исполнения Kafka Connect и публикует события в топики Kafka. Ключевые аспекты включают: детектирование изменений на уровне логов транзакций, обработку вставок/обновлений/удалений, сохранение истории схем и поддержку эволюции схем без прерывания потоков.
-
Протоколы, форматы данных и обработка схем
CDC-источники используют журналы изменений БД (Write-Ahead Logs, redo logs и т.д.) для извлечения событий. Debezium формирует полезную нагрузку с полями до и после изменений, временными метками и контекстной информацией о транзакциях. При эволюции схем Debezium может сохранять историю изменений в книге схем (schema history) и реагировать на добавление колонок или изменений типов. Важно предусмотреть совместимость форматов плайнов и потребителей: Avro или JSON, использование схем Registry для управления схемами и поддержки эволюции без разрушения потребителей.
-
### Архитектурные решения: конвейеры и интеграции
Архитектура CDC должна учитывать требования по задержкам, пропускной способности и последовательности изменений. В классических реализациях Debezium работает в связке с Kafka Connect и Kafka, где источники изменений публикуют события в топики, а потребители читают их через консьюмеры. В современных сценариях возможно использование потоковых платформ помимо Kafka, включая Pulsar или интеграцию через Flink/Spark для обработки в реальном времени. В этом контексте архитектура должна поддерживать разделение конвейера на слои: источники, коннекторы, шина событий, обработчики потребителей и хранилища вторичных данных (data lake, data warehouse). -
Безопасность и управление доступом
В архитектуре CDC критически важно реализовать безопасную аутентификацию и авторизацию к источникам данных, шине событий и потребителям. Это включает TLS-шифрование, Kerberos/аутентификацию, управление секретами и ограничение доступа по ролям. Роль schema registry и политики совместимости также следует учитывать для обеспечения согласованности данных между коннекторами и потребителями.
{ "name": "inventory-connector", "config": { "connector.class": "io.debezium.connector.mysql.MySqlConnector", "tasks.max": "1", "database.hostname": "dbhost", "database.port": "3306", "database.user": "debezium", "database.password": "dbz", "database.server.id": "184054", "database.include.list": "inventory", "database.history.kafka.bootstrap.servers": "kafka:9092", "database.history.kafka.topic": "dbhistory.inventory" } } -
Пример конфигурации коннектора в формате JSON демонстрирует, какие параметры критичны для запуска и как задаются источники, история изменений и интеграция с топиками Kafka. Подобные конфигурации служат основой единообразной конвейерной архитектуры и позволяют повторно использовать подходы на разных стадиях проекта.
Этапы дорожной карты внедрения Debezium и CDC
Дорожную карту целесообразно строить в виде последовательности шагов, фокусируясь на достижении конкретных целей по снижению задержек, масштабируемости и управляемости. В рамках этапов необходимо согласовать бизнес-цели с техническими требованиями к данным, инфраструктуре и операционным практикам. Ниже представлены ключевые этапы.
-
### Шаг 1. Определение целей проекта и рамок внедрения
Необходимо формализовать, какие данные и какие источники будут реплицироваться, какие потребители будут использовать события и какие уровни задержки являются допустимыми. Важно определить требования к консистентности и к точности временных меток. Установка целевой архитектуры (monolithic vs распределенная, локальная vs облачная) влияет на выбор инфраструктуры и charakterистики Failure Modes. -
### Шаг 2. Инвентаризация источников данных и существующих потоков
Проведите аудит всех баз данных: поддерживаемые СУБД, версии, режимы журналирования, требования к транзакционной согласованности и возможность подключения коннекторов Debezium. Оцените нагрузку на источники и потенциал влияния CDC на производительность. -
### Шаг 3. Проектирование целевой конвейерной архитектуры
Определите набор коннекторов, схемы публикации событий и топики. Решите, где будет размещаться история схем, как будет реализовано управление секретами, как будет осуществляться мониторинг задержек и как потребители будут обрабатывать повторяемые или дубликаты. Важным является выбор между локальной обработкой на консолидированной платформе и передачей изменений напрямую в Data Lake или Data Warehouse. -
### Шаг 4. Пилотный проект и критерии готовности
Реализуйте пилотный контур на единичной БД и ограниченном наборе таблиц. Определите метрики успеха: лаг коннекторов, задержка от источника до потребителя, полнота изменений и корректность обработки схем. Зафиксируйте пороговые значения и условия перехода к масштабированию. -
### Шаг 5. Масштабирование, переход к продакшн-эксплуатации
Переключитесь на продакшн-окружение: разверните кластер Kafka, настройте резервирование, обеспечьте устойчивость к сбоим. Введите политики версионирования коннекторов, мониторинга и аварийного восстановления. В конце цикла внедрения необходимо обеспечить документированную операционную практику и обученный персонал. -
### Шаг 6. Эксплуатация и развитие
Вводите непрерывное улучшение: управление схемами, новая функциональность коннекторов, расширение источников, оптимизация задержек и затрат, реализация сценариев кибербезопасности и соответствия требованиям регуляторов.
Инфраструктура, развёртывание и операционные режимы
Эффективное развёртывание Debezium требует выбора подходящей инфраструктуры и режима эксплуатации. В контексте крупных организаций предпочтение часто отдается Kubernetes с Debezium Operator, что обеспечивает упорядоченное управление коннекторами, обновлениями и масштабированием. Однако существуют и альтернативы, например, локальные docker-compose среды для пилотирования или облачные решения.
-
Развертывание и управление коннекторами
В продакшн-сценариях целесообразно использовать Debezium Operator, который управляет жизненным циклом коннекторов, обеспечивает мониторинг и упрощает обновления. В рамках инфраструктуры следует определить требования к ресурсам (CPU, память), лимиты по количеством соединений к источникам и масштабируемость. Рекомендуется разделить роль источников на отдельные коннекторы по БД, чтобы локализовать влияние изменений.
-
Конфигурации коннекторов и сценарии развертывания
Разделение коннекторов по назначению упрощает мониторинг, тестирование и безопасность. Для каждого источника следует определить набор параметров: hostname, port, учетные данные, список баз данных для репликации, параметры истории изменений и хранение схем. В качестве примерной настройки можно использовать конфигурацию, приведенную ниже в формате JSON, адаптированную под конкретные источники данных и окружение.
-
Безопасность и доступ к компонентам
В целях защиты рекомендуется использовать TLS для всех коммуникаций между коннекторами, Kafka и потребителями, а также управлять секретами через корпоративный секрет-хранилищ. За счет использования Kerberos или других механизмов аутентификации достигается необходимый уровень доверия между компонентами. Важна политика минимальных привилегий для учетных записей баз данных, чтобы ограничить возможные утечки.
-
Резервирование и устойчивость
Включение репликации топиков Kafka, резервировать ZooKeeper (или использовать KRaft в новых версиях Kafka) и настройка политик повторного чтения обеспечивают устойчивость. В контексте CDC стоит реализовать тесты на откат и проверку консистентности после сбоев, чтобы снизить риск потери изменений.
Мониторинг, тестирование и управление качеством данных
Надежная система CDC требует систематического мониторинга, тестирования и процедур управления качеством данных. Вопросы задержек, лагов, ошибок сериализации и эволюции схем часто являются предикторами проблемных ситуаций в продакшне. В этой части фокус на практиках мониторинга и контроля качества.
-
Метрики и сигналы мониторинга
Необходимо отслеживать лаг коннекторов, задержку между источником и потребителями, скорость генерации изменений, пропускную способность топиков, количество ошибок сериализации и повторных попыток. Важны также показатели доступности источников данных и состояния истории схем.
-
Эволюция схем и drift
Эволюция схем (schema evolution) - нормальная часть жизни источников. Необходимо внедрить стратегию управления изменениями схем: совместимость, миграции и версияцию, чтобы потребители могли обрабатывать новые поля без сбоев. drift схем может потребовать инструментов для автоматического обновления коннекторов или обработки изменений на уровне потребителя.
-
Тестирование коннекторов и end-to-end тесты
Пилотные проекты должны включать тестирование на целевых сценариях: корректная обработка вставок/обновлений/удалений, точная передача изменений в Kafka, корректная ретрансляция в целевые системы. End-to-end тесты помогают выявить узкие места на стыке источника и потребителей и снизить риск неожиданных задержек.
-
Контроль качества данных
Введите набор руководящих принципов: валидность значений, полнота, повторяемость и консистентность. Важно иметь механизмы для обнаружения и коррекции ошибок на пути конвейера. Примером может служить внедрение data quality checks на стороне потребителей, а также автоматическое журналирование несоответствий и уведомления ответственных лиц.
-
Безопасность и соответствие требованиям
Контроль доступа, аудита, мониторинг подозрительных действий и защита персональных данных - критически важны на протяжении всего жизненного цикла проекта. Обеспечение соответствия требованиям регуляторов и внутренним политикам должно присутствовать на этапе проектирования и эксплуатации.
Интеграции Debezium с потоковыми платформами и сценарии использования
После настройки CDC и инфраструктуры наступает этап интеграции с потоковыми платформами и потребителями данных. Основная идея - превращать события изменений в единый поток знаний, который поддерживает реальный анализ, оперативную аналитику и синхронизацию систем.
-
### Интеграции с Apache Kafka: топики, структура сообщений и потребители
Прямое подключение Debezium к Kafka обеспечивает эффективную маршрутизацию изменений в топики, где каждое событие содержит полезную нагрузку, набор ключей и метаданные. Важна единая политика именования топиков, контроль версий сообщений и поддержка стратегий exactly-once там, где применимо. Потребители могут использовать потоковые вычисления (например, Flink или Spark) или микроcервисы, подписанные на соответствующие топики. -
### Альтернативные платформы: Pulsar, Flink, Spark
В некоторых случаях целесообразно перенаправлять CDC-события в альтернативные потоковые системы, например Apache Pulsar, который может предоставить зрелые схемы маршрутизации и тонкую настройку QoS. Также возможно использование Flink или Spark Structured Streaming для обработки потоков изменений в рамках аналитических задач на стороне обработки. -
Архитектура потребителей и сценарии
CDC может обслуживать разнообразные потребительские сценарии: реальное обновление витрин данных (data warehouse), кэш-слой в микросервисной архитектуре, синхронную интеграцию между системами, мониторинг бизнес-ппроцессов и триггерную обработку. Важно обеспечить устойчивость к повторным событиям и возможность корректной повторной обработки без потери данных.
-
Гигиена данных и управление версионированием
В интеграциях необходимо продумать версионирование схем и управление псевдонимами полей, чтобы потребители могли корректно обрабатывать обновления. Рекомендуется использовать согласованные политики совместимости и кросс-платформенное тестирование, чтобы изменения в источниках не приводили к нестабильности на стороне потребителей.
-
Примеры сценариев внедрения
- Реальное времени аналитика: CDC из OLTP-баз данных регистрирует события и подает их в аналитические пайплайны на базе Kafka + Flink для регламентированной аналитики.
- Синхронизация витрин данных: изменения из БД операционной системы реплицируются в Data Lake и Data Warehouse для последующей бизнес-аналитики.
- Микросервисная синхронизация: изменения в одной БД приводят к обновлениям кэш-состояния и к реактивному поведению сервисов.
Key takeaways
- Debezium обеспечивает управляемый и стабильный подход к Change Data Capture через коннекторы к различным СУБД и публикацию изменений в потоковую шину.
- Архитектура CDC должна быть спроектирована с учетом лабораторий задержек, масштабируемости и устойчивости, включая безопасное управление секретами и доступом.
- Важна систематическая дорожная карта внедрения: от целей проекта к пилоту и масштабированию, с конкретными критериями готовности.
- Мониторинг и управление качеством данных являются неотъемлемой частью эксплуатации CDC, включая управление эволюцией схем и обработку drift.
- Интеграции с Kafka и альтернативными потоковыми платформами требуют согласованных стратегий по именованию топиков, сериализации сообщений и обработке ошибок.
- Безопасность, соответствие требованиям и устойчивость операционной среды должны присутствовать на всех этапах проекта.
- Применение практик тестирования и end-to-end проверки позволяет снизить риск аспектов задержек и несоответствий на продакшне.
FAQ
- Что такое Change Data Capture и зачем он нужен в Debezium?
- Change Data Capture (CDC) - это подход к извлечению только изменившихся данных из источников в режиме реального времени. Debezium реализует CDC через коннекторы, которые следят за журналами изменений баз данных и публикуют события в потоковую шину. CDC позволяет снизить нагрузку на источники по сравнению с полными копиями данных и обеспечивает более оперативное обновление потребителей.
- Какие источники данных поддерживает Debezium и какие ограничения?
- Debezium поддерживает широкую линейку СУБД, включая MySQL, PostgreSQL, MongoDB, SQL Server и Oracle в зависимости от версии. Важно учитывать версию СУБД, режим журналирования и требования к доступу. Некоторые СУБД требуют включения специфических режимов журналирования или дополнительных настроек для корректной генерации изменений.
- Как добиться устойчивости и минимизации лагов в продакшне?
- Уменьшение лагов достигается за счет правильного выбора параметров коннектора (частота опроса, обработка транзакций, параллелизм задач), выделения достаточных ресурсов для коннекторов и брокера Kafka, а также мониторинга задержек. Важна грамотная настройка масштабирования и репликации топиков, резервирования и своевременных обновлений коннекторов.
- Как управлять эволюцией схем без сбоев для потребителей?
- Эволюция схем требует согласованных политик совместимости. Debezium сохраняет историю схем и может обновлять коннекторы, чтобы отражать новые поля. Потребителям следует внедрить логику обработки изменений в новых полях и корректной обработки отсутствующих значений. Использование схем registry помогает централизованно управлять версиями схем.
- Какие практические шаги для пилотного проекта вы рекомендуете?
- Начните с одной базы данных, ограниченного набора таблиц и минимального набора потребителей. Определите целевые показатели (lag, задержка, полнота), создайте пайплайн с мониторингом и автоматическими тестами, и зафиксируйте критерии готовности к масштабированию. Пилот должен выявить узкие места до перехода к продакшн.
- Какие лучшие практики по конфигурации коннекторов?
- Разделяйте коннекторы по источникам на отдельные задачи, используйте управляемые секреты, включайте историю изменений и необходимо указывать корректные параметры совместимости схем. Рассмотрите возможность использования Kafka Connect в управляемом режиме, чтобы облегчить обновления и мониторинг.
- Как реализовать безопасную интеграцию Debezium в корпоративную среду?
- Внедрите TLS, аутентификацию и авторизацию между компонентами, настройте защиту секретов, применяйте минимальные привилегии для учетных записей БД, и используйте контроль версий и аудит изменений. Также рассмотрите политики безопасной передачи данных на уровне топиков, чтобы защитить чувствительные данные.
- Какие примеры инструментов для мониторинга CDC-пайплайна?
- Мониторинг может включать Prometheus + Grafana для метрик, алерты на лаги коннекторов и задержки, журналы ошибок коннекторов и интеграцию с системами управления инцидентами. Важно иметь дэшборды, которые показывают текущее состояние источников, коннекторов и потребителей в одном месте.
- Можно ли использовать Debezium без Kafka?
- В рамках типичной архитектуры Debezium часто применяется Kafka в качестве шины сообщений. Однако теоретически возможно связать Debezium с другими системами обработки через кастомные коннекторы или конвейеры, но это снижает готовность к тестированию и поддержки, и может потребовать дополнительных инфраструктурных решений.
- Какие сценарии помогают быстро начать в рамках методики DevOps?
- Включение CI/CD для коннекторов, автоматизированных тестов на осмысленные кейсы изменений, повторяемые сборки и развёртывания, а также автоматическое rollback в случае ошибок - все это ускоряет переход к продакшну и уменьшает риск.
Глава рассчитана на профессионалов в области данными и цифровой трансформации и предоставляет системное видение этапов внедрения Debezium и CDC: от архитектуры и проектирования до эксплуатации, мониторинга и интеграции с потоковыми платформами. Она поможет организациям выстроить устойчивый конвейер изменений, минимизировать риски и увеличить скорость получения актуальных данных для аналитики и операционных решений.


