

Масштабирование аналитических нагрузок и архитектурные паттерны
DuckDB как встроенный аналитический движок демонстрирует выдающуюся эффективность при работе с колонообразной загрузкой и сложными SQL-аналитическими операциями. В условиях современных data stack ключевыми становятся архитектура параллелизма, управление памятью и эффективная интеграция с внешними источниками данных. Глава рассматривает паттерны масштабирования, которые позволяют адаптировать DuckDB под разнообразные сценарии: от локальных подсистем анализа на периферии до централизованных серверных инстансов и облачных конвейеров обработки данных. Особое внимание уделено рациональному распределению вычислительной нагрузки, выбору алгоритмов исполнения и стратегиям эксплуатации в продакшн-средах.
Ключ к эффективному масштабированию - разговор об Architectural Design Choices: где и как запускать DuckDB, как управлять ресурсами, как обрабатывать большие наборы данных через columnar processing, и как выстроить устойчивую интеграцию в data stack без потери согласованности и управляемости.
- Архитектура параллелизма и управление памятью в DuckDB и на уровне инфраструктуры
- Интеграционные паттерны в современном data stack: от локального анализа до сервиса и конвейеров
- Оптимизация SQL-аналитики: алгоритмы исполнения, планирование запросов и протоколы взаимодействий
- Операционное сопровождение, мониторинг и управляемость в продакшн-средах
- Практические сценарии внедрения и риски, связанные с масштабированием
Архитектура масштабирования: параллелизм, память и хранение данных
В основе высокой производительности DuckDB лежит сочетание векторизованного исполнения и эффективного распределения работы между потоками. Архитектура движка гибко масштабируется как на уровне одного узла, так и в рамках более широких инфраструктурных паттернов. Векторизация минимизирует накладные расходы на обработку строк и делает вычисления более предсказуемыми для процессоров современных архитектур. Параллелизм проявляется на всех стадиях выполнения: сканирование столбцов, фильтрация, агрегации и соединения проходят в конвейере, который может динамически использовать доступные ядра.
Ключевые механизмы масштабирования:
- Параллелизм на уровне пула потоков. DuckDB умеет настраивать количество рабочих потоков, что критично в средах с ограниченными ресурсами или, наоборот, в кластерах с богатым CPU. В продакшн-окружениях рекомендуется устанавливать параметр threads в соответствии с реальной нагрузкой и конкурентностью.
- Потребление памяти и управление буферами. Эффективное использование памяти обеспечивает не только скорость, но и устойчивость к пиковым пиковым нагрузкам. Встроенные механизмы DuckDB позволяют задавать лимиты использования памяти и контролировать spilling при нехватке памяти.
- Columnar storage и внешние источники. Системы чтения Parquet/ORC напрямую поддерживаются DuckDB, что позволяет минимизировать преобразование форматов и максимально использовать колоночный режим обработки. В результате скорость сканирования и фильтрации данных возрастает пропорционально объему вводимых данных.
- Механизмы кэширования и повторного использования результатов. При повторном выполнении схожих аналитических запросов DuckDB может давать полезные ускорители через повторную аренуцию вычислений, что особенно критично в рамках BI-отчётности и интерактивной аналитики.
- Spill-to-disk и внешняя сортировка. При обработке больших наборов данных, выход за пределы доступной оперативной памяти обходит риски падения производительности. В таких случаях DuckDB применяет гибкие стратегии сортировки и хеширования с выбросами на диск, сохраняя корректность результатов.
PRAGMA threads = 8;
PRAGMA memory_limit = '16GB';
Эти примеры демонстрируют базовые принципы конфигурации, которые позволяют обеспечить согласованную производительность под реальным workload. В реальных сценариях важно помнить: достижение максимального throughput требует баланса между количеством потоков, доступной памятью и характером нагрузки (аналитика по большой выборке против глубокой агрегации с высокой карбонкой). При планировании масштабирования полезно моделировать пики и учитывать влияние других сервисов на узлы, где развёрнут DuckDB.
Разделение задач между локальными и удалёнными компонентами data stack имеет решающее значение. На локальном узле DuckDB может выступать как аналитический движок для пользователя или ETL-процесс на грани, тогда как серверная версия DuckDB-server обеспечивает совместную работу множества клиентов и единый доступ к общим данным. В таком контексте архитектура должна поддерживать согласованное управление версиями схем, централизованный реестр метаданных и единый подход к мониторингу.
Интеграционные паттерны в современном data stack
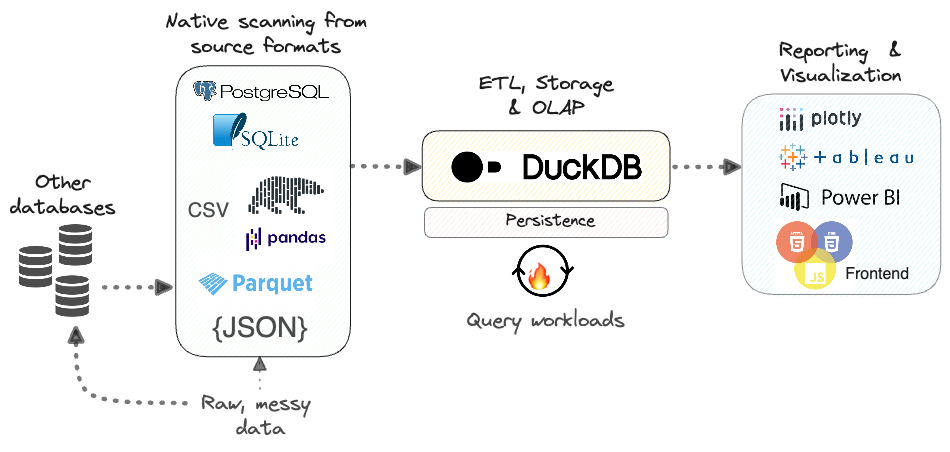
Современная аналитическая инфраструктура сочетает в себе ленточную память, ленивую загрузку, потоковую обработку и хранилища данных в формате колоночных файлов. DuckDB естественно интегрируется в такие паттерны благодаря своей способности напрямую читать Parquet/Arrow и поддерживать экспорт данных в эти форматы. В зависимости от сценария развертывания DuckDB может быть встроенным аналитическим движком в каждом вычислительном узле или агентом-обработчиком в сервисном слое.
Типичные интеграционные сценарии:
- DuckDB как локальный ETL-движок. В рамках data lake или data mesh DuckDB применяется на стадии ETL/ELT для фильтрации, агрегации и уплотнения данных перед загрузкой в хранилище. Здесь ключевыми являются скорость сканирования форматов колонн и возможность делать агрегации в памяти до передачи результатов в хранилище.
- DuckDB-server как сервис аналитики. Серверная версия позволяет нескольким клиентам отправлять SQL-запросы посредством сетевого протокола. Такой паттерн упрощает совместную работу команд, обеспечивает единый контроль доступа и согласованность метаданных, а также позволяет использовать единый планировщик ресурсов.
- Интеграция с потоковой обработкой. Для конвейеров, где данные поступают с высокой скоростью (Kafka, Pulsar), DuckDB может служить якорем для пакетной обработки: чтение пакетов данных, применение трансформаций и сохранение результатов в формате Parquet/ORC, подготовка к дальнейшему анализу в BI-инструментах.
- Универсальные механизмы доступа к данным. DuckDB поддерживает прямой доступ к файлам Parquet, Arrow и другим колоннарным форматам, что позволяет гибко связывать источники данных и ускоряет обмен данными между компонентами data stack без длительных ETL-циклов.
Пример реализации интеграционного сценария с Parquet-данными в Python:
import duckdb
con = duckdb.connect()

## Аналитика над Parquet-файлом без загрузки в единый оффлайн-табличный слой
df = con.execute("SELECT region, SUM(sales) AS total_sales
                  FROM read_parquet('s3://bucket/data/parquet/sales-*.parquet')
                  GROUP BY region").fetchdf()
print(df.head())
Такой подход демонстрирует, как DuckDB может выступать как мост между источниками данных и слоями бизнес-аналитики. В реальных системах целесообразно сочетать DuckDB с сервисами каталогов метаданных, системами оркестрации (например, Airflow или Dagster) и инструментами наблюдаемости. Важной частью является поддержание консистентности схем и версий данных между различными компонентами: источники данных, промежуточные конвертации и конечные витрины.
Оптимизация SQL-аналитики: алгоритмы движка, планирование и протоколы взаимодействий
Оптимизация аналитических запросов в DuckDB строится на трех китах: способность быстро сканировать данные, эффективные стратегии соединений и агрегаций, а также умение адаптивно распознавать оптимальные планы исполнения на основе текущих ресурсных ограничений.
- Планирование и выбор физических операторов. DuckDB реализует многоступенчатый подход к преобразованию логического плана в физический план: векторизованный исполнитель, выбор между хеш-джой и сортировочным джоем, выбор метода агрегации (hash-группировка vs. сортировка) в зависимости от объёма данных и доступной памяти.
- Предикат-пушдауны и фильтрации на раннем этапе. Эффективность аналитических запросов во многом зависит от того, насколько рано применяются фильтры и какие индикаторы статистики доступны. DuckDB стремится минимизировать количество обрабатываемых строк за счёт ранней фильтрации и оптимизации схем чтения форматов Parquet/Arrow.
- Кодогенерация и векторизированное исполнение. Важной особенностью является использование LLVM для генерирования специализированного кода под конкретный план выполнения. Это уменьшает накладные расходы на интерпретацию и повышает производительность на больших скейлах.
- Управление пиковыми нагрузками и spill-ability. При превышении памяти DuckDB может выгружать части промежуточных результатов на диск. Важна настройка параметров spill и размера кэш-памяти, чтобы не терять предсказуемость времени выполнения.
- Объяснение и профилирование. Для поддержки оптимизации рекомендуется использовать EXPLAIN, EXPLAIN ANALYZE и профилировку памяти. Это помогает выявлять узкие места, особенно в сложных запросах с несколькими соединениями и агрегированиями.
Пример концептуального сценария оптимизации запроса:
- Аналитический запрос с агрегацией по географическому признаку, с несколькими фильтрами и вычисляемыми полями.
- DuckDB выполняет фильтрацию на раннем этапе, затем применяет векторное объединение и агрегацию, минимизируя копирования и переходы между операторами.
- При необходимости переключение стратегий (например, выбор хеш-джоя против сортировки) подбирается в зависимости от доступной памяти и распределения данных.
Важно помнить: распределение вычислений в распределённых сценариях требует аккуратности. Если DuckDB развёрнут как сервер, необходимо обеспечить согласованный пул ресурсов и квоты для каждого клиента. В противном случае один запрос может «задушить» другие задачи в системе. Взаимодействие между приложением и движком следует проектировать так, чтобы запросы были предсказуемыми по времени выполнения и позволяли оператору быстро диагностировать источники задержек.
Протоколы и интеграционные аспекты
- Публичные сетевые протоколы. DuckDB-server поддерживает сетевые запросы через простой сетевой интерфейс, и клиентские библиотеки на Python, R и других языках позволяют строить единый доступ к данным.
- Безопасность и мультиарендность. В многопользовательских окружениях необходимо реализовать аутентификацию и авторизацию, ограничение доступа к данным и аудит операций.
- Набор поддерживаемых форматов. Parquet, Arrow и другие колоночные форматы - основа быстрого доступа к данным. Важно выбирать подходящие форматы в зависимости от задач: Parquet для лейк-слоя, Arrow для интерактивного анализа и передачи данных между компонентами.
Понимание того, как DuckDB превращает SQL-планы в эффективные конвейеры, позволяет проектировать архитектуру вокруг предсказуемых задержек и высокой пропускной способности. В практике следует задуматься о распределении ресурсов между вычислительными узлами, единообразии доступа к данным и об устойчивой политике обновления схем в продакшн-средах.
Архитектурные паттерны развертывания в современном data stack
Рациональная архитектура развертыванияDuckDB подразумевает баланс между локальной аналитикой и централизованной обработкой. Выбор паттерна зависит от требований к задержке, объемов данных, частоты обновления витрин и корпоративной политике по управлению данными.
- Встраиваемый узел против сервера. Встраиваемый DuckDB используют для локальной аналитики на отдельном узле или сервисе: быстрый доступ к данным, минимальные задержки, простая установка. DuckDB-server подходит для обеспечения совместного доступа к данным и централизованного управления ресурсами, что особенно важно при поддержке BI-отчётности и аналитических дашбордов в командах.
- Гибридный подход. Часто эффективна схема, в которой DuckDB является локальным движком на узлах для первичной агрегации и трансформаций, а результатные данные переносятся в центральное хранилище или в витрины. Это позволяет уменьшить долю данных, перемещаемых по сети, и увеличить скорость интерактивной аналитики.
- Облачная инфраструктура и Kubernetes. В облаке разумно разворачивать DuckDB в контейнерах или в виде DuckDB-server-подов, где можно масштабировать по горизонтали и управлять ресурсами через Kubernetes. В таком случае целесообразно реализовать распределение квот, мониторинг и автоматическое масштабирование.
Безопасное и устойчивое внедрение предполагает наличие архитектурной документации, стандартов по интеграции между DuckDB и другими системами (каталоги метаданных, механизмы обновления схем, политика резервного копирования), а также четкой стратегией кэширования и повторного использования результатов. Важно документировать конвенции именования, формат передачи данных между компонентами и правила обработки ошибок, чтобы обслуживание и эволюция архитектуры проходили без потери контроля и согласованности.
Операционная эксплуатация, мониторинг и управляемость
Эффективное масштабирование невозможно без качественной эксплуатации. Ключевые аспекты управляемости включают мониторинг нагрузки, профилирование запросов, авторизацию и трассировку, а также устойчивые механизмы восстановления после сбоев. Принципы:
- Метрики и мониторинг. В продакшн-средах критично иметь видимые показатели: throughput (запросов/сек), latency distribution, memory usage, CPU utilization, spill rate, cache hit ratio, I/O latency. Инструменты мониторинга должны быть интегрированы с кластерным оркестратором и системой алертинга.
- Обновления и миграции. Эволюция схем и обновление версий движка должны происходить без порушения доступности. Вводите миграционные планы, стадию тестирования на стейджинге и плавную миграцию витрин данных.
- Логирование и трассировка. Важно сохранять детальные логи выполнения запросов, чтобы определить источники задержек. Используйте структурированное логирование и корреляцию запросов с метаданными окружения.
- Управление ресурсами. Гибкое распределение CPU и памяти между DuckDB и СУБД/конвейерами позволяет избегать перегрузки узлов и обеспечивает предсказуемость.
Интеграция DuckDB в data stack требует приложения общего подхода к безопасности, управлению доступом и политиками хранения данных. Соглашение об управлении данными, версионировании схем и единый мониторинг - ключ к устойчивому масштаируемому решению.
Практические сценарии внедрения и риски
- Сценарий 1: локальная аналитика на границе. На периферийном узле пользователь выполняет интерактивные запросы через DuckDB встраиваемым образом. Плюсами являются отклик и независимость от внешних сервисов, минус - ограниченные ресурсы и необходимость синхронизации витрин.
- Сценарий 2: централизованный аналитический сервис. DuckDB-server обслуживает множество клиентов, обеспечивая единый доступ к данным и консистентность политик. Плюсы - легкость масштабирования и наблюдаемость; минусы - дополнительная сложность сетевого взаимодействия и безопасность.
- Сценарий 3: гибрид и конвейеризация. Локальные DuckDB-узлы выполняют тяжелые трансформации, а результаты складываются в витрину аналитики. Такой подход снижает сетевые расходы и ускоряет аналитические сценарии, однако требует детального управления данными и миграциями.
В рамках этих сценариев полезна модель стадийности внедрения: пилот, ограниченный по данным и пользователям; затем расширение в рамках ограниченной бизнес-подразделения; и, наконец, масштабирование на всю организацию. В каждом этапе следует проводить оценку рисков, в том числе рисков по управлению версиями данных, согласованию схем и согласованности ресурсов.
Key takeaways
- DuckDB сочетает векторизованное исполнение и параллелизм, что обеспечивает высокую производительность при columnar processing и работе с Parquet/Arrow.
- Выбор архитектуры развертывания (embedded vs server) влияет на латентность, управляемость и масштабируемость. Гибридные паттерны часто оказываются наиболее эффективными в реальных средах.
- Интеграция DuckDB в data stack должна происходить с учётом каталогов метаданных, единых политик безопасности и мониторинга ресурсов.
- Оптимизация запросов строится на раннем фильтровании, эффективном выборе физических операторов и использовании кодогенерации. Spill и управление памятью критичны для устойчивости под нагрузкой.
- Практические схемы включают локальную аналитику на периферии, сервера для совместного доступа и гибридные конвейеры. Внедрению предшествует стадийное тестирование и аккуратная настройка ресурсов.
- Обеспечение наблюдаемости и управления ресурсами - залог плавного масштабирования и минимизации простоев.
- Важно документировать конвенции, схемы и политики безопасности, чтобы упорядочить эволюцию архитектуры и ускорить внедрение новых паттернов.
FAQ
- Какие главные архитектурные преимущества DuckDB для аналитики в больших данных?
DuckDB обеспечивает высокую производительность за счет векторизированного исполнения, эффективной работы с памятью и сильной поддержки колоночных форматов. Это делает его особенно подходящим для интерактивной аналитики и пакетной обработки на грани или внутри сервисов. Архитектура позволяет быстро масштабировать вычисления в рамках одного узла и эффективно интегрироваться в существующий data stack через Parquet/Arrow и DuckDB-server.
- Как выбрать между встроенным DuckDB и DuckDB-server?
Для сценариев, где требуется минимальная задержка и локальный отклик, встроенный DuckDB на уровне приложения часто предпочтительнее. Если же требуется совместный доступ к данным нескольким пользователям, управляемый доступ, мониторинг и консистентная витрина, целесообразно рассмотреть DuckDB-server. В крупных организациях часто применяется гибридная архитектура: локальная аналитика на узлах плюс централизованный сервис для совместного использования.
- Какие протоколы и форматы данных следует учитывать при интеграции?
Главные форматы - Parquet и Arrow. Они позволяют DuckDB эффективно сканировать данные и передавать их между компонентами. В рамках сетевых сценариев DuckDB-server обеспечивает сетевой доступ к этим данным. Важно обеспечить согласование форматов и версий между источниками, конвейерами и витринами.
- Какие методы оптимизации запросов наиболее эффективны в DuckDB?
Главные принципы - фильтрация на раннем этапе, выбор эффективного плана исполнения (hash join vs sort-merge, агрегации), использование векторизованного execution и кодогенерации. Также важна эффективная настройка памяти и управление spilled data, чтобы не допускать резких задержек.
- Какие операционные практики критичны для стабильности в продакшн?
Включают мониторинг метрик, логирование и трассировку запросов, управление ресурсами через оркестраторы, безопасное обновление схем и версий, а также практики резервного копирования и восстановления. Наличие регламентированных процедур по управлению изменениями снижает риски простоев и ошибок.
- Как проектировать паттерны масштабирования в data stack?
Следует начинать с пилота, который оценивает нагрузку, latency и требования к памяти. Затем переходить к гибридным паттернам, которые позволяют распределять вычисления между локальными узлами и централизованным сервисом. Критично обеспечить согласование данных, политики доступа и мониторинга для всех компонентов.
- Какие ограничения DuckDB следует учитывать в масштабировании?
DuckDB - это мощный аналитический движок, но он ограничен объемами памяти на каждом узле и характером нагрузки. Внешние spill-решения помогают, но требуют грамотной конфигурации. Для очень больших кластеров следует рассмотреть интеграцию с дополнительными системами хранения и управления данными, чтобы избежать узких мест и обеспечить устойчивую производительность.
- Какие практики тестирования производительности применимы к DuckDB?
Релевантны: нагрузочное тестирование с реальными кейсами аналитики, профилирование запросов, анализ латентности по различным паттернам запросов и мониторинг поведения памяти. Автоматизированные тесты помогут выявлять регрессии при обновлениях и конвертациях форматов.
- Можно ли использовать DuckDB с облачными хранилищами в режиме server?
Да. DuckDB-server поддерживает сетевой доступ и может работать совместно с облачными хранилищами через Parquet-форматы. Это позволяет реализовать единый аналитический слой в облаке и обеспечивать совместную работу пользователей.
- Какие примеры внедрения наиболее эффективны в крупных организациях?
Эффективный подход - гибридная архитектура: локальные DuckDB-узлы для быстрого анализа на периферии и централизованный DuckDB-server для совместной аналитики и контроля версий. Такой подход сочетает максимальную отзывчивость и управляемость данных, снижая последствия задержек и сетевых ограничений.


