

Масштабирование и архитектура зрелости: миграции и устойчивость
DuckDB как встроенная аналитическая база данных обладает уникальной архитектурой, оптимизированной под локальные данные и параллельную обработку в рамках одного процесса. По мере роста объёма данных, усложнения сценариев аналитики и требований к надёжности возникает потребность в принципах масштабирования, эволюции схем и устойчивости к сбоям. В этой главе рассматриваются архитектурные принципы DuckDB, практики миграции данных и схем, а также подходы к обеспечению устойчивости и долговечности при работе с Parquet и локальными наборами данных. Основной акцент сделан на баланс между теоретической концепцией и конкретными реализациями, которые пригодны для внедрения в продуктовую среду.
DuckDB функционирует как встроенная аналитическая база данных, что накладывает особые требования к архитектуре: минимизация задержек на этапе загрузки данных, эффективное использование памяти и процессорного времени, поддержка параллелизма без сложной координации между узлами, а также простота миграций и обновлений без внешних сервисов. Этим и продиктованы ключевые решения архитектуры: векторизованный механизм выполнения, гибкая система хранения данных в виде колоночного формата, чтение Parquet как входного формата и тесная интеграция с языками-приложениями через стандартные протоколы доступа. В рамках главы детализируются не только внутренние компоненты DuckDB, но и практики миграций и устойчивости, которые критичны для зрелого применения в реальных продуктах.
- Архитектура DuckDB и её роль в масштабировании на локальном устройстве.
- Подходы к миграциям схем и данных в условиях эволюции моделей анализа.
- Механизмы устойчивости: резервное копирование, контроль целостности и восстановление.
- Интеграции с Parquet и сценарии внедрения в локальные пайплайны.
Архитектура DuckDB в контексте масштабирования
DuckDB реализует архитектуру, ориентированную на выполнение аналитики в памяти и эффективное взаимодействие с внешними источниками данных. Основные компоненты включают в себя парсер и планировщик запросов, оптимизатор, исполнители и систему хранения. Взаимодействие между ними реализуется внутри одного процесса, что позволяет снизить задержки на межпроцессной коммуникации и обеспечить предсказуемость выполнения.
- Векторизованный движок обработки: данные обрабатываются пакетами векторных размеров, что позволяет эффективно использовать процессорные ресурсы и современные кэши. Такой подход особенно эффективен при агрегациях, сортировке и соединениях больших таблиц, типичных для аналитических нагрузок.
- Колонарная организация хранения: DuckDB хранит данные в колоночной форме, что усиливает сжимаемость и ускоряет сканирование нужных столбцов в рамках аналитических запросов. Это существенно снижает объём передачи данных между слоями и уменьшает потребность в памяти.
- Обработка Parquet и других форматов: DuckDB включает эффективные адаптеры для чтения Parquet, что позволяет использовать существующие parquet-источники как входные данные. Встроенная оптимизация фильтров и предикатов обеспечивает раннее уменьшение объёма обрабатываемых данных.
- Каталог и интеграции: каталог объектов (таблицы, представления, функции) обеспечивает управление метаданными, а интеграции через JDBC/ODBC, Python, R расширяют применимость DuckDB в продуктах без потери локального характера исполнения.
- Механизм управления памятью и планированием задач: DuckDB реализует гибкую стратегию планирования и распределения задач между потоками, адаптирующуюся к размеру оборудования и характеру нагрузки. Это критически важно для масштабирования на локальной машине, где ресурсы могут быть ограничены.
Почему это важно: архитектурная концепция DuckDB строится вокруг минимизации задержек и максимального использования локальных ресурсов. В контексте миграций и устойчивости это означает, что изменения схем и трансформации данных могут выполняться на месте без радикального перерабатывания инфраструктуры, что особенно ценно в стадиях зрелости продукта.
- Согласованность данных: планирование применяется к однофазной транзакционной модели DuckDB, которая обеспечивает атомарность операций в рамках одной базы данных. Это упрощает миграции и откаты при изменениях схемы.
- Инструменты отладки и диагностики: благодаря модульности архитектуры и явной структуре планирования, локализация узких мест в сценариях миграции или устойчивости становится более предсказуемой.
PRAGMA threads=4;
Настройка параллелизма через параметры окружения или PRAGMA позволяет адаптировать поведение DuckDB под конкретную машину и характер нагрузки. В продакшне подобная настройка должна происходить после тестирования на характерном наборе запросов и данных.
Модели выполнения и параллелизм: как достигается масштабирование
Этап выполнения запросов в DuckDB строится вокруг параллельной обработки с минимальными задержками на синхронизацию и максимально эффективной загрузкой процессорных ядер. Параллелизм достигается за счёт распараллеливания на уровне сканирования (например, чтение Parquet и извлечение столбцов) и на уровне выполнения операций (группировки, соединения, агрегации, сортировки).
- Параллелизм на уровне сканирования: чтение источников данных, таких как Parquet, может происходить параллельно по секциям данных, что ускоряет загрузку больших наборов. DuckDB применяет фильтрацию на ранних стадиях, чтобы уменьшить обработку неиспользуемых данных.
- Векторизация операций: обработка данных выполняется пакетами векторов, что обеспечивает предсказуемую производительность и эффективное использование кэш-линейности памяти.
- Планирование и конвейеры: запросы превращаются в граф исполнителей, где каждый узел графа отвечает за конкретную операцию (сканирование, фильтрацию, агрегацию, соединение). Пайплайны позволяют начать обработку следующего шага ещё до окончания предыдущего, тем самым уменьшая задержку конвейера.
- Динамический выбор планов: оптимизатор учитывает статистику и распределение данных, чтобы выбирать эффективные алгоритмы соединения (hash join, merge join) и способы сортировки, адаптируясь к размеру входа.
- Память и spill: когда данные не помещаются в доступной памяти, DuckDB использует механизм временного хранения на диске и алгоритмы выбора стратегий выполнения, чтобы продолжать обработку без потери корректности результатов.
Практическая практика по масштабированию на локальном уровне часто заключается в настройке числа рабочих потоков под доступные CPU-ядра и объёма оперативной памяти. Оптимальные значения зависят от характера запросов: аналитика с тяжёлыми агрегациями и сортировками требует больше памяти и времени CPU, чем простая выборка. Важно помнить, что чрезмерное увеличение числа потоков может привести к конкуренции за ресурсы и ухудшению общей производительности, если другие процессы системно используют CPU и дисковую подсистему.
- При работе с Parquet и другими внешними источниками полезно обеспечить параллельное чтение столбцов, чтобы снизить задержку загрузки и ускорить стартовую фазу анализа.
- Для больших агрегаций и сортировок следует рассмотреть настройку памяти и внешнего хранения (spill-to-disk) с учётом специфики рабочих нагрузок.
Миграции схем и данных: принципы зрелости
Эволюция моделей данных и требований к аналитике сопровождается изменениями схемы, форматов и правил обработки. В DuckDB миграции проводят на уровне схем и данных без разрушения существующих запросов и бизнес-логики, если следовать принципам совместимости и пошагового внедрения.
- additive changes как предпочтительная стратегия: добавление новых столбцов с дефолтными значениями или значениями NULL не требует переработки существующих запросов. Любые новые столбцы должны быть аккуратно проксированы через существующий слой абстракций и не ломать существующие представления.
- безопасная работа с типами: изменение типа столбца - это одна из наиболее рискованных операций. Обычно безопаснее создать новый столбец с нужным типом, заполнить его данными через конвертацию и после проверки перенести логику доступа на новый столбец, затем при необходимости удалить старый.
- перезапись для больших изменений: если изменения требуют переработки значительного объема данных (например, изменение формата значений, нормализация или перерасчёт агрегаций), разумно создать новую таблицу с нужной схемой и перенести данные через INSERT INTO … SELECT, затем удалить старую таблицу и переименовать новую.
- миграции в контексте Parquet: при миграции источников данных, особенно если они читаются как Parquet, можно поддерживать совместную работу старой и новой схем до полного перехода. В большинстве случаев DuckDB допускает чтение старой схемы вместе с новой, но итоговая целостность должна быть проверена.
- тестирование и откат: любые миграционные изменения должны сопровождаться тестами на репрезентативном наборе данных, с возможностью отката к предыдущей версии схемы. Это особенно критично для бизнес-аналитики, где различия в результатах миграции могут повлечь неверные выводы.
- стратеги внедрения: можно поэтапно внедрять изменения через представления (VIEW) или временные таблицы, позволяя прикрыть старую логику новой схемой без немедленного переработания существующих процессов извлечения данных.
Практические принципы миграции в DuckDB:
- избегать драматических изменений в одной итерации; фокус на обратимой эволюции.
- документировать шаги миграции и зависимости бизнес-логики.
- использовать тестовые сценарии, близкие к реальной рабочей нагрузке.
- планировать параллельные чтения Parquet и миграцию на уровне источников: одни данные читаются через старую схему, другие - через новую, чтобы минимизировать простой.
-- Пример безопасной миграции через добавление столбца
ALTER TABLE sales ADD COLUMN discount_percent DOUBLE;
UPDATE sales SET discount_percent = 0.0 WHERE discount_percent IS NULL;
При этом важно помнить, что любые шаги миграции следует выполнять в рамках согласованных процессов изменения данных и контроля версий схемы. DuckDB обеспечивает гибкость, которую позволяет использовать подходы additive changes и миграций через создание временных объектов, без немедленного разрушения текущего набора запросов.
Версионирование и совместимость: миграции DuckDB
Обновление версии DuckDB в продуктивной среде требует внимания к совместимости между форматом хранения, функциональностью и языковыми интерфейсами. Встроенная база данных сохраняет данные в собственном формате, и обновления движка часто включают улучшения оптимизатора, новые операции и дополнительные функции. Практика зрелого внедрения предполагает:
- тестирование: проверять все критичные кейсы аналитики на тестовой копии базы перед обновлением в продакшене.
- обратная совместимость: сохранять возможность чтения данных с предшествующей версии там, где это возможно, и документировать любые несовместимости.
- миграции каталога: изменения в метаданной структуре должны сопровождаться миграциями каталога с учётом сохранности объектов, зависимостей и ссылок на функции.
- минимизация риска: в рамках крупной миграции целесообразно выполнить её в окне обслуживания, когда нагрузка на систему минимальна.
Особые аспекты миграций DuckDB включают в себя совместность с Parquet и другими источниками данных, где новые версии могут улучшать чтение старых форматов или наоборот менять поведение некоторых функций. Поэтому прежде чем переходить на новую версию, рекомендуется проверить совместимость уточнений в документации проекта и выполнить интеграционные тесты на репрезентативном наборе запросов.
- структура поведения улучшенного плана выполнения: обновления оптимизатора могут изменить план выполнения. В тестах следует проверить критичные запросы, особенно те, что включают сложные соединения, агрегации и сортировку.
- взаимодействие с внешними источниками: Parquet, CSV и другие форматы могут иметь особенности чтения, которые меняются с версией движка. Важно проверить сценарии извлечения данных из внешних источников.
Устойчивость и устойчивость к сбоям: операции резервирования и восстановления
Устойчивость DuckDB к сбоям связана с целостностью данных и возможностью восстановиться после аварий на локальном устройстве. Встроенная Nature DuckDB подразумевает компактный, файловый формат хранения, который обеспечивает согласованность и детерминированность. Практические принципы устойчивости:
- целостность и атомарность: изменения в транзакциях выполняются такими образом, чтобы любой частичный прогон не приводил к частично обновленным данным. Это критично для точных бизнес-аналитических выводов.
- контрольная точность и диагностика: режимы аудита и проверок могут быть активированы через функции и команды, которые помогают выявлять несоответствия и сбои.
- резервное копирование и копии: поскольку DuckDB хранит данные в одном файле, копирование этого файла на внешнее устройство или в сетевое хранилище формирует точную копию базы. Для крупных наборов данных рекомендуется создание последовательных снимков файловой системы или использование арендованных возможностей ОС для снапшотов.
- восстановление из копий: в случае сбоя можно заменить текущую базу на копию и продолжить работу, затем повторить миграцию, если она была запланирована.
- параллелизм и устойчивость: при высокой нагрузке DuckDB может перераспределять работу между ядрами, что, при правильном мониторинге, помогает избежать перегрузок и простоев.
Практический подход к резервному копированию в локальной среде:
- проведение копирования базы в периоды минимальной активности.
- использование файловой системы с поддержкой снапшотов (например, Btrfs, ZFS, или файловых систем в облаке) для обеспечения консистентности на момент копирования.
- экспорт наиболее критичных наборов данных в Parquet или другой формат, чтобы сохранить последующие версии на внешнем носителе независимо от состояния базы.
Важно отметить, что DuckDB как встроенная аналитическая БД упрощает резервное копирование за счёт своей структуры и отсутствия сложной инфраструктуры кластера. Тем не менее, в продакшн-среде следует формировать план устойчивости на уровне операционной среды: резервное копирование, тестирование восстановления и мониторинг файловой системы.
Интеграции и сценарии внедрения: Parquet, локальные пайплайны и продукционные сценарии
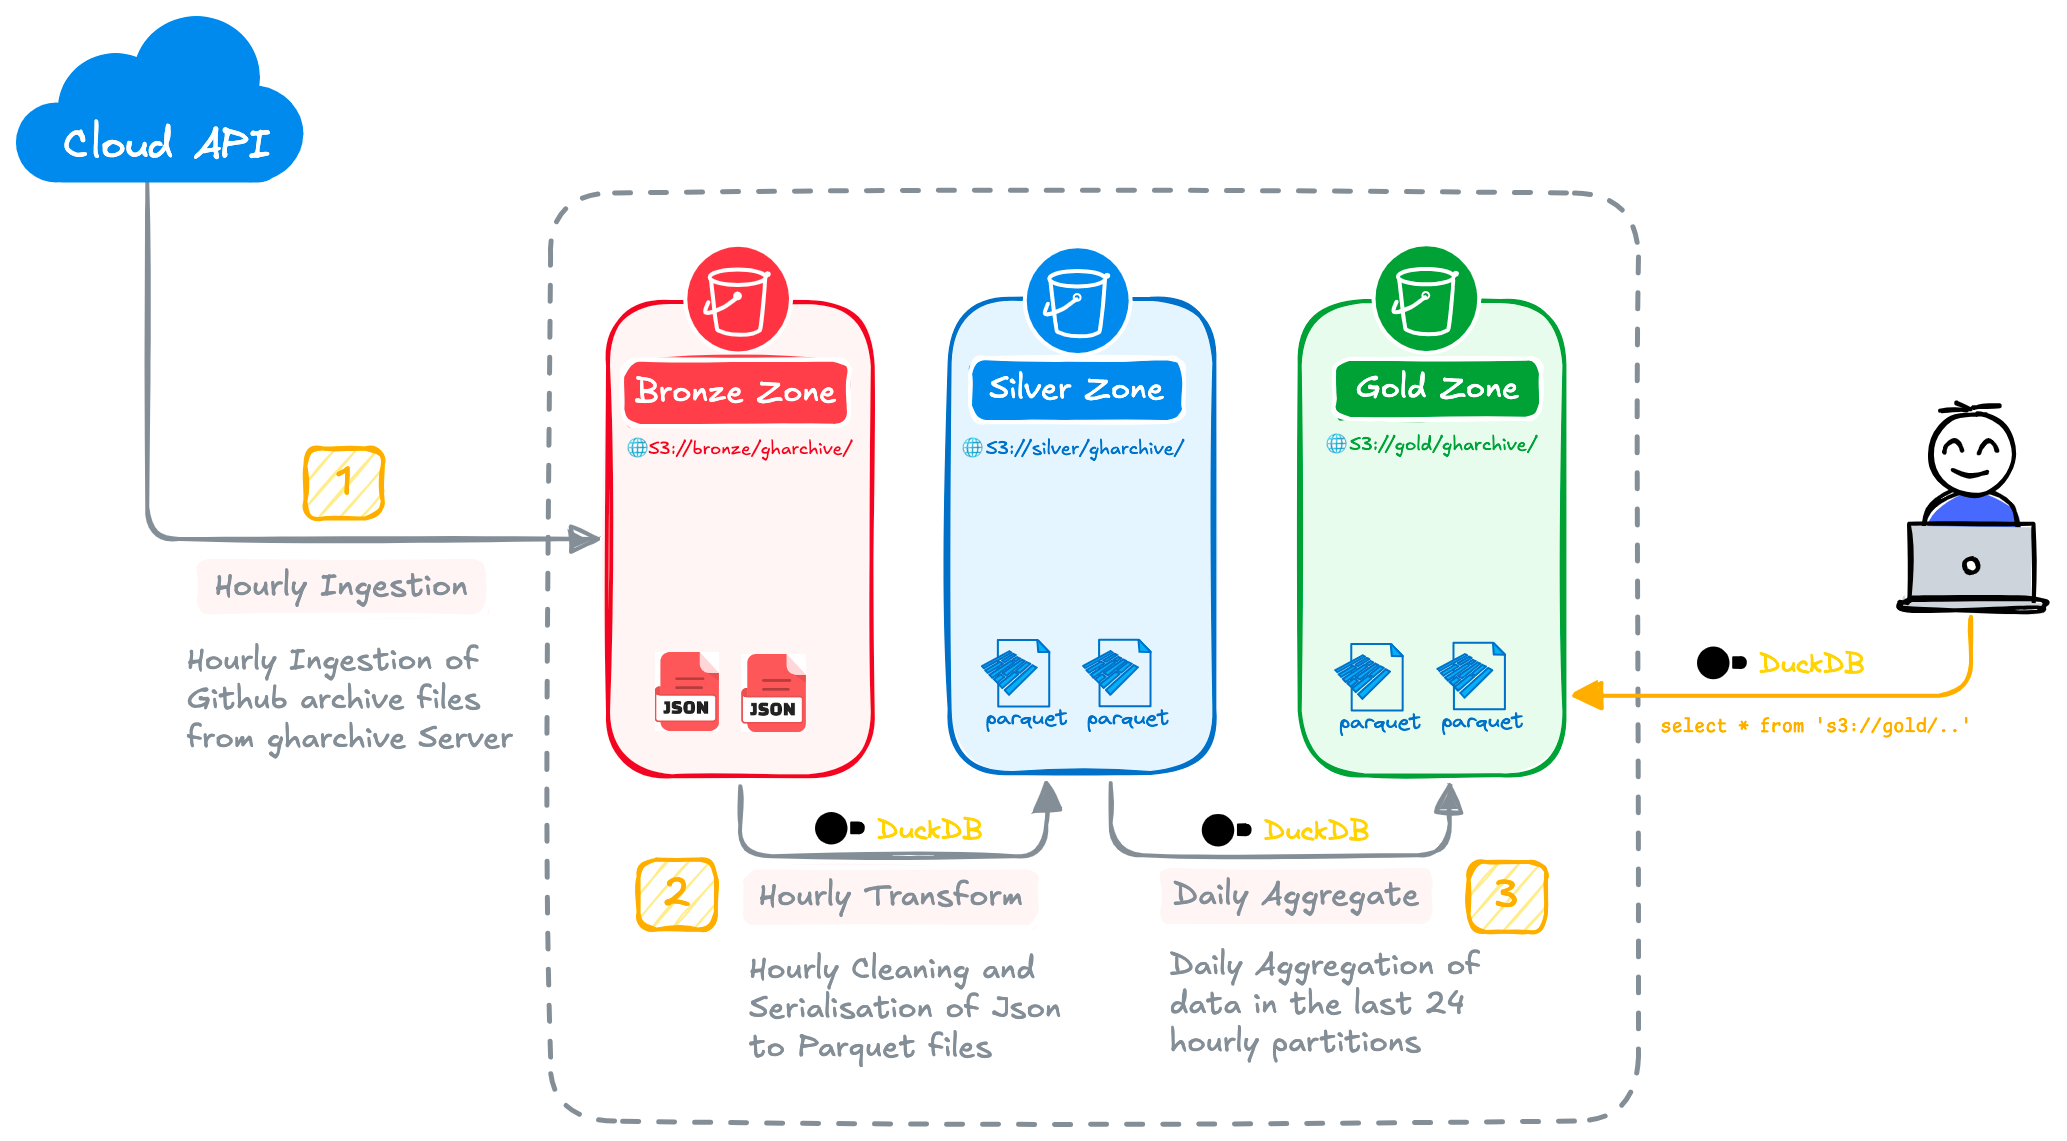
Экосистема DuckDB позволяет интегрировать локальную аналитику с Parquet и другими форматами данных, что развивает гибкость миграций и сценариев внедрения. Parquet остаётся одним из самых распространённых форматов для хранения аналитических данных из-за своей колоночной структуры и эффективной компрессии. DuckDB как часть локального пайплайна может выступать как точка агрегации и анализа, а также как инструмент для миграций и репликации данных между различными системами.
- чтение Parquet как источник данных: DuckDB оптимизирует чтение паркетных файлов и умеет пушить фильтры к источнику, чтобы минимизировать объём обрабатываемых данных. Это важно, когда данные поступают из систем хранения или пайплайна, где Parquet используется как стандарт обмена.
- запись Parquet для экспорта: аналитика может завершаться экспортом результатов в Parquet для дальнейшей обработки или передачи в другие системы. Это поддерживает линии данных, где DuckDB служит точкой агрегации перед хранением в долговременных системах.
- интеграция с языками и инструментами: доступ к DuckDB через Python, R, JDBC/ODBC позволяет внедрять локальные аналитические решения в существующие продукты, не перерабатывая инфраструктуру. В продукционных сценариях это означает, что аналитики и инженеры могут использовать DuckDB как локальную «рабочую станцию» для подготовки данных и быстрого анализа.
- сценарии миграции и перехода: миграции данных между форматами и системами часто проходят через DuckDB как мост между источниками и целями. Например, данные из CSV можно загрузить в DuckDB, преобразовать по новой схеме и экспортировать в Parquet для дальнейшего использования в хранилищах или аналитических пайплайнах.
- безопасность и контроль доступа: в локальных средах DuckDB обычно работает как часть приложения, поэтому управление доступом к данным во многом определяется политиками самой задачи. В случае мультипользовательного окружения следует рассмотреть изоляцию процессов и использование контейнеров, чтобы предотвратить случайное взаимодействие между сессиями.
Преимущества такого подхода заключаются в том, что локальная аналитика с DuckDB может служить мостом между этапами разработки и выпуска, обеспечивая устойчивость и контроль над миграциями. В результате можно уменьшить риск ошибок при обновлениях и миграциях, а параллельная обработка и поддержка Parquet расширяют возможности анализа больших наборов данных на локальном оборудовании.
Key takeaways
- DuckDB сочетает в себе архитектуру, оптимизированную для локальной аналитики: векторизованный движок, колоннарная структура и эффективную интеграцию с Parquet.
- Масштабирование на локальном устройстве достигается за счёт параллелизма и эффективного планирования выполнения запросов; настройка числа потоков должна соответствовать ресурсам машины и характеру нагрузки.
- Миграции схем и данных в DuckDB ориентированы на безопасную эволюцию, добавление столбцов и этапы переноса данных через временные таблицы без разрушения существующей бизнес-логики.
- Версионирование и совместимость требуют тестирования, документирования изменений и аккуратной миграции каталога и форматов хранения, особенно при работе с Parquet.
- Устойчивость достигается за счёт атомарности транзакций, консистентности копий базы и стратегий резервного копирования; использование файловых систем со снапShot может повысить надёжность восстановления.
- Интеграции с Parquet и локальными пайплайнами позволяют строить гибкие и надёжные аналитические потоки без необходимости разворачивать кластерную инфраструктуру.
- Практики миграций и устойчивости должны быть встроены в процесс разработки и эксплуатации: тестирование, документация и контроль версий на каждом этапе.
FAQ
- Какие особенности архитектуры DuckDB наиболее критичны для масштабирования на локальном устройстве?
- Основные особенности - это векторизованный движок выполнения, колоночная организация данных и параллельное выполнение запросов. Все это обеспечивает высокую пропускную способность анализа на локальном железе и уменьшает задержки по сравнению с строковыми хранилищами. Встроенный Parquet-ридер позволяет эффективно работать с внешними данными, не превращая DuckDB в промежуточное звено между несколькими системами. Архитектура также упрощает миграции и проверки целостности.
- Как DuckDB управляет параллелизмом и как его настраивать?
- Параллелизм достигается за счёт многоядерной обработки и разделения задач между потоками. Оптимально запускать DuckDB с числом потоков, равным количеству доступных ядер или чуть меньшим, чтобы сохранить реакцию операционной системы. Важной практикой является тестирование производительности под конкретной рабочей нагрузке: иногда меньшие значения потоков дают более стабильную задержку, чем максимальный параллелизм. Пример настройки: PRAGMA threads=4; в контексте вашей сессии.
- Какие паттерны миграций данных следует применять в условиях эволюции моделей данных?
- Рекомендовано добавлять новые столбцы, сохранять старые структуры и минимизировать риск разрушительных изменений. При необходимости изменений типа данных создавайте новый столбец, переносите данные через конвертацию и перенимайте логику доступа на новый столбец. При крупных изменениях применяйте временные таблицы и перенос данных через INSERT INTO … SELECT, затем удаляйте старые объекты и переименовывайте новые.
- Какие подходы к устойчивости DuckDB можно реализовать в продакшене?
- Основные подходы - это консистентность транзакций, регулярное резервное копирование базы и обеспечение возможности восстановления из копий. В локальной среде полезно использовать файловые системы с поддержкой снапшотов, чтобы получать консистентные снимки базы в момент копирования. В случае серьёзной аварии - наличие резервной копии позволяет минимизировать простой и продолжить работу.
- Что такое Parquet и как DuckDB взаимодействует с ним?
- Parquet - это колоночный формат хранения, оптимизированный для аналитики и эффективного исполнения запросов с фильтрами и агрегациями. DuckDB читает Parquet напрямую, применяя фильтры к источнику и уменьшая объём сканируемых данных. Кроме того, DuckDB может экспортировать результаты в Parquet, чтобы обеспечить совместимость с другими системами и пайплайнами.
- Как спроектировать архитектуру данных для DuckDB в локальном продакшне?
- Следует проектировать под additive изменения схемы, минимизировать количество переносов данных и учитывать характер запросов. Важно обеспечить гибкую миграцию между версиями форматов данных и поддерживать возможность чтения старых и новых форматов. Для интеграции с Parquet и другими источниками полезно устанавливать чёткую стратегию импорта и экспорта, чтобы можно было легко кэшировать результаты и повторно использовать данные.
- Какие ограничения и риски у встроенных аналитических БД по сравнению с распределёнными системами?
- Ограничения включают вычислительные ресурсы одного узла (CPU, память, диск), что требует аккуратной настройки параллелизма и планирования запросов. Также встраиваемые базы менее гибки в плане горизонтального масштабирования и распределённых обновлений. Риски связаны с потерей данных при сбоях, если не поддерживаются резервные копии, и с возможными ограничениями в обработке очень больших потоков одновременных запросов. Однако в контексте локальной аналитики DuckDB выигрывает за счёт скорости и простоты эксплуатации.
- Какие инструменты мониторинга и диагностики применимы для DuckDB?
- Мониторинг может включать встроенные метрики исполнения запросов, время выполнения, использование памяти и диска. Инструменты наблюдения, совместимые с Python, R или JDBC/ODBC-слоем, позволяют собирать логи и профилировать запросы. В продвинутых сценариях целесообразно использовать внешние средства мониторинга файловой системы и моментальные снапшоты для контроля над устойчивостью и миграциями.
- Как мигрировать существующие данные в DuckDB без потерь данных?
- Путь миграции зависит от источника данных. В случаях, когда данные находятся в Parquet или CSV, можно загрузить их в DuckDB, преобразовать к новой схеме и экспортировать обратно в Parquet для хранения. При изменении схемы следует практиковать миграцию через временные таблицы и последующую замену старых объектов новыми. Важно тестировать миграции на репрезентативном наборе данных и сохранять ревизии шагов.
- Каковы лучшие практики интеграции DuckDB с существующими пайплайнами?
- DuckDB может служить как локальная точка агрегации и превью данных. Для передачи данных во внешние хранилища и системы следует использовать Parquet как основной формат обмена данными. Интеграция с языками и инструментами через JDBC/ODBC и API позволяет внедрить DuckDB в существующие пайплайны без лишних сложностей. Рекомендовано документировать миграции и использовать тестовые сценарии, чтобы минимизировать риск ошибок на продакшн-данных.


