

Отказоустойчивость и доступность кластера: HA конфигурации, резервирование координатора, репликация нод
В промышленной среде требования к доступности и устойчивости к отказам существенно выше, чем в лабораторной или MVP-использовании. Традиционные многократные архитектуры для Trino предполагают аккуратную балансировку нагрузки, выбор активного координатора и географически распределённые ноды. Глава посвящена практикам проектирования и реализации отказоустойчивых кластера Trino: архитектурные решения, алгоритмы лидерства, принципы репликации нод и организации мониторинга, которые позволяют минимизировать простои и обеспечить предсказуемое время восстановления.
Переход к промышленной эксплуатации требует не только технического решения конкретной проблемы, но и системного подхода к планированию изменений, тестированию и подготовке операционной команды. В этом контексте рассматриваются паттерны, которые можно адаптировать к различным инфраструктурным реалиям: кластерам в дата-центрах, облачным средам, а также гибридной среде с разнесёнными зонами доступности. Особое внимание уделяется взаимодействию Trino с внешними системами метаданных, мониторинга и алертинга, а также с механизмами автоматического восстановления после сбоев.
-
Архитектура High Availability (HA) в контексте Trino: роли координатора и рабочих нод, discovery-сервиса, точка входа клиента и балансировка запросов.
-
Резервирование координатора: паттерны лидера, выбор активного узла, требования к консистентности и времени переключения.
-
Репликация нод и географическое развертывание: единообразие конфигураций, балансировка нагрузки, масштабирование и обновления без простоя.
-
Мониторинг и управление доступностью: метрики, журналирование, алертинг и тестирование отказов.
-
Планирование восстановления и практики Chaos Engineering: runbooks, DR-тесты, уровни резервирования и обучение персонала.
-
Архитектура HA в Trino: принципы доступности и роли компонентов
-
Резервирование координатора: паттерны организации лидера и времени переключения
-
Репликация нод: географическое развертывание и согласованность конфигураций
-
Мониторинг и управление доступностью: метрики, алертинг и действенные панели
-
Планирование восстановления: тестирование отказов, обучение и операционная подготовка
Архитектура HA в Trino: принципы доступности и роли компонентов
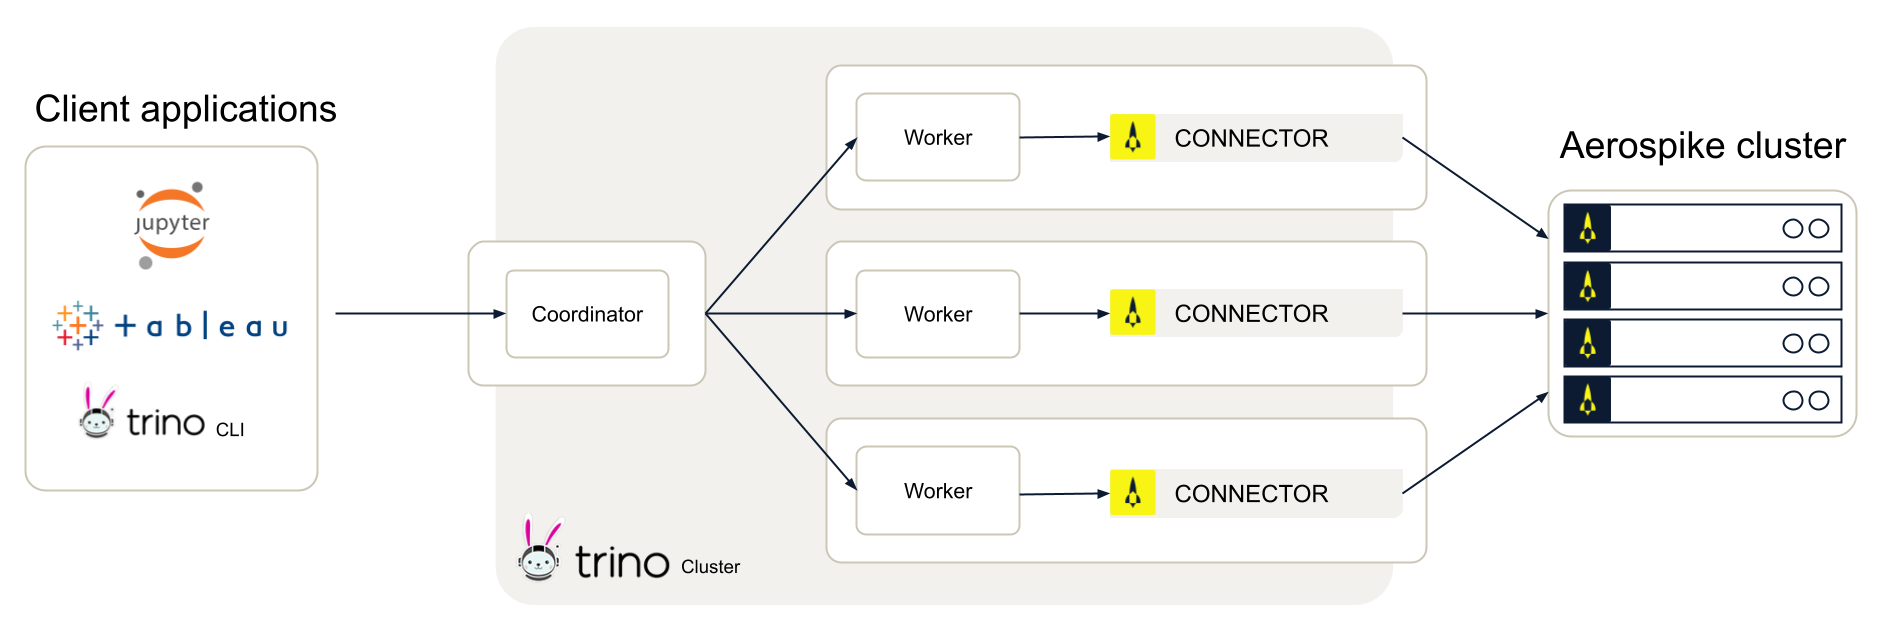
Основу отказоустойчивости составляют разделение ролей между координатором и нодами-исполнителями. В типичной конфигурации один координатор отвечает за планирование выполнения запросов, распределение задач и управление состоянием сеансов. Рабочие ноды выполняют чтение и обработку данных, возвращая результаты обратно к координатору. Чтобы обеспечить доступность при сбоях, необходимы следующие элементы.
- Discovery-сервис: источник информации о присутствующих координаторах и рабочих нодах. Клиенты и планировщик обращаются к этому сервису за актуальной топологией кластера. В HA-реализацииDiscovery-сервис должен выдерживать частичные сбои и обеспечивать консистентность реестра нод.
- Активный координатор и резервный (standby) координатор: большинство реализаций предполагает наличие одного активного координатора в данный момент времени и возможности безопасного перевода ролей на резервного при отказе активного узла. В случае смены лидера обновления маршрутов должны происходить без потери графа выполнения запросов и без дублей выполнения.
- Рабочие ноды: их основная задача** - обработка сквозной нагрузки и выполнение задач планировщика. В HA-конфигурации важно обеспечить равномерное распределение задач между нодами и устойчивость к отказам отдельных нод.
- Каталоги и внешние источники метаданных: многие кластеры Trino используют внешние хранилища метаданных (например, Hive Metastore) или соединяют внешние источники данных через соответствующие коннекторы. Конфигурации должны обеспечивать согласованное чтение метаданных независимо от того, какой координатор активен.
- Балансировщик входящих запросов: в промышленной среде зачастую применяется сетевой балансировщик или DNS-запись, указывающая на активного координатора. Это минимизирует задержку на фазе маршрутизации и упрощает мониторинг доступности точки входа.
Почему эти элементы критичны? Во-первых, без согласованной точки входа и корректного лидера планирования любой отказ координатора может привести к остановке выполнения существующих или новых запросов. Во-вторых, репликация конфигураций и единообразие версий между координатором и нодами уменьшают риск рассинхронизации и ошибок доступа к данным. И, наконец, устойчивость Discovery-сервиса и аккуратное управление маршрутизацией позволяют быстро перенаправлять клиенты к активному координатору без дополнительных задержек.
Рассматриваемые паттерны не требуют жесткой привязки к конкретному поставщику инфраструктуры. В зависимости от контекста применимы облачные механизмы ( managed DNS, health-check-ориентированный балансировщик), контейнерные оркестраторы (Kubernetes) и традиционные подходы на базе виртуализации. Важное решение - обеспечить наличие предсказуемого времени переключения и минимизацию потерь кэшированных данных на стороне клиентов и нод.
- Применение ведущего координации в Trino требует чёткой стратегии обновления конфигураций и контроля версий. Важно избегать ситуации, когда два координатора одновременно обрабатывают запросы, что может привести к дублированию или конфликтам планирования.
- Географическое разделение нод должно минимизировать вероятность одновременного отказа нескольких элементов инфраструктуры, но требует надёжной сетевой связности и согласованных политик обновления.
Резервирование координатора: паттерны организации лидера и времени переключения
Резервирование координатора - один из самых критичных аспектов HA. Рассматриваемые паттерны можно реализовать в рамках разных инфраструктур: от простых DNS-based схем до более сложных решений с лидерством через внешние сервисы.
- Лидерство через внешний сервис: выбор активного координатора может осуществляться через механизм лидера-выбора в серверах конфигурации (etcd, Consul) или через Kubernetes, где контейнер-агент следит за состоянием и поддерживает режим готовности. Такой подход обеспечивает надёжную смену лидера без ручного вмешательства и минимизирует риск гонок между двумя координаторами.
- Виртуальный IP и DNS: для клиентов создаётся абстрактная точка входа, которая указывает на активного координатора. При переключении лидера DNS-запись обновляется, а либо же DNS-сервис поддерживает кратковременные TTL-значения, чтобы обеспечить быструю переадресацию. Важно, чтобы переключение происходило без сбоев в рамках существующего сеанса и без повторного запроса авторизаций.
- паттерн с активным и резервным координатором: активный координатор обрабатывает запросы и поддерживает состояние сеанса, резервный имеет синхронную копию конфигураций и метаданных, но принимает только роли по запросу лидера. По сигналу отказа активного координатора резервный координатор поднимается и начинает обрабатывать входящие запросы. Такой подход снижает риск транзакционных конфликтов.
- Время переключения: в промышленной среде критично поддерживать предсказуемость. В зависимости от инфраструктуры ориентировочное время переключения может варьироваться от 5 до 60 секунд. В этом масштабе особенно важна обработка существующих сеансов и корректная передача планирования новым координатором. Для уменьшения задержек используется предиктивная координация и кэширование планов на клиентской стороне, где это возможно.
Технологические детали реализации могут различаться, но следующие принципы остаются общими:
- минимизация гонок: при наличии нескольких источников времени переключения необходимо обеспечить, чтобы только один координатор мог выполнять роль лидера в данный момент.
- сохранение совместимости: метаданные каталога и внешних источников должны быть доступны для любого координатора, чтобы не возникало расхождений в плане выполнения.
- мониторинг лидера: показатели доступности координатора, время переключения, количество запросов к активному координатору - критически важны для оперативной реакции на начало проблемы.
Рекомендации по реализации в промышленной среде:
- Использовать внешнюю систему лидирования (etcd/Consul или Kubernetes) для минимизации зависимости от конкретного технологического стека.
- Располагать координаторов в разных AZ или регионах, но сохранять единый вход через балансировщик/DNS.
- Развернуть standby-конфигурации с обновляемыми метаданными и минимальной задержкой синхронизации. Это сокращает время перехода и снижает риск рассинхронов.
- Вести строгий Runbook для операторов: последовательность отключения активного координатора, принудительное переключение и проверки целостности планирования и результатов запросов.
Репликация нод: географическое развертывание и согласованность конфигураций
Ошибка в одной ноде не должна приводить к падению всего кластера. Репликация нод - это способ обеспечить устойчивость вычислительных мощностей и уменьшить влияние локальных сбоев сети или оборудования. В контексте Trino репликация нод охватывает следующие практики.
- Географическое развертывание: размещение рабочих нод в разных зонах доступности или регионах снижает риск одновременного отключения нескольких нод и позволяет сохранять латентности на приемлемом уровне. В промышленной среде это особенно важно для защиты от региональных сбоев.
- Единообразие конфигураций: все ноды должны использовать идентичную конфигурацию (config.properties, любые параметры плагинов и коннекторов). Автоматизация развёртывания, например через GitOps-подход, снижает вероятность рассинхронизации после обновлений.
- Управление версиями коннекторов и метаданных: любые изменения в коннекторах, схемах источников данных или метаданных должны проходить через согласованный процесс развертывания, чтобы новый набор нод не работал с устаревшими версиями метаданных.
- Синхронизация версий и сервисов: версии Trino, JDBC/ODBC-драйверов, консистентность версии Hive Metastore и других внешних хранилищ должны быть согласованы между координатором и нодами. Это снижает риск ошибок совместимости во время выполнения запросов.
- Балансировка нагрузки и отказоустойчивость нод: если часть нод выходит из строя, остальные выполняют задачи, не прерывая выполнение запросов. Важно обеспечить достаточное избыточное количество нод, чтобы выдержать аппаратный сбой или сетевые проблемы.
- Обновления на нодах без простоя: обновления нод лучше выполнять по частям (rolling updates), чтобы сохранить непрерывность сервиса. Во время апдейтов необходимо следить за состоянием системы и синхронностью кэшей и планов исполнения.
Практическая логика управления нодами требует чёткой политики мониторинга: какие именно параметры влияют на решение об удалении ноды из пула, какое время ожидания (grace period) до перезапуска и какое регламентированное окно для обновлений. В промышленных условиях рекомендуется:
- устанавливать минимальные лимиты восстановления после сбоя (например, число работающих нод, минимальное значение доступности к трансформируемым данным);
- применять авто-масштабирование там, где инфраструктура поддерживает динамическую конфигурацию;
- поддерживать журнал изменений и версионность конфигураций, чтобы можно было быстро восстановить предыдущее состояние в случае несогласованности.
Мониторинг и управление доступностью: метрики, алертинг и тестирование отказов
Оценка состояния кластера и его способность к самовосстановлению требуют систематического мониторинга и тестирования. В промышленной среде это включает:
- Метрики и показатели: здоровье нод, время отклика, задержки планирования, доля успешно выполненных запросов, загрузка CPU, потребление памяти, сетевые параметры. Важной является метрика времени переключения лидера и частота неудачных попыток переключения.
- Взаимосвязь между компонентами: мониторинг взаимодействия_COORDINATOR-WORKER, доступность Discovery-сервиса и зависимость от внешних источников метаданных. Необходимо предусмотреть уведомления в случае несовместимости версий коннекторов и хранилищ.
- Логи и трассировки: структурированные логи событий старта/остановки_COORDINATOR, изменения состояний нод и статус выполнения запросов. Трассировка исполнения позволяет выявлять узкие места и непредвиденные задержки.
- Алертинг: заранее определённые пороги по каждому метрику и сценариям отказа. В промышленной среде важно настраивать оповещения на инциденты, способные повлиять на доступность сервиса, а не на бытовые регламентные проблемы.
- Панели мониторинга: наглядные дашборды, отражающие текущую топологию кластера, статус лидера, распределение нагрузки, региональные задержки и динамику отказоустойчивости. Регулярное использование таких панелей обеспечивает быструю идентификацию проблемы и ускоренную реакцию.
Для интеграции характерны следующие практические решения:
- Prometheus + Grafana как базовый набор мониторинга: сбор метрик Trino, нод и внешних систем, агрегация по кластерам и оповещения.
- JMX-метрики JVM для понимания поведения памяти и сборок мусора на стороне нод.
- Интеграция с системами централизованного логирования (ELK/EFK, OpenSearch) для структурированных журналов и поиска по ним.
- Удобство эксплуатации: наличие автоматических тестов регрессии для проверки алгоритмических сценариев переключения лидера и корректного маршрутизирования запросов.
С точки зрения архитектуры, мониторинг должен отражать четыре уровня: инфраструктура (узлы и сети), кластерная логика (координатор, лидеры), данные (коннекторы и источники метаданных) и качество обслуживания (время отклика, процент успешных запросов). Это позволяет оперативно выявлять сбои на ранних этапах и корректно инициировать процедуры восстановления.
Планирование восстановления и практики Chaos Engineering
Непрерывность работы достигается не только за счёт автоматических механизмов, но и через подготовку операционной команды и детальные планы восстановления. В промышленной среде целесообразно внедрять следующие подходы.
- Runbook по восстановлению: детальная пошаговая инструкция по ситуации перебоя координатора, потери связи Discovery-сервиса, проблемы с внешними источниками метаданных и падению отдельных нод. В runbook должны быть прописаны критерии перехода к резервному координатору, требования к проверкам целостности после переключения и этапы повторной интеграции с внешними системами.
- Тестирование отказоустойчивости: регулярные DR-тесты и сценарии, имитирующие утрату одной зоны доступности, перегрузку сети или падение внешних хранилищ. В промышленной среде такие тесты должны быть предсказуемыми и не приводить к непредвиденным последствиям в продакшене.
- Chaos Engineering: применение контролируемых экспериментов, направленных на разрушение зависимостей кластера, чтобы проверить устойчивость конфигураций и способность к самовосстановлению. Важно согласовать такие эксперименты с бизнес-окружением, определить лимиты влияния на пользователей и обеспечить возможность быстрого отката.
- Обучение персонала: регулярные симуляции инцидентов, обучение по работе с координацией лидеров и обработкой инцидентов. Разделение задач между администраторами, инженерами по данным и специалистами по безопасности способствует быстрой реакции и уменьшает время простоя.
Обеспечение устойчивости во многом определяется как способность к быстрой идентификации проблемы, безопасному переключению координатора и корректной работе рабочих нод в условиях частичности сбоев. В реальных условиях следует сочетать технические решения с организационными и операционными процессами: документированные runbooks, регламентированные тестирования и практику хаос-инженерии в рамках контроля риска.
Key takeaways
- HA в Trino строится на корректном разделении ролей координатора и рабочих нод, надёжной discovery-системе и единообразной маршрутизации входящих запросов.
- Резервирование координатора достигается через лидерство, которое может управляться внешним сервисом лидерства или средствами Kubernetes, с минимальным временем переключения и единым входом через балансировщик.
- Репликация нод предполагает географическое развертывание и согласование версий конфигураций и внешних источников, позволяя продолжать работу при сбоях отдельных нод или зон.
- Мониторинг и алертинг являются неотъемлемой частью устойчивости: набор метрик, журналирование и панели помогают предвидеть и локализовать проблемы раньше, чем возникает недоступность сервиса.
- Планирование восстановления и Chaos Engineering в сочетании с документированными runbooks обеспечивают предсказуемость операций и снижение риска длительных простоев.
FAQ
- Что такое дискриптор HA в Trino и зачем он нужен?
- Дискриптор HA - это концептуальная точка входа в кластер, которая ведёт к актуальному активному координатору. Он упрощает маршрутизацию запросов, ускоряет переключение и минимизирует влияние на клиентов в случае отказа координатора. Без надёжного дискриптора клиенты будут пытаться обращаться к неактивному коорданатору, что приводит к задержкам и ошибкам выполнения.
- Какие паттерны резерва координатора существуют в практике?
- Распространены паттерны с внешним лидером через etcd/Consul или Kubernetes-оркестрацию, DNS-вход через виртуальный IP или балансировщик, а также сочетание standby координатора с синхронной передачей метаданных. Важно не перегружать систему дублированием ролей и обеспечить безопасное переключение.
- Как обеспечить синхронность конфигураций между координатором и нодами?
- Использование GitOps-подходов, единых конфигурационных файлов и автоматизации развёртывания через инфраструктурные шаблоны позволяет гарантировать, что все ноды и координатор работают на одной версии конфигураций. Регулярная сверка версий и автоматизированные проверки совместимости снижают риск рассогласования.
- Какие метрики особенно важны для мониторинга HA?
- Время переключения лидера, доступность Discovery-сервиса, доля успешных запросов, задержки планирования, загрузка нод и ошибки коннекторов. Наличие детального лога и трассировок позволяет быстро локализовать источник проблемы.
- Как проводить DR-тесты без вреда для продакшена?
- Планируйте тесты в рамках изолированной копии окружения или в специально выделенном окне во времени. Используйте сценарии, которые воспроизводят реальные сбои: отказ координатора, потеря одного AZ, задержки в сетях. После теста выполняйте восстановление и регистрируйте результаты для улучшения процессов.
- Что учитывать при географическом развертывании нод?
- В первую очередь - сетевые задержки между зонами, требования к согласованию версий, устойчивость метаданных и доступность внешних систем. Важно избегать крайних сценариев, когда одни и те же данные обрабатываются изолированно в разных зонах, что может привести к конфликтам.
- Какие инструменты полезны для реализации HA в Trino?
- Приоритет отдаётся Kubernetes или другой оркестрации для лидера и развертывания, Prometheus и Grafana для мониторинга, обособленный DNS или балансировщик для входа, а также внешние хранилища метаданных (Hive Metastore) с согласованной стратегией версий. В открытом исходнике можно найти примеры конфигураций, адаптируемые под конкретные окружения.
- Что делать, если внешний источник метаданных недоступен?
- В таких случаях важно иметь режим работы: возможно временное ограничение на изменение схем и метаданных, кэширование метаданных на активном координаторе или помещение в очередь изменений с повторной попыткой. Необходимо обеспечить безопасное продолжение работы без компрометации консистентности данных.
- Как минимизировать простои при обновлениях нод?
- Применять rolling updates, ограничивать количество одновремённых обновлений, тестировать обновления в стейдж-среде, заранее внедрять совместимые версии коннекторов и метаданных. Планирование обновлений и контроль версий позволяют сохранить доступность сервиса.
- Какие существуют риски при реализации HA и как их минимизировать?
- Основные риски: несогласованность конфигураций, задержки переключения лидера, сетевые задержки между AZ, несовместимость версий коннекторов. Они минимизируются через автоматизацию развёртывания, строгий мониторинг, детальные runbooks и регулярные DR-упражнения.


