

Стратегии partitioning, bucketing и clustering для больших данных
Эффективная организация хранения в рамках Hadoop-экосистемы напрямую влияет на скорость ETL-процессов, качество аналитики и стоимость инфраструктуры. В данной главе рассмотрены архитектурные принципы partitioning, bucketing и clustering, их преимущества и компромиссы, а также практические рекомендации по реализации в рамках Hadoop-платформ: Hive, Spark и HDFS. Акцент сделан на логике выбора ключей, настройке параметров, интеграции в конвейеры ingestion и управлении операционной моделью.
Эти механизмы выступают не только как средства организации данных, но и как средства управления масштабируемостью и эффективностью запросов. Правильная стратегия partitioning, bucketing и clustering позволяет значительно снизить IO, ускорить фильтрацию и джоины, повысить предсказуемость латентности и уменьшить стоимость хранения за счет более эффективной компрессии и локализации данных.
- Понимание концепций partitioning, bucketing и clustering и их различий
- Выбор стратегий для заданной предметной области и рабочих нагрузок
- Реализация на практике в Hive, Spark и HDFS с учетом миграций и эксплуатации
- Метрики эффективности, мониторинг и подходы к оптимизации
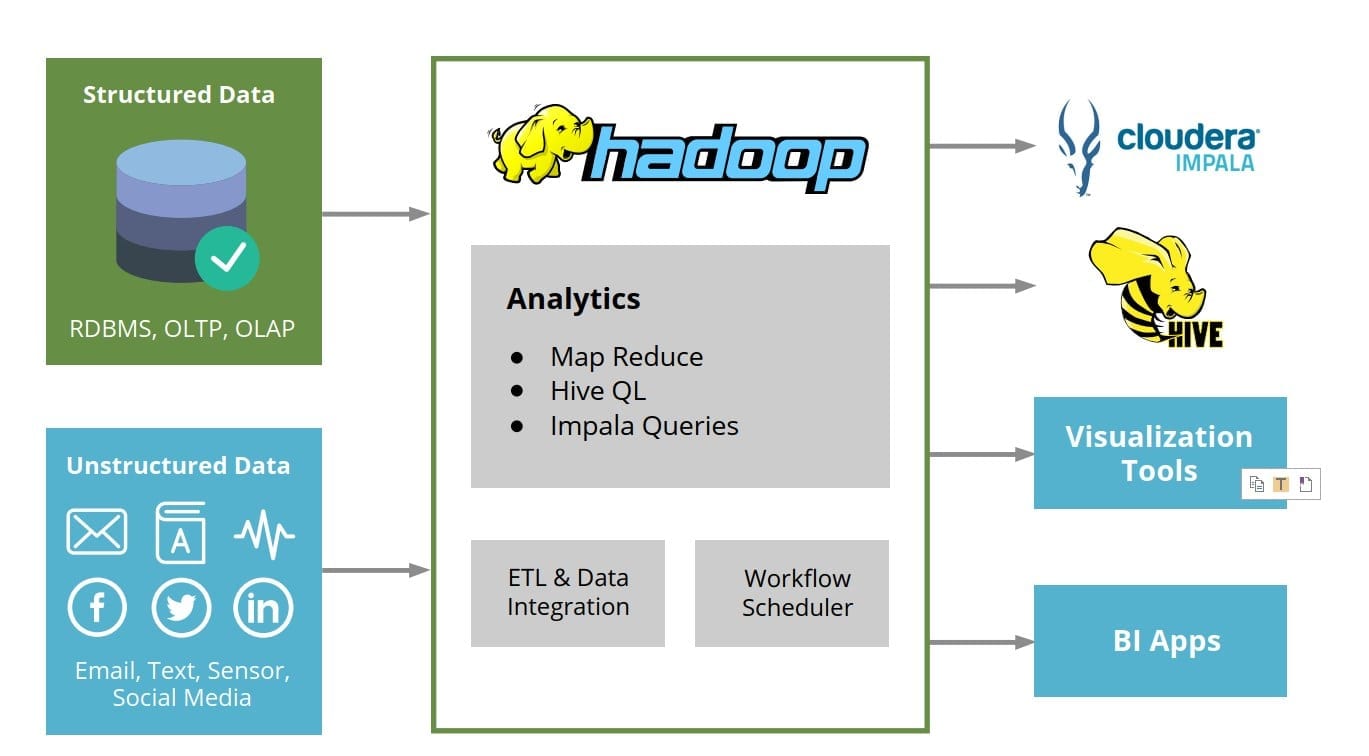
Концепции partitioning, bucketing и clustering
Partitioning разделяет данные на независимые сегменты на уровне файловой системы, основываясь на значении одного или нескольких ключей. Каждого партиционированного значения соответствует отдельная директория в HDFS, что позволяет проектировать запросы так, чтобы они читали лишь нужные участки данных. Bucketing разрезает данные по хешу некоторого столбца или набора столбцов на фиксированное число bucket’ов, что позволяет упорядочивать выполнение джоинов и агрегаций за счет локализации данных в рамкахbucket. Clustering - в контексте Hadoop чаще всего трактуется как дополнительная сортировка внутри bucket’ов или partition’ов, а также как упорядочивание данных по нескольким столбцам для ускоренной фильтрации и сжатия.
Эффекты на производительность заметны по нескольким направлениям:
- Пропуск ненужных участков данных благодаря фильтру partitioning (partition pruning) и bucket pruning.
- Снижение сложности джоин-плана за счет локальности данных внутри bucket’ов.
- Улучшение компрессии и скорости сканирования за счет сортировки внутри сегментов.
- Уменьшение числа файлов и управляемость метаданными, если partitioning и bucketing продуманны.
Однако несбалансированная стратегия несет риски: слишком мелкие partitions приводят к перегрузке metastore и управлению большим количеством директорий; слишком крупные partition’ы снижают эффективность pruning и приводят к чрезмерному IO. Аналогично bucketing требует устойчивого количества bucket’ов и согласованности между источниками данных, иначе преимуществ может не быть.
- Partitioning обеспечивает грубую, но эффективную фильтрацию на уровне файловой системы и метаданных.
- Bucketing обеспечивает тонкую деталь фильтрации в рамках обработанных сегментов и часто улучшает планирование джоинов.
- Clustering улучшает локальную сортировку внутри сегментов, что повышает эффективность сквозной аналитики и компрессии.
-- Пример DDL в Hive для partitioning
CREATE TABLE sales_partitioned (
  id BIGINT,
  amount DECIMAL(12,2),
  region STRING
)
PARTITIONED BY (dt STRING)
STORED AS PARQUET;

-- Вставка с динамическим созданием партиций
## SET hive.exec.dynamic.partition=true;
## SET hive.exec.dynamic.partition.mode=nonstrict;
INSERT INTO TABLE sales_partitioned PARTITION (dt)
SELECT id, amount, region, date_format(order_date, 'yyyy-MM-dd') AS dt
FROM raw_sales;
-- Пример DDL в Hive для bucketing
CREATE TABLE user_events_bucketed (
  user_id BIGINT,
  event STRING
)
CLUSTERED BY (user_id) INTO 32 BUCKETS
STORED AS ORC;
-- Пример Spark-подхода к bucketing и сортировке (псевдокод, демонстрирующий идею)
df.write
  .format("parquet")
  .bucketBy(32, "user_id")
  .sortBy("timestamp")
  .saveAsTable("events_bucketed");
Partitioning: стратегия ключей, границы и развязка
Выбор ключей partitioning определяется характером запросов и степенью кардинальности данных. Хорошо спроектированные partition’ы должны удовлетворять трем критериям: высокая кардинальность, умеренная размерность (чтобы число partitions оставалось управляемым), и совпадание с реальными сценариями отбора данных.
- Выбор ключей: часто применяют временные признаки (дата/время) и dimension’ы бизнес-домена (регион, продукт, канал). В больших датасетах по умолчанию предпочтение отдается временным разделам (например, dt в формате год-месяц-день), что обеспечивает плотную фильтрацию по времени и естественную главную "линию" конвейера ingestion.
- Границы partition: частота обновления partition должна соответствовать требованиям SLA по задержке данных. Частые новые партиции улучшают точность pruning, однако увеличивают число метаданных и сложность планирования.
- Управление скалируемостью: минимизация overhead в метадат-сервисах и файловой системе. В идеале partitions должны содержать хотя бы несколько сотен мегабайт, но не меньше нескольких десятков мегабайт и не больше нескольких гигабайт, чтобы не перегружать обработку.
- Архитектура и операции: поддержка dynamic partitioning, принципы восстановления после сбоя, и автоматизация добавления новых partition’ов.
Стратегия partitioning должна опираться на реальные запросы и сценарии потребления данных. Часто оптимальное решение - многоуровневый подход: основная партиция по дате, глубже по региону или по каналу продаж. Это позволяет отфильтровать большую часть данных на ранних этапах обработки.
- Эффект на запросы: запросы, ограниченные по времени или по региону, читают только соответствующий набор partition. Это резко сокращает время сканирования и IO.
- Эффект на ingestion: прогнозированная схема загрузки данных в новые partition’ы обеспечивает упорядоченность конвейера и консистентность схемы.
- Эффект на администрирование: автоматизированные задачи по созданию и удалению partition’ов, а также валидierung schemas.
-- Пример настройки динамических partition в Hive
## SET hive.exec.dynamic.partition=true;
SET hive.exec.dynamic.partition.mode=nonstrict;

CREATE TABLE daily_events (
  event_id BIGINT,
  value DOUBLE,
  device STRING
)
PARTITIONED BY (dt STRING)
STORED AS PARQUET;
-- Пример SQL-проекта по выборке с использованием partition pruning
## SELECT SUM(value) FROM daily_events
WHERE dt BETWEEN '2026-01-01' AND '2026-01-31'
AND device = 'mobile';
Рыцарь паттернов partitioning:
- При проектировании партиций следует учитывать бизнес-домены и регулярность загрузки. Частые обновления partition’ов в режиме реального времени требуют хорошо отлаженного конвейераингестион и автоматизированного удаления устаревших партиций.
- Для больших систем целесообразно использовать многоуровневые partition’ы, например, dt и region, чтобы обеспечить точечную фильтрацию по двум критериям.
Bucketing: проектирование и сценарии использования
Bucketing служит балансом между гибкой фильтрацией и управляемостью. Он особенно эффективен при выполнении джоинов на больших наборах данных и когда известно, что джойн-ключи будут редко изменяться. В отличие от partitioning, bucketing не требует сотен тысяч директории, а распределяет данные по фиксированному числу bucket’ов на уровне файловой системы.
-
Преимущества:
- Ускорение джоинов между двумя большими таблицами, которые будут иметь одинаковое число bucket’ов по ключу джоина.
- Возможность map-side джоинов без полной shuffle-перепрохводки при условии соблюдения bucket-совместимости.
- Улучшенная локализация чтения и компрессия за счет определенной структуры файлов.
-
Ограничения и риски:
- Неэффективен при сильной SKew-распределенности значений bucket-ключей.
- Требует согласованности числа bucket’ов между источниками данных и схемами экспорта.
- Потребность в реорганизации bucket’ов при изменении схемы или ключевых столбцов.
-
Практические рекомендации:
- Выбор числа bucket’ов: часто от 16 до 256, в зависимости от объема данных и сложности джоинов.
- Совмещение bucket’ирования с partitioning для максимального эффекта: bucketBy на столбец, который часто участвует в джоин-партнере, и partition по дате.
- Сортировка внутри bucket’ов (SORTED BY) дополняет эффект, особенно при диапазонных запросах по сортируемым столбцам.
-- Hive: bucketing и сортировка
CREATE TABLE events_bucketed (
  user_id BIGINT,
  event STRING,
  timestamp TIMESTAMP
)
CLUSTERED BY (user_id) INTO 64 BUCKETS
SORTED BY (timestamp) ASC
STORED AS ORC;
-- Spark-подход к bucketing и дальнейшему чтению
df.write
  .format("parquet")
  .bucketBy(64, "user_id")
  .sortBy("timestamp")
  .saveAsTable("events_bucketed_sparks");
-
Взаимодействие bucketing и partitioning:
- Partitioning задает гранулярность чтения на уровне файлов, bucketing - организацию внутри файлов.
- Запросы, фильтрующие по partition column и join’ы на bucket-ключ, получают наилучшую оптимизацию выполнения.
Clustering: сортировка и хранение данных
Clustering в Hadoop чаще всего реализуется как расширение bucket’инга сортировкой внутри bucket’ов или partition’ов. Это позволяет организовать физическую последовательность записей по нескольким столбцам и поддерживать эффективную фильтрацию по диапазонам. Правильная сортировка приносит следующие преимущества:
-
Повышение эффективности сканирования для диапазонных запросов (например, по датам и региону) благодаря упорядоченному расположению.
-
Улучшенная компрессия за счет предсказуемого распределения значений в векторе повторяющихся ключей.
-
Более эффективные сжатия Parquet/ORC, поскольку кодеки работают лучше на предсказуемых последовательностях.
-
Практические принципы:
- Совмещение сортировки с bucketing для локализации агрегатов и джоин-предикатов.
- Использование SORTED BY внутри bucket’ов, особенно когда бизнес-логика включает диапазонные фильтры.
- Встроенная поддержка сортировки в некоторых форматах хранения (ORC, Parquet) усиливает эффект через стратегию компрессии.
-- Hive: сортировка и кластеризация внутри bucket’ов
CREATE TABLE sales_clustered (
  sale_id BIGINT,
  amount DECIMAL(12,2),
  region STRING,
  sale_date DATE
)
CLUSTERED BY (region) INTO 128 BUCKETS
SORTED BY (sale_date) ASC
STORED AS PARQUET;
-- Spark: сортировка внутри партиций
df.write
  .partitionBy("region")
  .sortBy("sale_date")
  .parquet("hdfs:///data/sales_clustered")
-
Архитектурная роль clustering:
- Ускоряет выполнение диапазонных фильтров и ранжированных запросов.
- Поддерживает эффективную компрессию, особенно в случаях долгоживущих рабочих нагрузок.
- Требует дисциплины в операциях ETL, чтобы поддерживать порядок данных при повторной загрузке и обновлениях.
Реализация в экосистеме Hadoop: Hive, Spark, HDFS и сценарии миграции
Эффективная реализация требует тесной интеграции между слоями ingestion, хранения и обработки. Hive предоставляет богатый набор возможностей partitioning, bucketing и clustering через DDL, Parquet/ORC и метаданные в Metastore. Spark обеспечивает гибкую обработку на уровне DataFrame и DataSet, а также интеграцию с Hive-метаданными и возможностями Bucketing/SORT внутри задач. HDFS выступает как физический уровень хранения, где распределение файлов и директорий соответствует выбранной стратегии.
- Ингестион: при загрузке данных в Hadoop-кусты, partitioning следует использовать на этапе стейджинга. В идеале данные попадают в целевые partition’ы сразу, чтобы минимизировать переработку и переразброс.
- Метаданные и управление: для partition’ов необходима чистая и можно поддерживаемая структура метаданных в Hive Metastore. Управление количеством partition’ов локализует нагрузку на metastore и ускоряет планирование запросов.
- Мониторинг и правки: эксплуатация bucketing и clustering требует мониторинга распределения bucket’ов, кардинальности ключей, а также отслеживания skew’а. При росте объема данных может потребоваться переработка bucket’ов или пересортировка.
- Миграционные сценарии: переход от неразделяемых данных к partitioned и bucketed требует поэтапной миграции, включающей: (1) создание целевых структур, (2) дублирование данных в новый формат, (3) максимально возможно отключение старых путей чтения, (4) плановые задачи по сверке данных.
Рекомендуемые практики и подходы:
- Всегда начинать с анализом рабочих нагрузок: какие фильтры и какие джоины чаще встречаются; какие диапазоны чаще используются.
- Комбинировать partitioning, bucketing и clustering, сохраняя баланс между количеством файлов, метаданными и эффективностью выполнения.
- Использовать совместимую версию форматов хранения (Parquet/ORC) с поддержкой статики и компрессии.
- Внедрять автоматизацию управления partition’ами: создание, удаление устаревших partition’ов, мониторинг фрагментации.
- При миграциях осуществлять постепенный переход, избегая полной миграции без параллельной поддержки старого конвейера.
Примеры интеграции с реальными инструментами:
-
Hive + Parquet/ORC: стандартная связка для реализации partitioning и bucketing, с мощной поддержкой динамических partition’ов и гибких схем.
-
Spark SQL: обеспечивает богатый API для конвейеров, включая операции partitionBy, bucketBy и sortBy через интеграцию с Hive-метаданными и файловыми форматами.
-- Пример миграционного конвейера
-- 1) Создать целевые partition’ы по dt
## SET hive.exec.dynamic.partition=true;
SET hive.exec.dynamic.partition.mode=nonstrict;

-- 2) Переместить данные в новые структуры
INSERT INTO TABLE sales_partitioned PARTITION (dt)
SELECT id, amount, region, date_format(order_date, 'yyyy-MM-dd') AS dt
FROM raw_sales;

-- 3) Архивировать устаревшие данные (постепенная деактивация старого конвейера)
-- 4) Контроль целостности и сверка между источниками и целевыми структурами
-- Пример мониторинга планов в Hive/Spark
## EXPLAIN SELECT SUM(amount) FROM sales_partitioned
WHERE dt BETWEEN '2026-01-01' AND '2026-01-31'
AND region = 'EU';
Практические паттерны и производительность
-
Паттерн 1: дата-центрированная_partitioning с regional-детализацией - хорошо работает для аналитических запросов по времени и региону.
-
Паттерн 2: комбинированный partitioning и bucketing** - лучший выбор для больших джойнов по ключам и частых агрегаций.
-
Паттерн 3: кластеризация и сортировка внутри bucket’ов - эффективна для диапазонных запросов и сложных операций агрегации, но требует грамотного поддержания порядка в ETL.
-
Паттерн 4: компрессия и столбцатая оптимизация** - сортировка внутри bucket’ов улучшает компрессию, что особенно полезно при больших объемах данных.
Ключевые аспекты производительности:
- Планирование запросов и анализ EXPLAIN показывают, какие части данных будут прочитаны. Эффект partition pruning и bucket pruning становится очевидным при правильной фильтрации.
- Мониторинг кардинальности и skew’а: сильный skew в bucket’ах может обернуть преимущества в пустые улучшения. В таких случаях следует перераспределять bucket’ы или изменять стратегию.
- Управление размером partition’ов: слишком мелкие partition’ы приводят к избыточной метаданной нагрузке; слишком крупные - к снижению эффективности фильтрации.
- Совместимость форматов хранения: Parquet и ORC обеспечивают эффективную компрессию и схемы схемной эволюции, что усиливает эффекты clustering и bucketing.
Key takeaways
- Partitioning, bucketing и clustering - три взаимодополняющих механизма организации данных в Hadoop, которые совместно повышают производительность ETL и аналитики.
- Правильный выбор partition keys обеспечивает pruning на уровне файловой системы и значительную экономию IO.
- Bucketing ускоряет джоины и агрегации за счет распределения данных по фиксированному числу bucket’ов и поддержки совместимости ключей джоина.
- Clustering (сортировка внутри bucket’ов/partition’ов) улучшает диапазонные запросы, компрессию и планирование выполнения.
- Реализация требует анализа рабочих нагрузок, грамотного проектирования схем и автоматизации миграций, а также внимания к мониторингу и поддержке метаданных.
- Интеграция с Hive и Spark обеспечивает гибкость внедрения и масштабирования, а HDFS служит устойчивым физическим слоем хранения.
- При миграции на partitioning/bucketing следует планировать этапы перехода, минимизировать риск потери данных и обеспечить совместимость новой и старой архитектуры.
FAQ
- Что главное различие между partitioning и bucketing?
Partitioning делит данные по значению ключа на уровень файловой системы, создавая отдельные директории и METADATA на уровне Partitions. Bucketing же распределяет данные внутри файлов по хешу ключа на фиксированное число bucket’ов, что оптимизирует локальное распределение и джоины между таблицами с одинаковым числом bucket’ов. Partitioning ориентирован на фильтрацию по диапазонам и высокого уровня параллелизма, bucketing - на эффективные джоины и локальную агрегацию внутри bucket’ов.
- Как выбрать ключ partitioning?
Ключ partitioning должен соответствовать типовым фильтрам запросов, иметь разумную кардинальность и присутствовать в рабочих конвейерах. Часто применяют временные признаки (dt) и dimension-поля (region, channel). Важно избегать слишком большого числа_partition’ов и обеспечивать равномерность распределения значений по ним.
- Какие риски связаны с bucketing и как их минимизировать?
Основной риск - skew значений bucket’а. При дисбалансе часть bucket’ов может обрабатывать disproportionate объем данных, что снижает эффективность. Чтобы минимизировать риски, подбирайте число bucket’ов, учитывая объем данных, частоту обновления и характер джоинов; поддерживайте совместимость bucket’ов между источниками; комбинируйте bucketing с partitioning.
- В каких случаях clustering особенно полезен?
Clustering полезен для диапазонных запросов, сортировки по ключам, улучшения компрессии и ускорения сканирования в рамках bucket’ов/partition’ов. Особенно ощутим эффект при больших объемах и частых диапазонных фильтрах (например, по дате и региону).
- Какие форматы хранения рекомендуются с partitioning/bucketing?
Parquet и ORC - рекомендуемые форматы, поскольку поддерживают эффективную компрессию и схематическую эволюцию. Они хорошо сочетаются с Hive/Spark и поддерживают секционирование и сортировку внутри файлов.
- Как мониторить эффективность partitioning и bucketing?
Используйте планы запросов (EXPLAIN), метрики сканирования и IO, анализ распределения данных по partition’ам и bucket’ам, а также показатели времени выполнения джоинов. Регулярно пересматривайте стратегии в ответ на рост данных и изменение рабочих нагрузок.
- Как мигрировать существующие данные к partitioning и bucketing без простоев?
Планируйте поэтапную миграцию: создайте целевые структуры, дублируйте данные в новую схему, временно поддерживайте оба пути чтения, постепенно отключайте старый конвейер и валидируйте целостность. Важно автоматизировать создание partition’ов и bucket’ов, чтобы минимизировать ручной труд.
- Какие ограничения у кластеризации по ключам внутри Hadoop?
Ключи должны быть стабильными и хорошо распределенными. Изменение ключевых столбцов после загрузки данных может потребовать перераспределения bucket’ов и повторной сортировки. Также необходимы корректные настройки и совместимость форматов хранения.
- Можно ли сочетать partitioning, bucketing и clustering в Spark и Hive?
Да. Совместное применение дает наибольший эффект: partitioning обеспечивает фильтрацию на уровне данных, bucketing ускоряет джоины и агрегации, clustering усиливает локальную сортировку данных и компрессию. Важно синхронизировать параметры (число bucket’ов, схему partition’ов) между источниками и пайплайнами обработки.
- Как выбрать стратегию для конкретного проекта?
Начните с анализа рабочих нагрузок и типичных сценариев запросов. Опирайтесь на кардинальность и размер данных. Протестируйте различные конфигурации (например, несколько вариантов bucket’ов и несколько уровней partition’ов) в контрольной среде, измеряя время выполнения ключевых сценариев и стоимость хранения. Опирайтесь на методику постепенного внедрения и мониторинга реального эффекта на продакшн-конвейеры.


