

Форматы хранения и компрессия: Parquet, ORC, Snappy/Zstd, настройки
В рамках ETL-процессов в Hadoop выбор формата хранения и типа компрессии играет ключевую роль для производительности загрузки, пропускной способности обработки и общей себестоимости хранения. Цель главы - системно рассмотреть архитектурные принципы парадигм Parquet и ORC, сравнить их характеристики и правила выбора, разобрать компрессию Snappy и Zstd в контексте колоннарного формата, а также привести практические настройки для эффективной интеграции в Hadoop-экосистему (Hive, Spark, Presto/Trino).
Краткое введение
Современная архитектура ETL-процессов подразумевает два взаимосвязанных аспекта: хранение данных и их обработку. Форматы Parquet и ORC являются ведущими выборками для хранения колонных структур на HDFS и облачных файловых системах. Они поддерживают эффективную выборку колонок, статистику по столбцам, фильтрацию на уровне метаданных и частичную декодировку данных, что существенно ускоряет аналитические запросы и снижает сетевой трафик между узлами. Компрессия же дополняет эти свойства, уменьшая размер файлов и ускоряя чтение за счет снижения объема передаваемых данных. Однако компрессия влияет на CPU-накладные и задержку декомпрессии, поэтому архитектура решений должна учитывать характер рабочих нагрузок и профиль обработки.
Краткое содержание главы
- Архитектура форматов Parquet и ORC: структура файлов, метаданные, стратегии организации данных и их влияние на predicate pushdown и колоночную выборку.
- Детали Parquet: row groups, column chunks, кодирование и страничная компрессия, параметры оптимизации чтения и записи.
- Детали ORC: stripes, индексы и статистика, оптимизации чтения и компрессии, поддержка структур и типов.
- Компрессия Snappy и Zstd: компромиссы между скоростью и степенью сжатия, влияние на CPU и IO, рекомендации по выбору алгоритма.
- Настройки хранения и интеграции в Hadoop-пайплайны: параметры Parquet/ORC, взаимодействие с Hive/Spark/Presto, стратегия partitioning и схем evolution.
- Практические руководства по принятию решений и миграциям: примеры типовых сценариев и способы перехода между форматами.
- Обобщение и рекомендации по проектированию устойчивых ETL-процессов.
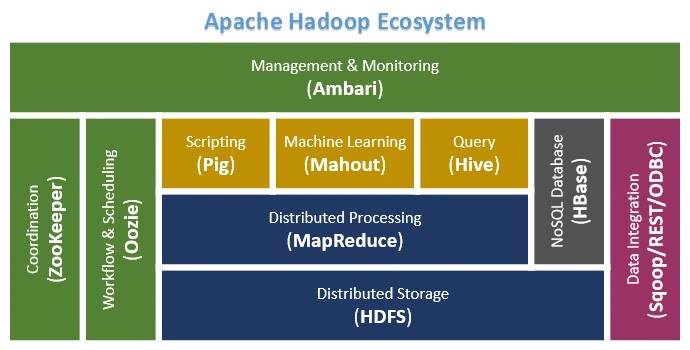
Архитектура и принципы работы форматов
Parquet и ORC реализуют столбцовый подход к сохранению данных внутри файлов. Это приносит выгоды в виде высокой эффективности для аналитических запросов, поскольку операции выбирают только необходимые столбцы, уменьшая объем считываемых данных. В обоих форматах встроена поддержка статистики по столбцам и схемам, что позволяет системам выполнять позднее predicate pushdown и ранжировать наборы данных до фактического чтения страниц.
Parquet строится вокруг концепции row groups и column chunks. Каждый файл делится на ряд групп строк, внутри которых данные организованы по столбцам (колонны). Это позволяет эффективно применять компрессию на уровне колонок и минимизировать чтение неиспользуемых столбцов. Метаданные о структуре данных хранится в футере файла, что упрощает навигацию при считывании.
ORC использует иной подход - stripes. Данные разделены на полосы, внутри которых также присутствуют индексы и статистика по каждому столбцу. Такой дизайн обеспечивает очень быстрый доступ к частям данных и эффективную фильтрацию на уровне метаданных. В ORC присутствуют дополнительные слои индексов и статистических данных, что повышает точность и скорость предикатной фильтрации, а также облегчает оптимизацию объединения данных.
Сравнение двух форматов здесь не сводится к одному «лучше/хуже»: выбор зависит от характера нагрузки, совместимости инструментов и требований к партитонированию. Parquet часто предпочтителен в экосистемах, где доминируют Spark и Hive, в то время как ORC может принести преимущества в средах, где критично глубокое использование индексов и фильтрации по статистике. В любом случае оба формата поддерживают схему эволюции, хотя способы управления схемой и совместимостью требуют аккуратной конфигурации и тестирования.
Структура и метаданные
- Parquet: футер файла содержит метаданные схемы, статистику по столбцам и ссылки на row groups. Эффективно сочетается с predicate pushdown, особенно при работе с большими набором столбцов и больших объемов данных.
- ORC: stripes вместе с индексами и иерархией статистик предоставляют богатый набор оптимизаций. Метаданные подстраиваются под столбцы, а встроенные индексы ускоряют точечные запросы.
Эволюция схемы и совместимость
Оба формата поддерживают эволюцию схемы, однако она требует четко проработанной стратегии обновления таблиц в зарегистрированных структурах (Hive Metastore, Glue Data Catalog и т. п.). В рамках ETL-процессов критически важно проектировать схемы таким образом, чтобы изменение типа данных и добавление столбцов не приводило к поломкам существующих пайплайнов и совместимости с предыдущими версиями моделей.
Parquet: архитектура, кодирование и параметры
Parquet - один из самых распространённых форматов хранения в Hadoop. Основная идея - максимально эффективная запись данных по столбцам с поддержкой сжатия и фильтрации.
Структура файла Parquet
Файл Parquet состоит из серий структур: файл начинается с магического слова, затем следует серия row groups, а в конце - футер с метаданными. В каждом row group хранится несколько столбцов, каждый столбец представлен наборами страниц с данными. Такой подход позволяет отделить данные и метаданные на уровне чтения, что упрощает чтение нужных столбцов без полной загрузки всего файла.
Кодирование столбцов и страничная компрессия
Каждый столбец может использовать Dictionary Encoding для повторяющихся значений и RLE/bit-packed кодирование для числовых данных. Это делает Parquet особенно эффективным при наличии повторяемых значений и низкой энтропии данных в отдельных столбцах.
Уровень страниц задаёт granularity чтения: размер страницы влияет на количество операций ввода-вывода и на баланс между компрессией и задержками чтения. Типичные значения страницы лежат в диапазоне нескольких килобайт, с возможностью настройки под конкретную рабочую нагрузку.
Компрессия и параметры оптимизации
Компрессия в Parquet применяется на уровне страниц или колонок. Алгоритм выбирается на уровне файла или конфигурации и может включать Snappy, GZIP, LZO и другие варианты в зависимости от реализации. Основной принцип: компрессия снижает размер файлов и сетевой трафик, но требует дополнительных CPU-ресурсов на декомпрессию. При длинных рабочих нагрузках, связанных с IO-bound операциями, предпочтение часто отдают Snappy как баланс между скоростью и степенью сжатия.
-
Простой набор параметров:
- parquet.block.size: задаёт размер блока/row group в байтах. Оптимальные значения часто лежат в диапазоне 128-256 МБ, но зависят от нагрузки и размера выборок.
- parquet.page.size: размер страницы, чаще на уровне 1-16 КБ.
- parquet.dictionary: включение словаря для столбцов с повторяющимися значениями.
- parquet.compression: глобальная политика компрессии, например SNAPPY, GZIP, ZSTD в зависимости от версии.
## Пример для Spark (PySpark)
df.write
  .option("compression","snappy")
  .parquet("hdfs://cluster/user/etl/parquet_events")
Практические рекомендации по Parquet
-
Настройка row group размера имеет критическое значение для скорости чтения: слишком маленькие группы приводят к большему числу операций чтения, слишком крупные - к снижению эффективности кэширования и индивидуального доступа к столбцам.
-
Смешанная нагрузка: если запросы часто касаются только части столбцов, Parquet будет особенно выгоден из-за эффективной колоночной выборки.
-
Взаимодействие с Spark и Hive: указание и поддержка свойств компрессии и размера страниц стоит в конфигурациях с учётом особенностей движков. В Spark включение векторного чтения может дополнительно усилить преимущества Parquet.
ORC: архитектура и особенности
ORC ориентирован на ещё более глубокую оптимизацию чтения и записи в рамках колоннарной структуры. Он широко применяется в экосистемах, где нужна продвинутая статистика столбцов и индексы.
Структура файла ORC
ORC разбивает файл на stripes, внутри каждого stripe хранится разделяемый набор столбцов. Значительная часть метаданных находится в заголовках и индексах stripes, что ускоряет поиск и фильтрацию. Орк поддерживает встроенные статистики по каждому столбцу, что особенно полезно для раннего отбора данных.
Метаданные, статистика и индексы
Статистика по столбцам позволяет ранней фильтрации и predicate pushdown, снижая объем операций чтения. Индексы и биомаски обеспечивают быстрый доступ к нужным диапазонам значений, что особенно ценно в больших полях с высоким разнообразием. В Oracle-современных реализациях ORC поддерживает Zstd и Snappy как варианты компрессии, что позволяет адаптировать баланс между скоростью и размером данных.
Сжатие и конфигурационные параметры
- orc.compress: управление типом компрессии (NONE, SNAPPY, ZLIB, ZSTD в современных реализациях).
- orc.stripe.size: размер stripe, который влияет на компрессию, параллелизм чтения и время начала обработки. Оптимальный размер stripe находится в диапазоне 64-256 МБ в зависимости от нагрузки и размера таблицы.
- Дополнительные параметры: orc.batch.size, orc.lazy" и другие зависят от конкретной реализации и движков.
Взаимодействие с движками и инфраструктурой
ORC традиционно хорошо работает в средах Hadoop с Hive и Spark, где статистика и индексы позволяют существенно снизить объем данных для чтения. В Presto/Trino ORC часто выступает как основное хранилище благодаря эффективному считыванию и поддержке сложных типов.
Рекомендации по выбору ORC
- Если критична фильтрация по столбцам и высокая точность статистик, ORC может быть более продуктивен.
- При необходимости поддержки электронной совместимости между несколькими инструментами, Parquet может быть более универсальным выбором.
- Важно тестировать конкретные сценарии под нагрузкой: точность фильтрации, скорость чтения и общий TCO (total cost of ownership).
Сжатие Snappy и Zstd: компромиссы и оптимизация
Snappy и Zstd представляют собой две наиболее часто применяемые технологии компрессии в современных форматах хранения. Их выбор существенно влияет на производительность ETL-пайплайнов и экономику хранения.
Snappy: скорость выше, компрессия умеренная
- Преимущества: очень быстрая декомпрессия и низкая задержка при чтении данных; меньшая нагрузка на CPU по сравнению с более тяжёлыми методами компрессии.
- Ограничения: размер итогового файла может быть больше по сравнению с Zstd при тех же данных, особенно для больших вариантов переменных столбцов.
Zstd: баланс между скоростью и степенью сжатия
- Преимущества: значительно лучшее сжатие для типичных наборов данных по сравнению со Snappy; поддерживает множество режимов компрессии, позволяя настраивать максимальную производительность.
- Ограничения: более высокая вычислительная стоимость по сравнению со Snappy, особенно в режимах максимального сжатия; в некоторых реализациях потребление CPU может быть выше.
Практическое применение в формате Parquet/ORC
- Для HDD/SSD клонов с большим объемом данных и частой повторной аналитикой чаще выбирают Zstd, чтобы сократить общий объем хранения и сетевой трафик.
- Для сценариев с задержками, критичных к моментальному чтению, предпочтение отдаётся Snappy из-за его быстрой декомпрессии.
Рекомендации по применению
- Оценка рабочей нагрузки: если запросы тянут большой объем данных через сетевой канал, Zstd может дать лучшие показатели.
- Баланс CPU и IO: для ограничений по CPU Snappy может быть предпочтительнее.
- Тестирование на реальных данных: важно проверить влияние компрессии на конкретные наборы данных и типы запросов.
Настройки хранения и интеграции в Hadoop-пайплайны
Потоки ingestion и обработка данных требуют единообразного управления настройками форматов и компрессии на уровне таблиц и рабочих сред. Правильная настройка обеспечивает совместимость между Hive, Spark и Presto/Trino и позволяет эффективно использовать разделение данных (partitioning).
Настройки Parquet
-
parquet.block.size: размер row group, обычно 128-256 МБ, зависит от характера данных и нагрузки.
-
parquet.page.size: размер страниц, типично 1-16 КБ.
-
parquet.enable.dictionary: включение словаря для подходящих столбцов.
-
parquet.compression: общий режим компрессии; может принимать значения SNAPPY, GZIP, ZSTD в зависимости от версии.
-
В контексте Spark/Hive дополнительно применяются свойства движка: spark.sql.parquet.compression - для Spark, hive.exec.orc.default.compress - для ORC в некоторых конфигурациях.
-- Пример Hive/Impala
CREATE EXTERNAL TABLE events_parquet (
  event_time TIMESTAMP,
  user_id STRING,
  action STRING
)
## STORED AS PARQUET
## LOCATION 'hdfs://cluster/data/events_parquet';
ALTER TABLE events_parquet SET TBLPROPERTIES ('parquet.compress'='SNAPPY');
Настройки ORC
-
orc.compress: выбор типа компрессии (NONE, SNAPPY, ZLIB, ZSTD).
-
orc.stripe.size: размер Stripe** - влияет на параллелизм и скорость чтения.
-
orc.batch.size: объем строк в пакете при чтении (bulk read).
-
Взаимодействие с движками: Spark, Hive и Presto обычно поддерживают эти параметры на уровне таблиц или сессии.
Интеграционные сценарии
- Partitioning: деление по временным меткам или другим признакам для повышения prune-полезности. В сочетании с Parquet/ORC это позволяет значительно уменьшать scanning.
- Стратегии миграции: при миграции с текстовых форматов на Parquet/ORC рекомендуется постепенно добавлять новые разделы в таблицы с новой схемой и поддерживать совместное чтение старых разделов.
- Schema evolution: внедрять версионирование схемы, регистрируя изменения и минимизируя совместимость с существующими пайплайнами. В Spark/Hive это достигается через аккуратную настройку SerDe и чтение с разных версий схем.
Практические кейсы по настройкам
- Для больших таблиц с частыми запросами на 1-2 колонки полезно использовать словарь для соответствующих типов данных и увеличить блок содержания row groups, чтобы повысить эффективность чтения.
- При использовании Zstd следует протестировать разные уровни сжатия, чтобы определить оптимальный компромисс между размером и временем декомпрессии.
Практические кейсы и миграции
Типичный кейс - миграция из текстовых форматов в Parquet или ORC для ускорения аналитических запросов и снижения затрат на хранение. Важно учитывать характер рабочих нагрузок, требование к совместимости инструментов и возможность поддержки схем.
- Кейсы миграции: текст→Parquet при сохранении существующих partitioning-логик; ORC для систем, где критична статистика по столбцам и индексы.
- Миграция типа компрессии: переход с Snappy на Zstd в рамках существующей инфраструктуры требует учета CPU-накладных и изменений в планах выполнения запросов.
- Инструменты миграции: использование Spark для переписывания данных в новый формат с сохранением метаданных и partitioning; обновление Hive Metastore и ы взаимодействия.
Key takeaways
- Выбор формата хранения влияет на скорость обработки и общую стоимость хранения: Parquet и ORC предоставляют отличную поддержку для колонной обработки и эффективную фильтрацию на уровне метаданных.
- Parquet - сильная сторона в большинстве сред Hadoop благодаря гибкости, поддержке коллекций и широко распространённой совместимости со Spark и Hive.
- ORC предоставляет расширенные возможности индексации и статистики, которые особенно полезны в workloads с агрессивной фильтрацией и сложной схемой.
- Компрессия Snappy и Zstd требует балансировки между скоростью выполнения и степенью сжатия; тестируйте на реальных рабочих наборах данных, чтобы выбрать оптимальный режим.
- Настройки row group/stripe размера, страницы и словарей существенно влияют на производительность чтения и записи; производите калибровку под конкретные задачи.
- Интеграционные практики - Partitioning, схема evolution и совместимость между Hive/Spark/Presto - критичны для устойчивости ETL-процессов.
FAQ
- Какие факторы влияют на выбор Parquet или ORC в конкретном проекте?
Parquet и ORC предлагают схожие базовые принципы колоночной организации, но различаются по метаданным и оптимизациям. Parquet часто более универсален и популярен в разных движках (Spark, Hive, Presto), тогда как ORC может предоставить дополнительные индексы и статистику, что полезно для сложной фильтрации. Выбор зависит от нагрузки, необходимой скорости чтения и совместимости инструментов, а также от того, какие оптимизации доступны в конкретной реализации.
- Как определить оптимальный размер row group в Parquet?
Оптимальный размер row group зависит от объема данных, характера запросов и типа рабочих нагрузок. Для аналитических запросов часто выбирают 128-256 МБ, поскольку это позволяет эффективно применить компрессию на уровне столбца и снизить число чтений. Но для очень больших файлов с узконаправленными запросами может быть целесообразно увеличить размер row group, чтобы уменьшить количество футеров и ускорить последовательное чтение.
- Что такое predicate pushdown и как форматы его поддерживают?
Predicate pushdown - это механизм раннего отбора данных на уровне чтения файла, чтобы считывать только те страницы/страйпы, которые удовлетворяют условиям запроса. Обе реализации - Parquet и ORC - поддерживают статистику столбцов и индексы, что позволяет системам быстро определить часть данных, которую нужно прочитать. Это существенно снижает IO и ускоряет обработку.
- В чем различие между Snappy и Zstd по эксплуатационному сценарию?
Snappy - быстрый алгоритм компрессии, оптимизированный для минимизации задержек чтения. Zstd обеспечивает лучшее сжатие по размеру, но может потребовать больше CPU-поддержки. Если важна скорость чтения и низкая задержка - чаще выбирают Snappy; если важна экономия пространства и суммарная экономия IO - Zstd может быть предпочтительнее.
- Какие параметры Parquet и ORC стоит обязательно проверить в кластере?
Обязательно стоит проверить параметры компрессии (parquet.compression, orc.compress), размер блоков/striПов (parquet.block.size, orc.stripe.size), включение словаря (parquet.enable.dictionary) и общие настройки чтения/записи движка, который вы используете (Spark, Hive, Presto). Также важно протестировать влияние на производительность с учётом вашей схемы и partitioning.
- Как schema evolution влияет на формат хранения?
И Parquet, и ORC поддерживают эволюцию схемы, но реализации и способы применения изменений варьируются. Рекомендовано проектировать схемы так, чтобы добавление новых столбцов не ломало существующие пайплайны; поддерживать регистры версий схемы и обеспечить совместимость через SerDe и зарегистрированные метаданные в Hive Metastore или аналогичном каталоге.
- Какие сценарии миграции наиболее безопасны?
Безопасная миграция обычно включает параллельную инференцию и чтение старой и новой таблиц, миграцию по partitioning и постепенный переход клиентов на новый формат. Рекомендуется проводить пилоты на поднаборе данных, чтобы проверить локальные задержки, пропускную способность и совместимость. Важно обеспечить синхронность схем и корректное обновление метаданных.
- Можно ли использовать разные форматы в одной аналитической системе?
Да, современные экосистемы позволяют работать с несколькими форматами в рамках единой инфраструктуры хранения. Например, часть таблиц может храниться в Parquet, другая - в ORC, в зависимости от конкретной нагрузки и потребностей. Основной задачей является согласование схем и единообразное окружение чтения в Spark/Hive/Presto.
- Какие риски связаны с использованием Zstd в Hadoop?
Главные риски - увеличение CPU-накладных при высокой интенсивности компрессии и декомпрессии, особенно если данные часто обновляются. В тестах следует проверить компрессии на реальных данных и убедиться, что инфраструктура поддерживает эффективную работу с Zstd в используемом стеке (версии Spark/Hive и т. д.).
- Как мониторить эффективность форматов и настроек?
Эффективность можно оценивать через показатели IO, пропускной способности, задержки выполнения запросов и общий размер хранения. Важно настройку тестировать на рабочих нагрузках и сравнивать с целями SLA. Включение статистики по столбцам и мониторинг планов выполнения поможет выявлять узкие места и корректировать параметры row group/stripe размера и компрессии.


