

Форматы данных и схемы: Parquet, ORC, Avro, текстовые форматы, компрессия
Форматы данных определяют как хранение, так и обработку больших объемов информации в аналитических конвейерах. В среде Hadoop и связанных платформах ключевую роль играют Parquet, ORC и Avro - каждый из форматов рассчитан на свои сценарии потребления: от высокопроизводительного сканирования в Spark SQL и Impala до эффективной эволюции схем и интеграции с Hive Metastore. Наряду с ними текстовые форматы (CSV, JSON/JSON Lines) часто применяются на входе в пайплайны, но требуют внимательного отношения к компрессии, партиционированию и схеме. В настоящем разделе рассмотрены архитектура форматов, механизмы кодирования и компрессии, практические особенности интеграции с Hive, Impala и Spark SQL, а также принципы выбора формата под конкретные нагрузки.
Краткое введение
-
В современных аналитических инфраструктурах компрессия и структура данных напрямую влияют на производительность запросов, задержки и стоимость владения. Простой выбор формата может привести к избыточному IO, плохому распилу столбцов и ограничению проектирования схем.
-
Понимание того, как Parquet, ORC и Avro кодируют данные, как реализуются схемы э Evolution и какие метаданные доступны, позволяет обосновать архитектурные решения и обойти узкие места в плоскости сквозной обработки в Hive, Impala и Spark SQL.
-
Архитектура и схемы: как устроены форматы, чем различаются хранение данных и их метаинформация.
-
Выбор и компрессия: какие кодеки применяются, как влияет компрессия на CPU и IO, как настраиваются параметры чтения.
-
Интеграции и сценарии внедрения: как форматы взаимодействуют с Hive Metastore, Spark и Impala, какие ограничения существуют при эволюции схем.
-
Практические рекомендации: когда использовать каждый формат, как сочетать форматы с процессами ETL, загрузки и аналитики.
Архитектура форматов и схемы
Форматы данных различаются по модели хранения и поддерживаемым типам схем. Parquet и ORC являются колоночными форматами, оптимизированными для сканирования больших таблиц: они организуют данные в гибридные структуры, где каждый столбец хранится независимо и может быть прочитан из нужной части файла без доступа к другим столбцам. Avro же ориентирован на строковую запись и удобную эволюцию схем, особенно полезен для потоковой обработки и передачи событий.
Ключевые концепции:
- Схема и эволюция схем: Parquet, ORC сохраняют схему и статистику в метаданных файлов (footer или Stripe-метаданные). Avro хранит схему вместе с данными. Эволюция схем поддерживается различными способами: добавление новых полей с дефолтными значениями, изменение типов в пределах ограничений совместимости. В аналитике это влияет на совместимость партий данных и стабильность пайплайнов.
- Компоновка и доступ: Parquet и ORC делят данные на row groups/stripes. Вырезка необходимых столбцов выполняется без чтения всего файла, что критично для производительности. Avro ориентирован на более гибкий доступ к строкам, но не обеспечивает столь же эффективное каскадное считывание столбцов.
- Типы данных и вложенные структуры: оба колоночных формата поддерживают сложные типы (struct, list, map), что важно для анализа полуструктурированных данных. В Avro вложенность поддерживается, но в плане столбцовых операций его эффективность ниже по умолчанию.
- Метаданные и статистика: колонки могут содержать статистику (min, max, null-count, частоты) на уровне столбцов и страниц. Это позволяет реализовывать predicate pushdown и индексирование на уровне чтения.
Почему это важно для исполнительной архитектуры
- Выбор формата влияет на скрипты ETL, схему хранения и дальнейшую обработку данными в Spark SQL, Hive и Impala. Колонарная обработка позволяет сильнее сжимать данные и ускорять сканирование, но требует продуманной эволюции схем и поддержки со стороны инструментов.
- Правильные схемы обеспечивают совместимость между компонентами и упрощают отказоустойчивые механизмы: например, возможность добавлять новые поля без переразбиения всего набора данных, или поддержка нулевых значений через опциональные поля.
Parquet: архитектура, кодирование и компрессия
Parquet - один из самых распространённых в аналитике форматов. Он реализует колонарную организацию файлов и эффективное сжатие за счёт кодирования на уровне столбцов и строгой структуры данных.
Структура Parquet:
- Row Group: базовая единица чтения и записи. Каждая Row Group содержит множество столбцов и представляет собой мини-век-файла внутри файла Parquet. Размер Row Group выбирается исходя из баланса между параллелизмом чтения и эффективностью кодирования.
- Column Chunk и Page: данные по каждому столбцу разбиты на Chunk, которые далее состоят из страниц (data pages, dictionary pages). Это позволяет выполнять точечное чтение необходимого столбца и ускорять доступ к данным.
- Encoding и Compression: каждый столбец может использовать отдельные кодировки и сжатие. Типичные кодировки: dictionary encoding для низкокардинальных столбцов, RLE/bit-packed for booleans, и Plain для остальных типов. Компрессия применяется на уровне столбцовых страниц: Snappy, GZIP и другие кодеки. В современных реализациях поддерживаются и более продвинутые компрессии, такие как Zstandard, что расширяет опции на баланс между скоростью распаковки и эффективностью сжатия.
Ключевые характеристики:
- Predicate pushdown: статистика по каждому столбцу (min, max, NULL_count) позволяет двигать фильтры к чтению данных, не загружая неинтересующие страницы. Это критично для больших наборов данных, когда фильтрация сокращает объем читаемой информации.
- Projection pushdown: чтение только тех столбцов, которые заданы в запросе, что существенно снижает IO.
- Поддержка сложных типов: Parquet позволяет хранить вложенные структуры (STRUCT, ARRAY, MAP) и сохранять их в эффективном столбцовом виде.
- Эволюция схем: добавление новых полей возможно с дефолтными значениями, старые данные читаются корректно, если совместимость обеспечена. Важно тестировать сценарии чтения старых файлов новыми потребителями.
Рекомендации по настройке:
- Размер Row Group: типично 128-256 килобайт на страницу в зависимости от данных; увеличение размера может повысить эффективность сканирования больших последовательностей данных, но снизить параллелизм.
- Выбор компрессии: Snappy обеспечивает хорошую скорость распаковки и общий баланс. Для архивирования больших архивов можно рассмотреть GZIP или Zstandard, если критично экономить место и не увеличивать задержки чтения.
- Конфигурации Spark: spark.sql.parquet.compression.codec задаёт используемый кодек; параметры parquet.block.size и parquet.page.size влияют на размер групп и страниц, соответственно, и должны подбираться под тип нагрузки.
import org.apache.spark.sql.SparkSession

val spark = SparkSession.builder()
  .appName("ParquetExample")
  .getOrCreate()

// Пример записи с настройкой размера блока и компрессии
val df = spark.read.json("hdfs:///data/events/*.json")
df.write
  .option("parquet.block.size", 128 * 1024 * 1024)
  .parquet("hdfs:///data/parquet/events")

// Пример чтения
val parquetDF = spark.read.parquet("hdfs:///data/parquet/events")
parquetDF.filter("event_type = 'click'").count()
Hive и Impala поддерживают Parquet на уровне внешних таблиц, что позволяет инкапсулировать оптимизированную схему и статистику, улучшая планировщики запросов. В Spark SQL параллелизация чтения по Row Group обеспечивает высокий уровень параллелизма. При этом следует помнить: на стороне Hive/Impala иногда требуется обновление статистик и повторная генерация метаданных после существенных изменений в наборе данных.
ORC: архитектура, особенности и компрессия
ORC (Optimized Row Columnar) - ещё один лидер среди колоночных форматов. Он отличается особенностями реализации и набором преимуществ, которые особенно заметны в диапазоне больших схваток и сложной схемы.
Структура ORC:
- Stripe-based layout: данные разбиты на полосы (stripes). Каждая полоса содержит таблицу столбцов и ориентирована на линейное чтение, что ускоряет последовательные проходы по данным.
- Columnar storage внутри полос: данные по каждому столбцу кодируются и сжимаются отдельно. Подобно Parquet, ORC поддерживает эффективное сжатие и быструю фильтрацию.
- Метаданные: ORC хранит статистику на уровне полос и столбцов, включая min/max и другие агрегаты, что позволяет движкам запросов быстрее отсеивать неинтересные участки данных.
Ключевые особенности:
- Разнообразие кодировок: ORC поддерживает Dictionary Encoding и другие формы кодирования, адаптивно подстраиваясь под характер данных. Это особенно полезно для столбцов с высокой повторяемостью.
- Bloom фильтры и индексы: ORC предоставляет встроенную поддержку Bloom фильтров по столбцам, что помогает отсеивать большие диапазоны данных до их физического чтения.
- Векторизованный чтение: для Spark и некоторых движков ImpalaHive обеспечивается векторизованный доступ, что значительно ускоряет обработку больших наборов данных.
- Эволюция схем: ORC поддерживает безопасную эволюцию схем и добавление полей. Как и Parquet, важно тестировать совместимость и корректность обработки старых файлов.
Рекомендации по настройке:
- Оптимизация полос: размер полос влияет на локальность чтения и кэширование. Балансируйте между количеством полос и размером записей, чтобы не перегружать метаданные и не снижать эффективность скана.
- Компрессия: Snappy остаётся популярным выбором за счёт скорости, а Zstandard может предоставить лучшие показатели компрессии при аналогичной скорости распаковки. В рамках ORC из-за особенностей реализации, LZ4 также может быть полезен в некоторых конфигурациях.
- Статистика и Bloom-фильтры: включение и настройка через параметры движка чтения позволяют ускорить планирование запросов и исключение не релевантных данных.
// Пример конфигурации ORC в Spark
val df = spark.read.orc("hdfs:///data/orc_sales")
df.createOrReplaceTempView("sales_orc")

// Чистая выборка с использованием фильтрации на уровне чтения
val res = spark.sql("SELECT SUM(amount) FROM sales_orc WHERE region = 'EU'")
res.show()
X Hive и Impala обычно хорошо поддерживают ORC, иногда с преимуществами в плане фильтрации на уровне структуры и поддержки индексов. Важное замечание: выбор между Parquet и ORC не всегда однозначен - зависит от конкретной нагрузки, формата данных и инструментов, которые используются в пайплайне.
Avro: схемы, эволюция, компрессия и влияние на потоковую обработку
Avro ориентирован на схему как первичную сущность данных и предоставляет эффективный механизм эволюции схем, особенно полезной в сценариях потоковой обработки и передачи событий. Avro хранит схему в интерфейсе записи, что облегчает обмен сообщениями между сервисами и системами, не требуя фазы "согласование" перед чтением.
Ключевые характеристики:
- Эволюция схем: Avro поддерживает совместимость (backward, forward, full) через механизмы дефолтных значений и возможности чтения без обработки полей, которых уже нет. Это критично для схем, которые меняются через версии микросервисов и обработчиков.
- Кодирование и эффективная сериализация: Avro использует бинарную сериализацию с эффективной упаковкой целочисленных значений (zigzag кодирование) и упрощённой компактной схемой для структур. Это позволяет быстро сериализовать события и доставлять их в потоковые системы.
- Компрессия: поддерживает Deflate, Snappy, Bzip2 и другие кодеки. В контексте потоковой передачи через Kafka или подобные системы это позволяет настраивать баланс между скоростью и размером сообщений.
- Интеграции: Avro тесно интегрирован в конвейеры Hadoop и стек Hadoop-владельца, часто выступает в роли формата сообщений или временных буферов. Однако для аналитического сканирования как основного источника данных Parquet/ORC чаще предпочтительнее архитектура с колонарными форматами из-за преимуществ в сканировании и сжатию.
Практические аспекты:
- В потоковых пайплайнах Avro часто выбирается как схема сообщения. При этом цель - минимизировать затраты на сериализацию/десериализацию, сохранив совместимость между производителями событий и потребителями данных.
- В аналитических пайплайнах Avro может служить промежуточной формой данных, предваряя Parquet или ORC на стадии хранения уже после обработки. Такой подход может быть полезен при интеграции широких потоков и пакетной обработки с различными требованиями к схемам.
Преимущества и ограничения:
- Преимущество Avro - простота эволюции схем и легкость интеграции с системами потоковой обработки; ограничение - меньше пригоден для прямого высокопроизводительного сканирования больших табличных наборов в рамках Spark SQL/Impala без конвертации в колоночный формат.
- В рамках экосистемы Hadoop Avro часто выступает как мост между потоками и пакетной аналитикой, но для чисто аналитических задач чаще применяется конвертация в Parquet или ORC.
Текстовые и полуструктурированные форматы
Текстовые форматы, такие как CSV и JSON/JSON Lines (NDJSON), широко применяются на входе в аналитические пайплайны и в конвейерах для передачи событий. Но они не обладают тем же уровнем структурирования и поддержки схем, как Parquet/ORC/Avro, что приводит к ряду компромиссов.
CSV:
- Простота и читаемость, отсутствие встроенной схемы сложных структур. Эффективное сохранение табличной информации, но требует явной согласованности схемы у потребителей.
- Ограничения: отсутствие поддержки вложенных структур без сложной обработки; зависимость от корректной обработки кавычек, экранирования и форматов чисел; сложности при переносе больших схематических изменений в старые наборы данных.
- В аналитике CSV чаще применяется как формат входной загрузки, который затем конвертируется в Parquet/ORC для сканирования.
JSON/JSON Lines:
- Гибкость для полуструктурированных данных. JSON Lines поддерживает последовательность независимых записей, что облегчает стриминг и запись в логах.
- Проблемы: вложенность, отсутствие эффективной поддержки столбцового сканирования без предварительной нормализации; высокая стоимость сериализации и распаковки, если данные имеют сложную вложенную схему.
- В Spark SQL и Hive JSON следует использовать осторожно: для больших наборов данных лучше применить конвертацию в Parquet/ORC или использовать в качестве входной формы и далее трансформировать.
Текстовые форматы полезны на входе в процессы ETL и интеграции систем, однако для аналитики и больших наборов данных они могут стать узким местом из-за потери возможностей колоночного сканирования. Часто рекомендуется хранить «финал» в Parquet/ORC и использовать текстовые форматы как интерфейс входа в пайплайн.
Итоговые принципы использования текстовых форматов:
- Используйте текстовые форматы для ingest-процессов и передачи событий, где важна гибкость и совместимость.
- Для аналитики переходите к колонарным форматам, чтобы обеспечить лучшую производительность запросов, предикат-пушдаун и эффективное сжатие.
- Включайте в пайплайн схемы преобразования данных: чтение CSV/JSON и конвертация в Parquet/ORC как часть стадии ETL или ELT.
Компрессия и баланс между форматом и производительностью
Компрессия играет важную роль в уменьшении объема хранения и снижении IO. В сочетании с форматом она влияет на общий пропускной режим аналитического конвейера. В Parquet, ORC и Avro применяются разные подходы к компрессии и кодированию данных.
Ключевые моменты:
- Формат и компрессия должны подбираться совместно. Разные форматы по-разному используют кодеки на уровне столбцов или строк, поэтому общая производительность зависит от набора данных, типа запросов и инфраструктуры.
- В Parquet и ORC компрессия применяется per column chunk / page, что обеспечивает эффективное сжатие и возможность чтения только необходимого набора столбцов.
- В Avro компрессия применяется на уровне каждого блока, в котором хранится данные. Это хорошо для последовательной обработки и передачи, но для аналитики требует конвертации в колонарный формат для эффективного сканирования.
- Выбор компрессии должен учитывать CPU-накладные затраты на распаковку и влияние на задержки чтения. Snappy обычно обеспечивает лучший баланс между скоростью и эффективностью, тогда как Zstandard может дать лучший коэффициент сжатия при аналогичной скорости распаковки. GZIP обеспечивает максимальное сжатие, но часто слишком медлен для интенсивной аналитики.
Практические рекомендации:
- Для большинства аналитических задач рекомендуется использовать Snappy или Zstandard как компрессии по умолчанию для Parquet и ORC. В случаях архивирования больших архивов можно рассмотреть Deflate/GZIP, если доступно больше CPU-времени на распаковку.
- При проектировании пайплайнов учитывайте требования к ходу времени выполнения: для интерактивных запросов ориентируйтесь на компрессии, обеспечивающие быструю распаковку; для архивирования - на максимальное сжатие.
- Неплохо сочетать компрессию со стратегиями уплотнения, такими как разделение данных по ключам, чтобы повысить эффективность кэширования и предикатов.
Поддержка в экосистеме:
- Spark SQL, Hive и Impala действительно поддерживают Parquet и ORC, но способы конфигурации могут немного различаться. В Spark следует учитывать параметры параллелизма чтения, размер блоков и стратегии кэширования: эти настройки влияют на то, как эффективно движок будет использовать колоночные структуры.
- У Avro тесно интегрируется с потоковой обработкой и системами передачи сообщений (например, Kafka), где важна совместимость схем и скорость сериализации.
Интеграции и сценарии внедрения
Совместимость механизмов:
- Hive Metastore играет роль центрального хранилища схем и статистик для Parquet и ORC, что упрощает управление схемами и совместимостью между партами. При работе через внешние таблицы важно поддерживать актуальные статистики и согласованность схемы на уровне каталога.
- Spark SQL держится за Parquet и ORC с хорошей поддержкой векторизованного чтения и столбцовой фильтрации. Он позволяет строить эффективные планы выполнения и реализацию партиционирования на основе столбцов, что особенно важно для больших наборов данных.
- Impala акцентирует внимание на быстром сканировании и энтити-поддержке предикат-пушдауна. Он может показывать лучшую производительность для частых аналитических запросов при условии правильного проектирования схемы и упаковки данных.
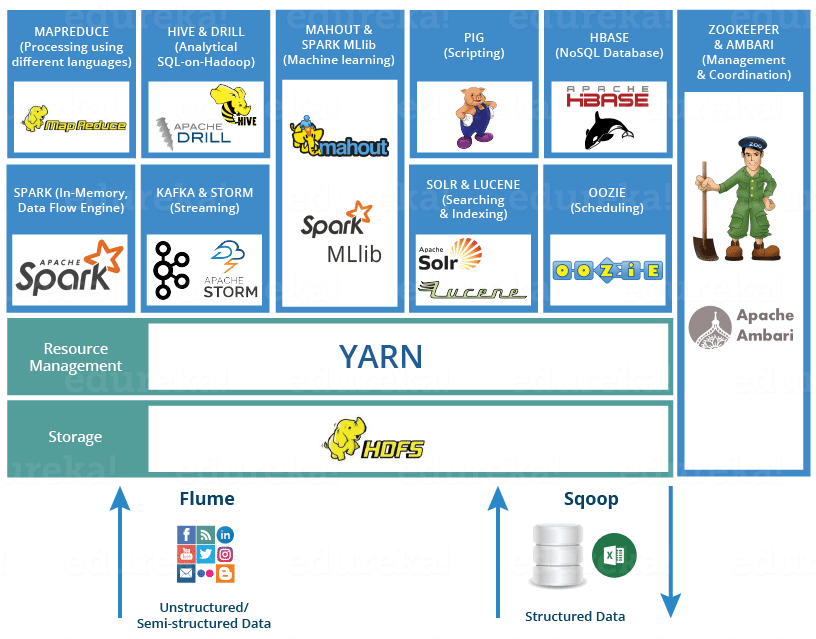
Как проектировать внедрение:
- Обеспечьте согласованность схем. Вспомогательно реализуйте процедуры тестирования нарушений совместимости схем, в том числе миграцию схем и обновление соответствующей части пайплайна.
- Обеспечьте качество метаданных. Поддерживайте корректную статистику по столбцам, чтобы движки могли эффективно планировать запросы и применять predicate pushdown.
- Определяйте подходящие форматы под нагрузку. Для стадий ETL, когда необходимо гибкость и частые изменения схем, Avro может быть полезен как промежуточный формат. Для стадий анализа предпочтительно Parquet/ORC из-за лучшей поддержки сканирования и компрессии.
- Внедряйте стратегию конвертации. Поддерживайте пайплайны, которые могут конвертировать данные между форматами в зависимости от текущей бизнес-логики или требований потребителей.
Практические рекомендации по формату выбора
- Batch-аналитика с четкой схемой и частой эволюцией: Parquet или ORC как основной формат хранения. Предикат-пушдаун и колоночное сканирование существенно снижают I/O.
- Потоковая обработка и событийые данные: Avro хорошо подходит на вход и на промежуточном уровне, но для аналитики после обработки предпочтительнее конвертация в Parquet/ORC.
- Гибкость и совместимость между сервисами: Avro - эффективен для передачи данных между сервисами; Parquet/ORC - для дальнейшей аналитики и хранения.
- Инфраструктурные ограничения: если используемая платформа оптимизирована под конкретный формат (Hive/Impala/Spark), то следуйте лучшим практикам этого стека и конфигурируйте параметры чтения и запись под типовую нагрузку.
Key takeaways
- Форматы Parquet и ORC в основном ориентированы на колонарный доступ, поддержку сложных структур и эффективную схему эволюцию, что критично для аналитических пайплайнов в Spark SQL, Hive и Impala.
- Avro прекрасно подходит для событийной передачи и эволюции схем в потоковых конвейерах; для аналитического сканирования часто применяется как промежуточный формат, затем конвертируется в Parquet/ORC.
- Текстовые форматы (CSV, JSON/JSON Lines) полезны на входе в пайплайны, однако для больших аналитических наборов данных чаще переходят в Parquet/ORC для эффективного сканирования и компрессии.
- Выбор компрессии и конфигураций должен учитывать баланс CPU/IO, характер нагрузки и требования к задержке. Snappy и Zstandard обычно предлагают лучший компромисс, тогда как GZIP полезен при архивировании.
- Важным является аккуратное управление схемами и статистикой в метаданных, а также координация между Hive, Impala и Spark SQL для обеспечения корректности и предсказуемости выполнения запросов.
FAQ
- Что выбрать для нового аналитического проекта: Parquet или ORC?**
- Выбор зависит от инструментального стека и характеристик workload. Parquet часто предпочтителен в Spark и Hadoop-эко-системе за счет широкой поддержки и хорошей совместимости с техникой predicate pushdown и column pruning. ORC может обладать преимуществами в системах, где требуется ещё более эффективная компрессия и продвинутая фильтрация по строкам и столбцам. Рекомендуется провести тестирование на реальных запросах и данных.
- Какую роль играет Avro в пайплайне?
- Avro полезен как формат событий и для обмена данными между сервисами благодаря встроенной схеме и эволюции. Он хорошо подходит для потоковых конвейеров, затем данные часто конвертируются в Parquet/ORC для аналитики.
- Что эффективнее использовать для ingestion: CSV или JSON Lines?**
- CSV прост и эффективен для табличных структур с фиксированными схемами, но без поддержки вложенной структуры. JSON Lines обеспечивает полуструктурированные данные и удобство потоковой передачи. Однако для аналитики лучше конвертировать в Parquet/ORC после завершения обработки.
- Какие компрессии чаще применяются и почему?
- Snappy - общий баланс скорости и уровня сжатия, подходящ для большинства аналитических задач. Zstandard - лучший компрессия/скорость в ряде сценариев. GZIP - высокое сжатие, но может замедлять чтение. Выбор зависит от характера нагрузки и требований к задержке.
- Как избежать проблем с эволюцией схем?
- Определите стратегию совместимости: добавление новых полей со значениями по умолчанию, аккуратная миграция таблиц и обновление статистики. Внедрите процессы тестирования на совместимость и автоматическое обновление метаданных.
- Какой формат выбрать для Hive и Impala?
- Чаще всего Parquet - базовый выбор за счёт поддержки столбцового сканирования и предикат-пушдауна, а также широкой совместимости с Metastore. ORC - хорошая альтернатива в случае специфических требований к компрессии и индексации. Avro - полезен на входе и в потоках, но для аналитики предпочтительнее конвертация в Parquet/ORC.
- Какие ограничения на изменение схем в Parquet/ORC?
- Добавление новых полей с дефолтными значениями обычно поддерживается. Удаление полей и изменение типов требует проверки совместимости и корректного поведения потребителей. Важно тестировать миграции и поддерживать тестовую среду для выявления ошибок.
- Нужно ли хранить метаданные отдельно от данных?
- Да. Метаданные и статистика таблиц критически важны для планирования запросов и оптимизации чтения. Hive Metastore, а также статистика по столбцам помогают системе планирования избегать ненужного IO.
- Какое влияние имеет размер Row Group/Stripe на производительность?
- Меньшие Row Groups улучшают параллелизм и адаптацию к распределению данных, но увеличивают накладные расходы на метаданные. Большие Row Groups уменьшают количество метаданных, но могут снизить гибкость чтения отдельных столбцов. Аналитикам следует подбирать размер под конкретную схему данных и характер запросов.
- Какие практики тестирования форматов стоит внедрить?
- Регрессионное тестирование на совместимость схем и корректность чтения старых файлов. Тесты на производительность чтения и записи, включая предикат-пушдаун и размер блоков. Мониторинг статистик и их точности после изменений в данных и схеме. Внедрение автоматизированной миграции схем и тестирования на совместимость между Spark, Hive и Impala.


