

Архитектура Hadoop: компоненты, взаимодействия и границы ответственности
Hadoop выступает как фундаментальная платформа для хранения и обработки больших данных в рамках корпоративной экосистемы. Архитектура Hadoop строится на разделении сфер хранения и вычислений, что обеспечивает масштабирование, отказоустойчивость и гибкость внедрения ETL-процессов, интеграции с Hive и Spark, а также взаимодействие с аналитическими системами. В данной главе рассматриваются ключевые компоненты, их роли и границы ответственности, принципы взаимодействия между ними, а также типовые паттерны проектирования ETL-архитектур на базе Hadoop.
В рамках курса уделяется внимание не только техническому устройству, но и темпоральной согласованности данных, режимам доступа, безопасности и операционной зрелости систем на основе Hadoop. Понимание архитектурных решений позволяет принимать обоснованные решения при проектировании ETL-процессов, выборе форматов хранения, настройке планирования задач и выстраивании устойчивых конвейеров данных.
- Основные компоненты Hadoop и их роли
- Взаимодействие между HDFS, YARN и вычислительными движками в ETL-процессах
- Границы ответственности, безопасность и операционная грамотность
- Эталонные архитектурные паттерны интеграции с Hive и Spark
Основные компоненты Hadoop и их роли
Hadoop состоит из набора взаимосвязанных компонентов, каждый из которых отвечает за конкретный аспект обработки данных: хранение, планирование ресурсов и исполнение задач, а также инфраструктурные сервисы. В совокупности они образуют распределенную систему, которая обеспечивает устойчивое масштабирование при росте объема данных и сложности вычислительных конвейеров.
HDFS: распределенное хранение и доступ к данным
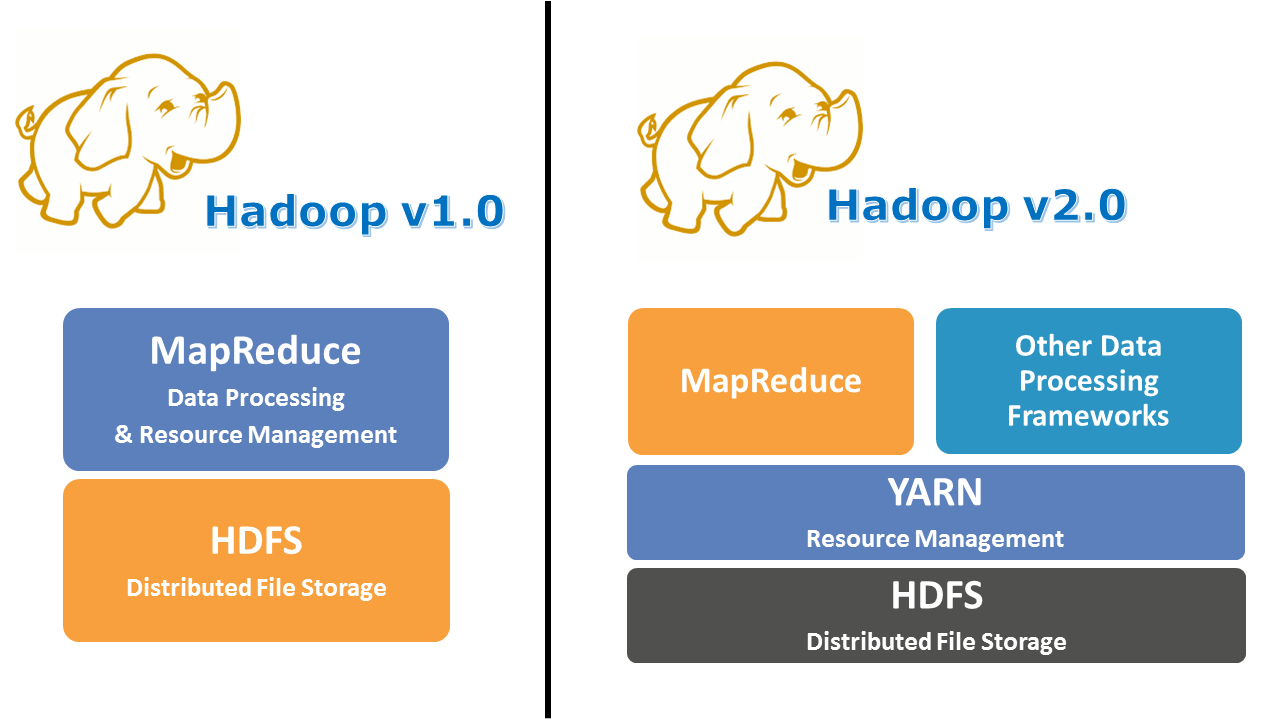
HDFS реализует надежное и доступное хранение огромных файлов путем разделения данных на блоки фиксированной величины и репликации этих блоков по узлам кластера. Основными элементами являются NameNode и DataNode. NameNode хранит метаданные о файловой системе: структуру директорий, маппинг блоков на файлы, расположение реплик и состояние каталога. DataNode осуществляет фактическое чтение и запись данных. Современные реализации поддерживают федерацию именованных пространств (несколько Namespaces) и высокую доступность NameNode через механизм JournalNode, что снимает единичную точку отказа.
Для читателя и писателя важна концепция data locality - выполнение вычислений ближе к месту хранения данных. Это минимизирует сетевые перемещения и позволяет эффективнее обрабатывать большие наборы файлов. В ходе настройки рекомендуется учитывать размер блоков, фактор репликации и стратегию размещения данных в кластере, чтобы обеспечить баланс между надежностью и расходами на хранение.
HDFS поддерживает несколько режимов консолидации метаданных и восстановления после сбоев. В современных кластерах широко применяется функциональность High Availability (HA) NameNode и Federation, что позволяет выдержать выход отдельных узлов из строя без значительных потерь доступности файлов. В контексте ETL это особенно важно для устойчивой обработки потоков данных, где простои могут задержать конвейеры и повлиять на SLA.
YARN: управление ресурсами и планирование
YARN является балансирующим звеном между требованиями вычислительных задач и ограниченными ресурсами кластера. Основными компонентами являются ResourceManager, NodeManager и ApplicationMaster. ResourceManager координирует доступ к ресурсам на уровне всего кластера, а NodeManager отвечает за жизненный цикл контейнеров на отдельных узлах. ApplicationMaster под каждое приложение отвечает за планирование задач внутри данного приложения, координируя выполнение и обработку с учетом характеристик ресурса и политики планирования.
С точки зрения ETL-процессов важны следующие моменты: установка профилей ресурсов (CPU, память, дисковое I/O), выбор планировщика (Capacity, Fair, Dominant Resource Fairness) и управление жизненным циклом приложений. Принятие решений о выборе движка (например, Spark на YARN против традиционного MapReduce) влияет на задержки, степень параллелизма и требования к памяти. Эффективное использование YARN достигается за счет разумного проектирования задач, минимизации serialized-обработки, настройки сжатия данных и стратегий повторной попытки при ошибках.
Программная модель исполнения: MapReduce и альтернативы
Классическая модель MapReduce - это ориентированная на пакетную обработку вычислительная схема, разделяющая работу на этапы маппинга и редуцирования. В современной архитектуре Hadoop MapReduce активно дополняется альтернативами, особенно Spark, работающими поверх YARN или в виде независимого кластера. Главная причина перехода к альтернативам - снижение задержек, более выразительный API для сложной трансформации данных и поддержка графовой/итеративной обработки.
MapReduce хорошо подходит для простых и предсказуемых конвейеров, где транзакционная консистентность и детерминированная обработка превалируют над супер-быстрой адаптацией под динамически изменяющиеся источники данных. Spark же демонстрирует существенные преимущества в сценариях с повторным использованием данных между задачами, интерактивной обработке и машинном обучении. В контексте ETL это означает переход к моделям, где данные сначала выгружаются в промежуточные форматы (например, Parquet/ ORC), затем выполняются цепочки трансформаций и агрегации с использованием Spark на YARN, с сохранением результатов обратно в HDFS или внешние хранилища.
Hadoop Common и экосистема: инфраструктура и стандарты
Hadoop Common обеспечивает базовые библиотеки, интерфейсы и утилиты, которые разделяют модули хранения, сериализации, RPC и конфигурацию. Эти общие компоненты позволяют согласованно работать различным сервисам в рамках единой экосистемы и упрощают миграцию между версиями. В рамках практических проектов кластеры часто дополняются инструментарием управления и мониторинга: Ambari или Cloudera Manager, которые снижают операционные риски за счет централизованной настройки, мониторинга и автоматических обновлений. Для поддержки сетевых хранилищ и облачных контура часто применяют адаптеры и драйверы через файловые системы, такие как s3a, что позволяет интегрировать Hadoop с облачными источниками и обеспечить единый интерфейс доступа к данным независимо от места их хранения.
Взаимодействие компонентов и сценарии выполнения ETL-процессов
Эффективная архитектура ETL-процессов на базе Hadoop строится вокруг гармоничного взаимодействия между хранением, планированием ресурсов и вычислениями. Рассматривая сценарии типичной обработки данных, можно выделить последовательность шагов, начиная с загрузки данных в HDFS и заканчивая загрузкой результатов в аналитические слои.
Этапы ETL в Hadoop: извлечение, трансформация, загрузка
Извлечение чаще всего происходит из разнообразных источников: файловые системы, базы данных через конвертеры и коннекторы (JDBC/ODBC, прямые драйверы). Данные попадают в HDFS как «сырые» файлы. Трансформация реализуется через вычислительные движки - Spark или MapReduce - которые читают данные, нормализуют схемы, агрегируют, объединяют источники и приводят данные к целевым форматам. Загрузка завершается сохранением результатов обратно в HDFS или в внешние хранилища с поддержкой событийной интеграции в Hive Metastore или другие каталоги схем.
Ключевым здесь является сохранение промежуточных этапов и возможность повторной загрузки данных без повторной переработки исходного массива. В ETL-поточках важны принципы идемпотентности, детерминированности и контроля версии схемы. Использование форматов колоночного хранения (Parquet, ORC) обеспечивает эффективное сжатие и ускоряет чтение при анализе.
Дорожная карта выполнения: от данных к результатам
Этапы реализации конвейера, как правило, выглядят следующим образом: данные поступают в HDFS, где сохраняются в разделах (partitioning) по признакам времени, источнику или бизнес-тону. Метаданные об источниках и схемах регистрируются в Hive Metastore, что обеспечивает единый каталог для последующей обработки и аналитики. Spark на YARN выполняет трансформации, применяет фильтры и агрегации, поддерживает кэширование промежуточных дизъюнкций и, при необходимости, выполняет обучение моделей на тех же данных. Результаты сохраняются в ORC/Parquet и доступны для BI-инструментов, Hive/Impala, Spark SQL или внешних систем.
Архитектурное проектирование конвейера требует учета качества данных, обработчика ошибок и стратегий повторного запуска. Например, для ETL-процессов с изменяющимися источниками целевых схем полезно поддерживать версионность схем и механизм отката, чтобы в случае несовместимости можно вернуть данные к стабильному состоянию. Также следует уделять внимание предикатным запросам и возможности pushdown, чтобы снизить объем обработки и сетевых переносов.
Путь данных через HDFS, YARN и вычислительные движки
Контекст исполнения задается настройкой совместимости между форматом файлов и механизмами доступа. HDFS предоставляет доступ к данным через стандартные API, а вычислительный движок, будь то Spark или MapReduce, формирует DAG выполнения. Распределенная память Spark, обработка данными через RDD/DataFrame и оптимизация планирования за счет Catalyst-плагина позволяют значительно ускорить сложные трансформации. В Hadoop такой подход достигается за счет минимизации дисковых операций и эффективной сериализации. В реальных условиях отладка и мониторинг являются неотъемлемой частью: логирование задач, показатели задержек и пропускной способности узлов позволяют оперативно управлять конвейерами и предотвращать узкие места.
Путь к устойчивости: журналирование и откат
Важным аспектом является журналирование и восстановление после сбоев. Благодаря HA NameNode и репликации данных в DataNodes система продолжает работу даже при выходе части узлов. Для повторной обработки ошибок применяются технические механизмы retry, параметры конфигурации заданий и контрольные точки в Spark Streaming или Structured Streaming. Такой подход обеспечивает устойчивость ETL-процессов к сетевым задержкам, сбоям узлов или временным перегрузкам кластера.
Границы ответственности и контроль данных
Разделение обязанностей между различными компонентами обеспечивает управляемость и предсказуемость поведения системы на протяжении жизненного цикла данных. Это также критично для обеспечения соответствия требованиям к безопасности, аудиту и управлению версиями.
Разделение ответственности: данные, вычисление и метаданные
- Хранение данных и их целостность лежат на HDFS: механизмы репликации, контроль доступа на уровне файловой системы, аудит операций чтения и записи.
- Вычисления и планирование ресурсов управляются YARN: выбор движка, настройка ресурсов, жизненный цикл приложений.
- Метаданные и схемы управляются через Hive Metastore, каталогизацию таблиц и схем, а также через внешние каталоги, которые обеспечивают совместимость между различными обработчиками.
Разделение ответственности способствует независимости компонент и упрощает миграцию между движками без кардинального переработки всей архитектуры. Однако следует поддерживать согласованную политику версионирования схем, совместимость форматов и единую систему аудита.
Безопасность и доступ: Kerberos, Ranger, ACL
Безопасность является неотъемлемой частью архитектуры Hadoop. В классических развёртываниях применяется Kerberos для аутентификации и межсервисного доверия. В дополнение рассматриваются механизмы авторизации и аудит доступа на уровне файловой системы и уровней приложений: ACL на уровне файлов, роли и политики доступа в Rangers или аналогичных системах управления безопасностью. Важной задачей является настройка безопасного доступа к данным в рамках ETL-процессов - минимизация рисков утечки данных и обеспечение соблюдения политик конфиденциальности.
Управление версиями и жизненный цикл данных
Эффективная архитектура предусматривает управление версиями схем, долговечность и archival-стратегии. Таблицы Hive Metastore должны поддерживать эволюцию схем, включая добавление столбцов, изменение типов и правила совместимости. Архивирование устаревших данных - это часть политики жизненного цикла данных, включающая удаление или перемещение в менее дорогие хранилища. В рамках Hadoop рекомендуется внедрять политики TTL на уровне архитектуры конвейеров и хранить критически важные данные в более производительных форматах для быстрого доступа.
Эталонная архитектура ETL-процесса с Hive/Spark
В типовом сценарии Hadoop-платформа используется как единая база для загрузки, трансформации и подготовки данных для аналитики. Важно, чтобы архитектура поддерживала прозрачное управление версиями схем, удобную интеграцию с Hive Metastore и эффективное использование памяти и CPU при трансформациях.
Общий паттерн включает:
- прием данных из множества источников и сохранение их в HDFS в формате, поддерживающем компрессию и быструю декомпрессию (Parquet/ORC);
- регистрация схем и таблиц в Hive Metastore для унифицированного доступа;
- обработку с использованием Spark на YARN - выполнение трансформаций, фильтраций и агрегаций;
- сохранение результатов в разделах и формате, удобном для конечной аналитики;
- обеспечение добычи и lineage через метаданные и логи выполнения.
Преимущественно такие архитектуры требуют:
- продуманной стратегии разделения данных (partitioning) по времени, источникам и бизнес-событиям;
- обеспечения нулевой или минимальной задержки между загрузкой и доступностью новых данных для анализа;
- контроля качества и мониторинга на каждом этапе конвейера;
- согласованности между различными инструментами через единый каталог и стандартизированные форматы.
Обеспечение согласованности междуHive и Spark достигается за счет совместимости форматов, соглашений об именовании таблиц и схем, поддержки сервиса Metastore и корректной настройки каталога данных. В современных сценариях Spark оптимизирует доступ к данным через Parquet/ORC и поддерживает встроенные механизмы predicate pushdown и проектирования планов выполнения, что существенно снижает накладные расходы на чтение больших объемов данных. Hive, в свою очередь, обеспечивает удобность анализа и совместимость с BI-инструментами, а также стабильный слой метаданных для репликации и аудита.
Интеграция с файловыми форматами и хранением данных
Эффективная работа ETL и аналитических драйверов во многом зависит от выбора форматов хранения и способов организации файлов в HDFS. Форматы Parquet и ORC являются основными для колонного хранения и позволяют осуществлять predicate pushdown, что существенно сокращает объём данных, считываемых из диска. Avro и JSON применяются там, где важна гибкость схемы или требуются структуры с эволюционной версией.
Форматы и схемы: что выбрать и зачем
- Parquet: отлично подходит для аналитических конвейеров, поддерживает колоночное чтение, секционирование и компрессию. Хорошо работает с Spark SQL и Hive для больших наборов данных.
- ORC: аналог Parquet с особым уклоном в высокоэффективное считывание, особенно полезен при агрегациях и больших объемах.
- Avro: удобен для строки без строгого схемного контроля, полезен в потоках и обмене сообщениями между системами.
- JSON: обеспечивает гибкость в плане структуры, но требует дополнительных усилий для эффективного анализа больших объемов данных.
Разделение и организация данных
Разделение данных (partitioning) по времени, источнику или бизнес-ключу снижает стоимость операций чтения и упрощает обновление данных. Bucketing - альтернативный подход, который может ускорить операции join в некоторых сценариях. Важно поддерживать согласованную схему и стабильный механизм обновления метаданных в Hive Metastore, чтобы обеспечить предсказуемость в анализе и легкость миграций между версиями форматов.
Совместимость и переходные сценарии
При эволюции архитектуры и переходе между форматами следует учитывать обратную совместимость. В рамках корпоративной инфраструктуры рекомендуется минимизировать изменения на уровне конвейеров и обеспечить плавный переход к новым форматов через промежуточные слои и конвертеры. Инструменты мониторинга должны отслеживать соответствие схем и предупреждать об изменениях, которые могут повлиять совместимость клиентов и аналитических запросов.
Контроль исполнения, безопасность и операционные аспекты
Операционная зрелость Hadoop-кластера достигается через выстроенную систему мониторинга, управления конфигурациями, обеспечения отказоустойчивости и политики безопасности. В контексте ETL и интеграций с Hive и Spark это особенно критично, поскольку задержки и простои напрямую влияют на сроки поставки данных.
Мониторинг, логирование и управляемость
Современные подходы включают использование инструментов мониторинга (Prometheus, Grafana), централизованного логирования (ELK или EFK стек) и решений для управления конфигурациями (Ansible, Puppet, Chef). В качестве коммерческих решений применяются Ambari или Cloudera Manager, которые предоставляют dap-таск-видимость, автоматизацию обновлений и диагностику проблем. Важно иметь дашборды по ключевым метрикам: задержки конвейеров, пропускная способность сетей, загрузка CPU и памяти на узлах, статус репликации HDFS и состояние Namenode/JournalNode.
Безопасность и соответствие требованиям
Для защиты данных в Hadoop-кластере применяется многоуровневый подход: аутентификация через Kerberos, авторизация на уровне файловой системы и служб через ACL и политики доступа, а также аудит и мониторинг доступов. Ranger и аналогичные решения позволяют задавать детальные политики доступа к данным и таблицам. В корпоративной среде эти механизмы следует сочетать с процедурами управления ключами и шифрованием на уровне хранилища.
Операционные практики и устойчивость
- High Availability NameNode и JournalNode обеспечивают отказоустойчивость на уровне управления метаданными.
- Резервное копирование метаданных и периодическое тестирование восстановления критически важных узлов.
- Планирование обновлений и совместимости версий между компонентами - HC/CI-процедуры и тестовые стенды позволяют минимизировать риск сбоев в проде.
- Политики хранения и удаление устаревших данных - важная часть экономии ресурсов и соблюдения регуляторных требований.
Key takeaways
- Архитектура Hadoop строится вокруг разделения хранения и вычислений, что обеспечивает масштабируемость и устойчивость к сбоям.
- Основные компоненты - HDFS, YARN и вычислительные движки (MapReduce, Spark). Их взаимодействие и конфигурации определяют производительность ETL-процессов.
- Границы ответственности помогают управлять данными, вычислением и метаданными, а безопасность должна быть встроена на всех уровнях.
- Эталонная архитектура ETL-процессов с Hive/Spark опирается на единый каталог схем, форматы Parquet/ORC и эффективное планирование выполнения в рамках YARN.
- Выбор форматов данных и правильная организация разделов прямо влияют на производительность аналитики и стоимость хранения.
- Операционная зрелость достигается через мониторинг, управление конфигурациями и продуманную стратегию безопасности.
- Внедрение Hadoop-архитектуры должно сопровождаться планом миграции и поддержкой совместимости между инструментами.
FAQ
- Какие базовые компоненты Hadoop стоит изучить в первую очередь и почему?
HDFS обеспечивает долговременное хранение больших файлов и данные для вычислений, YARN реализует управление ресурсами и планирование задач, а вычислительный движок (MapReduce или Spark) конструирует логику обработки. Понимание взаимодействия этих слоев позволяет проектировать эффективные ETL-процессы и предсказывать поведение конвейеров при росте данных и нагрузки.
- Чем отличается архитектура MapReduce от Spark в контексте ETL?
MapReduce ориентирован на пакетную обработку с явным разделением этапов между маппингом и редуцированием, обеспечивает надежное выполнение, но имеет более ограниченную гибкость и задержки. Spark предлагает более гибкое API, поддержку итеративных алгоритмов и высокий уровень абстракций, ускоряющий трансформации, что особенно полезно в ETL-циклах и моделях подготовки данных.
- Как обеспечить надёжное хранение и высокую доступность данных в HDFS?
Использование HA NameNode через JournalNode, Federation, надлежащее управление репликацией (фактор репликации) и мониторинг состояния DataNode обеспечивают устойчивость к сбоям. Важно планировать резервное копирование метаданных и проверять процедуры восстановления.
- Какие практики помогут обеспечить безопасность Hadoop-кластера?
Kerberos обеспечивает аутентификацию, Ranger - детализированную авторизацию, ACL на уровне файлов и служб, аудит операций и мониторинг доступа. Комбинация этих механизмов снижает риск несанкционированного доступа к данным и обеспечивает соблюдение политик безопасности.
- Какие форматы хранения данных следует использовать в ETL-проектах и почему?
Parquet и ORC - колоночные форматы, оптимизированные под чтение запрошенных столбцов и эффективную компрессию; Avro полезен для схем из динамических источников и обмена сообщениями; JSON - гибкость в структурах, но требует дополнительных усилий на анализ больших объемов. Выбор зависит от характера запросов и требований к производительности.
- Как организовать интеграцию Hive и Spark в рамках одного конвейера?
Hive Metastore выступает в роли единого каталога схем, обеспечивая совместимость между Spark и Hive. Spark использует этот каталог для чтения схем и записи результатов, поддерживая оптимизацию планов выполнения и единый набор правил доступа к данным.
- Какие паттерны следует использовать для проектирования ETL-конвейеров на Hadoop?
Рекомендуется проектировать конвейеры через этапы загрузки данных в HDFS, регистрации схем в Metastore, трансформацию в Spark/YARN и сохранение результатов в форматы Parquet/ORC. Включение шагов верификации данных, контроль качества и устойчивые механизмы повторного запуска повышают надёжность.
- Какие операционные практики критичны для масштабирования Hadoop
непосредственно в ETL-проектах?
Необходимо обеспечить мониторинг и логирование на уровне кластера, планирование ресурсов, высокую доступность, резервное копирование и тестирование восстановления. Автоматизированные процедуры обновления и инфраструктурные проверки снижают риск сбоев.
- Какие современные тенденции влияют на архитектуру Hadoop сегодня?
Интеграция с облачными хранилищами и переход к гибридным средам, улучшенная поддержка Spark и ускорение вычислений, улучшения в управлении безопасностью и доступом, а также архитектурные паттерны для управления данными становятся ключевыми направлениями. Важно учитывать совместимость версий и миграционные стратегии в рамках зрелой корпоративной инфраструктуры.
- Как планировать миграцию к новой архитектуре Hadoop без простоя?
Необходимо определить критические конвейеры, выполнить тестовую миграцию на стенде, обеспечить совместимость форматов и схем, закладывать в процесс миграции параллельную работу старого и нового стека и постепенно переносить задачи на новую платформу. Включение поэтапного тестирования и rollback-плана - критические аспекты минимизации риска.


