

Hadoop для Data Engineer
Этот курс ориентирован на практическое использование Hadoop для построения ETL-процессов и обработки больших данных. Он показывает, как проектировать пайплайны, интегрировать источники данных и выстраивать обработку как в batch, так и в streaming сценариях.
Вы изучите работу с Hive, Spark, Kafka и другими инструментами экосистемы, а также подходы к оптимизации производительности и управлению файловыми форматами. Особое внимание уделяется качеству данных, оркестрации пайплайнов и эксплуатации решений.
Курс даёт практическое понимание того, как Hadoop используется в реальных data engineering проектах.
- Введение: Hadoop, Data Engineer и контекст ETL в больших данных
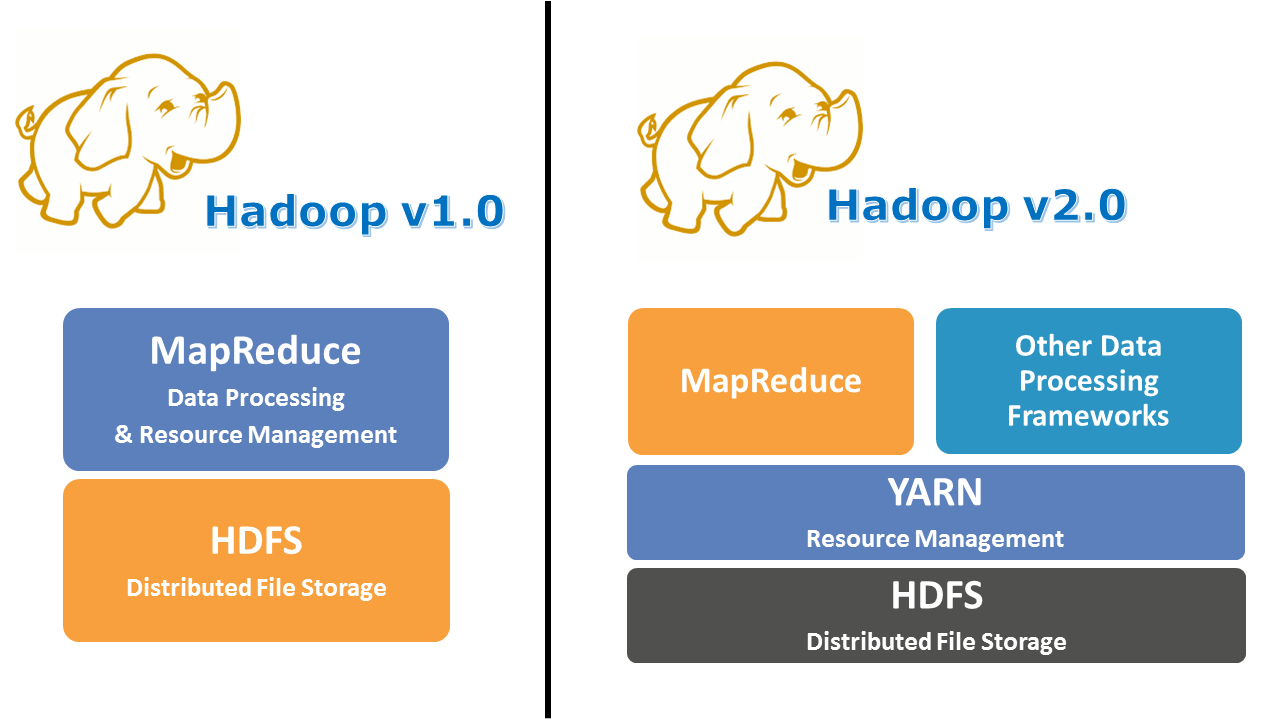
- Термины и базовые концепции HDFS, YARN, MapReduce и Spark
- Архитектура Hadoop: компоненты, взаимодействия и границы ответственности
- Стратегия данных в организации: требования к архитектуре и зрелость
- Хранение данных на HDFS: принципы, репликация, безопасность и производительность
- Файловые форматы для больших данных: Parquet, ORC, Avro, JSON, SequenceFile
- Метаданные и управление данными: Hive Metastore, Atlas, Data Catalog
- Источники данных и их интеграция: Sqoop, Flume, NiFi, Kafka
- Интеграция с аналитикой: Hive, Spark SQL, Presto/Trino
- Обработка пакетных данных: MapReduce, Tez, Spark на Hadoop
- Потоковая обработка в экосистеме Hadoop: Structured Streaming и Spark Streaming
- Архитектурные паттерны ETL на Hadoop: пакетная, потоковая и гибридная архитектура
- Проектирование ETL-конвейеров: конвейеры, зависимости, переиспользование
- Трансформации данных и математические модели: формулы, правила и алгоритмы
- Качество данных: профилирование, валидация, тестирование пайплайнов
- Безопасность и соответствие: Kerberos, Ranger, Knox, TLS, шифрование данных
- Управление доступом и аудитами: политики, роли, журналирование
- Эволюция схем и управление схемами: совместимость, миграции, версионирование
- Производительность и оптимизация: форматы, разделы, predicate pushdown, векторизация
- Мониторинг и операционная устойчивость: метрики, логирование, алертинг
- Оркестрация пайплайнов: Oozie, Airflow, NiFi и управление зависимостями
- Тестирование ETL и качество кода: unit, integration, data tests
- Эксплуатационная модель: развёртывание, обновления пайплайнов, DevOps для данных
- Масштабирование и зрелость Hadoop: кластеризация, многопоточность, стоимость владения
- Интеграция Hadoop с BI и аналитическими инструментами: дэшборды, JDBC/ODBC
- Практические кейсы: сценарии внедрения ETL на Hadoop
- Риски, ограничения и типовые ошибки: профилактика и уроки
- Будущее Hadoop и альтернативы: облачные платформы и lakehouse-траектории
- Финальный практический проект: проектирование и реализация ETL-пайплайна с Hive и Spark


