

Введение: Hadoop, Data Engineer и контекст ETL в больших данных
Индустрия обработки больших данных ставит перед Data Engineer задачу построения надёжных и масштабируемых конвейеров извлечения, преобразования и загрузки данных. В этом контексте Hadoop выступает как платформа хранения и вычислений, обеспечивающая распределение объёмов данных на десятки или сотни нод и поддержку разнообразных режимов обработки - пакетной, интерактивной и потоковой. Роль Data Engineer здесь не ограничивается написанием трансформаций: следует помнить о целостности данных, управляемости пайплайнами, интеграции метаданных и обеспечении эксплуатационной устойчивости систем.
Данная глава задаёт контекст и рамки курса: какие архитектурные принципы и паттерны лежат в основе ETL в больших данных на платформе Hadoop, какие интеграции с Hive и Spark реализуют рабочие сценарии, как выбирать форматы файлов и как выстраивать надёжные конвейеры с учётом вопросов безопасности и мониторинга. Мы опираемся на ведущие концепции Hadoop-экосистемы, разбираем закономерности архитектуры, описываем типовые сценарии внедрения и приводим практические ориентиры по проектированию ETL-процессов.
Краткое содержание главы
- Архитектурный контекст Hadoop и роль Data Engineer в контексте ETL: что лежит в основе хранения, вычислений и метаданных.
- Паттерны ETL в больших данных: этапы, качество данных, идемпотентность и оркестрация пайплайнов.
- Интеграции с Hive и Spark: как использовать Hive Metastore и Spark SQL для эффективной обработки и агрегаций, какие паттерны взаимодействия применяются.
- Форматы файлов и принципы хранения: Parquet, ORC, Avro, их плюсы и особенности использования в задачах ETL.
- Управление качеством, безопасностью и мониторингом: управление данными, контроль версий схем, безопасность и видимость пайплайнов.
Архитектурный контекст Hadoop и роль Data Engineer
Рассмотрим базовые компоненты Hadoop-платформы и роли, которые выполняют Data Engineer в рамках ETL.
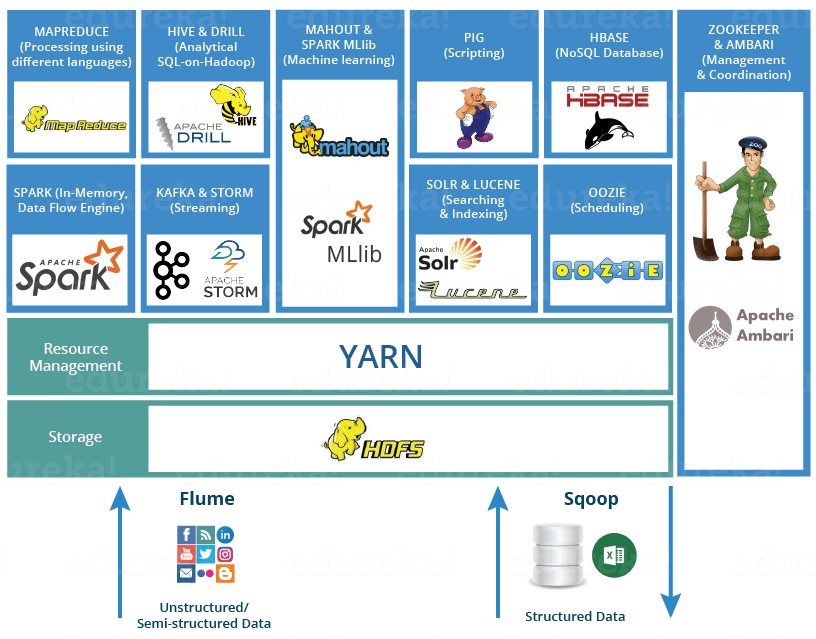
Hadoop построен вокруг двух краеугольных элементов: хранилища и вычислений. Хранилище реализовано через распределённую файловую систему HDFS: данные разбиваются на блоки, дублируются на разных узлах, обеспечивая долговечность и устойчивость к сбоям. Узлы каталога данных (NameNode) отвечают за метаданные, DataNode - за фактическое хранение данных. Эффект от эффектной масштабируемости достигается за счёт горизонтального добавления узлов, что позволяет хранить и обработать петабайты данных.
Часть вычислений традиционно реализуется через YARN - общий менеджер ресурсов, который распределяет задачам контейнеры на кластере. Это позволяет теоретически запускать любые движки обработки поверх единой инфраструктуры: MapReduce сегодня не но устаревший, но остаётся в ряде сценариев как базовый движок; современные альтернативы, такие как Tezи Spark, поддерживают гораздо более эффективные графовые планы и инкрементальные вычисления. В рамках ETL именно Spark часто становится основным движком преобразований: он поддерживает in-memory вычисления, гибкую работу с DataFrame и SQL, а также тесно интегрируется с файловыми форматами.
Важно отметить роль метаданных и управления данными. Hive Metastoreслужит центром спектра схем, разделов и таблиц, предоставляя единый источник истины для инструментов анализа. Связка Hive Metastore с Spark SQL позволяет Spark работать с внешними и управляемыми таблицами так же, как и с локальными файлами, сохраняя согласованность между слоями «данные - метаданные - правила доступа».
Безопасность и управляемость - неотъемлемая часть архитектуры Hadoop в рамках корпоративной ETL-экосистемы. Реализация Kerberos для аутентификации, роль-based access control (RABC), правила Ranger для аудита и контроля доступа - всё это обеспечивает защиту чувствительных данных и соответствие требованиям регуляторов. В условиях больших данных возрастает внимание к мониторингу и управлению изменениями meta-данных, версии схем и детерминированности пайплайнов.
С точки зрения архитектуры важна концепция обработки данных «где лежат данные» и «как к ним можно обратиться». Применение концепций data lake и data warehouse в одном контексте чаще ведёт к hybrid-архитектурам: данные из разных источников инжектируются в общий файловый слой, затем через SQL/DataFrame-интерфейсы они преобразуются и загружаются в целевые таблицы. Важной здесь является совместимость форматов файлов и способность выполнять запросы через Hive/Spark без необходимости полного копирования или преобразования данных.
Ключевые технологические направления, которые формируют роль Data Engineer в Hadoop-проектах, можно свести к следующим аспектам:
- Архитектура хранения и вычислений: HDFS, NameNode/DataNode, репликация, балансировка нагрузки, локализация вычислений и устойчивость к сбоям; обработчики вычислений на основе YARN, Tez, Spark и их взаимодействие с файловой подсистемой.
- Метаданные и схемы: Hive Metastore, таблицы, разделы, версии схем, поддержку schema evolution; интеграции с Spark SQL и внешними инструментами.
- Паттерны доступа к данным: пакетная загрузка и обновление, инкрементальные загрузки, потоковая обработка (через интеграцию с Kafka, Flume и др.); оркестрация пайплайнов.
- Форматы файлов и оптимизация хранения: Parquet, ORC, Avro как ключевые форматы для эффективной компрессии, CJ-предикатной загрузки и промышленной производительности;
- Безопасность и мониторинг: Kerberos, Ranger/Knox, аудит доступа, мониторинг с помощью Prometheus/Grafana и логирования для воспроизводимости.
В рамках этого курса особый акцент делается на интеграциях между компонентами и на практических паттернах проектирования ETL-пайплайнов в больших данных. Правильная постановка архитектуры должна обеспечивать масштабируемость, предсказуемость задержек и устойчивость к сбоям, позволяя при этом ориентироваться на требования бизнеса к скорости получения аналитической информации и к качеству данных.
Этапы ETL в больших данных: архитектура, паттерны и реализация
ETL-процессы в Hadoop-окружении проходят через три стандартных этапа: извлечение данных из источников, их преобразование с учётом бизнес-правил и загрузка в целевой слой. В больших данных эти этапы усугубляются объёмами, скоростью поступления и разнородностью источников. Ниже представлены базовые паттерны и практики, которые применяются на практике.
Извлечение данных - первый узел конвейера. В Hadoop-проекте часто встречаются источники: реляционные базы данных через Sqoop, логи приложений и серверной инфраструктуры через Flume, потоки событий из Kafka, файлы на файловых системах и объекты в облачном хранилище. Возможна интеграция через streaming-платформы, которые держат данные в «потоке» и позволяют не терять события в случае временного простоя. В этом контексте Data Engineer должен обеспечить надёжность и идемпотентность операций загрузки: повторная загрузка не должна приводить к дублированию или неконсистентности; сервисы должны иметь возможность повторного запуска без побочных эффектов.
Преобразование - сердце ETL в больших данных. В рамках Hadoop это обычно достигается через движки, которые поддерживают сложные трансформации над гигантскими объёмами данных. Sparkчасто выступает как основной движок преобразований благодаря своей гибкости во владении структурированными данными (DataFrame, Spark SQL), поддержке UDF и широкому набору преобразований. Верификация и очищение данных, нормализация схем, обработка пропусков, детекция дубликатов, расчёт вычисляемых колонок - все это выполняется на стадии трансформаций. Важной особенностью является ленивое вычисление: Spark строит граф зависимостей и выполняет вычисления только при действительной необходимости, минимизируя накладные расходы.
Загрузка данных - последняя стадия конвейера. Загружать можно как во временные staging-таблицы, так и в целевые Hive-представления или таблицы с использованием файловых форматов, оптимизированных для аналитики: Parquet, ORC или Avro. Разделение по датам и другим ключам (partitioning) позволяет поддерживать эффективное сканирование и ускорять запросы. Важной задачей является выбор подходящего режима записи: append, overwrite или upsert (через ACID-транзакции в Hive/ORC, если это поддерживается версией и настройками кластера).
Контроль качества и мониториование - обязательный компонент. На этапе ETL нужно проверять соответствие данных контрактам, проводить проверки целостности, согласование схем, валидацию бизнес-правил и мониторинг задержек пайплайнов. Роль Data Engineer в этом контексте - проектирование и внедрение тестов на уровне данных, версионирование схем и создание «contracts» между источниками и потребителями.
Идемпотентность и повторяемость пайплайна - критичные требования. В условиях больших данных повторные запуски shouldn't приводить к дублированию данных или нарушению консистентности. Для обеспечения идемпотентности применяют стратегии, такие как управление ключами естественных/польных идентификаторов, использование диапазонных разделов и контроль версий записей, а также либо append-only логику, либо детерминированную схему обновлений.
from pyspark.sql import SparkSession
from pyspark.sql.functions import year, col

spark = SparkSession.builder.enableHiveSupport().getOrCreate()
df = spark.read.format("parquet").load("hdfs:///data/raw/sales/")
transformed = df.filter(col("amount") > 0).withColumn("year", year(col("date")))
transformed.write.mode("append").saveAsTable("warehouse.fact_sales")
Данный пример демонстрирует базовую схему ETL-пайплайна: извлечение данных из Parquet на HDFS, трансформацию через Spark и загрузку в Hive-таблицу. В реальных проектах подобный блок часто дополняется этапами валидации, обработки ошибок и повторной попытки загрузки. Важно отметить, что выбор форматов и стратегий загрузки тесно связан с темами безопасности, консистентности и мониторинга, которые будут рассматриваться далее.
Практическая архитектура ETL в Hadoop обычно строится на следующих принципах:
- Интеграция источников через коннекторы и конвейеры. В реальных проектах чаще всего присутствуют как пакетные коннекторы к базам данных (через Sqoop), так и потоковые источники (Kafka, Flume) для нулевого проигрывания задержки.
- Логика трансформаций централизуется в рамках движков анализа (Spark) или SQL-слоев (Hive/Spark SQL), что обеспечивает единый интерфейс к данным и возможность повторного использования бизнес-правил.
- Управление схемой и метаданными через Hive Metastore, помогающее синхронизировать схемы между источниками и потребителями.
- Пути к данным и покомпонентность архитектуры: разделение на raw, curated, и aggregated слои помогает управлять качеством данных и необходимостью повторной обработки.
- Безопасность и аудит - обязательный аспект: Kerberos-аутентификация, разрешения, контроль доступа и журналы аудита для соответствия требованиям.
Этапы ETL в больших данных подчинены общей логике управления изменениями. В рамках проектов особое внимание уделяют:
- Управлению временными разделами и версиями схем для поддержки эволюции данных.
- Введение контрактов между источниками и потребителями через строгие правила согласованных форматов данных.
- Автоматизации тестирования и мониторинга пайплайнов для обеспечения воспроизводимости и устойчивости к сбоям.
Интеграции с Hive и Spark: совместная работа для аналитики
Контекст интеграций между Hive и Spark является краеугольным для эффективной реализации ETL на Hadoop. Hive выступает как уровень SQL-представления над данными на HDFS, обеспечивая читабельность и совместимость с ранее существующими аналитическими процессами. Spark, в свою очередь, предоставляет современный API для трансформаций и расширенные возможности машинного обучения, графовых вычислений и обработки больших данных.
Hive интеграция
Hive Metastore хранит метаданные о структурах таблиц и их разделах. Это позволяет Spark подключаться к тем же метаданным и выполнять запросы, используя единый источник информации о схемах. При включении Hive поддержки в Spark (enableHiveSupport) появляется возможность:
- читать и записывать Hive-таблицы через Spark SQL;
- использовать внешние таблицы, созданные в Hive, в рамках Spark-запросов;
- сохранять результаты преобразований обратно в Hive таблицы для обеспечения единообразия данных и оперативного доступа зависимым системам.
Поддержка ACID в Hive (через формат ORC и механизмы транзакций) позволяет реализовать надёжную загрузку и обновление транзакционных таблиц в рамках ETL-процессов, что особенно актуально для корпоративной аналитики и репортинга. Временная дисциплина схем, совместные транзакции и корректировка схем - критически важные аспекты для устойчивой работы.
Spark интеграция
Sparkинтегрируется с Hive Metastore и HiveServer2, что позволяет запускать SQL-запросы и работать с данными, находящимися в Hive, через Spark и DataFrame API. Основные преимущества:
- единая среда для трансформаций и аналитики: Spark SQL, DataFrames, Spark MLlib и прочие;
- эффективная обработка больших объемов благодаря распределённой обработке и оптимизатору Catalyst;
- поддержка форматов Parquet, ORC, Avro и совместная работа со сховищами; возможность использования Spark для инкрементных загрузок и обновлений;
- гибкость в выборе движка - можно сочетать пакетную обработку Spark с потоковой обработкой через структурированную потоковую обработку.
Совместная архитектура
В рамках современной архитектуры Hadoop часто применяется концепция Lakehouse-подхода: данные сохраняются на HDFS в колонно-ориентированных форматах, при этом SQL-интерфейс Hive/Spark обеспечивает быстрый доступ к данным. Open-source альтернативы и расширения, такие как Apache Iceberg и Apache Hudi, предоставляют дополнительные возможности по управлению таблицами, версии схем и оптимизации ленивых загрузок. Однако в рамках данного курса мы ограничиваемся классической связкой Hadoop + Hive + Spark и рассматриваем Iceberg/Hudi как опцию для дальнейшего углубления.
Понимание того, как именно интегрировать Hive и Spark, помогает писать более предсказуемые и повторяемые пайплайны: Spark может читать данные напрямую из HDFS, использовать Hive Metastore для определения схем и сохранять результаты в Hive-таблицы, что упрощает организацию аналитического слоя и ускоряет доступ к данным для BI-инструментов и аналитиков. В контексте ETL это обеспечивает единый слой данных, к которому могут обращаться несколько потребителей без конфликта версий и с согласованной семантикой.
Форматы файлов и хранение данных
Ключевой частью производительности ETL-процессов является выбор форматов файлов и стратегии хранения. Различные форматы имеют свои сильные стороны:
- Parquet: колонно-ориентированный формат с эффективной компрессией и predicate pushdown. Отлично подходит для аналитических запросов, часто является основой для хранения пред-обработанных данных в аналитических слоях. Parquet хорошо интегрируется с Spark и Hive, поддерживает схемы эволюции и очень эффективен при сквозной обработке больших наборов данных.
- ORC: оптимизированный для Hive формат с эффективной компрессией и ускоренной обработкой через индексирование. Хороший выбор для больших таблиц, где важны производительные сканирования и чтение через Hive/LLAP. ORC часто применяется в сочетании с транзакционными возможностями Hive.
- Avro: гибкий формат для потоковой передачи и обмена сообщениями; отлично подходит для сериализации и передачи данных между системами, когда важна эволюция схем и компактное представление данных.
- SequenceFile и другие старые форматы: чаще используются в ностальгических или специфических контекстах, но редко являются предпочтительным выбором для новых проектов.
Выбор формата влияет на множество аспектов: скорость записи и чтения, эффективность компрессии, поддержку эволюции схем и потребности в предикатном фильтровании. В большинстве современных проектов применяется Parquet или ORC в качестве основного формата хранения для аналитики, с Avro-предусмотренной ролью для потоковой передачи и обмена сообщениями. При выборе форматов следует учитывать требования к совместимости с существующими потребителями данных, частоту обновлений и характер запросов.
Покрывая эти аспекты, Data Engineer обеспечивает, чтобы данные в Hadoop-окружении оставались доступными, структурированными и пригодными для анализа. Эффективность форматов тесно связана с темпами ETL и необходимостью обеспечения согласованности данных; правильный выбор форматов и параметров хранения прямо влияет на задержки аналитики и стоимость владения инфраструктурой.
Управление качеством данных, безопасность и мониторинг
Качественные и управляемые пайплайны - основа доверия к данным. В этом разделе рассматриваются практики, которые позволяют обеспечить согласованность, прозрачность и устойчивость ETL-процессов.
- Контракты данных и проверка качества. Определение контрактов между источниками и потребителями данных, валидизация контрактов на этапе загрузки, мониторинг изменений схем и правил обработки. Это позволяет быстро выявлять расхождения между ожиданиями и реальными данными.
- Мониторинг и журналирование. Непрерывный мониторинг задержек, объёмов, ошибок и качества данных. Использование инструментов мониторинга (Prometheus, Grafana, ELK-стек) позволяет быстро реагировать на аномалии и эффективно проводить аудит.
- Безопасность и соответствие нормативам. Реализация Kerberos для аутентификации, управление доступом через роли и политики, аудит доступа к данным. Для потребителей и аналитиков важно понимать, какие данные доступны и как они обновляются.
- Управление версиями схем и эволюция данных. Поддержка изменений схем без нарушения существующих пайплайнов; использование схем-эволюции и миграций данных; контроль совместимости между версиями.
- Надёжность и устойчивость к сбоям. Оценка критических путей пайплайна, резервирование узлов, репликация и план восстановления после сбоев. В кластерах Hadoop важно обеспечить минимальные простои и способность к повторному выполнению заданий.
Эти практики дополняют техническую часть архитектуры и позволяют создать устойчивый и управляемый процесс ETL. В сочетании со стратегиями идемпотентности и контроля версий они помогают минимизировать риск ошибок в данных и обеспечить соответствие требованиям бизнеса к качеству аналитических выводов.
Key takeaways
- Hadoop обеспечивает основу для масштабируемого хранения и вычислений за счёт HDFS и YARN, что критически важно для ETL в больших данных.
- Интеграция Hive и Spark позволяет осуществлять эффективную обработку данных и единый доступ к метаданным через Metastore.
- Выбор форматов файлов (Parquet, ORC, Avro) напрямую влияет на производительность запросов, эволюцию схем и стоимость хранения.
- Паттерны ETL включают ingestion, трансформацию и загрузку с учётом идемпотентности, контроля качества и оркестрации пайплайнов.
- Безопасность, аудит и мониторинг должны быть встроены на ранних этапах разработки пайплайна, чтобы обеспечить устойчивость и соответствие требованиям.
- Архитектура «Lakehouse» и интеграции с инструментами из сообщества (например, Iceberg, Hudi) расширяют возможности по управлению таблицами и версиями схем.
- Практическая реализация ETL требует четко определённых контрактов данных, повторяемых тестов и надёжной оркестрации (Oozie, Airflow).
FAQ
- Что такое Hadoop в контексте ETL и зачем он нужен Data Engineer?
- Hadoop - это платформа для масштабируемого хранения данных и распределённых вычислений. Для Data Engineer Hadoop обеспечивает возможность хранить неструктурированные и полуструктурированные данные в HDFS и обрабатывать их с помощью вычислительных движков (Spark, Tez, MapReduce). ETL-процессы в таком контексте строятся на трёх главных эпохах: извлечение данных из разных источников, их трансформацию под бизнес-правила и загрузку в целевые структуры, поддерживающие аналитическую нагрузку. Важной целью является обеспечение масштабируемости, надёжности и прозрачности пайплайнов, чтобы бизнес получал своевременную и качественную аналитику.
- Какие ключевые компоненты Hadoop важны для ETL?
- Основные компоненты - HDFS как хранилище, YARN как менеджер ресурсов для выполнения задач, Hive Metastore как централизованный репозиторий схем и таблиц, Spark как движок преобразований. В рамках ETL также часто используются инструменты инжекции данных (Sqoop, Flume, Kafka) и оркестрации (Oozie, Airflow). Взаимодействие этих компонентов и правильная архитектура позволяет строить надёжные конвейеры и управлять ими на больших объёмах.
- Каковы типичные паттерны ETL в больших данных?
- Типовые паттерны включают ingestion-пайплайны (постоянная подача данных из источников), трансформации на Spark (очистка, нормализация, агрегации, расчёт новых колонок) и загрузку в целевые таблицы Hive/Parquet-ORC. Важной частью является управление схемой, поддержка эволюции схем и обеспечение идемпотентности загрузок. Оркестрация пайплайнов и обработка ошибок - необходимая часть производственного цикла.
- Какой формат файлов выбрать для ETL-процессов и почему?
- Parquet и ORC - колоночные форматы с эффективной компрессией и предикатным pushdownом, что ускоряет аналитические запросы. Parquet более популярен в связке Spark и общего Hadoop-стека, ORC часто выбирают для Hive-окружения с упором на производительность сканирования. Avro удобен для потоковых данных и передачи данных между системами, где важна эволюция схем. Выбор зависит от сценария: частота обновлений, требования к схемам и потребности в совместимости с потребителями.
- Как обеспечить идемпотентность ETL-пайплайна?
- Идемпотентность достигается через детерминированные ключи загрузки, контроль версий схем, управление разделами и режимы записи (append/overwrite). В случае повторных запусков старые данные не должны дублироваться, а система должна корректно воспроизводить результат, независимо от количества попыток. Инструменты оркестрации и строгие контракты между источниками и потребителями данных помогают обеспечить повторяемость и надёжность.
- Как интегрировать Hive и Spark в ETL-пайплайны?
- Hive Metastore служит единым источником схем и разделов; Spark может использовать Hive Metastore через enableHiveSupport, что позволяет Spark SQL видеть Hive таблицы и работать с ними как с обычными DataFrame-датафреймами. Встраивание Spark в ETL-пайплайны позволяет выполнить сложные преобразования, а затем сохранить результаты обратно в Hive-таблицы или в файловый формат на HDFS. Эти интеграции обеспечивают единый интерфейс к данным и совместные правила доступа для аналитиков и BI.
- Какие меры безопасности и мониторинга важны в Hadoop-проектах?
- Обеспечение аутентификации через Kerberos, управление доступом и аудит через Ranger/Knox, сбор и анализ логов, мониторинг задержек и ошибок. В больших проектах данные часто чувствительные; поэтому безопасность и аудит - это часть дизайна пайплайна, а не его дополнение. Мониторинг помогает быстро выявлять проблемы, а аудит обеспечивает прозрачность и соответствие требованиям регуляторов и внутренних политик.
- Какие организационные практики полезны при внедрении ETL с Hadoop?
- Внедрять строгие контракты данных и контекстную документацию, развивать культуру тестирования на уровне данных, использовать повторяемые пайплайны и автоматизированную оркестрацию, внедрять практики DevOps: инфраструктура как код, контроль версий пайплайнов и конфигураций, регламент обработки инцидентов и непрерывного улучшения. Эффективная коммуникация между командами разработки, эксплуатации и бизнес-пользователями - ключ к успешной реализации проектов по большому данным.


