

Интеграция с аналитикой: Hive, Spark SQL, Presto/Trino
Современная Hadoop-экосистема строится на тесной связке между хранением больших данных и аналитическими движками. Глава посвящена тому, как выстраивать эффективную интеграцию между Hive, Spark SQL и федеративной аналитикой через Presto/Trino, как реализовать ETL-процессы с опорой на Hive-метаданные и как управлять форматами файлов и схемами в условиях растущего объема данных. Рассматриваются архитектурные паттерны, алгоритмы оптимизации, протоколы взаимодействия и реальные подходы к реализации на уровне кода и конфигурации.
Эта глава ориентирована на разработчиков ETL и Data Engineers, ответственных за консолидированную аналитическую среду: от моделирования архитектуры и выбора форматов файлов до настройки процессов загрузки данных и обеспечения наблюдаемости и безопасности.
Краткое содержание главы
- Архитектура интеграционной цепочки: как связаны хранение, метаданные и вычисления, какие роли играют Hive, Spark и Presto/Trino.
- Реализация ETL через Hive и Spark SQL: циклы загрузки, очистки, трансформаций, управление метаданными и схемами.
- Федеративная аналитика через Presto/Trino: принципы федерации, каталоги, оптимизация и сценарии совместного использования данных.
- Управление файловыми форматами и схемами: выбор Parquet/ORC/Avro, эволюция схем, партиционирование и хранение.
- Производительность, безопасность и мониторинг: принципы масштабирования, политики доступа, сбор метрик и наблюдаемость.
Архитектура интеграционной цепочки
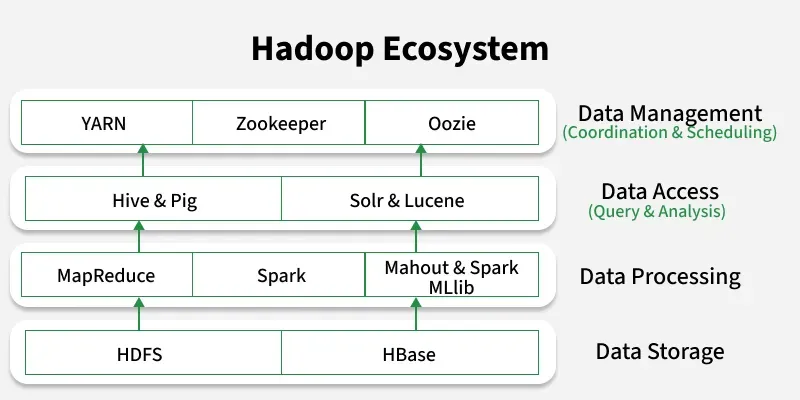
В состав интеграционной цепочки входят несколько ключевых компонентов, которые должны быть согласованы между собой, чтобы обеспечить надежную обработку больших данных и единое семантическое представление метаданных. В классической Hadoop-экосистеме слово “архитектура” понимается как баланс между хранением данных, вычислительной инфраструктурой и интерфейсами для аналитиков и разработчиков.
Основные элементы архитектуры:
- Хранилище и файловые форматы. Данные обычно размещаются в распределенном файловом хранилище (HDFS, а в облачных контурах - объектные хранилища вроде S3 или ADLS). После выбора форматов файлов предпочтительны колоночные форматы Parquet или ORC для аналитики: они обеспечивают эффективное считывание столбцов, компактное хранение и возможность использования схемы и статистики. Форматы зависят от характера обработки: Parquet хорошо подходит для чтения больших наборов столбцов и эффективной компрессии, ORC - для высокопроизводительных аналитических рабочих нагрузок и лучшей поддержки некоторых видов агрегаций.
- Метаданные и управление схемой. Hive Metastore выступает как единый каталог для всех потребителей данных. Это критично для координации между ETL-процессами, Spark SQL и федеративными движками. Метаданные включают определение таблиц, столбцов, типов данных, partitioning и связи с физическим расположением файлов.
- Вычислительная среда. Spark и Tez/YARN/Hadoop-кластеры обеспечивают вычислительную мощность. Spark можно использовать как мощный ETL-двигатель с поддержкой Hive и Spark SQL, позволяя писать преобразования в рамках единого склада метаданных. Для интерактивной аналитики часто применяется федеративная система запроса - Presto/Trino, которая обращается к источникам метаданных и данным через соответствующие коннекторы.
- Федеративная аналитика и интеграция запросов. Presto/Trino выступает как движок федеративного анализа, который может соединять данные из Hive Metastore, файловых систем и других источников. Архитектурно это позволяет пользователю писать запросы, которые работают над разными источниками без явного переноса данных.
- Безопасность и управление доступом. Kerberos для аутентификации, интеграция с сервисами по управлению политиками (например, Ranger/Atlas) и многоуровневые политики доступа на уровне файловой системы, таблиц и столбцов обеспечивают необходимый уровень защиты. Важно иметь централизованную аутентификацию, единый журнал аудита и возможность аудита операций над данными.
Почему так устроено именно так? Архитектура разделяет зоны ответственности: хранение - через устойчивое файловое хранилище; метаданные - через единый каталог; вычисления - через эластичную вычислительную среду; аналитика - через федеративные движки. Такой подход обеспечивает масштабируемость, гибкость и возможность автономного масштабирования компонентов без потери консистентности метаданных и схем.
Прежде чем переходить к реализации, следует привести к пониманию концепций схемной эволюции и совместного использования столбцовых форматов. При этом сохраняется принцип разделения между этапами: загрузка данных в хранение, подготовка и обогащение через ETL, аналитика во внешних и федеративных запросах. Архитектура должна поддерживать идемпотентность ETL-операций, возможность повторной загрузки без двойной записи и автоматическое обновление статистики таблиц.
Взаимодействие компонентов в реальном пайплайне может быть таким образом:
- Метаданные и каталог: Hive Metastore хранит схему и разделы таблиц; Spark использует его через HiveSupport для чтения и записи данных; Presto/Trino обращается к тем же метаданным для составления планов выполнения.
- Хранилище данных: данные хранятся в Parquet/ORC-файлах, разделенных по ключам (partition keys): например, по дате или региону.
- Внешний доступ: аналитики пишут запросы через Spark SQL на ETL-слой или через Presto/Trino для интерактивной аналитики, что позволяет избежать дублирования копий данных и поддерживать консистентность метаданных.
Алгоритмические и протокольные аспекты взаимодействия здесь отражают принципы открытого стандарта и совместимости между движками. В частности, согласованный формат метаданных, корректная работа с транзакциями Hive (если поддерживается версией и форматом) и минимизация расхода на конвертацию форматов являются критическими аспектами производительности и надежности.
Интеграция Hive и Spark SQL: реализация ETL
KV-основа ETL-процессов в Hadoop-ландшафте - это бережное использование возможностей Hive как каталога и Spark как вычислительного движка. В рамках этого раздела рассматриваются паттерны реализации ETL, которые обеспечивают согласованность, идемпотентность и контроль качества данных.
Рабочий цикл ETL
- Ингестинг данных. В зависимости от источника данные могут поступать пакетно или в стримовом режиме. В любом случае загрузка должна сохранять исходную структуру и позволять последующую трансформацию без потери данных.
- Очистка и нормализация. На этапе очистки избавляются от дубликатов, пропусков и неконсистентных значений. Нормализация типов, привязка к согласованной схеме и привязка к partitioning-ключам формируют основу для эффективного чтения.
- Обогащение и агрегации. Привязка данных к внешним справочникам, расчет бизнес-метрик, создание датасетов для аналитики. Часто применяется разделение на факторный ETL и агрегационные слои, чтобы минимизировать переменные зависимости и ускорить повторное использование результатов.
- Верификация качества. Проверки целостности, ограничения, валидации бизнес-правил или сигнатурные тесты. В идеале данные проходят через тестовую лавку и только затем попадают в хранилище аналитического слоя.
- Загрузка в целевые таблицы Hive. Результаты записываются в Hive-таблицы (или во внешние таблицы, указывающие на Parquet/ORC-файлы), часто с динамическим партиционированием и управлением схемой.
Паттерны реализации
- Динамическое партиционирование. Выделение разделов по дате или другим ключам позволяет избежать полного сканирования и ускоряет чтение. В Spark SQL динамическое партиционирование может быть включено через настройки Spark и параллельное создание разделов на этапе записи.
- Запись через saveAsTable. Это позволяет сохранять результат прямо в Hive-таблицы и поддерживать единый каталог. При необходимости можно писать в существующие таблицы или создавать новые, опираясь на управляемые схемы.
- Управление схемой на запись. В большинстве случаев схема пишется заранее, но полезны возможности эволюции схемы. Hive (и соответствующие версии Spark) поддерживают добавление новых столбцов без миграции уже существующих данных, что особенно важно при частых изменениях требований к данным.
- Валидация данных на входе и выходе. Включение проверок схемы и валидаторов на этапе ETL, включая проверки уникальности, типов и вычисляемых метрик, обеспечивает устойчивость пайплайна.
Примеры реализуемых практик
-
Использование SparkSession с поддержкой Hive для объединения вычислений и метаданных:
// Scala import org.apache.spark.sql.SparkSession val spark = SparkSession.builder() .appName("ETL-Hive-Spark") .enableHiveSupport() .getOrCreate() spark.sql("USE default") // загрузка сырых данных val df = spark.read.parquet("hdfs://cluster/raw/events") // очистка и трансформации val cleaned = df.filter("event_type IS NOT NULL") .select("event_time", "user_id", "event_type", "properties") // запись в Hive-таблицу cleaned.write.mode("overwrite").saveAsTable("analytics.cleaned_events") -
Как вариант, работа через временные представления и промежуточные копии. Подход позволяет строго отделить стадии обработки, упростить отладку и обеспечить повторную попытку загрузки без дубликатов.
-
Конфигурация Hive и Spark. В практиках настройки часто включают параметры, влияющие на производительность и согласованность:
// Пример настройки Spark для Hive spark.conf.set("spark.sql.hive.metastore.version", "3.1.0") spark.conf.set("spark.sql.hive.metastore.jdbc.url", "jdbc:mysql://metastore-host:3306/hive?useSSL=false") -
В части архитектуры стоит предусмотреть план A/B для различных стратегий загрузки, например, миграцию со старой схемы на новую через временные таблицы и постепенный трафик.
Преимущества такого подхода очевидны: единая точка входа для трансформаций, консистентность метаданных и возможность повторного воспроизведения pipeline в случае ошибок. Эффективная работа с Hive Metastore как источником vérité позволяет избежать рассинхронов между теми данными, которые читаются Spark-ом, и теми, которые доступны через внешний анализ через Presto/Trino.
Аналитика через Presto/Trino
Presto (Trino) представляет собой федеративную аналитическую систему, позволяющую выполнять интерактивные запросы над несколькими источниками данных без их физического перемещения. В контексте Hadoop-экосистемы Presto/Trino выступает как дополнительный слой поверх Hive Metastore и файлового хранилища, обеспечивая быстрый доступ к данным и объединение данных из разных источников.
Ключевые концепты:
- Каталоги и коннекторы. Presto/Trino используют каталоги конфигураций, где каждый каталог описывает коннектор и параметры доступа к источникам. В контексте Hadoop наиболее часто применяются коннекторы Hive и HDFS/S3. Каталог Hive позволяет Presto/Trino «видеть» Hive Metastore и работать с теми же таблицами, что и Spark SQL.
- Федеративная аналитика. Запросы могут объединять данные из разных баз и файловых систем. Это особенно полезно при наличии разделения зон ответственности: warehouse-данные в Hive и оперативные данные в других источниках (например, S3-аккумуляторы или потоковые данные).
- Производительность. Presto/Trino оптимизируют выполнение запросов через распределенную архитектуру, параллелизацию и эффективные планы чтения, что позволяет достичь близкой к серии интерактивной задержки при больших объемах данных.
Пример конфигурации и типовых сценариев
-
Каталог Hive для Presto/Trino:
## Пример каталога для Presto/Trino (catalog/hive.properties)
connector.name=hive
hive.metastore.uri=thrift://metastore-host:9083
-
Пример выполнения запроса из аналитической панели:
SELECT c.region, COUNT(*) AS visits
## FROM hive.default.visits v
JOIN hive.default.cities c ON v.city_id = c.id
WHERE v.visit_date >= DATE '2024-01-01'
GROUP BY c.region;
-
Архитектурные принципы. Важное преимущество федеративной аналитики - возможность не копировать данные для каждого источника, а выполнять вычисления на стороне источников и агрегировать результаты сверху. В реальной эксплуатации критично обеспечить корректный доступ к данным, единые политики безопасности и согласование времени обновления статистики для всех источников.
Роль Presto/Trino в рамках данной главы - это не замена Hive или Spark, а дополнительный слой для интерактивной аналитики и кросс-системной агрегации. Правильная настройка каталога и грамотная постановка вопросов к данным позволяют снизить задержки и повысить точность бизнес-аналитики за счет единой точки доступа.
Управление формами файлов и схемами
Эффективная работа с большими данными требует не только вычислительных мощностей, но и продуманной стратегии хранения и схемы данных. В рамках интеграции Hive, Spark SQL и Presto/Trino важно определить, какие форматы файлов использовать в зависимости от требований к прочности, скорости чтения и эволюции данных.
Основные принципы:
- Выбор форматов. Parquet и ORC являются основными формами для аналитики. Parquet обеспечивает эффективное считывание по столбцам и хорошую компрессию, что особенно важно при больших объемах данных. ORC часто хорошо работает в сочетании с Hive и Spark благодаря эффективной реализации счетчиков и поддержки современных функций.
- Эволюция схемы. Hive 3.x улучшает поддержку схемной эволюции: добавление столбцов без изменения данных, упреждающая проверка типов и миграции. Важно планировать эволюцию схем через временные версии таблиц и поддерживать совместимость чтения старых данных.
- Партиционирование. Партиционирование по ключам времени, регионам и другим релевантным признакам позволяет ускорить чтение, снизить стоимость сканирования и улучшить производительность аналитических запросов. В Spark и Presto/Trino следует внимательно управлять метаданными partitioning и обновлять статистику таблиц.
- Совместное использование таблиц. Таблицы в Hive можно объявлять как внешние, чтобы указать на данные в файловой системе без копирования. Это упрощает управление данными и позволяет разделять ответственность между различными пайплайнами и приложениями.
Практические примеры
-
Создание внешней таблицы с Parquet:
CREATE EXTERNAL TABLE analytics.cleaned_events ( event_time TIMESTAMP, user_id STRING, event_type STRING, properties MAP<STRING, STRING> ) STORED AS PARQUET ## PARTITIONED BY (dt STRING) LOCATION 'hdfs://cluster/analytics/cleaned_events'; -
Пример добавления новой колонки через эволюцию схемы без миграции существующих данных:
// В Hive можно использовать ALTER TABLE ADD COLUMNS ALTER TABLE analytics.cleaned_events ADD COLUMNS (device STRING); -
Архитектурное соотношение между форматами и типами загрузки: For стриминга часто выбирают Avro или JSON на входной скорости и затем конвертацию в Parquet/ORC на этапе сохранения в аналитические таблицы. Это обеспечивает гибкость источников и эффективную аналитическую доступность.
Управление схемой и качеством данных
- Внесение изменений схемы - это не просто добавление столбцов. Нужно учитывать влияние на существующие пайплайны, совместимость запросов и влияние на производительность. В реальных практиках рекомендуется вести версионирование схем и внедрять миграции через координацию ETL-слоев и аналитических слоёв.
- Контроль качества. Встроенные проверки целостности, уникальности, корректности типов и валидации бизнес-логики должны быть частью ETL-процессов. Работа через тестовые окружения, где можно повторно воспроизвести загрузку и анализ, существенно снижает риски.
Производительность, безопасность и мониторинг
Производительность аналитических пайплайнов напрямую зависит от согласованности между форматом данных, планированием запросов и качеством метаданных. В этой секции рассмотрены принципы обеспечения устойчивой производительности, а также вопросы безопасности и мониторинга.
Производительность
- Статистика таблиц и анализ выполнения. Регулярное обновление статистики таблиц (ANALYZE TABLE) позволяет планировщикам запросов строить более эффективные планы исполнения.
- Векторизация и пропуск столбцов. В Parquet/ORC активно применяются векторизированные движки чтения, что ускоряет сканирование. Следует включать соответствующие параметры в Spark и Presto/Trino для максимизации преимуществ.
- Механизм динамического удаления и партиционирование. Правильное партиционирование и pruning позволяют исключать целые разделы данных из сканирования, сокращая задержки и ресурсы.
- Кэширование и повторное использование результатов. Spark поддерживает кэширование DataFrame в памяти, что особенно полезно для повторных запросов. В Presto/Trino следует оптимизировать память и настройку коннекторов для эффективной работы с большими данными.
Безопасность
- Аутентификация и авторизация. Kerberos как базовый механизм аутентификации и интеграция с политиками доступа на уровне Hive, файловой системы и вычислительных узлов.
- Контроль доступа по данным. Ranger/Atlas или аналогичные решения позволяют управлять доступом на уровне таблиц, столбцов и операций, обеспечивая соответствие требованиям комплаенса.
- Защита канала и аудит. Шифрование и аудит доступа к данным, журналирование выполнения запросов и операций ETL - критически важны для выявления аномалий и соблюдения регуляторных требований.
Наблюдаемость и мониторинг
- Метрики и телеметрия. Важна централизованная панель мониторинга, которая собирает метрики из Hive Metastore, Spark, Presto/Trino и файловой системы. Включение OpenTelemetry или эквивалентных инструментов упрощает трассировку и отладку.
- Логи и трассировка. Встроенные логи выполнения запросов и ETL-операций дают возможность в реальном времени реагировать на сбои, а также проводить постмортем-аналитику.
- Лайфтаймы и SLA. Установка целей по времени обработки для ETL и аналитических запросов помогает определить узкие места и планировать масштабирование кластера.
Key takeaways
- Эффективная интеграция Hive, Spark SQL и Presto/Trino требует единых метаданных, согласованных форматов и хорошо продуманной архитектуры вычислений.
- Hive Metastore обеспечивает консистентность схем и разделов, что критично для одновременного использования Spark и Presto/Trino.
- Parquet и ORC - базовые форматы для аналитики; эволюция схем и корректное партиционирование позволяют удерживать качество и производительность по мере роста данных.
- ETL-процессы должны быть идемпотентными и поддерживать повторную загрузку без дубликатов, используя единый каталог и управляемые DAG-подходы.
- Федеративная аналитика через Presto/Trino сокращает задержки и позволяет интегрировать данные из разных источников без копирования.
- Безопасность и аудит должны быть встроены в каждый слой: аутентификация, управление доступом, шифрование и мониторинг.
- Наблюдаемость и статистика таблиц являются краеугольными камнями производительности: регулярно обновляйте статистику, контролируйте планы выполнения и мониторьте сквозные задержки.
- При проектировании архитектуры следует соблюдать баланс между функциональностью и простотой эксплуатации, учитывая требования бизнес-аналитики, регуляторные ограничения и возможности масштаба.
FAQ
- Как выбрать между Spark и Presto/Trino для аналитики в рамках Hadoop-архитектуры?
- Spark эффективен как ETL-движок: он поддерживает гибкую логику трансформаций, сложную очистку и обогащение данных, использовать его целесообразно на стадии подготовки данных и сохранения их в Hive-таблицах. Presto/Trino же оптимален для интерактивной и федеративной аналитики, когда требуется объединение данных из Hive и других источников без перемещения данных. Комбинация: Spark для пакетной подготовки и Hive-sущественных метаданных, Presto/Trino - для интерактивной аналитики над единым каталогом и файловой системой.
- Как обеспечить согласованность между ETL и аналитикой?
- Важнейшее условие - единый каталог метаданных (Hive MetaStore) и согласованные версии схем. ETL-процессы должны обновлять статистику таблиц и поддерживать совместную версию таблиц с аналитическими системами. Выстраивайте пайплайны так, чтобы изменения схемы проходили через контролируемые миграции и тестовые окружения, а аналитика читала данные по тем же версиям схем.
- Какие принципы использовать для эволюции схем?
- Принципы минимального воздействия: добавление столбцов без удаления существующих, версияция схем (например, через суффиксы таблиц или свойства таблиц), поддержка нескольких версий таблиц на ход. В Hive и Spark используются механизмы совместимости типов и перехода между версиями через миграции и тестирование.
- Какие форматы файлов выбрать для разных сценариев?
- Parquet - общий выбор для аналитики, благодаря эффективному сквозному считыванию. ORC - хорош для больших потоков и агрегаций в Hive. Avro - полезен для стриминга и схем с частой изменяемостью. Выбор зависит от характера нагрузки, требований к латентности и совместимости между компонентами.
- Какие меры наблюдаемости стоит внедрить?
- Включение метрик выполнения запросов, нагрузки на кластер, статистики таблиц и времени выполнения ETL-операций. Настройка логирования и трассировки (OpenTelemetry или аналог) для полного цикла от ingest до аналитики. Единая панель мониторинга для всех компонентов (Hive, Spark, Presto/Trino, хранилище) упрощает идентификацию узких мест.
- Как обеспечить безопасность в гибридной аналитике?
- Реализация единых политик доступа через Kerberos, интеграцию с Ranger/Atlas или аналогичными системами, разграничение прав на уровне таблиц и столбцов, аудит действий и шифрование на каналах передачи и хранении. Важно поддерживать принцип минимальных привилегий и постоянный аудит соответствия требованиям регуляторов.
- Какие типичные ошибки встречаются на старте интеграции?
- Недостаточное управление схемами и слабая согласованность между различными потребителями метаданных. Игнорирование требований к партиционированию и форматам может привести к хаосу и низкой производительности. Неправильная настройка безопасности и отсутствующий аудит также создают риски. Важно реализовать единый каталог, продумать стратегию миграций и выстроить процедуры мониторинга.
- Как масштабировать интеграцию на практическом уровне?
- Разделение ролей между ETL и аналитикой, горизонтальное масштабирование кластера, грамотное использование кэширования и вычислительных ресурсов. Вводите поэтапное разворачивание и пилоты, чтобы проверить влияние изменений на производительность и устойчивость пайплайнов. Не забывайте об автоматическом обновлении статистики и мониторинге латентности.
- Какую роль играет хранение в облаке и локальные решения в контексте интеграции Hive, Spark и Presto/Trino?
- Облачные хранилища упростят масштабирование и доступность внешней инфраструктуры, однако требуют согласованных политик безопасности и дорогих сетевых задержек если данные читаются из разных локаций. Локальные кластеры дают большую управляемость и стабильность, но ограничивают масштаб. В большинстве сценариев выбирают гибрид: критические данные локально, архивы и редко используемые наборы - в облаке, с федеративной аналитикой для единого доступа.
- Как минимизировать риск ошибок при миграции и обновлении версий?
- Планируйте миграции через промежуточные этапы, создайте тестовую копию данных и окружение для воспроизведения ошибок, используйте версионирование схем и совместимый режим чтения/записи, применяйте контроль версий конфигураций и автоматизированные проверки на целостность данных.
Эта глава охватывает архитектурные паттерны, реализацию ETL-процессов, конфигурации и сценарии использования Hive, Spark SQL и федеративной аналитики через Presto/Trino. Важное место занимает выбор форматов данных, эволюция схем и обеспечение безопасности и наблюдаемости в условиях больших данных. Реализация в больших системах требует комплексного подхода: четкой координации между хранением, метаданными и вычислениями, дисциплины в конфигурациях и постоянного контроля качества и производительности.


