

Производительность, профилирование и тестирование: методики измерения и улучшения
Polars как движок для аналитических вычислений опирается на современную архитектуру столбцовых данных, параллелизм и эффективное управление памятью. В условиях крупных данных и сложных вычислений именно грамотная стратегия профилирования и тестирования определяет реальную скорость бизнес-операций и качество аналитики. Эта глава развивает системный подход к измерению производительности Polars в рамках аналитических платформ: от архитектурных основ до конкретных методик тестирования и внедрения оптимизаций в продакшн-среды.
Polars на стыке Rust-ядра и Python-интерфейса обеспечивает высокую скорость благодаря ленивому вычислению, оптимизированной схеме хранения в памяти и эффективному параллелизму. Однако реальная производительность зависит не только от отдельных операций, но и от конвейеров, формата данных, конкретных рабочих нагрузок и среды исполнения. В рамках данного материала приводятся принципы профилирования, методики мониторинга и пошаговые подходы к внедрению оптимизаций в data platform: как проектировать тестовые сценарии, какие метрики использовать, какие инструменты применить и как корректно сравнивать результаты между версиями и окружениями.
Краткое содержание главы
- Архитектурные основы производительности Polars и влияние планирования запросов на скорость исполнения.
- Методы профилирования: как формулировать гипотезы, какие показатели собирать и как интерпретировать профили.
- Интеграция Polars в data platform: конвейеры, кэширование, взаимодействие с данными и вычислительным слоем.
- Практические методики тестирования производительности: конструкторы нагрузок, репродуцируемость, регрессионное тестирование.
- Рекомендации по оптимизации: архитектура конвейеров, режимы выполнения, настройки Polars и типизация данных.
Архитектурные основы производительности Polars
Polars строится на столбцовой памяти и параллельном исполнении, что критически важно для аналитических задач с агрегациями, группировками и сложными выражениями. Ядро реализовано на Rust и опирается на принципы Arrow-совместимости, что обеспечивает эффективную нотацию памяти и обмен между компонентами. Основные архитектурные принципы, влияющие на производительность, включают:
- Столбцовая организация данных. Данные хранятся в колонках, что облегчает векторизацию и эффективное использование кэш-памяти. Для типов данных выбираются представления, минимизирующие упаковку и позволящие SIMD-операции.
- Векторизация и SIMD. Операторы работают пакетно над векторами значений, что снижает число инструкций и ускоряет вычисления по сравнению с построчным подходом.
- Параллелизм на уровне CPU. Polars распараллеливает обработку по нескольким потокам, что особенно заметно при больших наборах данных и агрегациях. Эффективность зависит от распределения workload и баланса между вычислениями и памятью.
- Ленивое вычисление и fusion. В LazyFrame выражения формируют граф вычислений, который затем компилируется в единый план выполнения. Это позволяет устранить промежуточные матеріалы и объединить операции, что уменьшает временные и память-расходы.
- Прозрачная интеграция с Arrow. Совместимость с Arrow обеспечивает fast-pathы копирования и совместное использование буферов между компонентами, снижая накладные расходы на конвертации.
- Управление памятью и аллокацией. В реальных конвейерах память может стать узким местом. Эффективная стратегия allocation и освобождения, а также разумное использование типов данных и фрагментации памяти снижают задержки и пиковые потребления.
Понимание этих принципов позволяет формулировать гипотезы и планировать профилирование именно по узким местам конвейера. В частности, в продакшн-сценариях часто выявляются компромиссы между ленивостью и надоевшей сборкой промежуточных результатов: слишком агрессивная ленивая стратегия может привести к задержкам на стадии materialization в конце конвейера, тогда как излишняя materialization увеличивает потребляемую память и снижает Throughput. Практический подход состоит в выборе баланса между ленивым планированием и явной эвристикой для конкретных нагрузок: фильтрации, группировок и соединений.
Подходы к планированию и оптимизации выражений в Polars тесно переплетаются с архитектурой.predicate pushdown и projection pushdown позволяют исключить из расчетов данные на ранних стадиях конвейера. В сочетании с эффективной реализацией группировок и агрегаций это приводит к значительному снижению объема обработанных данных и ускорению ответов.
Внедрение в data platform требует дополнительной дисциплины: совместное использование форматов данных (Parquet, IPC), контроль над размерами чанков и количеством потоков, правильное размещение вычислительного слоя ближе к источнику данных и минимизация IO-станций. Важной практикой является понятие «путь данных» - от источника до результата, где каждый переход между этапами должен быть оптимизирован с учетом профилей памяти и временем доступа.
Планирование памяти и управления нагрузкой
Эффективность Polars во многом зависит от того, как распределены данные по памяти и как происходят копирования между процессами. В практике staged-процессов полезно:
- Размечать данные по типам и минимизировать приводку к широким типам (например, использование минимально достаточного дробления типов int/float, избегать чрезмерного преобразования типов).
- Поддерживать разумное число активных чанков, чтобы не перегружать кэш-память и не вызывать частые свопы.
- Контролировать параметры параллелизма: слишком агрессивная распараллеливание может усилить конкуренцию за CPU и память, тогда как слишком консервативная настройка может недоиспользовать доступные ресурсы.
Эти принципы особенно важны в смешанных рабочих нагрузках: интерактивная аналитика рядом с периодическими пакетными задачами. Глубокое понимание архитектуры позволяет предвидеть поведение системы при изменении объема данных, структуры запросов и доступных ресурсов.
import polars as pl

## Пример ленивого конвейера: фильтрация -> проекция -> агрегация
lf = pl.scan_csv("events_large.csv") \
        .filter(pl.col("country") == "RU") \
        .select(["user_id","event_type","timestamp"]) \
        .with_columns([
            pl.col("timestamp").cast(pl.Datetime)
        ])

## Исполнение конвейера
df = lf.collect()
Данный пример демонстрирует типичный ленивый конвейер с фильтрацией и проекцией, после чего выполняется вычисление. В реальных конфигурациях необходима настройка параметров чтения, размера чанков и уровня параллелизма в зависимости от доступной памяти и CPU.
Методы профилирования
Профилирование производительности в Polars следует рассматривать как системный процесс: от характерного поведения отдельной операции до поведения конвейера в рамках данных и окружения. В практическом контексте это означает систематическую работу по сбору и анализу метрик, постановку гипотез и последовательное введение изменений, которые затем проверяются повторным тестированием.
Ключевые принципы профилирования:
- Определение целевых KPI: сквозная пропускная способность (throughput), задержка (latency) на разных квантилях, потребление памяти, накладные расходы на IO, время «hot paths» в вычислениях.
- Разделение профилирования на уровни: локальные узкие места (конкретная операция), среда выполнения (план выполнения, распараллеливание), инфраструктура (IO, диск, сеть).
- Использование ленивого профиля. Анализ графа зависимостей и fusion-оптимизаций. Сбалансированное использование ленивого выполнения против явной materialization.
- Сопоставление с реальными сценариями. Плотные тестовые наборы должны воспроизводить типичные нагрузки: фильтрация по датам, группировки по нескольким колонкам, соединения и внешние агрегации, обработка больших Parquet-файлов.
Инструменты и подходы
- Внутренние профилировщики языка/библиотеки. Для Python-посредника это часто py-spy, cProfile, timeit для отдельных блоков кода. Для Rust-ядра полируется на системном уровне с использованием perf или perfetto.
- Системные профилировщики. perf, dtrace/eBPF-решения позволяют отслеживать CPU-циклои, пропуски кэш-памяти, I/O-перебои, мусор в памяти, аллокацию.
- Профилирование памяти. tracemalloc (Python), valgrind/memcheck, а в Rust - инструменты для анализа аллокаций. В сценариях Polars важно выявлять утечки памяти при больших данных и при повторном чтении файлов.
- Мониторинг и трассировка транзакций на уровне data platform. Включение распределённых traces (OpenTelemetry) позволяет учесть время ожидания между компонентами конвейера и узкими местами слоёв взаимодействия.
- Бенчмарки и регрессионные тесты. Включение микро-бенчмарков в CI и попытки запускать их на чистой системе позволяют отслеживать регрессию производительности.
Практический пример профилирования
Чтобы понять влияние конкретной операции, полезно зафиксировать время выполнения при разных сценариях. Ниже приведён упрощённый пример для ленивого конвейера Polars в Python, где мы измеряем время выполнения сложной фильтрации и агрегации.
import polars as pl
import time

df = pl.read_csv("events_large.csv")

start = time.perf_counter()
## ленивый конвейер
lf = pl.scan_csv("events_large.csv").filter(pl.col("country") == "RU").groupby("user_id").agg(pl.col("value").sum())
## исполнение
result = lf.collect()
end = time.perf_counter()

print("Elapsed:", end - start)
Далее можно расширить этот пример двумя способами: (1) повторить с разными разделами данных, (2) дополнительно включить py-spy для профилирования CPU во время выполнения, чтобы увидеть узкие места. Результаты профилей позволяют формулировать гипотезы: может потребоваться снижение числа чанков, переработка схемы агрегаций или изменение выбора типов данных. Важно фиксировать окружение и настройки: версия Polars, размер данных, количество потоков и т. п. Только в сочетании с воспроизводимостью такие тесты дают надёжную картину изменений.
Инструменты профилирования в рамках data platform
- py-spy для живого профилирования Python-обёрток над Polars и для идентификации горячих путей.
- perf и perf record для низкоуровневого профилирования CPU и кэш-уровней.
- eBPF-аналитика (например, bpftrace) для наблюдения за системной активностью в контейнерах и оркестраторах.
- Визуализация профилей через flame graphs и аналогичные подходы для быстрого определения hot paths.
Важно помнить: цель профилирования - не «снять ярлык» на одну медленную операцию, а увидеть целостный конвейер, где узкое место может появляться на стыке нескольких этапов, например, из-за перегрузки IO, частых конвертаций типов или неэффективного планирования памяти.
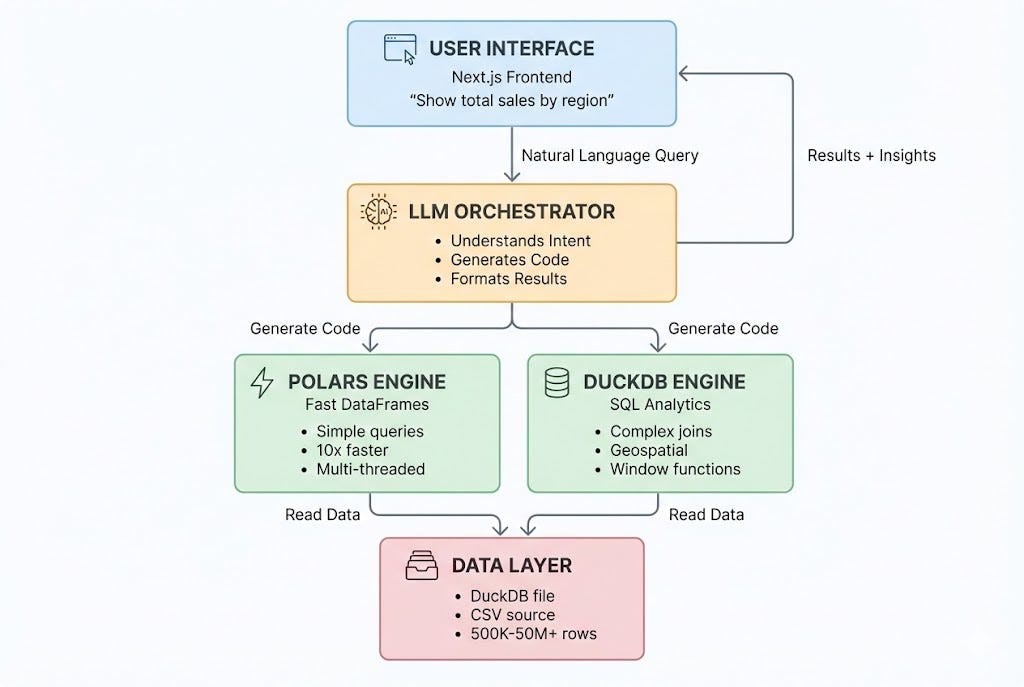
Интеграция Polars в data platform
Интеграция Polars в data platform требует аккуратного проектирования конвейеров, выбора форматов данных и управления вычислительным слоем. Основные сценарии включают:
- Batch-аналитика на основе параллельной обработки. Привязка Polars к источникам Parquet/IPC-данных и кэширование результатов на уровне горячих подконвейеров.
- Интерактивная аналитика и ноутбуки. Прямой доступ к Polars через LazyFrame в аналитических сессиях, где важна скорость старта и повторная инициализация конвейера.
- Интеграция в ELT/ETL. Polars выступает в роли движка вычислений на стадии подготовки данных: фильтрации, агрегации, формирование материалов и ускорение подготовительных этапов.
Ключевые принципы интеграции:
- Выбор форматов данных и формат-оптимизация. Parquet поддерживает эффективную компрессию и столбцовую схему, что позволяет минимизировать I/O и ускорить фильтрацию. В контексте Polars важна совместимость с Arrow и эффективные конверсии между представлениями данных.
- Разделение вычислений и хранения. Вычислительная часть на Polars должна располагаться ближе к источнику данных или к месту, где данные уже находятся в наборах, минимизируя задержку копирования и распаковки.
- Кэширование и повторное использование результатов. В рамках data platform целесообразно кэшировать промежуточные результаты там, где это снижает общую задержку и повторно используемые конвейеры.
- Оркестрация и мониторинг. Инструменты оркестрации (Dagster, Apache Airflow, Prefect) должны учитывать профиль производительности Polars, включая задержки и потребление ресурсов. Мониторинг на уровне метрик выполнения и времени выполнения отдельных задач позволяет своевременно выявлять регрессию.
В рамках интеграции часто встречаются два паттерна: (1) конвейер строгой batch-аналитики, где Polars выполняет тяжелые вычисления на больших наборах данных, и (2) интерактивная аналитика, где Polars отвечает за быстрый отклик на запросы в ноутбуках и BI-инструментах. Также следует рассмотреть вариативность нагрузки: утренние пики, ночные пакетные задачи и спайк-режимы, когда необходимо адаптивно менять количество потоков и планы исполнения.
Пример сценария интеграции
- Исходные данные из Data Lake в формате Parquet.
- Инжиниринг ETL: Polars оборачивает процесс фильтрации, агрегации и раннего проецирования столбцов.
- Materialized view для часто используемых агрегаций, которые обновляются по расписанию.
- Аналитическая платформа с API-запросами к Polars и кэшируемым результатам для повторяющихся сценариев.
Избежание ошибок интеграции:
- Не допускать неоднозначной конвертации типов между источниками и Polars, особенно дат/времен и числовых типов. Непредсказуемые конвертации приводят к лишним затратам на преобразования и помехам в планировании.
- Обеспечивать согласованность версий зависимостей между компонентами (Polars, формат данных, прокси-слой). Разные версии могут приводить к несовместимостям и снижению производительности.
- Управлять ресурсами на уровне контейнеров: число потоков, лимиты памяти, лимиты CPU. Неправильная конфигурация может привести к деградации производительности и нестабильности.
Практические методики тестирования производительности
Тестирование производительности должно быть систематическим и повторяемым. Основные шаги:
- Формулировка цели. Определение конкретной нагрузки, которая отражает реальные сценарии: объем данных, распределение значений, характер запросов (фильтры, соединения, группировки).
- Репродукционная среда. Воспроизводимость нагрузки: одинаковое оборудование, те же версии ПО, одинаковые параметры запуска. Применение CI-пайплайна с регрессионными тестами производительности.
- Бенчмарки и сценарии. Разработка набора сценариев: от простых фильтров до сложной агрегации и JOIN. Включение элементов реальной бизнес-логики для повышения валидности тестов.
- Метрики. Включение детальных метрик: latency distributions (p50, p95, p99), throughput, memory footprint, GC-паузы (если применимо), IO-операции, CPU-usage, количество создаваемых объектов.
- Анализ и итерации. После каждого цикла тестирования формулируются гипотезы об узких местах и внедряются изменения. Затем повторное тестирование подтверждает эффект и помогает определить влияние на другие сценарии.
Ключевые подходы к тестированию
- Бенчмаркинг на близких к продакшену данных. Использование реальных наборов данных в тестовой среде позволяет точнее прогнозировать поведение в проде.
- Регрессионное тестирование производительности. В течение CI каждый прогон тестов сравнивает текущие показатели с базовыми. При отклонении более чем заданного порога выполняются дополнительные проверки.
- Вариативность нагрузок. Включение сценариев с разными параметрами: размер данных, число столбцов, типы агрегаций, размер выборки, количество соединений.
- Непрерывность профилирования. Встроенные мониторинги временных характеристик (периодические выборки по трассам, сбор метрик) позволяют быстро выявлять деградацию.
Практический аспект для продакшена
- Определять пороги и окна для оценки производительности. Например, в интерактивной аналитике цель - latency под 500 мс в 95-м процентиле; для пакетной обработки - throughput не менее заданного объема строк в секунду.
- Вносить изменения порциями. Каждое изменение должно быть изолировано и проверяемо. Нельзя полагаться на единичный эксперимент.
- Включать стресс-тесты. Проверка устойчивости к пиковым нагрузкам и резким изменениям в нагрузке - критически для зрелой data platform.
Оптимизации и практические рекомендации
Оптимизация производительности начинается с архитектурного анализа и заканчивается тонкой настройкой параметров исполнения и данных. Ниже приводятся основные принципы, которые применяются на практике:
- Проектирование конвейера с фокусом на фильтрацию и раннюю проекцию. Чем раньше в конвейере применяются фильтры и выбор под нужные столбцы, тем меньше обрабатывается данных и тем выше Throughput.
- Использование ленивого режима и fusion-оптимизаций. Ленивый граф вычислений даёт возможность объединять операции и исключать промежуточные копирования. В продакшене следует внимательно отслеживать влияние fusion на задержку и потребление памяти.
- Правильная типизация данных. Выбор минимально достаточных типов и избегание непредсказуемых конвертаций может сильно снизить CPU-расходы и объем памяти.
- Управление числом потоков. Полезно динамически подстраивать число активных потоков под текущую загрузку и доступные ресурсы. В некоторых средах разумно фиксировать количество потоков на уровне контейнера или узла, чтобы исключить перегрузку.
- Выбор форматов и кэширование. Parquet обеспечивает эффективное хранение и быстрый доступ к колонкам. Использование кэшей и повторного использования вычислений снижает нагрузку на вычислительный слой.
- Оптимизация Join и группировок. Выбор порядка выполнения, распределение данных и использование локальных агрегаций может существенно повлиять на производительность при больших объемах.
- Мониторинг и обратная связь. Встроенные метрики, сборки профилей и инструментальные логи должны использоваться для постоянного мониторинга и корректировки конвейеров.
Рассмотрение частых кейсов
- Кейс 1: Большой Parquet-файл с ограниченной памятью. Решение: ленивые конвейеры, проекция только необходимых столбцов, фильтрация на ранних стадиях, возможно разбиение данных на чанки и параллельная обработка.
- Кейс 2: Частые агрегации по нескольким измерениям. Решение: использование эффективных группировок, предвычисленных индексов и, при необходимости, материализации часто используемых агрегатов.
- Кейс 3: Интеграция в интерактивную аналитику. Решение: баланс между скоростью старта и глубиной анализа, подготовка небольших, быстрых подконвейеров для общих сценариев и более глубоких аналитических цепочек для продвинутых запросов.
## Пример простой конфигурации ленивого конвейера с несколькими операциями
import polars as pl

lf = pl.scan_csv("big_data.csv").filter(pl.col("sales") > 100).select(["date","region","sales"])
df = lf.collect()
Такой подход демонстрирует режим работы Polars в реальной среде: ленивый план, фильтрация и проекция, затем материалицация для выдачи результата. В реальной системе этой конфигурации обычно сопутствуют дополнительные параметры: управление числом потоков, использование кэширования, настройка форматов данных.
Key takeaways
- Архитектура Polars и ленивое вычисление существенно влияют на производительность аналитических конвейеров; эффективное планирование и fusion уменьшают объем обрабатываемых данных.
- Профилирование должно быть системным: от локальных hot paths к общему конвейеру; акцент делается на повторяемость сценариев и воспроизводимость окружения.
- Интеграция Polars в data platform требует грамотного выбора форматов данных, кэширования и архитектурного размещения вычислений близко к источникам данных.
- Практические методики тестирования включают формулировку целей, репродукцию нагрузки, детальные метрики и непрерывное регрессионное тестирование.
- Оптимизации на уровне запросов и конфигураций должны осуществляться по принципу 80/20: зафиксировать наиболее часто встречающиеся сценарии и соответственно настроить ленивое выполнение, типизацию и параллелизм.
- Важно поддерживать прозрачность изменений: документировать гипотезы, результаты профилирования и принятые решения; это облегчает поддержание и эволюцию аналитической платформы.
- Мониторинг в продакшене должен быть неразрывной частью конвейера: сбор метрик, трассировка временных задержек и регулярные повторные тестирования после обновлений.
FAQ
- Вопрос: Какие KPI считаются основными для оценки производительности Polars в аналитических конвейерах?
Основные KPI включают latency (p50, p95, p99), throughput (количество обработанных строк в секунду), потребление памяти и аллокации, IO-накладные расходы, время выполнения ленивых графов и время запуска интерактивных запросов. В зависимости от сценария могут добавляться метрики по времени подготовки данных, количеству созданных объектов и степени конвейера.
- Вопрос: Какую роль играет ленивое выполнение в производительности Polars?
Ленивое выполнение позволяет объединить несколько операций в единый граф и избежать промежуточного materialization. Это снижает объем данных, которые нужно передать по конвейеру и уменьшает время выполнения. Однако в некоторых сценариях явная materialization может быть полезной для контроля памяти и уменьшения пиковых задержек, поэтому стоит тестировать оба режима.
- Вопрос: Какие инструменты профилирования рекомендуется использовать для Polars в Python?
Для Python-переброски - py-spy и cProfile; для системного профилирования - perf и perfetto; для анализа памяти - tracemalloc и инструментальные средства в среде исполнения. В рамках продакшена полезно внедрить OpenTelemetry для трассировки распределённых операций.
- Вопрос: Как выбирать формат данных и режим загрузки при интеграции Polars в data platform?
Формат Parquet обеспечивает эффективное хранение и быстрый доступ к столбцам; IPC-форматы могут быть полезны для передачи между сервисами. Важно минимизировать копирования и конвертации между форматами, использовать ленивые конвейеры, а при необходимости - кэшировать часто используемые результаты.
- Вопрос: Как минимизировать влияние IO на производительность?
Сфокусируйтесь на проекции нужных столбцов и фильтрацию данных на ранних стадиях, используйте колоночные форматы, разрезайте данные на чанки подходящего размера, применяйте параллелизм и кэширование. Оптимизация IO часто приводит к заметному улучшению latency и throughput.
- Вопрос: Какие подходы к тестированию пригодны для регрессионного контроля производительности?
Создайте набор регрессионных бенчмарков с фиксируемыми входными данными, повторяйте тесты на каждой версии и сравнивайте распределения latency и throughput. Включите сценарии с реальными данными и тестируйте как минимум раз в релиз, чтобы обнаруживать деградацию в продакшен-среде.
- Какие практики следует внедрить в CI/CD для мониторинга производительности Polars?
Включите микро-бенчмарки в CI и храните результаты в артефактах/базах данных. Настройте пороги регрессионной производительности и автоматическую блокировку изменений, если отклонения превышают заданный порог. В качестве дополнения полезны регулярные регрессионные тесты на различных окружениях и системах.
- Вопрос: Какие риски связаны с оптимизацией на уровне памяти и как их минимизировать?
Основные риски - утечки памяти, фрагментация и неожиданные пиковые нагрузки. Решение - тщательно планировать размер чанков, использовать типизацию и лимиты памяти, проводить профилирование памяти и тестировать под реальными пиковыми условиями.
- Вопрос: Насколько важны кэш-результаты в аналитике Polars?
Кэширование может существенно ускорять повторяемые аналитические сценарии, но требует контроля за освежением данных. В зависимости от частоты обновления источников и требования к времени отклика кэш может быть ключевым элементом архитектуры.
- Вопрос: Как сочетать интерактивную аналитику и пакетную обработку в одной data platform?
Разделите слои вычислений: интерактивная аналитика реализуется через быстрые ленивые конвейеры на Polars и визуальные дашборды, пакетная обработка - через планировочные конвейеры, которые агрегируют данные и обновляют материализованные результаты. Важно обеспечить совместимый формат данных, единые схемы мониторинга и возможность обмена кэшированными результатами между слоями.
Эта глава предлагает целостный взгляд на производительность Polars в аналитических системах: архитектура, профилирование, интеграция и практические методики тестирования. Применение изложенных подходов позволяет не только достигать высоких скоростей вычислений, но и обеспечивать устойчивость и предсказуемость аналитических конвейеров в рамках цифровой трансформации организаций.


