

Сериализация в Apache Airflow: принципы, архитектура и реализация, форматы данных и влияние на производительность и миграцию
Аннотация и область исследования: сериализация в Apache Airflow
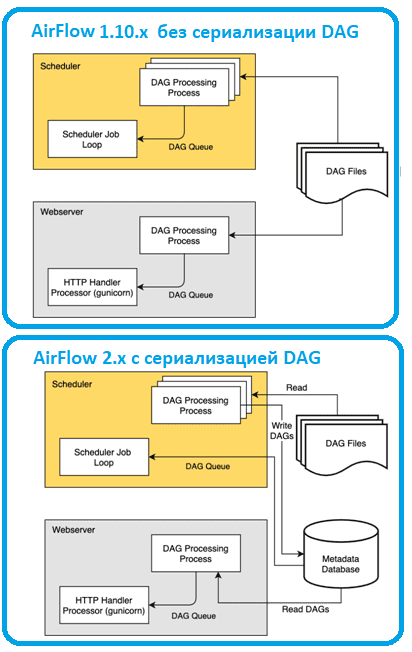
Сериализация в контексте облачных и распределённых оркестраторов задач представляет собой процесс преобразования сложных объектов в линейный формат, пригодный для передачи по сети, выдерживания в хранилищах метаданных и повторного восстановления. В Apache Airflow сериализация выполняется не только для передачи аргументов между задачами, но и для снижения зависимости планировщика и веб-сервера от исходных DAG-файлов. В рамках версии проекта, начиная с 2.x, введён механизм обязательной сериализации DAG в формат JSON, чтобы разгрузить веб-сервер и планировщик от анализа файлов DAG на каждом запуске. В данной работе формулируются теоретические основы и архитектурные решения Airflow в части сериализации, освещаются практики реализации пользовательских сериализаторов, механизмы хранения сериализованных объектов и их влияние на эксплуатацию и миграцию кластеров. Особое внимание уделяется моделям данных, таким как SerializedDagModel, DagCode и RenderedTaskInstanceFields, а также параметрам конфигурации, влияющим на частоту обновления и объём сохраняемых данных. Анализ проводится в контексте повышения надёжности, масштабируемости и скорости развёртывания инфраструктур данных в крупных корпоративных средах. В заключение представлены практические рекомендации по внедрению и миграции, а также потенциальные риски и направления дальнейшего развития.
Теоретические основы сериализации: принципы, форматы и ограничения
Сериализация - это процесс перевода структуры данных в представление, пригодное для сохранения или передачи. В Python стандартные типы данных, такие как строки и числа, поддерживаются напрямую, однако сложные структуры требуют явной стратегии преобразования. В Airflow ключевой принцип состоит в том, что объекты под управлением фреймворка или разработчика следует приводить к примитивам или к словарям, ключи которых тоже являются примитивами. Это обеспечивает совместимость с универсальным форматом JSON, который широко поддерживается в клиентских и серверных компонентах.
Нельзя забывать о ограничениях динамических языков и форматов: JSON не поддерживает произвольные классы и циклические ссылки, поэтому для внешних библиотек и нестандартных структур предусмотрены зарегистрированные сериализаторы и методы serialize/deserialize. В Airflow предпочтение отдаётся словарям и примитивам, а классы, помогающие обходить ограничение, рекомендуется оформлять в виде декорированных датаклассов @dataclass или использования соответствующих атрибутов (например, @attr.define). При отсутствии возможности сделать объект управляемым Airflow, разработчик обязан реализовать serialize() и deserialize() и вернуть примитив или словарь, где значения остаются несложными структурами.
Важной частью механизма является управление версиями сериализаторов. При работе с внешними библиотеками версии и совместимость являются критическими - на них накладываются требования к обратной совместимости и к предотвращению циклических импортов. В случаях использования пользовательских сериализаторов следует избегать прямого обращения к классам из других модулей и зачастую указывать полные имена пространств имён в виде строк, например serializers = ["my.company.Foo"], чтобы избежать циклических импортов. В контексте JSON-представления данные должны сохраняться в виде примитивов или словарей, чтобы последующая десериализация была предсказуема и повторяема.
Формально разделение на уровни абстракции позволяет разнести ответственность между слоями: базовые примитивы и структуры данных на уровне конвенций проекта, сериализаторы - на уровне расширяемости для сторонних библиотек, и механизм десериализации - на уровне совместимости версий и валидности данных. Это обеспечивает устойчивость к изменениям в экосистеме Python и внешних зависимостях, а также упрощает миграцию между версиями Airflow и окружениями.
Архитектура Airflow: декомпозиция компонентов и их взаимодействие
Архитектура Airflow строится вокруг трёх основных исполнителей процесса оркестрации: планировщика (scheduler), веб-сервера (webserver) и рабочей среды исполнителей (workers). Между ними взаимодействуют компоненты метаданных базы данных, а также набор объектов и моделей данных, описывающих графы задач и их состояние.
- Планировщик отвечает за анализ DAG и принятие решений о запуске задач. В контексте сериализации он опирается на сериализованные DAG-объекты, чтобы минимизировать обработку JSON и повторное чтение DAG-файлов. В частности, при включённой сериализации DagFileProcessorProcess анализирует файлы DAG, сериализует их в JSON и сохраняет в таблице SerializedDagModel в системе метаданных. Это обеспечивает согласованность и ускорение планирования.
- Веб-сервер читает сериализованные DAG-объекты из базы и конструирует DagBag на основе десериализованных данных, что позволяет визуализировать структуру DAG и управлять конфигурацией без необходимости обращения к исходным файлам DAG на файловой системе.
- DagBag выполняет роль кэширующего уровня и предоставляет интерфейсы для загрузки DAG в память. При сериализации он оперирует кэшированными данными и обновлениями из таблицы serialized_dag, чтобы поддерживать актуальность отображаемой информации в UI.
- Модели данных: SerializedDagModel представляет собой сериализованный набор метаданных DAG; DagCode хранит исходный код текстовой формы шаблонов и позволяет восстановить вид контента; RenderedTaskInstanceFields сохраняют поля экземпляров задач после рендеринга, что ускоряет повторное использование конфигураций и падение нагрузки на обработку задач.
Архитектура поддерживает модульность и расширяемость: новая сериализация может быть добавлена через регистрируемые сериализаторы, которые работают с примитивами и словарями, что обеспечивает совместимость и упрощает миграцию между версиями. Взаимодействие между компонентами организуется через чётко очерченные интерфейсы, что снижает риск портирования на другие среды и упрощает отладку и мониторинг.
Механизм сериализации в Airflow: принципы, уровни абстракции и роли
Механизм сериализации в Airflow разделён на несколько уровней абстракции, каждый из которых призван поддерживать баланс между производительностью и полнотой информации.
- Примитивы и словари как базовая единица передачи. Любой объект, который может быть представлен примитивами или словарём, может быть возвращён как есть или представлен в виде словаря, где ключи - примитивы, а значения - примитивы или вложенные структуры без сложных объектов.
- Пользовательские сериализаторы. Для нестандартных структур данных или внешних библиотек Airflow поддерживает реестр сериализаторов, где каждая запись определяет serialize() и deserialize() для соответствующего типа. Если класс помечен как dataclass или attrs-определение, принципы сериализации будут следовать стандартам этих декораторов, используя открытые поля и методы.
- Регистрация и поиск. Когда объект не является примитивом или итерируемым признаком, Airflow обращается к зарегистрированным сериализаторам в пространстве имен serialization.serializers. Если сериализатор не найден, применяется локальная реализация через методы serialize()/deserialize(), если они доступны.
- Управление циклами и зависимостями. При регистрации сериализаторов следует избегать циклических импортов, используя строковые пространства имён, чтобы избежать загрузки и зависимостей до момента выполнения. Это обеспечивает безопасное внедрение новых сериализаторов без разрушения существующей структуры модулей.
- Контроль версий. Управление версиями сериализаторов критично для совместимости между различными версиями Airflow и внешних библиотек. В рамках проекта предусмотрены механизмы указания версии сериализатора и поддержки обратной совместимости при обновлениях.
На уровне DAG сериализация служит для преобразования метаданных направленного ациклического графа в JSON-формат, который затем хранится в базе метаданных. Такой подход устраняет необходимость повторного анализа DAG-файлов каждым компонентом и ускоряет как загрузку веб-интерфейса, так и планировщика. В результате DAG-объекты конструируются только по запросу, благодаря хранению сериализованных форм в SerializedDagModel и возможности десериализации их в DagBag по мере необходимости.
Сериализация DAG: причины, внедрение с версии 2 и предполагаемые преимущества
Причины внедрения сериализации DAG в Airflow основаны на потребностях больших инфраструктур, где количество DAG растёт линейно, а загрузка веб-сервера и планировщика становится узким местом. JSON-представление DAG упрощает переносимость и совместимость между компонентами, а также сокращает задержки, связанные с чтением файлов DAG на диске и парсингом на старте сервисов.
- Снижение времени загрузки веб-сервера. При наличии большого числа DAG веб-сервер может обходиться сериализованными объектами, которые уже находятся в БД, что устраняет необходимость повторной инициализации и анализа каждой DAG-файла.
- Ускорение планирования. Планировщик получает доступ к консистентной и согласованной копии DAG через сериализованный объект, что позволяет принимать решения быстрее и с меньшими задержками.
- Независимость от файловой системы. В ситуациях, когда DAG-файлы недоступны или сильно задержаны (например, в контейнерной среде или облаке), сериализация обеспечивает бесперебойную работу UI и планирования.
- Контроль последствий обновлений. Сериализация упрощает миграции: изменения в структуре DAG могут проходить через сериализованные формы, минимизируя необходимость немедленного доступа к файловой системе на рабочих нодах.
Практически внедрение началось с версии 2.0.0 в части планировщика и веб-сервера, где часть логики стала базироваться на сериализованном DAG и его версионной стабильности. Это позволило разделить анализ DAG и отображение их в UI, повысив надёжность и масштабируемость. Важным аспектом стало хранение в базе данных не только самой сериализованной модели, но и связанных данных - к примеру, содержимого DagCode, при необходимости сохраняемого для полноты аудита и восстановления, и RenderedTaskInstanceFields, которые позволяют ускорение рендеринга в ходе выполнения задач.
Преимущества, которые ожидаются и достигаются на практике, включают улучшение отклика пользовательского интерфейса, снижение нагрузки на файловую систему и дисковый ввод-вывод, а также упрощение миграций между средами и версиями Airflow. Однако данные преимущества достигаются при грамотной настройке и грамотном выборе форматов сериализации, о чём будет подробно рассказано далее.
Форматы и подходы к сериализации: примитивы, словари и пользовательские сериализаторы
Рекомендованный подход к сериализации в Airflow опирается на принципы минимальной сложности и предсказуемости. На практике это означает: - предпочитать примитивы и словари там, где это возможно; - избегать сложных классов и графов объектов, если их можно заменить словарём; - при необходимости использовать пользовательские сериализаторы для внешних библиотек.
- Примитивы и словари. Возвращение примитива или словаря - это основной путь сериализации для простых структур. В словаре ключи должны быть примитивами, а значения - примитивами или вложенными словарями без сложных объектов. Это обеспечивает предсказуемость, совместимость с JSON и быстрый доступ к данным.
- Регистрация сериализаторов. Для объектов, не находящихся под управлением Airflow, требуется зарегистрированный сериализатор и десериализатор, включая версии. Примеры подконтрольных Airflow объектов включают модули airfow.model.dag.DAG; для внешних объектов - например numpy или сторонних библиотек - необходимы зарегистрированные сериализаторы.
- Встроенные и слабые места JSON. JSON, как текстовый формат, ограничен в передаче сложных структур и типов. Airflow компенсирует это через словари и сериализаторы, которые дают возможность представлять сложные данные в виде примитивов и простых структур, совместимых с JSON.
- Избежание циклических импортов. В целях профилактики циклических импортов рекомендуется указывать сериализаторы через пространства имён в виде строк, например serializers = ["my.company.Foo"] вместо непосредственного обращения к классу Foo. Это снижает риск ошибок при динамической загрузке модулей.
- Встроенные инструменты и расширение. Для расширения системы сериализации можно внедрять новые сериализаторы, ориентированные на конкретные бизнес-объекты или библиотеки. Важной практикой остаётся документирование формата сериализуемых данных и обеспечения обратной совместимости.
Примерно так Airflow подходит к работе с данными для передачи по сети и сохранения на сервере: сначала оценивается, можно ли представить объект как примитив или словарь. Если да, такой объект сериализуется напрямую. Если нет, ищется зарегистрированный сериализатор, иначе применяется набор методов serialize/deserialize при наличии такой реализации. В противном случае возникает задача, требующая рефакторинга структуры данных, чтобы привести её к совместимому формату.
Регистрация сериализаторов и расширение: поиск, регистрация, версии
Расширяемость процесса сериализации предполагает две составные части: механизм регистрации сериализаторов и управление их версиями. В Airflow основа - пространство имён serialization.serializers, где можно определить сериализаторы для типов, которые не являются примитивами. Регистрация может быть выполнена как динамически во время работы, так и через конфигурацию проекта.
- Поиск сериализаторов. При попытке сериализовать объект система ищет подходящий сериализатор в реестре. В случае отсутствия зарегистрированного сериализатора применяется стандартный путь через serialize()/deserialize() либо возвращается примитив, если это возможно.
- Регистрация через пространство имён. Чтобы снизить риск циклических импортов и зависимости между модулями, применяютStrategy регистрации через строковые имена пространств имён. Это позволяет определить сериализатор без непосредственного импорта модуля на этапе загрузки, что особенно полезно в больших инфраструктурах и микросервисной архитектуре.
- Версии сериализаторов. При эволюции моделей и внешних библиотек важно сохранять обратную совместимость сериализаторов. Наличие версий позволяет точно управлять миграциями и откатом. В случае несовместимости выводится предупреждение или применяется миграционный путь, чтобы данные остались доступными и корректными.
Эти принципы позволяют Airflow эволюционировать вместе с экосистемой, минимизируя риски для существующих рабочих процессов и конфигураций. В условиях больших кластеров они критически важны для поддержания совместимости между версиями и средами выполнения.
Реализация сериализации для внешних библиотек: управление версиями и циклические импорты
Особенно сложной задачей остаётся реализация сериализации для внешних, не контролируемых Airflow библиотек. В таких случаях применяются зарегистрированные сериализаторы с указанием поддержки версий. Управление версиями критично: несовместимые форматы могут привести к неверной десериализации, потере данных или некорректной эволюции DAG.
- Управление версиями. В рамках внедрения сериализации для внешних типов поддерживается версия сериализатора, позволяющая выполнять миграции данных. В случае изменения формата данные мигрируются по заранее определённой схеме, чтобы сохранить целостность.
- Циклические импорты. Для предотвращения проблем с импортами целесообразно использовать строковые ссылки на сериализаторы и избегать прямого импорта классов. Это обеспечивает гибкую загрузку и безопасную интеграцию в рамках сложной архитектуры Airflow.
- Специализированные примеры. В реальных сценариях встречаются библиотеки NumPy, Pandas и другие, где выходной формат может быть не совместим с прямой сериализацией через JSON. В таких случаях применяются адаптеры и сериализаторы, которые возвращают примитивы или словари, совместимые с JSON, и поддерживают версионность.
Следовательно, реализация сериализации для внешних библиотек требует внимательного подхода к версиям, а также к архитектуре модулей и зависимостей в проекте Airflow. Этот подход позволяет сохранить совместимость и минимизировать риск некорректной загрузки DAG и связанных ресурсов.
Модели данных и хранение: SerializedDagModel, DagCode, RenderedTaskInstanceFields
Эффективная архитектура хранения сериализованных данных требует чёткой структуры моделей и их взаимосвязей.
- SerializedDagModel. Эта модель представляет собой сериализованный набор метаданных Directed Acyclic Graph (DAG). В ней хранится сам граф в виде JSON, информация о зависимостях, расписаниях и параметрах, необходимых для планирования и визуализации. SerializedDagModel обеспечивает быстрый доступ к ключевым сведениям, позволяя веб-серверу и планировщику работать с данными без обращения к исходным DAG-файлам.
- DagCode. Модель DagCode хранит содержимое исходного кода DAG-файлов в виде шаблона или текста. Это полезно для аудита и восстановления, а также позволяет отображать контент в UI и поддерживать версию кода. При активной сериализации отображение кода может быть отключено во избежание лишних обращений к большому объёму текста, но копия содержимого остаётся в БД.
- RenderedTaskInstanceFields. Эта модель сохраняет поля, получившие значения после этапа рендеринга задач. Сохранение таких полей снижает вычислительную нагрузку в повторных запусках и ускоряет отрисовку состояния задач на веб-UI. Однако для контроля роста объёма данных сохраняются только последние записи, а старые удаляются по настройкам и практикам мониторинга.
Эти модели обеспечивают единый слой хранения сериализованных данных и позволяют эффективно управлять нагрузкой на базу данных метаданных, а также поддерживать консистентность между различными компонентами системы.
Управление размером данных и хранением: ограничения, очистка, компрессия
Рост объёмов сериализованных данных может привести к перегрузке базы данных метаданных и снижению производительности. Поэтому практики управления размером данных включают несколько направлений.
- Ограничение объёмов. В целях ограничения роста хранилища применяются политики, например сохранение только последних записей RenderedTaskInstanceFields, ограничение числа полей, сохраняемых для каждой задачи, а также применение фильтрации и агрегации для часто используемых данных.
- Очистка. Регулярная очистка старых записей и архивирование являются важной частью эксплуатации. Важно устанавливать пороги, которые не влияют на текущее функционирование планировщика и веб-интерфейса, но позволяют контролировать доступ к архивационным данным.
- Компрессия. В случаях крупных DAG полезна компрессия сериализованных DAG в БД. Включение компрессии уменьшает занимаемое место, но может ограничивать возможность непосредственного анализа зависимостей по внешним инструментам. При включении компрессии может происходить ограничение отображения зависимостей DAG, что следует учитывать в архитектуре и политике мониторинга.
- Баланс между доступностью и объёмом. Важно сохранять баланс между доступностью сериализованных данных и объёмами их хранения. В идеале данные должны оставаться доступными для быстрого десериализирования, но без чрезмерного дублирования.
Эти принципы позволяют обеспечить устойчивость к нагрузкам и масштабирование, а также способствуют экономии ресурсов на хранилище метаданных.
Конфигурационные параметры: min_serialized_dag_update_interval, min_serialized_dag_fetch_interval, max_num_rendered_ti_fields_per_task, compress_serialized_dags
Конфигурационные параметры Airflow предоставляют контроль над балансом между актуальностью данных и нагрузкой на систему.
- min_serialized_dag_update_interval. Минимальный интервал (в секундах) между обновлениями сериализованных DAG в базе метаданных. Этот параметр позволяет уменьшить нагрузку на БД за счёт редуцирования частоты обновлений, сохраняя при этом приемлемую актуальность данных для веб-сервера и планировщика.
- min_serialized_dag_fetch_interval. Частота повторной выборки сериализованного DAG из базы данных, когда он уже загружен в DagBag на веб-сервере. Этот параметр регулирует чтение данных и выдерживает баланс между соответствием реальному состоянию DAG и нагрузкой на метаданные.
- max_num_rendered_ti_fields_per_task. Максимальное количество полей экземпляра визуализированной задачи (fields шаблона) для каждой задачи, которые необходимо сохранить в базе данных. Это ограничение направлено на контроль объёма RenderedTaskInstanceFields и предотвращение неограниченного роста.
- compress_serialized_dags. Флаг, управляющий сжатием сериализованных DAG в базе данных. При включённой компрессии достигается экономия пространства, но просмотр зависимостей DAG может стать сложнее и требует дополнительной обработки десериализации.
Эти параметры позволяют адаптировать Airflow к конкретным требованиям производительности, объёмам DAG и политике хранения, обеспечивая гибкость в разных средах - от локальных до кластерных инсталляций.
Взаимодействие DagBag, веб-сервера и планировщика: загрузка и кэширование
Взаимодействие между DagBag, веб-сервером и планировщиком в рамках сериализации устроено так, что данные DAG загружаются и кэшируются в соответствующих слоях.
- DagBag формирует локальный кэш DAG и обеспечивает доступ к ним. При сериализации веб-сервер читает сериализованные DAG из SerializedDagModel, не обращаясь к исходным DAG-файлам, что существенно ускоряет загрузку.
- Веб-сервер. После загрузки сериализованных DAG он десериализует данные и формирует DagBag для отображения и взаимодействия пользователя. При обращении к конкретной DAG выполняется десериализация в контексте нужной информации.
- Планировщик. Он полагается на сериализованные DAG для определения расписания и выполнения задач. Это обеспечивает согласованность и ускорение планирования, поскольку планировщик оперирует данными уже в JSON-формате, без необходимости повторного анализа файлов DAG.
Таким образом, система обеспечивает разобщение между анализом DAG и их использованием в UI и планировании, что улучшает производительность и надёжность всей цепочки выполнения.
Влияние на производительность и эксплуатацию: время загрузки, потребление памяти, масштабируемость
Сериализация DAG и связанных данных напрямую влияет на производительность и эксплуатацию Airflow.
- Время загрузки. В случаях большого числа DAG сериализованные формы позволяют значительно сократить время загрузки веб-сервера и начать работу быстрее. Это особенно критично в окружениях с большим количеством DAG и различной активностью задач.
- Потребление памяти. Эффективное кэширование и хранение сериализованных данных снижают нагрузку на оперативную память, поскольку не требуется хранить в памяти полные AST-структуры DAG файлов. Однако неизбежно необходимо держать часть сериализованных данных в памяти для быстрого доступа.
- Масштабируемость. Модульность и возможность регистрации сериализаторов позволяют адаптировать архитектуру под масштабы кластера, включая распределённые режимы исполнения и многокластерную инфраструктуру. С переходом на сериализованные DAG снижаются зависимости между узлами кластера и улучшаются показатели согласованности.
Управление размером данных также влияет на масштабируемость: компрессия, ограничение числа полей RenderedTaskInstanceFields и периодическая очистка помогают удерживать объём в разумных пределах, что критично для крупных инсталляций и долгосрочной эксплуатации.
Декомпозиция технических компонентов и их взаимодействия: подробный разбор
Техническая структура Airflow в контексте сериализации может быть рассмотрена через уровни: данные DAG и их состояние, механизмы сериализации, хранилище и интерфейсы для взаимодействия между компонентами.
- Данные DAG и их состояние. Основной набор состоит из сериализованных форм DAG (SerializedDagModel), исходного кода DAG (DagCode) и полей, связанных с rendерированием задач (RenderedTaskInstanceFields). Эти элементы формируют основу для быстрого доступа и отображения DAG в UI, а также для планирования.
- Механизмы сериализации. Включают базовые примитивы и словари, а также регистрируемые сериализаторы внешних библиотек. Механизм поддерживает версионирование и защиту от циклических импортов.
- Хранилище и интерфейсы. База метаданных служит хранилищем сериализованных форм; DagBag и веб-сервер вместе обеспечивают доступ и представление DAG, в то время как планировщик опирается на сериализованные данные для решений о запуске.
- Взаимодействие через кэширование. Кэширование сериализованных DAG позволяет снизить частоту обращений к данным и улучшить отклик UI, при этом поддерживая согласованность через периодическую синхронизацию с базой метаданных.
Этот разбор подчёркивает принцип разделения ответственности: сохранение и управление сериализованными данными отделено от их использования на уровне UI и планирования. В итоге система остаётся устойчивой к изменениям в составе DAG и внешних сервисах.
Интеграция стеков и синергия: JSON, альтернативы, настройка окружения
JSON остаётся основным форматом сериализации в Airflow благодаря своей простоте, совместимости и широкому кругу инструментов. Однако для повышения производительности в некоторых конфигурациях может использоваться альтернативный JSON-стек, например ujson, который обеспечивает более быстрый парсинг и сериализацию. Для подключения альтернативы в Airflow предусмотрены механизмы настройки через локальные файлы и окружение.
- Стандартная библиотека JSON. По умолчанию используется модуль json из стандартной библиотеки Python. Он обеспечивает надёжность и совместимость без дополнительных зависимостей.
- Замена на альтернативы. При использовании другой библиотеки JSON сначала импортируется соответствующая реализация, затем определяется локальная переменная json в airflow_local_settings.py, запрашивая нужную реализацию. Это позволяет сохранить единообразие кода и управлять производительностью.
- Настройки окружения. Конфигурационные изменения обычно вносятся через airflow.cfg и дополнительные настройки через airflow_local_settings.py. Важно учитывать совместимость версий и влияние на миграции.
- Безопасность и совместимость. При внедрении альтернатив следует внимательно тестировать сценарии сериализации и десериализации, чтобы не нарушить существующие процессы и не повредить миграционные траектории.
Таким образом, интеграция стеков и выбор форматов - это баланс между производительностью и надёжностью, который зависит от конкретной рабочей нагрузки и требований к эксплуатации.
Кейсы применения в реальных сценариях: сценарии внедрения и результаты
Кейсы внедрения систем сериализации в Airflow обычно включают сценарии с большим количеством DAG и ограничениями на ресурсы. Рассмотрим обобщённый набор сценариев and результаты:
- Вариант A: крупный финансовый конгломерат с сотнями DAG. Внедрение сериализованных DAG позволило существенно сократить время загрузки веб-интерфейса и снизить потребление памяти в web-сервере. В результате наблюдалась более предсказуемая задержка отклика и более устойчивое планирование.
- Вариант B: производственный холдинг с многокластерной архитектурой. Применение компрессии сериализованных DAG и ограничение RenderedTaskInstanceFields позволило снизить нагрузку на базу данных метаданных и упростило миграцию между средами.
- Вариант C: здравоохранение с высоким уровнем аудитории. Использование альтернативного JSON-стека позволило ускорить парсинг больших DAG и снизить общее время отклика для пользователей, работающих через веб-интерфейс в условиях ограниченной пропускной способности.
Эти сценарии демонстрируют, что сериализация DAG в Airflow не является единственно верным решением для всех окружений, но с грамотной настройкой параметров и выбором форматов она может существенно повысить производительность и надёжность эксплуатации.
Применение в экономических секторах: финансы, здравоохранение, производство, торговля
- Финансы. В условиях строгих требований к аудиту и скорости обработки потоков данных сериализация DAG позволяет быстрее разворачивать новые потоки и обеспечивать консистентность между планировщиком и UI, что критично для своевременного исполнения регламентированных задач.
- Здравоохранение. В системах, где обработка пациентских данных требует соблюдения регуляторных норм, использование сериализованных DAG упрощает аудит изменений и обеспечивает устойчивость к сбоям, сохраняя данные в управляемом виде и контролируемом доступе.
- Производство. В условиях интенсивной эксплуатации и большого числа задач сериализация помогает держать нагрузку под контролем, улучшает масштабируемость, а также ускоряет развёртывание новых процессов.
- Торговля. В e-commerce и розничной торговле, где время отклика критично, сериализация DAG облегчает мониторинг и управление потоками задач, снижая задержки при обновлениях и миграциях конфигураций.
Эти примеры иллюстрируют, как принципы сериализации в Airflow применимы в разных секторах экономики, удовлетворяя требования к производительности, надёжности и управляемости.
Риски, уязвимости и ограничения: метрики эффективности, мониторинг и безопасность
Несмотря на преимущества, сериализация DAG несёт риски и ограничения, требующие внимательного мониторинга.
- Метрики эффективности. Важны показатели времени загрузки веб-сервера, времени планирования и памяти, потребляемой сериализованными формами. Необходимо отслеживать темпы изменений и частоту обновлений, чтобы не перегружать базу данных.
- Мониторинг и диагностика. Необходимо обеспечить мониторинг процессов сериализации и десериализации, регистрировать исключения и неуспешные попытки десериализации, чтобы своевременно реагировать на проблемы совместимости.
- Безопасность. Сериализованные данные могут содержать конфиденциальную информацию; требуется контроль доступа к SerializedDagModel и DagCode, а также управление доступом к данным в рамках кластерной инфраструктуры.
- Ограничения форматов. JSON ограничивает представление сложных структур, и для внешних библиотек иногда требуется реальный рефакторинг архитектуры или внедрение дополнительных сериализаторов. Это может потребовать времени на миграцию и тестирование.
- Риск агрессивного хранения. Без ограничений о количестве RenderedTaskInstanceFields возможно чрезмерное рости данных и нагрузка на БД. Необходима балансировка между полнотой данных и размером.
Управление этими аспектами требует регулярного аудита политики хранения, мониторинга и миграций, чтобы обеспечить долгосрочную устойчивость и соответствие требованиям.
Конкурентный анализ и дифференциация: Airflow и альтернативы, сравнительный обзор
На рынке оркестраторов данных существуют альтернативы Apache Airflow с различной трактовкой сериализации и хранения метаданных. Среди них можно выделить:
- Airflow vs Prefect. Prefect предлагает иной подход к управлению потоками и зависимости, а также богатый набор инструментов для мониторинга. Сериализация в Prefect имеет свои особенности, но концептуально аналогична - хранение контекста выполнения и состояния задач, но архитектура и UI отличаются.
- Airflow vs Dagster. Dagster ориентирован на оркестрацию с акцентом на типизацию и детальное описание конфигураций. В части сериализации Dagster применяет собственные механизмы концептуализации данных; Airflow же держится принципа расширяемости через сериализаторы и словари.
- Airflow vs Azkaban и другие инструменты. В некоторых случаях Azkaban применяет иной подход к загрузке DAG и их зависимостей, что влияет на архитектуру сериализации и производительность. В целом Airflow выигрывает в гибкости и расширяемости через механизм сериализации, хотя требует внимательной настройки и миграции.
- Дифференциация. Основные различия лежат в подходах к хранению метаданных, расширяемости сериализации и интеграции с внешними библиотеками. Airflow обеспечивает более прозрачное и гибкое управление сериализацией за счёт возможностей регистрации сериализаторов, версий и параметров конфигурации. Это позволяет адаптировать систему под конкретные требования, но требует более продуманной стратегии эксплуатации.
Эта дифференциация помогает организациям выбирать наиболее подходящие инструменты под конкретные сценарии, однако в рамках крупных предприятий Airflow остаётся одним из наиболее развёрнутых и гибких решений для оркестрации и управления данными.
Руководство по внедрению и миграции: шаги, рекомендации и best practices
Внедрение и миграция к сериализованным DAG в Airflow требуют системного подхода и планирования.
- Этап подготовки. Оценка текущей нагрузки, числа DAG, объёмов данных и миграционных требований. Выбор конфигурационных параметров min_serialized_dag_update_interval, min_serialized_dag_fetch_interval, max_num_rendered_ti_fields_per_task и compress_serialized_dags...
- Граф миграции. Определение последовательности изменений: введение сериализации DAG, подключение SerializedDagModel, создание DagCode и RenderedTaskInstanceFields, настройка кэширования и обновления.
- Тестирование совместимости. Вначале следует ограничить изменения тестовой средой, проверить работу сериализации и десериализации, протестировать реальный сценарий миграции на нескольких DAG.
- Управление версиями сериализаторов. Внедрение многоверсионной стратегии сохранения сериализаторов и их совместимости. Документация по версиям для разработчиков и администраторов.
- Мониторинг и аудит. Включение мониторинга по времени загрузки, памяти и скорости десериализации. Обеспечение аудита изменений для DAG, а также сохранение истории изменения данных.
- Миграция на продакшене. Постепенная миграция с параллельной работой оригинальных DAG и сериализованных форм. Обеспечение механизмов отката и мониторинга на каждом этапа.
Best practices включают: документирование форматов сериализованных данных, тестирование локально и в стейджинге, постепенное развёртывание, настройку устойчивости к ошибкам и страхованию данных. В результате внедрение сериализации DAG становится инструментом для повышения надёжности и производительности, допускающим адаптацию под конкретную инфраструктуру.
Вопрос-Ответ
Вопрос: Что такое SerializedDagModel и зачем он нужен?**
SerializedDagModel - это сериализованный набор метаданных DAG, который хранится в базе метаданных и используется веб-сервером и планировщиком для быстрого доступа к графу и его конфигурациям без обращения к исходным DAG-файлам.
Вопрос: Какие форматы данных рекомендуются для сериализации в Airflow?**
В Airflow рекомендуется использовать примитивы и словари, где ключи являются примитивами; при необходимости применяются зарегистрированные сериализаторы для внешних библиотек. Это помогает поддерживать совместимость с JSON и упрощает десериализацию.
Вопрос: Какие основные параметры конфигурации управляют сериализацией?**
Основные параметры - min_serialized_dag_update_interval, min_serialized_dag_fetch_interval, max_num_rendered_ti_fields_per_task, compress_serialized_dags - управляют обновлениями, выборкой, количеством сохраняемых полей и степенью компрессии.
Вопрос: Как сериализация DAG влияет на производительность?**
Сериализация DAG позволяет уменьшить время загрузки веб-сервера и повысить скорость планирования за счёт снижения зависимости от файлов DAG. В зависимости от конфигурации может снизиться потребление памяти и увеличить масштабируемость.
Вопрос: Что делать с регистрацией новых сериализаторов?**
Регистрация требует аккуратности: используйте пространства имён в виде строк, избегайте циклических импортов, регистрируйте сериализаторы для внешних библиотек с указанием версий и тенденций совместимости.
Вопрос: Какие риски связаны с компрессией сериализованных DAG?**
Компрессия может затруднить просмотр зависимостей и анализ, если инструменты требуют доступа к неразжатым данным. Необходимо балансировать между экономией пространства и удобством диагностики.
Вопрос: Как интегрировать альтернативы JSON в Airflow?**
Чтобы использовать альтернативу JSON, необходимо импортировать её и определить json-переменную в airflow_local_settings.py, а затем корректно зарегистрировать сериализаторы и проверить совместимость с существующими механизмами десериализации.
Вопрос: Какие шаги следует предпринять для миграции на сериализованные DAG?**
Оценка нагрузки, подготовка конфигураций, тестирование миграции на стейджинге, постепенная замена DAG на сериализованные экземпляры, мониторинг производительности и создание плана отката.