

Trino: архитектура, планирование и оптимизация выполнения запросов - концептуальный обзор механизмов pushdown, динамических фильтров, стратегий соединений и интеграции коннекторов
Введение: цели анализа и контекст оптимизации запросов в Trino
Trino представляет собой распределённый движок выполнения SQL-запросов, спроектированный для обработки больших аналитических наборов данных на кластере из независимых узлов. Основной интерес к анализу архитектуры и механизмов оптимизации обусловлен необходимостью минимизировать задержки чтения данных, снизить сетевой трафик между источником данных и вычислительным слоем, а также обеспечить предсказуемую производительность в сценариях бизнеса с высокими требованиями к своевременности принятия решений.
Цель данной статьи - изложить концептуальный контекст, принципы построения планов выполнения и стратегии оптимизации в Trino, а также рассмотреть практические аспекты интеграции коннекторов, каталогов и источников данных. Мы начинаем с общей картины архитектуры и постепенно углубляемся в механизмы планирования, реализации определённых паттернов ускорения выполнения, вопросов мониторинга и примеров применимости в реальных сценариях. Важной целью является не только описание того, «что» делает механизм, но и причинно-следственные связи: почему именно тот или иной подход эффективен в контексте распределённых систем, какие trade-off сопряжены с выбором конкретной стратегии и какие риски следует учитывать при эксплуатации.
Ключевые темы охватывают два класса аспектов: во-первых, архитектурные принципы и этапы обработки запроса в распределённом окружении Trino; во-вторых, механизмы pushdown и адаптивной оптимизации, которые позволяют снизить объем данных на входе в коннекторы и поэтому ускорить выполнение. Отдельное внимание уделено контрактам между коннекторами Iceberg и Hive, а также взаимосвязям каталоги-коннектор-источник данных, которые являются базой для эффективного pushdown и корректной оценки стоимости выполнения.
Архитектура Trino: координатор, воркеры, каталоги и коннекторы

Trino строится вокруг координационного узла (Coordinator) и одного или более рабочих узлов (Worker). Координатор выполняет функции оркестрации: принятие SQL-запросов, построение логических и физических планов, координацию распределённых задач и сбор результатов. Воркеры выполняют реальные вычисления - чтение данных, выполнение операторов и агрегаций, обмен промежуточными результатами и передачу итогов координационному узлу для формирования окончательного набора результатов клиенту.
Модель каталогов (Catalogs) и коннекторов (Connectors) определяет, как Trino видит источники данных: каталоги - это конфигурационные наборы свойств, которые позволяют подключаться к конкретному источнику, в то время как коннектор реализует единую SPI (Service Provider Interface) и интегрируется с системой хранения или базой данных на уровне метаданных и данных. Каталог задаёт параметры подключения (URL, учётные данные, параметры доступа и пр.), а имя файла конфигурации каталога в каталоге Trino определяет именно этот каталог.
Архитектура предполагает, что клиенты подключаются к координатору через стандартный REST-интерфейс или JDBC/ODBC-драйверы, и далее координатор распределяет работу между воркерами. При этом оба типа узлов - координатор и воркеры - имеют доступ к набору коннекторов, описанных в каталогах. Это позволяет реализовать федеративные запросы, объединяющие данные из разнородных источников без принудительной перемещения данных в единый репозиторий.
Важно помнить несколько ключевых концепций:
- Коннектор - адаптер, реализующий специфический API взаимодействия с конкретным источником данных и предлагающий интерфейсы чтения, запроса метаданных и реализации функций pushdown. Примеры: Iceberg, Hive, PostgreSQL, MySQL, Cassandra, ClickHouse и др.
- Каталог - набор свойств, которые позволяют выбрать коннектор и подключиться к источнику данных. Имя файла каталога в каталоге etc/catalog/ задаёт идентификатор каталога, доступ к которому осуществляется через этот набор свойств.
- Таблица в Trino - это отображение внешнего источника данных: таблица в Hive, таблица в Iceberg, таблица в Postgres и т. д. Полное имя таблицы включает в себя имя каталога и схему, а затем имя объекта: catalog.schema.table.
- Порядок выполнения - Trino строит распределённый план, который разбивается на фрагменты (fragments) и стадии (stages), где каждая стадия может состоять из нескольких задач (tasks). Задачи действительно обрабатывают данные и осуществляют Exchange между стадиями через механизм Exchanges.
Эта архитектура обеспечивает высокую масштабируемость и гибкость, позволяя адаптировать план под конкретные характеристики источников и объём данных, которые необходимо обработать в рамках запроса.
Основные концепции выполнения запросов: statement, query, стадии, фрагменты, сплиты, драйверы и Exchanges
Понимание базовых единиц выполнения в Trino начинается с различения двух близких понятий: statement и query. Statement - это текст ANSI SQL-запроса, который пользователь отправляет системе. Trino затем превращает этот оператор в внутреннее представление под названием query, которое включает набор стадий, задач, разбиений и конструктов, необходимых для выполнения запроса в распределённой среде.
Распределённый план включает:
- Стадии (stages) - логическая структура вычислений, которые должны быть выполнены в рамках всего запроса. Основная идея состоит в том, что каждая стадия отражает часть работы над данными и может быть выполнена параллельно несколькими задачами. Стадии сами по себе не выполняются на воркерах; они являются моделью плана.
- Фрагменты (fragments) - самостоятельные куски плана, которые выполняются на отдельных воркерах. Fragment 0 может отвечать за чтение данных, Fragment 1 - за обработку агрегации, и т. д. Фрагменты формируют граф исполнения, переходя данные между собой через Exchanges.
- Сплиты (splits) - минимальная единица чтения данных в коннекторе. Каждый split соответствует части файла (или нескольких файлов) и включает информацию о местоположении данных и необходимых колонках.
- Драйверы (drivers) - нижеуровневая последовательность операторов внутри конкретной задачи, которая реализует цепочку чтений, фильтраций и преобразований данных и выдаёт промежуточные результаты для следующего оператора.
- Exchanges - механизм передачи промежуточных данных между разными стадиями запроса. Exchanges обеспечивают связь между фрагментами и позволяют строить распределённый граф исполнения с передачей данных между узлами кластера.
Постепенно эти элементы связываются в распределённый план, который coordenator запрашивает у коннектора доступные сплиты, распределяет их между воркерами и следит за выполнением. В сложном запросе, скажем, при агрегации по большой таблице в Hive, корневая стадия может агрегировать итоговые значения, а дочерние стадии реализуют часть вычислений, в частности сканирования, фильтрации и подготовки данных. Такой подход позволяет выполнить планирование на уровне coordinator и достигнуть эффективной распараллеленной обработки на воркерах.
Важно помнить, что планирование и исполнение в Trino происходят с учётом контакта между коннекторами и источниками данных. Например, для Iceberg и Hive коннекторов часть операции может быть проброшена в источник данных (pushdown), что минимизирует объём данных, которые необходимо перенести через сеть и обработать в Trino.
Компоненты планирования и оптимизации: Parser, Optimizer и Cost-Based Optimization
Три ключевых компонента в механизме планирования Trino:
- Parser (Парсер) - преобразует текст SQL-запроса (statement) в синтаксическое дерево и первичную структуру. Этот этап отвечает за корректность синтаксиса и построение базовой внутренней репрезентации запроса.
- Optimizer (Оптимизатор) - принимает текст и преобразованную структуру из Parser, строит логический план выполнения (логические операции: скан, фильтр, join, агрегат и т. д.) и далее преобразует его в физический план, который будет реализован на воркерах. Основная задача оптимизатора - минимизировать время выполнения и стоимость запроса путем выбора наилучшего порядка выполнения операций, использования pushdown-оптимизаций, partition pruning и прочих стратегий.
- Cost-Based Optimization (CBO, оптимизация на основе стоимости) - механизм планировщика, который на основе статистики таблиц оценивает «стоимость» вариантов исполнения. Это включает оценку порядка соединений, стратегии перераспределения данных и предполагаемую работу над данными. Цель CBO - выбрать план с минимальной предполагаемой стоимостью выполнения, учитывая данные о размерах, распределении значений и доступности статистики.
Стоимость вычислений в рамках CBO выводится в EXPLAIN-выводах как ориентировочная метрика, помогающая сравнивать разные планы исполнения. В контексте реального выполнения размеры, предикаты и статистика влияют на итоговый выбор алгоритмов соединения (broadcast vs partitioned), выбор плана свертывания и прочие решения. Важно понимать, что для эффективности CBO критически важна актуальная статистика коннекторов: размеры таблиц, распределения значений, доля NULL-значений и другие параметры. В отсутствие полноценной статистики оптимизатор может перейти к более консервативным стратегиям.
Роль статистики в планировании: SHOW STATS, ANALYZE и управление статистикой коннекторов
Статистика таблиц - критический фактор для эффективного планирования в Trino. Она позволяет оценить количество строк, общий объём данных, частоты значений и диапазоны значений по каждому столбцу. Эти данные поддерживаются коннекторами, которые могут включать или исключать сбор статистики в зависимости от возможностей источника.
Ключевые концепты:
- SHOW STATS - команда, которая позволяет просмотреть текущие оценки статистики для таблиц и конкретных столбцов. Это помогает аналитикам понять, какие предположения сделаны планировщиком и как это может влиять на выбор планов.
- ANALYZE - команда, инициирующая сбор расширенной статистики. Это позволяет обновить статистику таблиц, особенно когда внешние системы изменили данные без участия Trino, и существующая статистика устарела.
- Управление статистикой коннекторов - реализация зависит от конкретного коннектора. Некоторые коннекторы (например, Delta Lake, Iceberg, Hive) поддерживают управление статистикой непосредственно через Trino. Другие коннекторы могут полагаться на базовый источник данных или не поддерживать статистику вообще.
- Динамическая статистика - некоторые коннекторы могут модернизировать статистику во время выполнения операций.
Во время планирования стоимость на узел плана оценивается на основе статистики и в итоге отражается в EXPLAIN как Estimates: {rows: ..., cpu: ..., memory: ..., network: ...}. Если статистика неизвестна, соответствующие значения помечаются как вопросительные знаки. В зависимости от поддержки со стороны коннектора, статистика может обновляться через INSERT/UPDATE/DELETE или ANALYZE. В контексте Iceberg, Hive и Delta Lake существуют механизмы для обновления и использования статистики в рамках планирования и оптимизации.
Для эффективного использования статистики рекомендуется:
- поддерживать актуальность статистики через ANALYZE на регулярно обновляемых источниках;
- использовать EXPLAIN и EXPLAIN ANALYZE для оценки влияния статистики на план;
- учитывать ограничение в коннекторе: некоторые коннекторы не предоставляют данные по размеру данных, что ограничивает точность оценки;
- рассматривать включение расширенной статистики (extended statistics) для более точной оценки стоимости.
Predicate Pushdown, Projection Pushdown и Dereference Pushdown
Pushdown-принципы позволяют перенести часть вычислений в источник данных, чтобы уменьшить объем загружаемых данных и время обработки. В контексте Trino это относится к трём основным видам pushdown:
- Predicate Pushdown (проброс предикатов) - передача условий отбора (WHERE, JOIN ON) в источник данных для фильтрации на уровне хранилища. Это снижает количество строк, читаемых из источника. В идеальном варианте, если коннектор поддерживает проброс, оператор Scan не содержит дополнительных условий отбора; в противном случае план включает Scan+Filter+Project на стороне Trino.
- Projection Pushdown (проброс проекций) - передача только тех столбцов, которые необходимы запросу, в источник. Это уменьшает объем считываемых данных и снижает накладные расходы на обработку.
- Dereference Pushdown - более избирательная аналогия проекции: ограничение на чтение только конкретных полей внутри сложных типов, таких как ROW или STRUCT. Это особенно полезно для коннекторов с вложенными структурами, где запрос обращается только к одному полю внутри сложного типа.
В реальных конфигурациях поддержка этих pushdown-фич зависит от конкретного коннектора. Например, для Iceberg/Hive коннекторов Trino может передавать предикаты и проекции на уровень файловой системы и таблиц, с учётом спецификации каждого коннектора. Если проброс для конкретной функции или набора условий не поддерживается, в плане будет видна соответствующая операция на стороне Trino, например, ScanFilterProject, что сигнализирует, что часть работы не была проброшена на источник.
Преимущества Pushdown:
- уменьшение объема данных, передаваемых по сети;
- снижение времени чтения и обработки;
- повышение эффективности использования ресурсов на источнике данных (CPU, I/O).
Ограничения:
- поддержка зависит от коннектора и самой базы/хранилища;
- не все предикаты можно пробросить; сложные выражения или пользовательские функции могут потребовать выполнения внутри Trino;
- sometimes pushing down complex aggregations может быть невозможно или неэффективно реализуемо.
Постоянно следует проверять план выполнения (EXPLAIN) на предмет наличия операторов с indication Pushdown: отсутствие операторов типа ScanFilterProject или наличие явного RemoteSource/Pushdown-предикатов служит индикатором того, что pushdown не применён полностью.
Проброс агрегации и Top-N Pushdown: возможности и ограничения
Проброс агрегации позволяет перенести выполнение агрегирующих функций на уровень коннектора, если коннектор поддерживает такие операции. Это может значительно снизить объем обрабатываемых данных, особенно когда источники дают возможность частично агрегировать до загрузки в систему. Однако существует ряд ограничений и условий:
- коннектор должен поддерживать проброс конкретной функции агрегации или агрегирующую конструкцию в целом;
- структура запроса должна позволять проброс агрегации; некоторые сложные формы запроса или вложенные агрегаты могут быть несовместимы;
- если агрегирующая функция не может быть проброшена, план выполнения будет содержать оператор Aggregate в расчётах Trino.
Top-N Pushdown - это паттерн, который реализуется в сочетании ORDER BY и LIMIT/FETCH FIRST N ROWS. Проброс такого запроса к источнику данных может позволить сократить количество обрабатываемых строк до верхних N значений на уровне источника, что особенно полезно, когда источник поддерживает упорядочение и ограничение чтения. В некоторых коннекторах, например, PostgreSQL, демонстрируется успешный Top-N pushdown: план не содержит явного оператора Sort или Limit внутри Trino, поскольку выполнение ограничено источником данных. В других случаях, когда топ-N не поддерживается в источнике, Trino выполняет Top-N локально, что может потребовать загрузки значительной доли набора данных.
В примерах, связанных с TPC-H и коннектором PostgreSQL, можно увидеть различие: когда Top-N pushdown поддерживается, план видит соответствующую структуру, и часть операций перемещается на источник. В случаях, когда Top-N pushdown недоступен (например, с коннектором для TPC-H в PostgreSQL), Trino выполняет Top-N внутри собственного движка, что может повлечь нагрузку на память и сеть в ходе выполнения.
Ключевые факторы, влияющие на проброс агрегации и Top-N:
- поддержка коннектора конкретной функции агрегации;
- сложность выражения агрегации (например, sum(a*b) может быть сложной для проброса);
- наличие соответствующих индексов, функций и функциональных возможностей источника;
- особенности реализации физического плана в источнике (например, возможность раннего сопоставления и вычислений на стороне источника).
В контексте практики рекомендуется проверять EXPLAIN и EXPLAIN ANALYZE, чтобы определить, выполняется ли проброс агрегации или Top-N, и при необходимости оптимизировать запрос или конфигурацию (например, выбирать альтернативные формулы запроса, упрощать выражения агрегации, или пересматривать стратегию чтения данных).
Динамические фильтры и динамическое разделение: Dynamic Filtering и Dynamic Partition Pruning
Dynamic Filtering (динамические фильтры) - это механизм, который позволяет использовать значения, полученные во время выполнения из одной части запроса (например, после выполнения JOIN на build-стороне), для фильтрации другой части запроса во время выполнения. Это позволяет уменьшить объем данных, считываемых из источника, и тем самым ускорить выполнение.
Dynamic Partition Pruning (динамическое разделение партиций) - это методика, аналогичная динамическим фильтрам, которая позволяет исключать целые партиции на этапе планирования или исполнения, если выражения WHERE/JOIN ON показывают, что эти партиции не содержат нужных данных. Это особенно существенно в схемах, где Iceberg-тип таблиц и Hive-метасторы предоставляют богатую метаинформацию, позволяющую эффективно prune партиции и файлы.
Глубокий взгляд на динамические фильтры:
- они применяются во время выполнения запроса, но требуют participation источников, которые могут подать значения на ранних этапах;
- динамические фильтры снижают расход сетевых ресурсов и ускоряют обработку, особенно в сценариях, где размер входных данных велик;
- совместимость с коннекторами различна; не все коннекторы поддерживают эффективное динамическое разделение или dynamic filtering на уровне источника.
Динамические фильтры в сочетании с partition pruning на Iceberg и Hive часто приводят к значительной экономии времени выполнения и снижению IO. Однако при отсутствии поддержки коннектора их реализация может быть ограничена, и оптимизатор применяет динамические фильтры менее агрессивно или не применяет их.
Оптимизация порядка соединений: cost-based join ordering и динамическая фильтрация
Оптимизация порядка соединений имеет критическую роль в производительности запросов, особенно в распределённых средах, где чтение и перераспределение данных по сети являются узкими местами. В Trino применяется Cost-Based Optimization (CBO), который использует статистику таблиц и конфигурацию сессий для выбора порядка соединений, а также стратегий распределения (Partitioned vs Broadcast) и возможности проброса.
Ключевые принципы:
- последовательность соединений влияет на производительность: чем раньше в планах выполняются соединения больших таблиц, тем выше риск затрат памяти и объём сетевого обмена.
- оптимизатор оценивает разные варианты порядка соединений, опираясь на статистику и доступность информации о размерах отдельных входов и выходах;
- поддержка автоматического перебора соединений (AUTOMATIC) в конфигурации optimizer.join_reordering_strategy; если статистика недоступна, Trino может применить ELIMINATE_CROSS_JOINS как безопасное поведение.
Динамическая фильтрация применяется параллельно с перебором соединений: если build-сторона фильтруется, dynamic filtering может уменьшить количество строк на probe-стороне и упростить план.
Практические рекомендации:
- логически выстраивать запросы так, чтобы большие таблицы становились build-сторонами и попадали на ранних стадиях в хэш-таблицу;
- использовать статистику и ANALYZE для повышения точности оценок стоимости;
- активировать adaptive join-reordering (адаптивная переупорядочиваемость) для сценариев с недоступной статистикой, чтобы система могла динамически подстроить порядок соединений во время выполнения;
- учитывать возможные skew-риски - если распределение по ключу соединения неравномерное, оптимизация может потребовать дополнительных манёвров (например, перераспределение данных, кастомизация параметров).
Эффективная оптимизация порядка соединений с учётом динамики выполнений помогает сократить время отклика и улучшить масштабируемость аналитических задач.
Типы соединений и стратегии распределения: PARTITIONED JOIN, BROADCAST JOIN, HASH JOIN
В распределённых системах выбор стратегии соединения существенно влияет на потребление памяти, сетевые затраты и общую пропускную способность. Trino поддерживает три базовых типа соединений:
- PARTITIONED JOIN (партиционированное соединение) - данные обеих таблиц распределяются по узлам на основе хеш-ключа соединения. Каждое узло выполняет локальное соединение своей части данных, и результат затем собирается. Преимущества: подходит для больших таблиц, не требует полной памяти на каждом узле; ограничение - требует значительной сетевой передачи (shuffle) и потенциально затрат на балансировку, особенно при сильном skews.
- BROADCAST JOIN (широковещательное соединение) - меньшая таблица реплицируется на все узлы, где выполняется соединение. Преимущества: низкая задержка и меньшая нагрузка на сеть по сравнению с hash-join при больших таблицах, если build-сторона умещается в память каждого узла. Ограничение: build-сторона должна помещаться в RAM каждого узла; в противном случае может возникнуть OOM или деградация производительности.
- HASH JOIN (хеш-join) - общая реализация, которая может использовать различные стратегии распределения. В базовом варианте операция включает построение хеш-таблицы по build-стороне и последовательное сканирование probe-стороны. В случае partitioned join данные распределяются по ключу, а затем хеш-таблицы строятся на основе локальных подмножек данных. Broadcast-join - специализация построения хеш-таблицы на каждой ноде на всей build-стороне; Partitioned-join - распределение по ключу и локальные хеш-таблицы.
Эти режимы управляются параметрами join_distribution_type и join_reordering_strategy. В режиме AUTOMATIC оптимизатор выбирает между Partitioned и Broadcast в зависимости от статистики и размера входов. В некоторых случаях следует вручную ограничивать размер реплицируемой таблицы (join_max_broadcast_table_size) или зафиксировать тип распределения (join_distribution_type = BROADCAST или PARTITIONED), чтобы предотвратить неэффективные планы.
Понимание особенностей каждого типа подключения помогает проектировать запросы так, чтобы минимизировать сетевой трафик и избегать OOM. При работе с Iceberg/Hive коннекторами динамическая фильтрация и статистика позволяют избегать чрезмерных перемещений данных и использовать оптимальные схемы распределения.
Обмен данными между узлами: Exchanges, RemoteSource и LocalExchange
Exchanges (обмены) - это механизм передачи промежуточных данных между узлами в рамках разных стадий запроса. Их задача - обеспечить корректный поток данных между фрагментами, особенно когда данные, создаваемые одной стадией, должны быть использованы другой стадией на другом узле.
- RemoteSource - источник данных, который требует получения данных из удалённых источников или с удалённых узлов. Это типичная структура на стороне потребителя, который получает данные от других фрагментов, расположенных на разных узлах.
- LocalExchange - локальный обмен данными внутри одного узла, который используется для коллективного распределения данных, когда несколько драйверов в одной стадии обрабатывают данные и их результаты объединяются.
- HASH, GATHER, и другие механизмы выполнения Exchanges - демонстрируют, как данные перераспределяются и объединяются между фрагментами и стадиями.
Обмены позволяют организовать распределённую обработку, в частности:
- обеспечивает корректное соединение (JOIN) и агрегацию, где данные должны встречаться на одном узле;
- поддерживает потоковую обработку - probe side может обрабатывать данные строка за строкой, не загружая весь набор данных в память;
- позволяет источнику данных напрямую обрабатывать часть операций (pushdown) и тем самым экономить бюджет исполнения.
Понимание роли Exchanges особенно важно, когда проектируются планы для больших наборов данных, где задержки коммуникаций и балансировка загрузки критична для достижения требуемой пропускной способности.
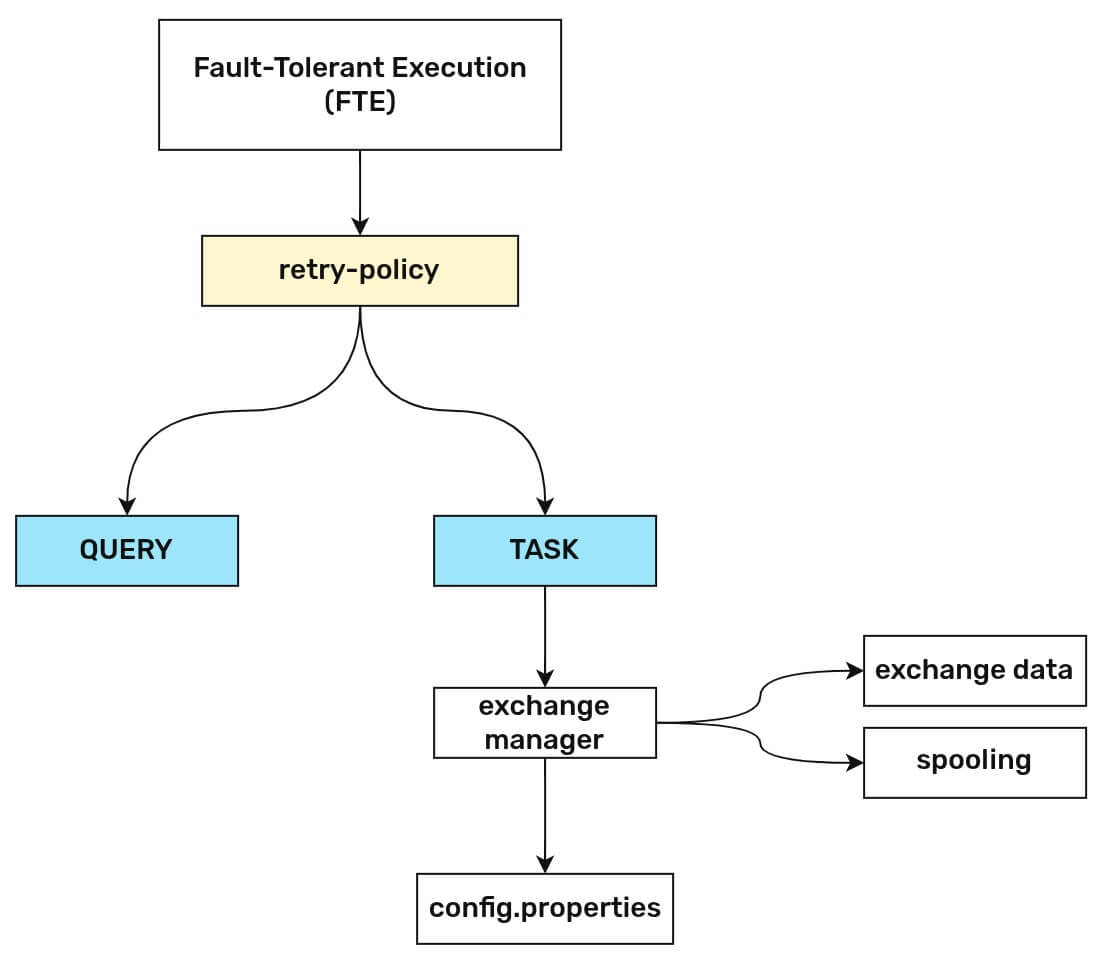
Адаптивное выполнение и fault-tolerant execution
Адаптивное выполнение (Adaptive plan optimizations) - набор механизмов, которые позволяют плану динамически изменяться во время выполнения на основе статистик, собираемых в процессе обработки. В контексте отказоустойчивого выполнения (Fault-tolerant execution) адаптивные оптимизации становятся доступными и активируются соответствующими флагами и параметрами.
Ключевые особенности адаптивного выполнения:
- адаптивное переупорядочивание распределённых соединений (Adaptive reordering of partitioned joins) - позволяет динамически менять порядок входных данных для соединений в процессе выполнения, что особенно полезно, когда исходная статистика недоступна или неточна.
- адаптивные изменения плана в ответ на реальную загрузку, распределение и задержки - система может перестраивать стадии и пересчитать распределение задач, чтобы снизить узкие места.
- отключение адаптивной переупорядочиваемости позволяет зафиксировать план и повысить предсказуемость в окружении с ограниченными ресурсами.
Fault-tolerant execution обеспечивает отказоустойчивость выполнения запросов: если возникают сбои узла, система может повторить выполнение части операций или задачи на другом узле. При этом промежуточные данные могут быть сохранены в поддерживаемом хранилище (например, HDFS, S3) и продолжить выполнение после восстановления, что снижает вероятность полного провала запроса.
Адаптивные механизмы требуют дополнительных ресурсов, и их использование требует соответствующей настройки. Включение и настройка adaptive planning обычно осуществляется через параметры fault-tolerant-execution-adaptive-query-planning-enabled и fault-tolerant-execution-adaptive-join-reordering-enabled, которые регулируют поведение адаптивного планирования как на уровне всей сессии, так и на уровне конкретного запроса.
Iceberg и Hive коннекторы: архитектура, метаданные и функциональность pushdown
Iceberg и Hive являются двумя ключевыми коннекторами для развёртывания аналитических сценариев в Trino, особенно в контексте больших хранилищ данных и lakehouse-подхода. Они различаются по архитектуре и по тому, как управляются метаданные и манифесты файлов:
-
Iceberg коннектор реализует работу с форматом Apache Iceberg, который строится вокруг файлового уровня и метаданных, хранящихся внутри Iceberg-таблиц. Iceberg хранит пути к файлам данных в метаданных, а изменения таблицы атомарны. Данные Iceberg могут храниться в Parquet/ORC/AVRO внутри файловой системы, будь то HDFS или объектное хранилище. Iceberg поддерживает версии спецификаций (v1 и v2), функциональные возможности в области торговле данными, а также продвинутые механизмы: манIFEST-файлы, файлы данных, snapshot-ы и фильтры по партициям. Коннектор Iceberg поддерживает широкий набор конфигурационных параметров, включая общие параметры Iceberg (каталоги, формат файлов, компрессию и т. д.) и специфические функции, такие как управление метаданными, динамическое фильтрование, partition filtering и т. д.
-
Hive коннектор обеспечивает доступ к данным, которые хранятся в файлах под управлением Hive Metastore (HMS). В Hive хранение метаданных осуществляется в HMS, а сами файлы данных - в файловой системе (HDFS, S3). В Trino Hive коннектор обеспечивает доступ к данным, используя Hive Metastore для получения информации о расположении партиций и таблиц. Hive коннектор поддерживает pushdown предикатов и проекций в известной мере, но размер файла и детальные статистики могут различаться по версии Hive и особенностям HMS. В контексте Iceberg Hive-каталог может использоваться как источник метаданных и совместно с Iceberg реализацией. Hive-коннектор является важной частью экосистемы, но Iceberg часто обеспечивает более богатую метаинформацию и возможности динамического фильтрования где они применимы.
Ключевые механизмы pushdown в Iceberg/Hive коннекторах:
- Predicate Pushdown: проброс WHERE и JOIN условий в источники, чтобы фильтровать данные на уровне файлов и разбивок.
- Projection Pushdown: ограничение на чтение только тех столбцов, которые действительно нужны для запроса.
- Dereference Pushdown: ограничение чтения подполей внутри структур типа ROW (STRUCT), что особенно полезно при наличии вложенных полей.
- Aggregation Pushdown: перенос части агрегирования в коннектор, если форма запроса и поддержка коннектора допускают это.
- Join Pushdown: перенос соединения в источник данных, когда это возможно и соответствует условиям для проброса предикатов и доступности данных в коннекторе.
Iceberg-хранилище с поддержкой распределённых метаданных, статических и динамических фильтров предоставляет эффективные механизмы prune-фильтров и оптимизирует план выполнения за счёт метаданных файлов. Hive-каталог традиционно работает через HMS и может использовать Spark-метаданные и внешние каталоги, что требует аккуратного подхода в конфигурациях. В целом, Iceberg-коннектор часто обеспечивает более широкие возможности pushdown и динамического фильтрования, нежели Hive-коннектор, благодаря своей архитектуре метаданных.
Каталоги и конфигурация коннекторов: Iceberg, Hive, Postgres, S3 и др.
Каталог в Trino - это единица конфигурации, которая описывает подключение к конкретному источнику данных через соответствующий коннектор. Каталоги состоят из файла свойств, который хранится в etc/catalog, и идентифицируется именем каталога. Имя файла определяет имя каталога, и в конфигурации обязательно должно присутствовать свойство connector.name, которое указывает на используемый коннектор.
Пример конфигурации Iceberg/ Hive коннектора может включать:
- connector.name=iceberg
- iceberg.catalog-type (или другой параметр, в зависимости от версии используемого Iceberg)
- hive.metastore.uri и другие параметры, если применяется Hive Metastore
- fs.xxx параметры, указывающие на файловую систему
- статистика и расширенные параметры iceberg.extended-statistics.enabled и т. д.
Важно понимать, что каждый коннектор имеет собственный набор параметров конфигурации и собственную логику интеграции. В частности, Iceberg-коннектор требует указать конфигурацию Iceberg метастора (catalog type), формат файлов, возможно, настройки file layout и параметры, связанные с Hive/MS или Nessie/Glue/REST-каталогами. Hive-коннектор требует конфигурацию Hive Metastore (hive.metastore.uri) и параметры доступа к файловой системе, а также параметры форматов файлов (ORC/Parquet) и поддержки разделов.
Каталоги позволяют соединить Trino с несколькими источниками данных, даже если они используют разные коннекторы. Например, можно иметь два каталога Hive с различной настройкой, один Iceberg-коннектор для lakehouse, и несколько каталожных коннекторов PostgreSQL для доступа к разным БД. Анализ конфигурации каталогов помогает оптимизировать план выполнения, когда источник данных различается по качеству статистики и пропускной способности.
Ключевые практики:
- разделение конфигураций по каталогу для разных источников облегчает мониторинг и доступ к данным;
- в конфигурациях Iceberg рекомендуется включать параметры, связанные с метаданными и фильтрами, чтобы использовать динамические фильтры и pushdown;
- учет форматов файлов и межконнекторной совместимости; многие коннекторы требуют согласованности с соответствующим форматом хранения;
- использование Nessie-каталога может обеспечить управление схемами и версионирование.
Метаданные Iceberg: файлы данных, manifest, snapshots и фильтры по партициям
Iceberg - современный табличный формат, ориентированный на масштабируемость аналитических рабочих нагрузок. Iceberg хранит данные и метаданные вне отдельных таблиц, обеспечивает atomicity изменений, и предоставляет богатую метаинформацию, которая может быть использована планировщиком для эффективного чтения.
Основные элементы Iceberg:
- Файлы данных - Parquet/ORC/AVRO-файлы, которые содержат сами данные таблицы.
- Manifest-файлы - списки файлов данных и другая информация, служащая для ускорения чтения и фильтрации; они содержат информацию о статистике по файлам и по партициям.
- Snapshots - версия состояния таблицы на конкретный момент времени; каждый снепшот отражает набор файлов и метаданные соответствующей версии таблицы.
- Фильтры по партициям - Iceberg поддерживает фильтрацию по партициям с применением предикатов, что позволяет исключать чтение целых партиций ещё на ранних этапах чтения.
Преимущества Iceberg в контексте планирования - способность prune файлы и партиции на базе метаданных, что позволяет значительно снижать объем данных, подлежащих сканированию. Это особенно важно в сценариях динамического разделения и динамической фильтрации, когда фильтры на уровне данных позволяют ограничить количество файлов, обрабатываемых во время выполнения. Iceberg поддерживает дополнительные административные операции, такие как VAC и COMPACT, MERGE, EXPERIMENTAL features и другие операции, которые помогают поддерживать целостность и эффективность файлового хранилища.
Взаимодействие Iceberg-коннектора с Trino обеспечивает использование манифестов и снепшотов для оптимального чтения и фильтрации-помимо прочего - при работе с партиционированными таблицами и динамическими фильтрами. Iceberg-метаданные позволяют Trino уменьшить число файлов и участков, на которые приходится накладывать фильтры, что приводит к ускорению выполнения запросов и снижению объема IO.
Кейсы применения в реальных сценариях: примеры запросов и производительности
Рассматривая реальные сценарии применения Trino, можно выделить несколько типовых кейсов, которые иллюстрируют преимущества pushdown, динамической фильтрации и адаптивного выполнения:
- Кейс A: аналитика продаж в розничной сети. Использование Iceberg-схемы и Hive-метастора позволяет выполнить предикаты по дате, региону и SKU на уровне источника, а затем агрегировать результаты в Trino. Predicate Pushdown и Partition Pruning позволяют существенно уменьшить объем данных, который читается из файлов, и сократить сетевой трафик.
- Кейс B: федеративный запрос к разным источниками (Postgres, S3, Kafka). С помощью каталога и коннектора можно выполнить JOIN между таблицами в Postgres и данными в S3. Важной частью является настройка join_distribution_type и использование dynamic filtering, чтобы уменьшить размер probe-части.
- Кейс C: анализ клиринговых транзакций в финансовом секторе. Iceberg-коннектор позволяет выполнять агрегации и фильтры на уровне манифестов и Snowflake/Glue-метаданных. Top-N и сортировка могут быть проброшены на источники, когда это поддерживается. Это позволяет выполнить запрос с минимальным временем ожидания.
- Кейс D: обработка телекоммуникационных журналов. Много таблиц в Iceberg и Hive, включая вложенные типы, где dereference pushdown ограничивает чтение только нужных полей внутри ROW(). Это приводит к существенно меньшей памяти и IO.
Эти кейсы демонстрируют важность балансирования решений между pushdown, динамическими фильтрами и стратегиями соединений, учитывая особенности форматов данных и доступную статистику.
Интеграция технологических стеков: HMS, Glue, Nessie, S3, HDFS и т.д.
Интеграция Trino с внешними системами и стеком сервисов требует внимания к совместимости и конфигурации:
- HMS (Hive Metastore) - центральная служба хранения метаданных Hive. В контексте Hive-коннектора HMS обеспечивает доступ к метаданным таблиц и партиций. Владение несколькими HMS-каталогами позволяет разделить данные по проектам или по принадлежности к разным дата-лейкам.
- Glue Catalog (AWS Glue) - управляет метаданными в облаке AWS и служит альтернативой HMS. Поддержка AWS Glue как каталог позволяет интегрировать данные в S3 и упрощает чтение таблиц, управляемых Glue.
- Nessie - сервис версионирования схем в рамках лейк-флоу. Nessie позволяет управлять версиями "таблиц" и схем в Iceberg, обеспечивая стабильность в течение развёртываний и миграций. В контексте Trino Nessie может служить источником каталогов и обеспечивать эволюцию схем без разрушительных изменений.
- S3, HDFS, GCS, Azure Blob - файловые хранилища, которые могут быть источниками данных как для Iceberg, так и для Hive. Конфигурация каталога должна обеспечивать совместимость с форматом хранения, профиль с доступом и параметры кэширования.
- Прочие коннекторы - Cassandra, ClickHouse, OpenSearch, Prometheus и др. Они расширяют горизонт анализа и дополняют возможности федеративной аналитики.
Важно: интеграции требуют аккуратного управления доступом, сетевыми настройками и согласованностью в рамках планирования. В процессе эксплуатации рекомендуется внимательно следить за задержками доступа к HMS/Glue и за временем ответа на метаданные, поскольку это может стать узким узлом в плане выполнения для больших запросов.
Применение в экономических секторах: финансы, розничная торговля, телеком и гос сектор
Применение Trino в экономических секторах требует учёта ряда специфических факторов: конфиденциальности, скорости ответа на бизнес-органы, а также устойчивости к нагрузкам и обеспечению согласованности данных.
- Финансы - критично точное планирование и быстрый доступ к историческим данным. Iceberg-хранилища в сочетании с Hive-метасторой через Iceberg-коннектор позволяют реализовать системные запросы к данным за большие периоды, обеспечивая безопасную фильтрацию по партициям и эффективный доступ к данным. Использование dynamic filtering и Top-N pushdown может повысить производительность при анализе больших наборов финансовых журналов.
- Розничная торговля - большой объём данных, обработка событий, накладные расходы и требования к SLA. Predicate Pushdown и Partition Pruning помогают снизить затраты на чтение больших таблиц по признакам, имеющим бизнес-ценность (регион, категория, время).
- Телеком - объём телеметрических данных большой; эффективная планировка и корректная маршрутизация соединений (Broadcast vs Partitioned) позволяют ускорить обработку и улучшить отклик аналитических запросов в режиме near real-time.
- гос сектор - часто требуется Federated запросы к разным системам, высокая надёжность и управляемость. Конфигурации каталогов и сите: HMS, Nessie для эволюции схем, а также интеграция с HDFS/S3 для хранения.
Во всех случаях критически важны: управление статистикой, поддержка pushdown, адаптивность выполнения и мониторинг. В сочетании с Iceberg/Hive коннекторами это обеспечивает баланс между эффективной загрузкой данных и надёжностью.
Риски, уязвимости и ограничения: память, сеть, статистика, skew
Любые распределённые аналитические системы сопряжены с рисками и ограничениями:
- память и spill-to-disk: для больших запросов и сложных планов может потребоваться активировать spill-to-disk; если пороговые значения неверно настроены, система может столкнуться с переполнением памяти или чрезмерной задержкой.
- сеть и перераспределение данных: hash join и shuffle требуют значительного сетевого обмена. Skew по ключам может привести к неравномерному распределению нагрузки и ухудшению производительности.
- статистика и предположения: отсутствие актуальной статистики приводит к менее точному выбору плана, что может увеличить время выполнения. В таких случаях рекомендуется собирать статистику через ANALYZE и поддерживать версии коннекторов.
- поддержка pushdown-вычислений: не все коннекторы поддерживают полный набор pushdown-функций; частичность или отсутствие pushdown может влиять на эффективность запроса.
- совместимость коннекторов: Iceberg/Hive и другие коннекторы имеют разные уровни поддержки функций pushdown, доступ к метаданным и способы обновления статистики. Важно тщательно тестировать и валидировать планы выполнения.
- управление партициями: некорректные настройки Hive-конфига или Iceberg-конфига могут привести к конфликтам или неправильной работе при работе больших наборов данных. Требуется корректная настройка hive.metastore.uri, iceberg.ticket и связанных параметров.
- безопасность и доступ: федеративные запросы требуют надлежащей настройки доступа между источниками и соответствующим ограничением прав.
Управление этими рисками требует политики мониторинга и наставлений по эксплуатации: контроль памяти, мониторинг задержек сети и использование EXPLAIN/ANALYZE для анализа планов, регулярное обновление статистики, а также осторожный подход к настройке параметров по умолчанию.
Метрики эффективности и мониторинг: EXPLAIN, estimates, cpu, memory, network
Мониторинг и оценка эффективности запросов в Trino строится на нескольких ключевых метриках и инструментах:
- EXPLAIN и EXPLAIN ANALYZE - позволяют просмотреть план выполнения и, в случае ANALYZE, фактические статистические данные по времени выполнения, расходу CPU, памяти и сети. Эти данные полезны для понимания того, где возникают узкие места и как влияет pushdown.
- Estimates - значения, присутствующие в EXPLAIN, отражают предсказанные показатели по объему строк, объему данных, CPU, памяти и сети. Это служит основой для оценки стоимости узлов плана и выбора оптимального варианта.
- CPU, Memory, Network - ресурсы сигнальные параметры: сколько CPU времени, сколько памяти и какой сетевой трафик потребляется на конкретном узле или стадии. Эти данные полезны для диагностики производительности и планирования инфраструктуры.
- Spending Spills и использование локального диска - в контексте spill-to-disk, метрики по объему данных, выгруженных на диск, и влияние на производительность.
- Статистика по сплитам и файлам - количество чтения файлов, количество файлов, выполненная работа, и прочие параметры, связанные с IO.
- Метрики эксплуатации и устойчивости - в Fault-tolerant execution могут быть метрики по повторному выполнению задач и их эффективности.
Эти метрики используются для оптимизации конфигурации, таких как memory limits, spill thresholds и параметры join-distribution, а также для принятия решений по архитектуре исполнения и выбору наиболее подходящих коннекторов и каталогов.
Конкурентный анализ и дифференциация: сравнение с Spark SQL, Athena, BigQuery, Snowflake
На рынке существуют несколько альтернативных систем для исполнения SQL-запросов над большими данными, таких как Spark SQL, AWS Athena, Google BigQuery и Snowflake. Ниже приведено краткое сравнение в контексте ключевых характеристик, которые важно учитывать:
-
Распределённость и архитектура:
- Trino - в первую очередь распределённый движок выполнения с координацией на рамках кластера; поддерживает федеративные запросы и широкую интеграцию коннекторов.
- Spark SQL - часть экосистемы Apache Spark, ориентирован на обработку в рамках экосистемы Spark и может использовать Spark SQL через DataFrame API. Эффективность зависит от уровня параллелизма и оптимизации Spark.
- Athena - управляемый сервис AWS, базируется на Presto-подобной архитектуре; упор на простоту использования и интеграцию в экосистему AWS.
- BigQuery - полностью управляемый сервис Google Cloud; ориентирован на аналитические запросы с хорошей поддержкой колонно-ориентированного хранения и параллельного выполнения.
- Snowflake - облачный аналитический сервис, который обеспечивает широкий набор функций и оптимизированное хранение. Snowflake имеет собственную модель выполнения и управления микропартиями.
-
Pushdown и оптимизация:
- Trino часто демонстрирует сильную гибкость в pushdown и сериализацию, особенно в Iceberg/Hive коннекторах, и способен адаптивно управлять планами.
- Spark SQL и BigQuery поддерживают некоторые формы pushdown, но архитектурно отличаются (например, собственные оптимизаторы в Spark, столбцовые форматы в BigQuery).
- Athena и Snowflake - ориентированы на управляемую инфраструктуру и интеграцию; pushdown в этих системах реализуется внутри их собственных движков.
-
Интерфейс федеративной аналитики:
- Trino - сильная сторона - федеративные запросы через множество коннекторов.
- Snowflake и BigQuery в рамках своей платформы предоставляют обзор на собственные данные и внешние источники через развертывания и внешние функции.
- Spark может объединять данные из разных источников, но федеративные режимы могут требовать отдельных сценариев и технических решений.
-
Контроль над инфраструктурой и развертыванием:
- Trino - гибкость в настройке и развертывании на собственном кластере, требующая ответственности за ресурсы.
- Snowflake - полностью управляемый сервис.
- BigQuery - полностью управляемый сервис от Google.
- Athena - управляемый сервис, интегрированный с AWS;
- Spark - зависит от инфраструктуры и конфигураций.
Выбор между этими системами зависит от множества факторов: требования к федеративной аналитике, характер рабочих нагрузок, нужда в управлении инфраструктурой, требования к задержке и SLA, интеграции с существующими данными и форматами хранения, а также бюджет. Trino особенно полезен, когда нужна гибкость в интеграции с разрозненными источниками и требуеться детальность настройки планирования и расходов.
Практические рекомендации по настройке и оптимизации: параметры join_reordering_strategy, join_distribution_type, spill-to-disk
Для достижения максимальной эффективности в реальном мире следует учитывать набор практических рекомендаций:
- join_reordering_strategy:
- AUTOMATIC - автоматическое перебор соединений, основанное на статистике.
- ELIMINATE_CROSS_JOINS - устранение ненужных кросс-соединений.
- NONE - сохранять синтаксический порядок соединений.
Рекомендуется использовать AUTOMATIC как базовую стратегию, но при отсутствии достоверной статистики можно временно переключиться на ELIMINATE_CROSS_JOINS.
- join_distribution_type:
- AUTOMATIC - автоматический выбор между BROADCAST и PARTITIONED на основе статистики и размера входов.
- BROADCAST - принудительное использование рассылочного соединения.
- PARTITIONED - принудительное использование распределённого соединения.
Рекомендуется оставлять AUTOMATIC, но ограничивать размер реплицируемой таблицы, чтобы избежать OOM. По умолчанию join-max-broadcast-table-size ограничен 100 МБ.
- spill-to-disk:
- Включение spill-to-disk позволяет выгружать промежуточные данные на диск в случае нехватки памяти. Включение spill может предотвратить падение запросов, но может привести к дополнительной задержке из-за IO на диск.
Рекомендация: включать spill для крупных операций (агрегации, соединения, сортировки), особенно в случаях, когда доступна память ограничена, или когда данные распределены неравномерно по ключам.
- Включение spill-to-disk позволяет выгружать промежуточные данные на диск в случае нехватки памяти. Включение spill может предотвратить падение запросов, но может привести к дополнительной задержке из-за IO на диск.
- memory limits:
- query.max-memory, query.max-memory-per-node - ограничивают потребление памяти. Устанавливайте в соответствии с размером и характеристиками кластера, чтобы избежать перегрузки фактической памяти и нестабильности.
- dynamic filtering / partition pruning:
- Для Iceberg-таблиц рекомендуется включать динамическое разделение и динамическую фильтрацию. Это позволяет фильтровать файлы и партиции ещё до точного выполнения join, снижая нагрузку.
- statistics:
- Включите ANALYZE для Iceberg/Hive коннекторов, если данные часто обновляются без участия Trino. Следует обеспечить актуальную статистику для лучших решений плана.
- projection pushdown:
- Включение projection pushdown снижает количество считываемых колонок и, следовательно, размер IO, что особенно полезно для больших таблиц с широкими схемами.
- adaptive planning:
- Включение адаптивного планирования полезно в условиях неопределённой статистики. Оно может уменьшить время выполнения за счёт переработки плана во время исполнения и устранения узких мест.
- мониторинг и алерты:
- Настройте мониторинг планов и метрик исполнения, включая EXPLAIN-выводы, сетевые показатели и использование CPU/memory, чтобы быстро выявлять узкие места и настраивать параметры.
Эти рекомендации следует адаптировать под реальную инфраструктуру и требования к SLA. В ряде случаев полезно провести профилирование на тестовом наборе данных для определения оптимального набора параметров.
Заключение и направления дальнейших исследований
Trino как платформа для распределённого выполнения SQL-установок демонстрирует сильную гибкость и широкие возможности для интеграции с различными источниками данных. Концептуальное ядро состоит в эффективном планировании и динамической оптимизации: pushdown, динамическая фильтрация, адаптивное планирование и стратегические решения по типам соединений. Важной ролью играют Iceberg и Hive коннекторы в контексте фильтрации по партициям, управления метаданными, а также в использовании манифестов и снепшотов Iceberg для ускорения чтения.
Передовые практики включают: поддержание актуальной статистики, оптимизацию порядка соединений и выбора стратегий соединения через параметры join_reordering_strategy, join_distribution_type; использование spill-to-disk для устойчивости к сценариям выше определённой памяти; а также активное применение динамических фильтров и partition pruning в Iceberg-вокруг. В комбинации с Nessie, Glue Catalog и HMS можно получить мощную и гибкую экосистему управления данными.
Здесь представлен концептуальный обзор механизмов: от архитектуры координационного узла и воркеров до реализации интерактивных паттернов, таких как Predicate Pushdown, Projection Pushdown, Dynamic Filtering и Top-N Pushdown. Все обсуждаемые темы лежат в основе практических подходов к проектированию и эксплуатации аналитических систем на базе Trino в современных корпоративных средах.
Дальнейшие направления исследований и развития включают:
- усовершенствование автоматического выбора планов в условиях слабой или недоступной статистики;
- расширение поддержки pushdown-коннекторов и стандартов, особенно в контексте новых форматов хранения и хранилищ;
- исследование динамических схем и эволюционных паттернов в Iceberg Nessie-каталогах;
- улучшение мониторинга планов, включая визуальные инструменты для сравнения планов, а также глубокий анализ латентной задержки и задержек в Exchanges.
В конце статьи представлены вопросы и ответы, резюмирующие ключевые тезисы и выводы.
Вопрос-Ответ:
-
Вопрос: Какой механизм отвечает за перенесение вычислений предикатов в источники данных?
Ответ: Predicate Pushdown - механизм переноса предикатов в источники данных для фильтрации на уровне файлов и сегментов. Это сокращает объём считывания и ускоряет выполнение, при условии, что коннектор поддерживает проброс. -
Вопрос: Что означает термин «statement» в контексте Trino?
Ответ: Statement - это текст ANSI SQL-запроса, который отправляется пользователем, тогда как query - это внутреннее представление этого оператора с планом выполнения, созданное для распространённого исполнения на кластере. -
Вопрос: Какие типы соединений бывают в Trino?
Ответ: PARTITIONED JOIN, BROADCAST JOIN и HASH JOIN. PARTITIONED JOIN распределяет данные по узлам, BROADCAST JOIN реплицирует меньшую таблицу на всех узлах, а HASH JOIN - классический реализация через хеш-таблицу, с выбором стратегии распределения. -
Вопрос: Какие инструменты мониторинга рекомендуется использовать для оценки планов?
Ответ: EXPLAIN и EXPLAIN ANALYZE для анализа планов, а также метрики CPU, memory, network, estimation ряда и статистической информации. Эти инструменты позволяют сравнивать варианты планов и выбирать оптимальный. -
Вопрос: Как Iceberg коннектор влияет на производительность?
Ответ: Iceberg коннектор дает богатые метаданные (manifests, snapshots, partition information), что позволяет эффективно prune файлов и partitions, а также поддерживает pushdown и динамическое разделение, улучшая производительность по сравнению с традиционными моделями хранения. -
Вопрос: Какие ограничения существуют при Top-N Pushdown?
Ответ: Top-N Pushdown зависит от поддержки коннектора и конкретного запроса. В некоторых случаях источник может обрабатывать Top-N и вернуть первые N строк на стороне источника; в других случаях, если коннектор не поддерживает Top-N, Trino выполняет его локально, что может увеличить нагрузку на память и IO. -
Вопрос: Какие риски связаны с различной поддержкой статистики для коннекторов?
Ответ: Неполная или устаревшая статистика может привести к неверному выбору плана, увеличению времени выполнения. Регулярная актуализация статистики через ANALYZE и SHOW STATS, а также учет ограничений конкретного коннектора помогут снизить риск. -
Вопрос: Какой подход к конфигурации параметров рекомендуется для повышения устойчивости?
Ответ: Рекомендуется использовать AUTOMATIC для join_distribution_type и join_reordering_strategy, включить spill-to-disk для тяжелых операций, корректно настроить memory limits и активировать adaptive planning в сценариях, когда статистика недоступна. Также важно поддерживать актуальную статистику и тестировать планы исполнения на тестовых данных. -
Вопрос: Какие архитектурные преимущества представленности координатора и воркеров в контексте федеративной аналитики?
Ответ: Координатор обеспечивает единый контролируемый порт управляющего слоя и эффективное распределение задач между воркерами, а воркеры исполняют операции с данными на конкретных узлах, что позволяет параллельно обрабатывать множество источников данных и создавать интегрированные ответы «из разных миров» без централизованного переноса. -
Вопрос: Какие роли играют каталоги и коннекторы в реализации pushdown?
Ответ: Каталоги задают параметры доступа к источнику данных и выбор коннектора; коннектор реализует API доступа к данным и поддерживает механизмы pushdown (predicate, projection, dereference). Эффективность pushdown зависит от возможностей коннектора и от того, как он умеет работать с метаданными источника. -
Вопрос: Какую роль играет Dynamics в Iceberg/Hive интеграциях?
Ответ: Dynamic Filtering и Dynamic Partition Pruning используют метаданные таблиц Iceberg и/или Hive для фильтрации файлов и партиций до выполнения join, что значительно снижает входной объем данных и ускоряет выполнение, особенно в больших данных. -
Вопрос: Что нужно учитывать при планировании миграций и эволюции схем?
Ответ: Необходимо учитывать эволюцию схемы Iceberg, включая безопасное добавление/удаление/переименование колонок. Nessie может помочь в управлении версиями схем. При миграциях следует тестировать совместимость коннекторов, обновления метаданных и влияние на планирование. -
Вопрос: Какие ограничения по памяти стоит учитывать в контексте распределённых соединений?
Ответ: Для Broadcast JOIN размер build-стороны должен помещаться в память каждого узла. В противном случае выбор стратегии может привести к OOM. Partitioned Join требует большей сети, но уменьшает требования к памяти, распределяя нагрузку между узлами. Балансировка между этими стратегиями и корректная настройка join_max_broadcast_table_size являются критическими для устойчивой эксплуатации. -
Вопрос: Какие практики применяют для ускорения работы с Iceberg-таблицами?
Ответ: Использовать динамическое фильтрование, partition pruning, pushdown проекций, агрегаций там, где это поддерживается коннектором, а также выполнять ANALYZE и эффективное управление манифестами и файлами. Iceberg метаданные позволяют значительно сократить объем данных и ускорить планирование.
Эта статья даёт целостную картину архитектуры, механизмов планирования и практических подходов к оптимизации выполнения запросов в Trino, подчеркивая роль пула коннекторов и каталога, а также раскрывая принципы pushdown, динамических фильтров, оптимизации порядка соединений и адаптивного исполнения.