

Многослойный Data Lineage
Наглядная карта, показывающая то, как данные связаны и перемещаются в течение своего жизненного цикла, - мечта любой организации. Стремление заполучить инструмент, соединяющий колонки, таблицы и дашборды в едином хранилище, вполне можно сравнить с золотой лихорадкой. Но, как и добыча золота, эта задача не из легких ...
Раньше отслеживание data lineage проводилось вручную, и было доступно далеко не каждому. Обычно только те, кто ежедневно работает с процессами преобразования данных, знают о фактическом потоке данных – и то, как правило, этот видение представляет собой гремучую смесь из того, что у них в голове и задокументированной информации.
К счастью, постепенно мы начали отходить от ручного процесса и автоматизировали data lineage, например, путем парсинга файлов SQL . Инструменты data lineage (каталогизация данных, качество данных, управление данными...) открыли перед нами совершенно новые возможности обеспечения надежности данных и их наблюдаемости в хранилище. По сути, эта автоматизация позволила пользователям создавать собственные визуализации, позволяющая ответить на многие вопросы:
- В каких моделях есть ошибки и каково их влияние на экосистему?
- Кто использует эти данные? Этот дашборд?
- Как повлияет удаление столбца или модели на всю аналитическую экосистему?
- Что мешает реализации моих моделей? Есть ли какие-либо узкие места и если да, то какие? Есть ли еще какие-либо сдерживающие факторы?
К сожалению, если не знать, на что именно обращать внимание, data lineage может оказаться непосильной задачей, поскольку необходимо будет работать со слишком большим количеством уровней. Кроме того, объем данных (как и сама организация) имеет тенденцию к росту. Да и для того, чтобы ответить на вопросы, обозначенные выше, нам могут понадобиться различные инструменты (или люди!). Поэтому, если мы хотим повысить корпоративную грамотность в области данных и обеспечить безопасную среду самообслуживания, нам необходимо минимизировать зависимость от людей или инструментов, позволяющих понять, как именно развиваются данные.
Как создать единый интерфейс, который будет понятен абсолютно каждому? Или карту, с помощью которой мы могли бы хорошо ориентироваться в наших активах данных без необходимости привлечения большого количества людей или инструментов? В этом статей мы расскажем Вам о том, как можно применить опыт картографии и Google Maps для того, чтобы раскрыть весь потенциал data lineage и создать идеальный интерфейс, который позволит нам повысить уровень всеобщей грамотности и улучшить наблюдаемость данных.

Картография данных — использование карт для навигации по данным
Картография - это искусство и наука создания и использования карт для эффективной передачи информации о пространстве. К сожалению, универсальных карт не существует. Разные типы карт подходят для отображения разных типов информации. В зависимости от наших потребностей нам могут быть интересны карты с изображением рельефа, рек или дорог определенного региона.
Однако зачастую карты - это не просто один слой данных. Как правило, они содержат многогранную информацию. Существует наложение, когда две или более тематических карт одной и той же территории помещаются друг на друга, образуя новую карту. Для того, чтобы ответить на такой вопрос, как "Где нам построить новый торговый центр?", потребуются наложить сразу несколько слоев данных, таких как доступные зоны застройки, плотность населения, уровень развития транспортной инфраструктуры, высота местности и т. д.

Когда мы говорим о различных слоях наблюдаемости data lineage, мы сталкиваемся с похожей ситуацией. Безусловно, универсальной визуализации, дающей нам целостное представление в доступной форме, не существует. Однако есть одна общая закономерность - все слои data lineage – это не что иное, как грани одной и той же области. Так, если мы хотим проанализировать влияние изменения одного столбца на всю экосистему, мы можем наложить информацию о последующих столбцах, которые будут изменены, о том, затрагиваем ли мы таблицы фактов, и о том, нужно ли нам информировать какие-либо бизнес-подразделения, на которые повлияет это изменение, исходя из права собственности на активы данных.
Если мы сложим все эти слои вместе, то получим представление, очень похожее на то, с которым мы уже знакомы, а именно ER – диаграммы. Мы уже давно используем их для проектирования и моделирования хранилищ данных, однако сейчас они стали намного сложнее, соответственно и нам стало гораздо труднее работать с ними. При всем многообразии моделей и инструментов нет простого способа визуализировать различные пути, по которым могут двигаться данные в хранилище.
В старые добрые времена, когда еще не было Google Maps, для перемещения между городами мы полагалась на визуализированное представление нескольких слоев, сложенных вместе с помощью бумажных карт, ориентиров или друзей, подсказывающих наиболее оптимальный путь. Именно в такой же ситуации мы находимся и сейчас, когда пытаемся понять все связи между данными. Для того чтобы разобраться в том, как именно движутся и развиваются данные, нам по-прежнему требуется объединить информацию из самых разных источников: уведомлений Slack, документов dbt, зависимостей, дашбордов, метрик и т.д.
Если мы не хотим усложнять себе жизнь и не анализировать все это многообразие источников, нам нужно научиться относиться к картам data lineage как к единому источнику правды, который каждый может использовать, анализировать и понимать без необходимости привлекать новые инструменты или просить помощи у коллег. В данном случае мы можем многое почерпнуть из Google Maps и теории графов.
Google Maps
Во время пандемии Google добавили в свою карту слой COVID-19, чтобы пользователям было удобнее получать информацию о распространении коронавирусной инфекции в том или ином регионе и было проще принимать взвешенное решение о том, стоит куда-либо отправляться или нет. Но это не было чем-то совершенно новым для Google Maps. До этого они добавили в свою карту слой для отслеживания регионов распространения лесных пожаров, слой для отслеживания уровня загрязненности воздуха и даже целую платформу, где каждый пользователь мог добавить свой собственный слой в Google Maps. Не стоит забывать и о таких классических вещах, как, например, загруженность трафика. Что объединяет все эти новые функции? А то, что все они представляют собой новый слой поверх старых добрых Google Maps. Нам не нужно разбираться в том, как ими пользоваться - достаточно нескольких кликов, и искомая информация накладывается поверх того, что мы уже знаем.
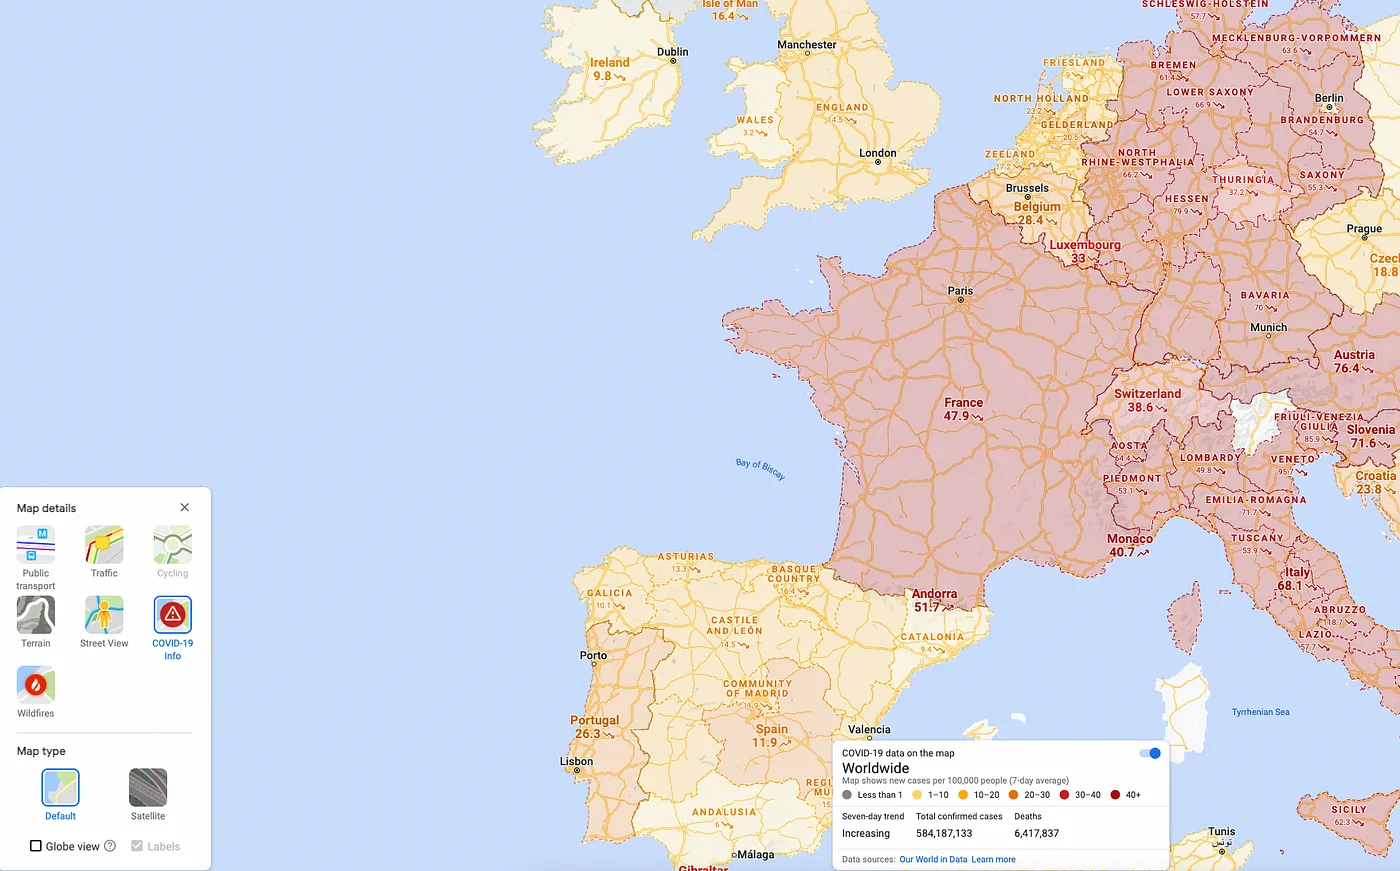
В мире данных бумажными картами, позволяющими нам понять, как именно двигаются данные в хранилище, являются направленные ациклические графы (DAG). Однако текущие визуализации обычно представляют собой статическое представление зависимостей данных, и даже если у нас есть все данные, которые делают эти карты живыми (результаты тестов, время выполнения, потребление ресурсов, история доступа...), нам все равно нужно мысленно представлять, как DAG и метаданные связаны друг с другом. Что, если бы мы могли визуализировать пробки между моделями так же, как Google Maps - между городами? Кажется естественным, что на DAG можно наложить все собранные метаданные.
Уровень производительности
Почему выполнение этой модели занимает так много времени?
Время выполнения, длительность задач, потребление ресурсов - это ключевые показатели, формирующие понимание работы конвейеров данных. Используя эти данные, можно извлечь метрики, указывающие на самые медленные модели или те, которые потребляют больше всего ресурсов. Однако эти показатели обычно представляются по отдельности.
Наложение данных о производительности на DAG может дать гораздо более полное представление о том, как отдельные задачи влияют на производительность всего конвейера данных в целом. На изображении ниже показан пример того, как новый слой визуализации данных может помочь понять, что влияет на время выполнения модели. Чтобы создать этот новый слой, нам нужно только время выполнения каждой задачи и немного теории графов. В следующих статьях мы расскажем Вам о том, как построить визуализацию такого типа.
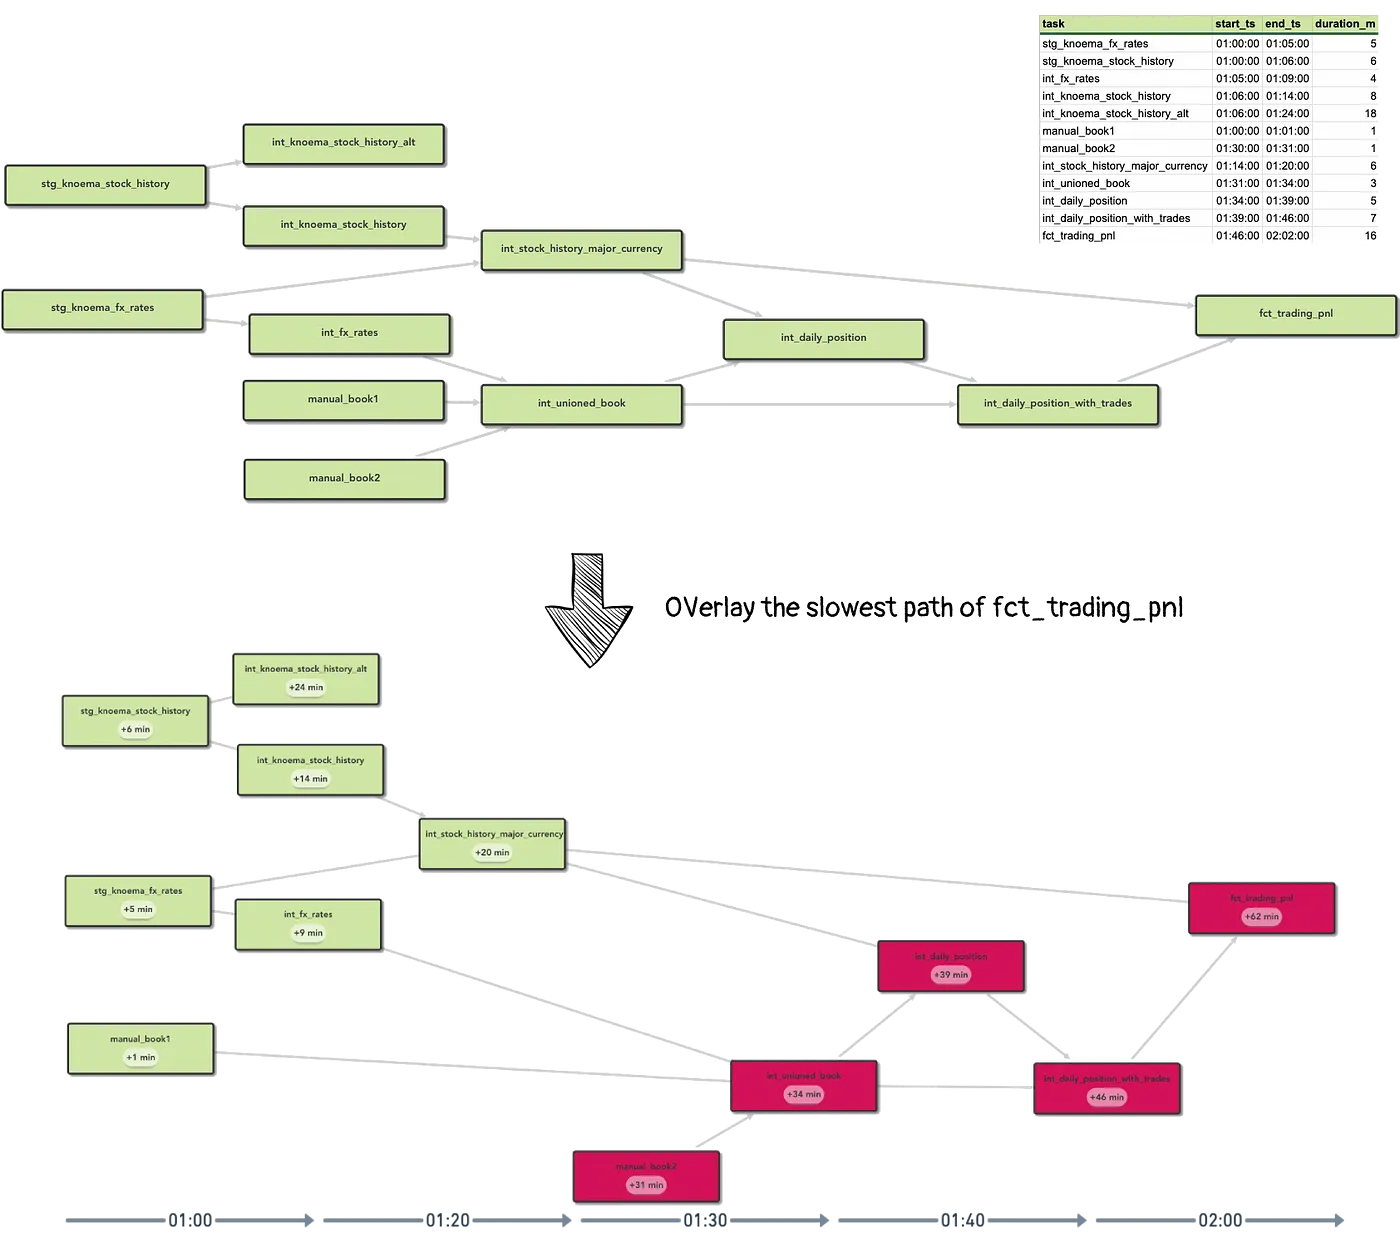
Каждая задача показывает количество времени, которое она добавляет к окончательному выполнению fct_trading_pnl. В данном случае, несмотря на то, что на выполнение manual_book2 уходит всего минута, она запускается позже остальных моделей, добавляя много накладных расходов на время выполнения финальной модели. Ось Y представляет собой временную шкалу для визуализации времени выполнения модели.
Слой использования
Есть ли в хранилище неиспользованные модели?
Этот столбец вообще используется?
Четкое понимание того, кто и как использует данные, - один из первых шагов к поддержанию жизнеспособности хранилища данных. К сожалению, в условиях постоянного роста объема данных это становится все более и более сложной задачей, поскольку очень часто разовые эксперименты проникают в производство или модели перестают соответствовать своему назначению.
Однако благодаря использованию журналов аудита можно извлекать и накладывать всю информацию о доступе и использовании данных на график data lineage. Это поможет сформировать представление о том, какие активы данных больше не используются.
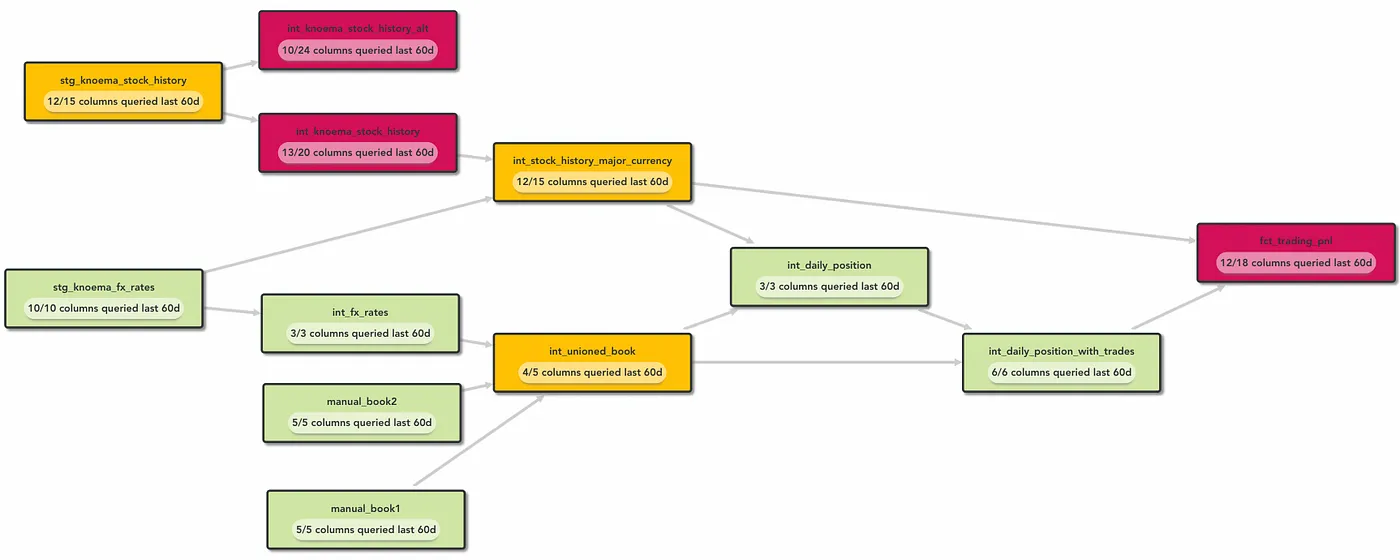
Использование модели на уровне столбцов - каждый узел представляет модель с информацией о том, сколько столбцов было запрошено за последние 90 дней. Градиент столбцов показывает, сколько столбцов не используется: зеленый цвет означает 100-процентное использование, а красный - менее 60 %.
Слой качества данных и многое другое!
Что препятствует выполнению моей модели?
Какая модель недостаточно протестирована? Какой модели не хватает документации?
Как правило, отчеты о тестировании и сбоях моделей составляются по отдельности, однако в реальности сбой или непрохождение теста моделью сказывается на всем хранилище. Например, если модель заблокирована какими-либо зависимостями, заинтересованные стороны должны иметь возможность отследить блокирующие факторы, чтобы лучше понять их влияние без привлечения сторонних специалистов или так инструментов, как Airflow.
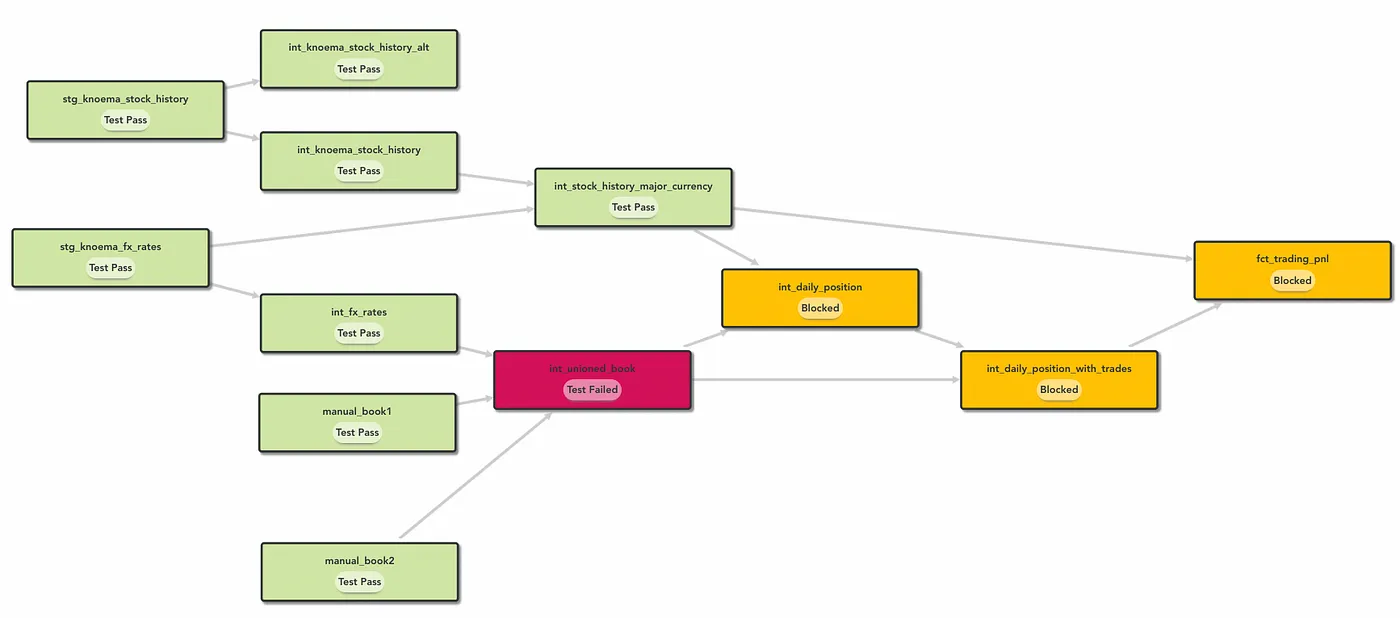
Слой качества данных, показывающий «неудачную» модель (красный цвет) и то, на какие последующие модели она повлияла (оранжевый цвет).
Но качество данных - это не только количество тестов, которые прошла модель. Это также и показатель того, насколько хорошо набор данных подходит для выполнения конкретной задачи. Мы должны думать о слое качества данных как о наборе слоев, отображающих, насколько хороша модель: задокументированы ли таблицы и столбцы? отвечают ли модели данных требованиям SLA? есть ли у них владелец? Все эти аспекты могут быть выделены цветом и представлены в виде нового слоя, что даст нам объективное понимание истинного качества хранилища данных.
Уровень детализации
Одно из главных ограничений data lineage - визуализация очень плотных графов, включающих в себя сотни узлов. Обычно мы пытаемся уменьшить эту гранулярность, создавая подграфы или используя фильтры тегов в dbt-документах, но даже при таких условиях очень сложно получить полное представление о том, как именно все взаимосвязано. Создается ощущение, что мы все еще разворачиваем дорожный атлас формата A1, пытаясь понять, как связаны между собой города.
Опять же, любимые нами Google Maps решили эту проблему, помогая пользователям увеличивать или уменьшать масштаб изображения. При более низких уровнях масштабирования на карте отображаются целые континенты, а при более высоких - детали города. С помощью одного простого действия мы можем легко изменить уровень детализации карты. Если перенести эту концепцию на карты data lineage, то более низкие уровни масштабирования означают, что карта data lineage показывает различные бизнес-области, определенные в хранилище, а более высокие уровни масштабирования означают, что карта может показывать подробности о линиях таблиц или даже столбцов.
Следуя этому предположению, на следующем изображении показана «идеальная» карта, на которой мы можем просматривать различные уровни детализации данных. С помощью этой визуализации мы можем перемещаться от бизнес-уровня, на котором некоторые модели не работают, вниз по моделям, которые заблокированы, а также к столбцам, которые не прошли тестирование. Этот пример также показывает, как различные информационные слои, о которых мы рассказывали выше, могут быть агрегированы с различной степенью детализации, а не только на уровне таблиц.
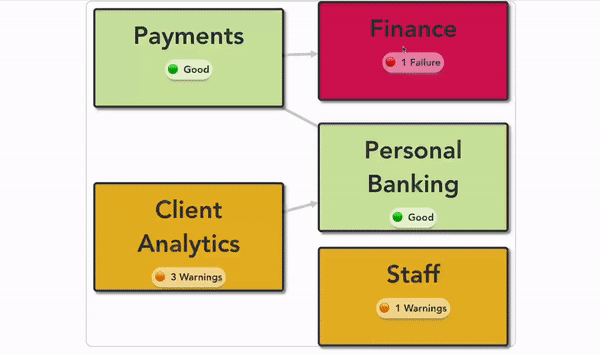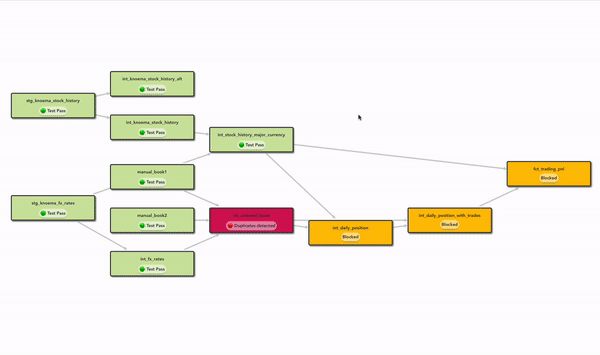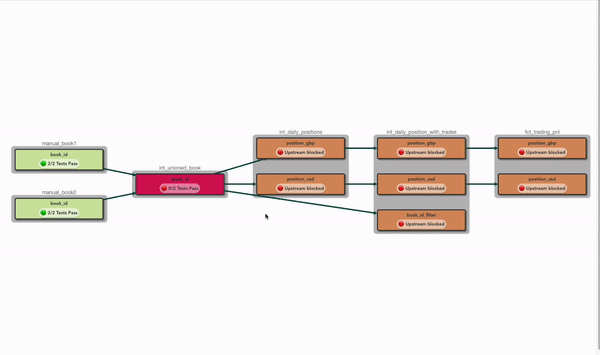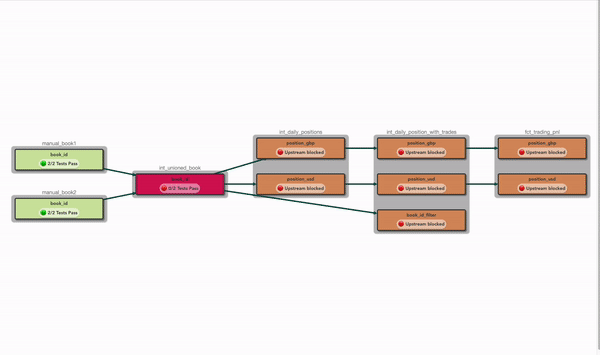
Изменение уровня детализации: от более абстрактного бизнес-уровня до количества столбцов.
В этой статье мы показали Вам, как с помощью одного-единственного интерфейса можно устранить множество барьеров для доступа к данным; карта с бесконечными возможностями расширения для самостоятельной работы.
Однако здесь есть одна оговорка. Если мы хотим устранить абсолютно все барьеры, нам нужно в первую очередь подумать о моделировании данных, и здесь нам не помогут ни data lineage, ни все новые новомодные инструменты в современном стеке данных. Если мы не смоделируем и не каталогизируем данные правильно, мы, по сути, зашифруем хранилище, а data lineage превратится в карту сокровищ, полную загадок и тупиков, и поверьте, единственное сокровище, которое можно найти в конце, - это отчаяние…


