

Модуль 5. Загрузка данных в StarRocks
Методологическое понимание загрузки в StarRocks
StarRocks изначально проектировался как система, способная работать и с batch-загрузками, и с real-time ingestion.
От того, как мы настроим процесс загрузки, зависит:
- насколько свежие данные будут видеть BI-пользователи;
- выдержит ли кластер пики нагрузки;
- не «зальём» ли мы диски лишними партициями и компакшнами;
- будут ли данные консистентными (особенно при upsert/delete).
Ключевые подходы:
- Batch ingestion — крупными порциями, с планированием окон загрузки (ETL или скрипты).
- Real-time ingestion — непрерывная подача из Kafka/Flink/CDC, с минимальной задержкой.
- Hybrid — сырые данные идут real-time, агрегаты — batch.
Методология выбора режима:
- Если SLA по свежести < 5 мин — идём в real-time ingestion.
- Если SLA по свежести ≥ 1 час и данные корректируются — batch с upsert.
- Если данные стабильны, объёмы большие — batch в ночные окна.
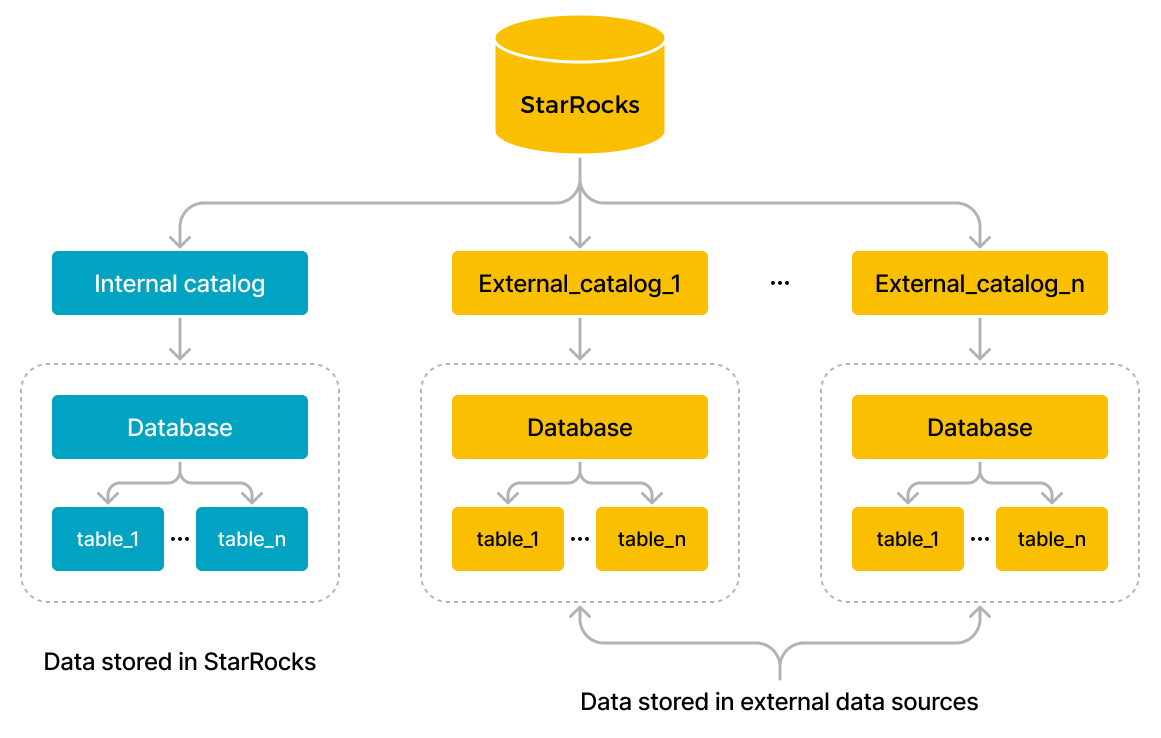
Методы загрузки данных
1. Broker Load — классический batch
- Работает через внешнего брокера (HDFS, S3).
- Асинхронная загрузка.
- Форматы: CSV, JSON, Parquet, ORC.
- Можно задавать фильтры, маппинг колонок.
- Хорош для больших исторических загрузок.
Пример:
LOAD LABEL my_load_20250810
(
    DATA INFILE("s3://bucket/path/*.parquet")
    INTO TABLE sales
    FORMAT AS "parquet"
    (col1, col2, col3)
)
WITH BROKER "my_s3"
(
    "aws_access_key"="xxx",
    "aws_secret_key"="yyy"
)
PROPERTIES
(
    "timeout"="3600",
    "max_filter_ratio"="0.05"
);
Stream Load — синхронная загрузка
- Отправка данных напрямую через HTTP.
- Удобно для интеграций из приложений.
- Не требует файлового хранилища.
- Форматы: CSV, JSON.
Пример:
curl --location-trusted -u user:pass \
    -H "label:load_20250810_01" \
    -H "format:json" \
    -T data.json \
    http://fe_host:8030/api/db_name/sales/_stream_load
Routine Load — real-time из Kafka
- Постоянно читаем топик Kafka.
- Поддержка нескольких партиций и параллельной загрузки.
- Можно маппить JSON → таблицу.
- Настраивается через SQL.
Пример:
CREATE ROUTINE LOAD db.sales_load
ON sales
COLUMNS(id, ts, amount)
PROPERTIES
(
    "desired_concurrent_number"="3",
    "max_batch_rows"="50000",
    "max_batch_interval"="5"
)
FROM KAFKA
(
    "kafka_broker_list"="broker1:9092,broker2:9092",
    "kafka_topic"="sales_events",
    "property.group.id"="sr_sales_loader"
);
External Table / Hive / Iceberg
- Подключение внешних таблиц без копирования данных.
- Подходит для Lakehouse-архитектуры.
- StarRocks читает напрямую из Iceberg/Hive/S3.
Пример:
CREATE EXTERNAL TABLE ext_sales (
    id BIGINT, ts DATETIME, amount DECIMAL(10,2)
)
ENGINE=HIVE
PROPERTIES
(
    "database"="dwh",
    "table"="sales",
    "hive.metastore.uris"="thrift://metastore:9083"
);
Технические особенности ingestion
- Batch (Broker/Stream) — данные пишутся в новые сегменты, затем сегменты компакшнятся.
- Routine Load — ingestion идёт фоново, сегменты периодически сбрасываются.
- PK-таблицы — каждый upsert требует построения delta-segment, потом compaction.
- Aggregate Key — агрегация на ingest при добавлении строк.
- Duplicate Key — просто вставка без изменений.
Влияние на BE:
- Batch даёт пик нагрузки → надо планировать окна.
- Real-time постоянно грузит CPU и диск → надо оставлять запас.
Практические кейсы
Кейс 1. Историческая загрузка 5 ТБ
- Проблема: загрузка исторических продаж с S3.
- Решение: Broker Load с Parquet-файлами, партиция по месяцу.
- Оптимизация: загрузка параллельно по месяцам, max_filter_ratio=0.05.
- Результат: загрузка за 6 часов.
- Риск: падение FE при большом количестве LABEL.
- Защита: удалять старые LABEL, следить за /transactions.
Кейс 2. Real-time заказы в e-commerce
- Проблема: обновление заказов в реальном времени, SLA < 3 сек.
- Решение: Routine Load из Kafka в PK-таблицу, партиция по дню+часу.
- Оптимизация: max_batch_interval=5 сек, параллельность=4.
- Риск: compaction отстаёт при пиках.
- Защита: планировать compaction в «тихие часы» и добавлять BE.
Кейс 3. Lakehouse-витрины
- Проблема: нужно подключить Iceberg без копирования.
- Решение: External Table на S3.
- Оптимизация: партиции Iceberg синхронизированы с BI-фильтрами.
- Риск: медленные запросы при полном скане.
- Защита: кэширование или перенос часто используемых данных в StarRocks-таблицы.
Риски и меры
|
Риск |
Симптом |
Как избежать |
|---|---|---|
|
Перегрузка FE при массовом Broker Load |
Ошибки метаданных |
Параллелить по партициям, следить за транзакциями |
|
Lag в Kafka ingestion |
Данные отстают |
Настроить desired_concurrent_number, следить за compaction |
|
Перекос по ключу в дистрибуции |
Одни BE перегружены |
Выбирать равномерный hash key |
|
Компакшн забивает диск |
Рост latency |
Ночные окна, RF=3, быстрые NVMe |
|
BI-отчёты бьют по сырым данным |
Долгие запросы |
Материализованные представления |
Методологические рекомендации
-
Разделяйте зоны загрузки:
- Raw zone (Duplicate Key) для сырых данных.
- Aggregated zone (Aggregate Key) для BI.
- TTL на партиции — удаляйте старые данные или агрегируйте.
- Параллелизация загрузки — по партициям или shard’ам.
- Тестируйте ingestion под пиковую нагрузку до выхода в прод.
- Ведите документацию по потокам — источник, формат, SLA.


