

Учебный курс: StarRocks — полный практический гид по внедрению и эксплуатации
О курсе
Это комплексная программа, которая от начала и до конца проведёт вас через весь цикл работы со StarRocks — от установки и настройки до проектирования архитектуры, оптимизации и интеграции с BI-системами. Мы учим не только «нажимать кнопки», но и понимать методологию, уметь обосновать архитектурные решения и избегать типичных ошибок при внедрении.
Курс разработан так, чтобы его можно было использовать как инструкцию по внедрению StarRocks в реальном проекте — с готовыми DDL-примерами, схемами архитектуры, чек-листами по сайзингу и безопасной эксплуатации.
Для кого
- Data Engineers — для проектирования и поддержки продуктивных кластеров.
- BI-разработчики — чтобы понимать, как построить оптимальные витрины под BI-нагрузку.
- Системные архитекторы — для выбора архитектуры и интеграций с DWH/Lakehouse.
- DevOps/администраторы СУБД — для установки, настройки, мониторинга и масштабирования.
- Технические лиды проектов — чтобы уверенно вести команду при внедрении StarRocks.
Модуль 1. Введение в StarRocks
- Что такое StarRocks и зачем он нужен: OLAP, MPP, колоночное хранение
- Эволюция проекта (Apache Doris → StarRocks)
- Основные сценарии применения: DWH, BI, real-time аналитика, Lakehouse
- Сравнение с ClickHouse, Greenplum, Snowflake, BigQuery
- Ключевые преимущества: высокая скорость запросов, встраивание в экосистему, real-time ingestion
Модуль 2. Архитектура и принципы работы
-
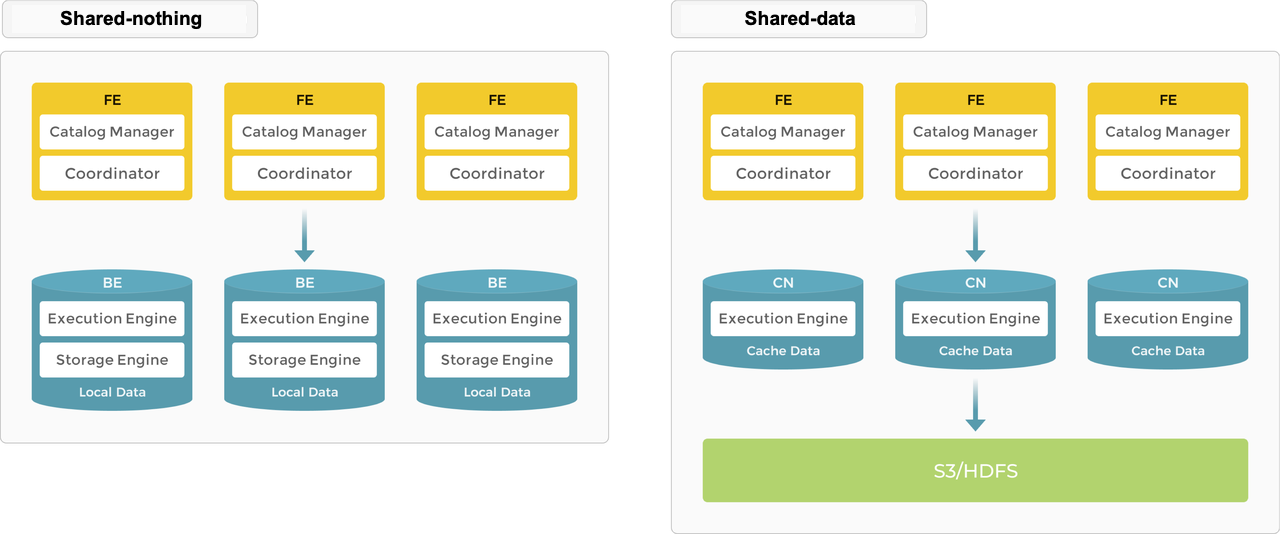
Основные компоненты:
- FE (Frontend) — координация, планировщик запросов
- BE (Backend) — хранение и выполнение
- MetaStore, Journal, репликация данных
- Форматы хранения (columnar storage, segment files)
- Механизм MPP и векторизированного выполнения запросов
- Поддержка материализованных представлений и индексов
Модуль 3. Развёртывание и конфигурация
-
Установка StarRocks:
- Single-node (тест)
- Multi-node (продакшн)
- Аппаратные требования (CPU, RAM, Disk, Network)
- Конфигурационные параметры FE и BE
- Мониторинг состояния кластера
- Обновление и масштабирование (scale up / scale out)
Модуль 4. Моделирование данных в StarRocks
-
Типы таблиц:
- OLAP table
- Primary key table
- Duplicate key table
- Aggregate key table
- Разбиение данных (Partitioning) и сегментация
- Дистрибуция данных по BE
- Типы индексов и ключей сортировки
- Работа с материализованными представлениями (MV)
- Batch ingestion (Broker Load, Stream Load)
- Real-time ingestion (Routine Load, Kafka)
- Интеграция с Lakehouse (Iceberg, Hive Metastore)
- Интеграция с внешними системами (MySQL, ElasticSearch)
- Типичные ошибки загрузки и их устранение
- Поддержка SQL-синтаксиса MySQL
- Расширенные аналитические функции (Window, Rollup, Cube)
- Join-стратегии и оптимизация
- Subquery и CTE
- Особенности работы с NULL и типами данных
Модуль 7. Оптимизация производительности
- Профилирование запросов (EXPLAIN, PROFILE)
- Настройка параметров выполнения (session variables)
- Оптимизация партиционирования и дистрибуции
- Индексация и материализованные представления
- Балансировка нагрузки между BE
Модуль 8. Интеграция с BI и DWH
- Подключение к Tableau, Power BI, Superset, FineBI
- Использование JDBC/ODBC
- StarRocks как часть DWH/Lakehouse-архитектуры
- Best practices по построению витрин
Модуль 9. Безопасность и управление доступом
- Ролевая модель и разграничение прав
- Аутентификация и шифрование
- Управление пользователями и группами
- Аудит действий
Модуль 10. Эксплуатация и мониторинг
- Метрики StarRocks (Prometheus, Grafana)
- Логи и диагностика
- Плановое обслуживание и бэкапы
- Управление ростом данных и TTL
- StarRocks в Kubernetes
- Vectorized Execution Engine
- CBO (Cost-Based Optimizer)
- Интеграция с Flink/Spark
- Настройка real-time dashboards
- Построение аналитической витрины от загрузки до BI
- Работа с real-time данными
- Оптимизация «тяжёлого» отчёта
- Разбор реального кейса (например, аналитика логов / e-commerce)
Дополнительно:


