

Модуль 1. Введение в StarRocks
Что такое StarRocks и зачем он нужен
StarRocks — это современная распределённая аналитическая СУБД (OLAP) с архитектурой MPP (Massively Parallel Processing) и колоночным хранением.
Её задача — максимально быстро отвечать на аналитические SQL-запросы, в том числе сложные, с агрегациями, джойнами и аналитическими функциями, на очень больших объёмах данных (миллиарды строк, терабайты).
Методологически, StarRocks закрывает нишу между:
- классическими DWH (Greenplum, Vertica, Teradata), которые хороши в батч-аналитике, но слабы в real-time,
- и stream-ориентированными движками (Kafka + Flink), которые обрабатывают поток, но не хранят исторические данные удобно для сложной аналитики.
Ключевые сценарии применения:
- BI-аналитика на свежих данных — подключение Power BI, Tableau, FineBI и работа с миллиардами строк в интерактиве.
- Real-time аналитика — например, дашборды по заказам в e-commerce с задержкой 2–5 секунд.
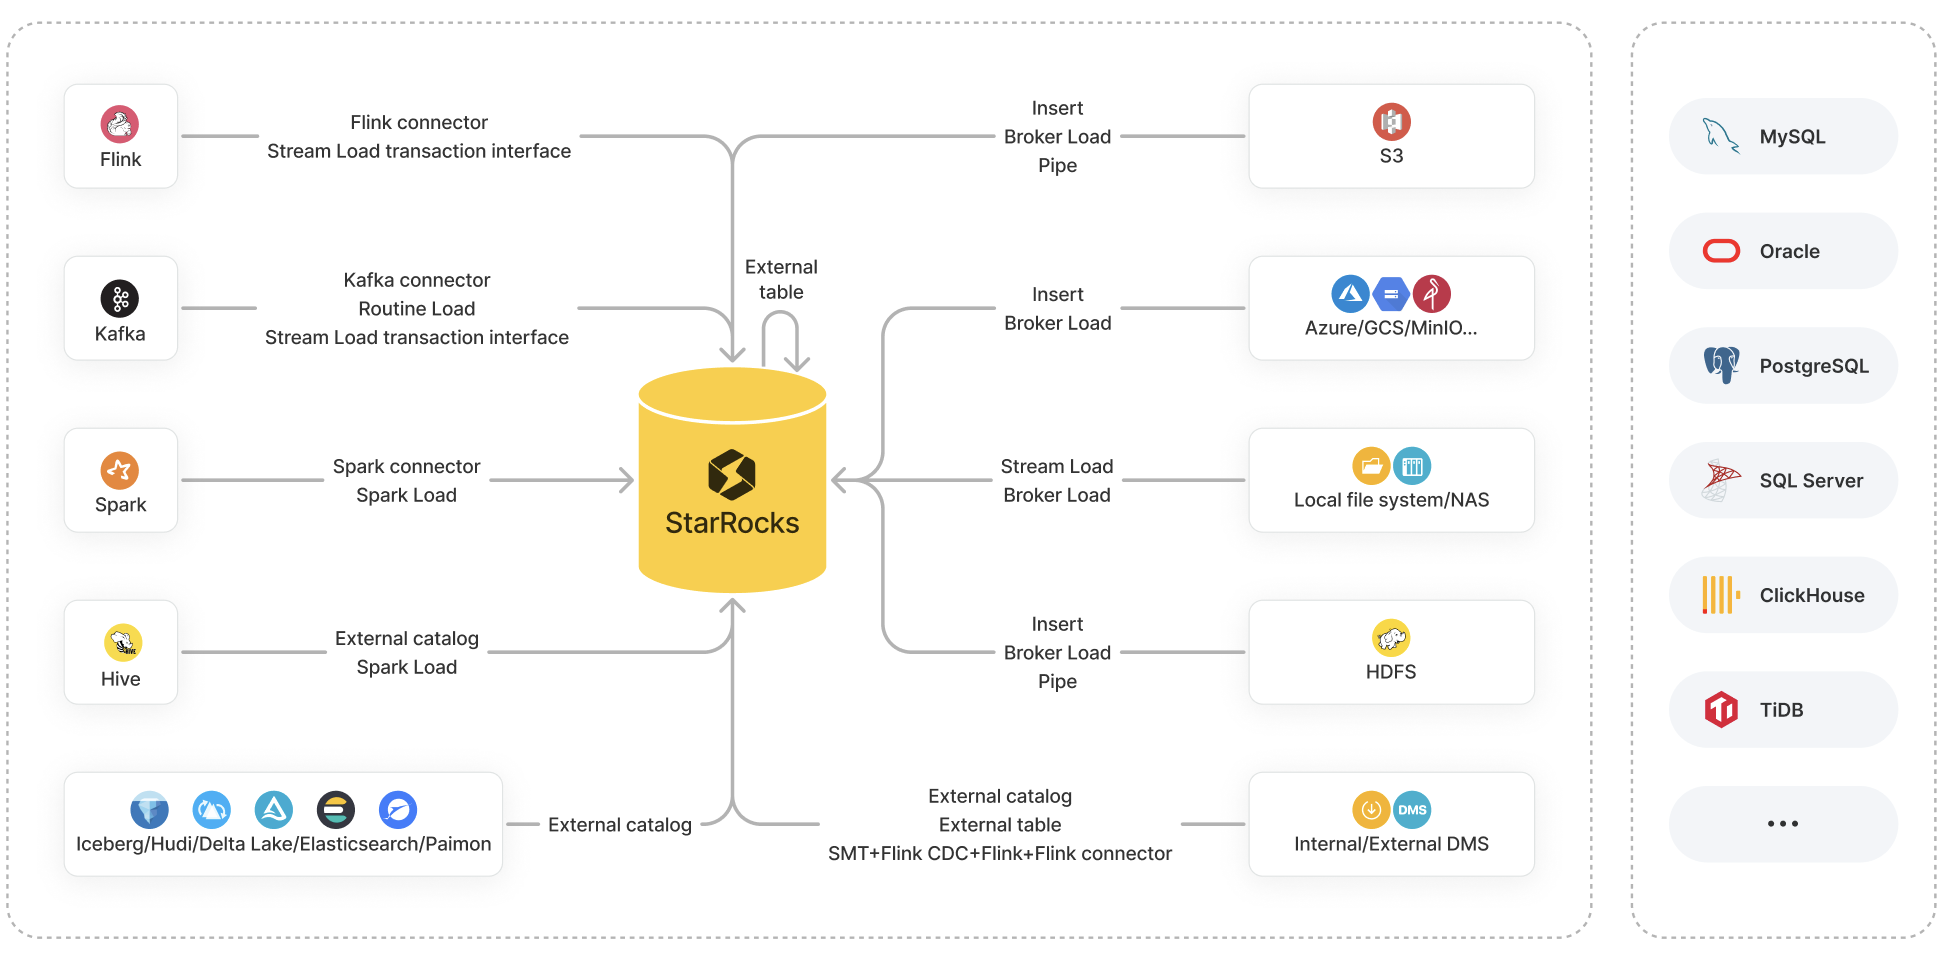
- Lakehouse-архитектуры — совместное использование с S3/MinIO/HDFS, поддержка формата Apache Iceberg.
- Оффлайн-отчётность — быстрая генерация регламентных отчётов и витрин.
- Интерактивные сервисы — рекомендации, аналитика в продукте (embedded analytics).
История и эволюция проекта
- Изначально StarRocks был форком Apache Doris, который, в свою очередь, вырос из Baidu Palo (2017).
-
В 2020–2021 гг. команда разработчиков выделилась в отдельный проект и переписала многие ключевые части движка:
- Добавили векторизированный execution engine (ускорение в 3–5 раз на ряде запросов).
- Реализовали CBO (Cost-Based Optimizer).
- Добавили поддержку real-time ingestion (Kafka, Flink, CDC).
- Расширили SQL-диалект и поддержку BI-функций.
- Сегодня StarRocks — open source (Apache License 2.0), но с активным коммерческим бэкендом (StarRocks Inc.), что гарантирует развитие.
Методологическое место StarRocks в архитектуре данных
В классическом DWH-проекте (по Кимболлу или Инмону) StarRocks можно использовать как:
- Финальный слой BI-витрин (замена традиционного OLAP на кубах).
- Весь аналитический движок — если не требуется сложный ELT в самом DWH, а основная трансформация идёт в ETL/ELT-инструментах или внутри StarRocks.
В Lakehouse-архитектуре:
- StarRocks — compute-движок для запросов к Iceberg/Hive.
- S3/MinIO — хранение сырых и обработанных данных.
- ETL — Flink/Spark/Debezium.
Почему это важно: методологически StarRocks — это не «ещё один ClickHouse», а более «SQL-центричный» движок, ориентированный на BI, а не только на логи и time-series.
Архитектура и ключевые компоненты
В StarRocks есть два основных типа узлов:
-
Frontend (FE) — принимает SQL, планирует запросы, управляет метаданными.
- Хранит метаданные (схемы, партиции, пользователи).
- Оптимизирует запросы (CBO, rule-based).
- Поддерживает HA (несколько FE-нод с лидер-выбором).
- Backend (BE) — хранит сегменты данных и выполняет вычисления.
- Хранение в колоночном формате.
- Выполнение векторизированных операций.
- Локальная репликация сегментов для отказоустойчивости.
Пример мини-схемы:
[BI Tool] → [FE Nodes] → [BE Nodes] → [Storage: local disk / S3 / HDFS]
Технические особенности, которые стоит знать с самого начала
- Columnar storage: данные хранятся по колонкам, что ускоряет агрегации.
- Vectorized execution: обработка пачками значений (batch processing) вместо построчной.
- Materialized Views: автоматическое переписывание запросов под MVs для ускорения.
- Real-time ingestion: Kafka/Flink без тяжёлых ETL.
- SQL совместимость: диалект MySQL + расширения (Window, Rollup, Bitmap, HLL).
- Lakehouse поддержка: чтение Iceberg/Hive таблиц как обычных.
Практические кейсы внедрения
Кейс 1. E-commerce аналитика заказов
- Задача: строить дашборд по заказам в Power BI с задержкой не более 5 секунд.
- Решение: Kafka → Routine Load в StarRocks → Materialized View по ключевым KPI → Power BI через ODBC.
- Результат: MAPE по свежим данным < 1%, дашборд обновляется каждые 10 сек.
- Риск: перегрузка Routine Load при пиках продаж.
- Как избежать: масштабировать BE-ноды, настроить backpressure в Kafka.
Кейс 2. Лог-аналитика в реальном времени
- Задача: анализ логов API по миллиарду записей за день.
- Решение: Flink CDC → StarRocks → Materialized View с pre-aggregation.
- Результат: время ответа < 1 сек на запросах с 10 млрд строк.
- Риск: быстрый рост хранилища.
- Как избежать: настроить TTL и агрегировать старые партиции.
Риски и как от них застраховаться
|
Риск |
Как проявляется |
Как избежать |
|---|---|---|
|
Неверный выбор типа таблицы |
Деградация производительности |
Анализировать сценарий: PK table для upsert, Aggregate Key для агрегаций |
|
Одноточечная перегрузка BE |
Медленные запросы, таймауты |
Равномерная дистрибуция партиций, мониторинг загрузки |
|
Неконтролируемый рост данных |
Увеличение стоимости и падение скорости |
Включить TTL, агрегацию старых данных |
|
Потеря данных при сбое Kafka/ETL |
Пропуски в аналитике |
Настроить exactly-once ingestion и репликацию |
|
BI-запросы «стреляют» в сырые таблицы |
Высокая нагрузка на продакшн |
Материализованные представления и витрины |
Итог по модулю
StarRocks — это не просто быстрый OLAP, а платформа, которая позволяет строить BI и real-time аналитику с минимальной задержкой. Для успешного внедрения нужно:
- Чётко понимать архитектуру и роли FE/BE.
- Правильно моделировать таблицы под сценарий.
- Контролировать рост данных и нагрузку.
- Использовать MVs и TTL.
- Планировать интеграцию с BI на раннем этапе.


