

Онтологии, таксономии и бизнес-словарь данных
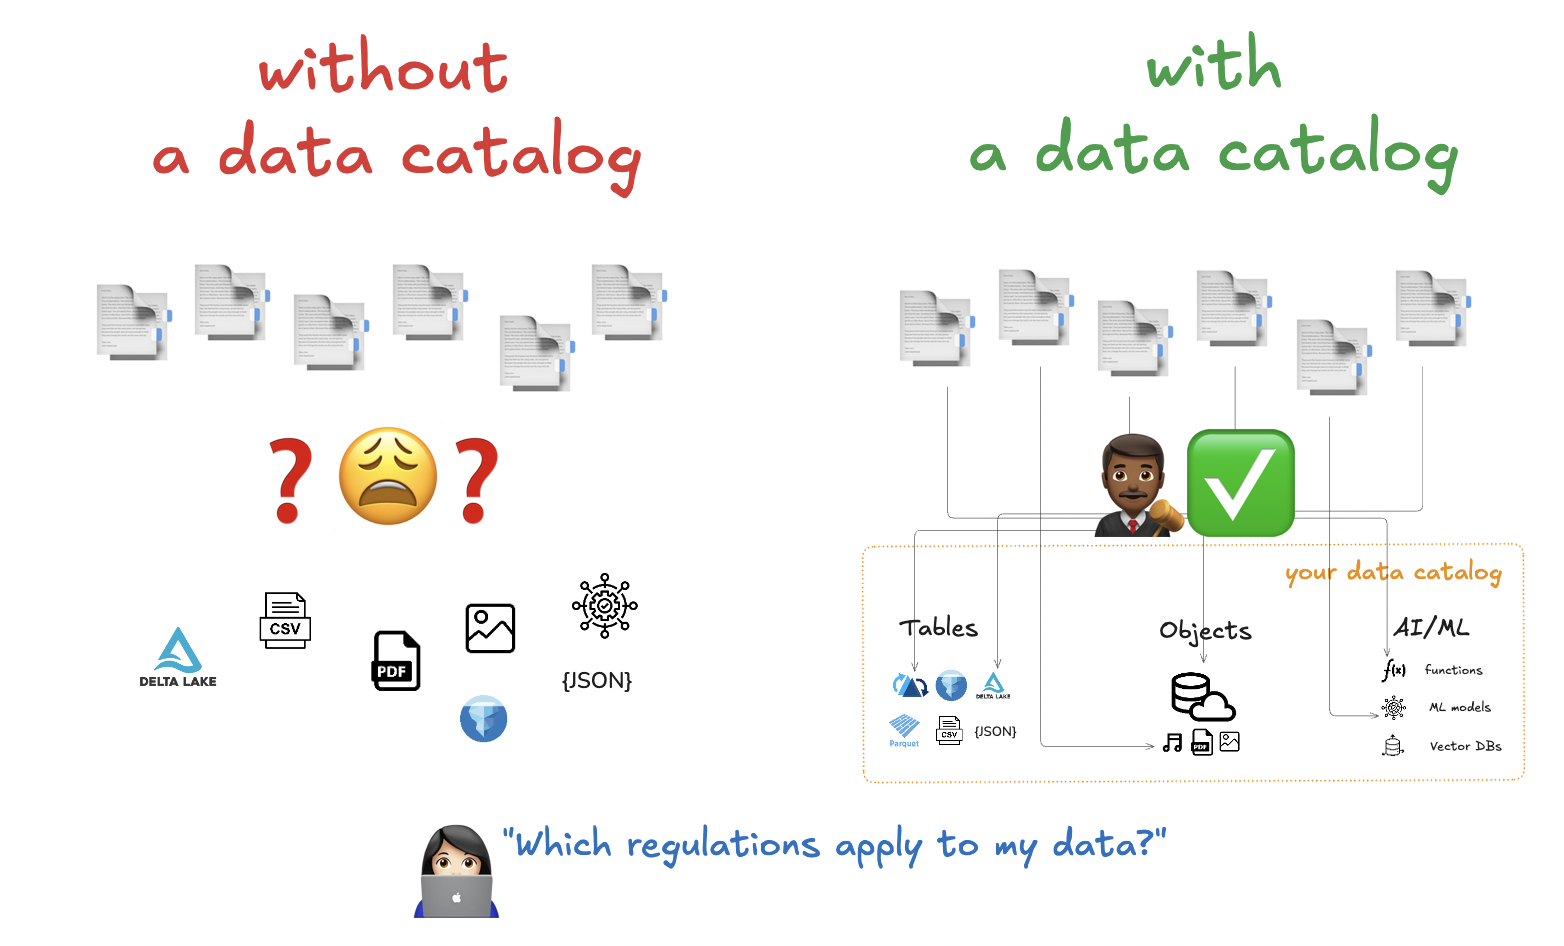
В рамках курса по Data Catalog вопросы семантики становятся критически важными: как единые языки и определения помогают упорядочить данные, повысить читаемость каталога и ускорить поиск, а также обеспечить устойчивую интеграцию между бизнес-терминами и техническими артефактами. Эта глава посвящена трем фундаментальным элементам управляемой семантики данных: онтологиям, таксономиям и бизнес-словарю данных. Мы рассмотрим концептуальные различия и взаимосвязи, архитектурные решения для реализации в корпоративной платформе, а также практики наполнения и эксплуатации в условиях цифровой трансформации.
Необходимость единой семантики становится особенно ощутимой при масштабировании дата-платформы: когда сотни команд используют общие термины, поиск становится предсказуемым, линейная зависимость между данными и бизнес-потребностями сокращается, а качество данных поддерживается через четко зафиксированные определения и взаимосвязи. В этой главе раскрываются теоретические основы и практические принципы построения, наполнения и эксплуатации семантического слоя Data Catalog в корпоративной среде.
- Что такое онтология, таксономия и бизнес-словарь данных и зачем они нужны в каталоге
- Как эти элементы взаимодействуют с архитектурой 데이터-платформы и метаданными
- Как организовать жизненный цикл наполнения, управление изменениями и качество терминов
- Какие сценарии внедрения подходят для крупных организаций и какие риски следует учитывать
Концепции: онтологии, таксономии и бизнес-словарь данных
Онтология в контексте данных представляет собой формальную, машиннообъяснимую модель предметной области. Она формулирует концепты, их свойства и отношения между ними, что позволяет не просто классифицировать данные, но и описывать логику связей между понятиями. В корпоративном каталоге онтология служит семантическим каркасом, на котором базируются поиск, автоматическое тегирование и выводы об атрибутах объектов данных. В отличие от простой иерархии, она поддерживает сложные связи: часть-целое, ассоциации, типы диаграмм зависимости, ограничительные правила и онтологические ограничения.
Таксономия — это иерархическая структура понятий, ориентированная на навигацию и категоризацию. Она обеспечивает удобную навигацию по бизнес-доменам и поддоменам, облегчает агрегацию и фильтрацию данных, а также служит «карта-объяснение» для пользователей, не владеющих глубокой технической спецификой. Таксономия хорошо интегрируется с пользовательскими интерфейсами каталога: деревья категорий, фильтры по уровням и быстрые переходы к связанным данным.
Бизнес-словарь данных (data glossary) — это центральный реестр терминов с определениями, синонимами, источниками и владением. Помимо терминов, в словарь включаются атрибуты качества, уровень доверия, ссылки на источники данных, нормативы, правила использования и контекст применения. В реальном мире словарь становится связующим звеном между бизнес-пользователями и техническими специалистами: он обеспечивает единый язык и способствует принятию решений на основе согласованных понятий.
Эти три элемента не являются изолированными артефактами. Они тесно взаимосвязаны:
- термины бизнес-словаря часто сопоставляются с концептами онтологии через концептуальные маппинги, что позволяет использовать термины в смысле и контексте более широких моделей;
- таксономия может служить производной структуре внутри онтологии, предлагая навигационные траектории и ускоряя поиск;
- словарь обеспечивает понятную механику трактовки терминов и их лексических вариантов, что особенно важно при интеграции между разными системами и данными.
Ключевые принципы проектирования в корпоративной среде:
- модульность и повторное использование: словарь, онтология и таксономия должны быть оперируемыми модулями, которые легко обновлять без разрушения зависимостей;
- управляемость изменений: версии терминов и связей должны сопровождаться дорожной картой изменений и согласованием со стейкхолдерами;
- связность с данными: каждый термин или концепт должен иметь атрибуты привязки к данным (метаданные, источники, lineage, владельцы);
- исламизация согласованности: в больших организациях полезно внедрять единый словарь и правила названий, чтобы минимизировать дубликаты и интерпретационные различия.
Для поддержки практических задач в каталоге применяются стандарты и технологии, такие как SKOS (Simple Knowledge Organization System) для моделирования таксономий и словарей, RDF/OWL для формальных онтологий, а также графовые баз данных и индексаторы поисковых систем для эффективного семантического поиска. В реальных проектах может сочетаться графовая модель для семантики и реляционная модель для прикладных метаданных, чтобы удовлетворить производительности и масштабируемости.
Форматы и интеграционные подходы
- Онтологии и словари можно моделировать в формальных языках: OWL/OWL2 для онтологий, SKOS для лексикона и таксономий. Эти форматы позволяют задавать ограничения, наследование и правила вывода.
- Для корпоративной среды часто выбирают гибридную реализацию: графовая база данных для семантического слоя (концепты, отношения, связи) и хранилища метаданных в Data Catalog для функциональности снабжения, версионирования и аудита.
- API и интеграции: RESTful и GraphQL API обеспечивают доступ к терминам, концептам и связям; подписки на события об изменениях позволяют синхронизировать терминологию с другими системами.
Примеры инструментов и практик (упоминания в контексте обобщения, без избыточной конкретики):
- инструмент моделирования онтологий и словарей на основе SKOS/OWL, который может работать как внешний репозиторий и обеспечивать версии и согласование;
- интеграция с governance-решениями уровня дата-ленты: политики, рабочие процессы согласования и аудита изменений;
- использование графовой базы данных для хранения концептов и отношений и индексации для быстрого поиска.
Архитектура и интеграция: место онтологий, таксономий и словаря в Data Catalog
Эффективная архитектура семантики требует четкого разделения обязанностей и ясной маршрутизации потоков данных. В типовой корпоративной Data Catalog архитектура семантики делится на три слоя: слой бизнес-терминов (словарь), слой концепций и связей (онто-логический слой) и слой технических объектов (метаданные и данные-assets). Эти слои взаимно дополняют друг друга и обеспечивают устойчивую базу для поиска, каталогизации и управления данными.
- Слой словаря данных: здесь размещаются термины, определения, синонимы, источники, ответственность за термин, уровень доверия и контекст применения. Этот слой служит точкой входа для пользователей и систем, которые хотят понять смысл конкретного набора данных.
- Слой онтологии и связей: в этом слое формализуется семантика предметной области — концепты, их свойства и отношения (часть/целое, производные типы, зависимости и т. п.). Это обеспечивает машину-обработку и поддержку семантики в каталогах.
- Слой технических данных: включает метаданные об источниках данных, датасетах, таблицах, полях, lineage, политики доступа и т. д. Этот слой обеспечивает операционную функциональность каталога.
Ключевые интеграционные паттерны:
- интеграция через API: терминология и концепты доступны через унифицированный API, что позволяет приложениям легко получать сигнатуры для терминов и объекты на основе онтологий;
- синхронизация изменений: подписка на события об изменениях в словаре и онтологиях, чтобы обновлять индекс и регистрировать версионность;
- совместная обработка данных и семантики: семантический слой дополняет классический каталог данными об источниках, lineage и контекстах использования;
- поддержка добычи знаний: возможен экспорт и импорт словарей и онтологий через стандартные форматы (SKOS, RDF/OWL) для обмена между системами и партнерами.
С точки зрения технологий предпочтительным является гибридный подход: графовая база для представления концептов и их связей, реляционная или документная база для хранения бизнес-терминов и атрибутов, а также поисковый индекс для быстрого доступа пользователей. Прямыми преимуществами такого подхода являются: ускорение семантического поиска, улучшенная поддержка версионирования словаря, а также возможность автоматизации вывода на основе онтологической модели.
Роль открытых инструментов в этом контексте может быть достаточно ограниченной, если речь идет о корпоративной конфигурации. Однако две категории инструментов заслуживают упоминания:
- инструменты моделирования и редактирования онтологий и словарей (например, для разработки и проверки структуры) обеспечивают версионирование, валидацию и совместное редактирование;
- консолидационные решения и governance-платформы, которые поддерживают интеграцию с существующими системами управления метаданными и предлагают шаблоны процессов согласования.
Определение оптимального набора компонентов зависит от масштаба организации, зрелости управления данными и зрелости Data Catalog. В крупных организациях целесообразно сначала сформировать базовую версию словаря и простой набор онтологических концептов, затем расширять через сценарии использования: поиск, метаданные, lineage и управление качеством.
Архитектурные элементы и принципы реализации
- Моделирование: разделение на три слоя, четко разграничивающее бизнес-термины, концепции и данные. Это упрощает управление изменениями и снижает риск конфликтов.
- Нормализация терминов: единый процесс нормализации, включая разрешение синонимов и вариантов формулировок, чтобы избежать дублирования и расхождений.
- Версионирование и управление изменениями: каждое изменение термина или концепта должно проходить через одобренный процесс, фиксироваться в журнале и связываться с влиянием на связанные объекты (датасеты, линейка и т. д.).
- Согласование владельцев: для каждого термина должен быть ответственный владелец из бизнес-подразделения и/или технического владельца, что обеспечивает качество и актуальность.
- Управление качеством семантики: набор метрик для оценки полноты, точности и согласованности словаря и онтологии, а также статус аудита изменений.
Программно-ориентированная реализация может включать:
- хранение терминов и контекстов в базе данных терминов, где определяется идентификатор, определение, источники, синонимы, уровень доверия;
- хранение концептов и отношений в графовой базе данных, которая поддерживает сложные связи и правила вывода;
- экспорт/импорт через RDF/OWL или SKOS для обмена между системами и партнерами;
- индексацию в полнотекстовом поиске для быстрого доступа по семантике и лексическим вариантам.
Технологические примеры (упомянутые для иллюстрации подхода, без перегрузки выбором):
- открытые инструменты моделирования онтологий и словарей позволяют проектировать и валидировать структуры до их разворачивания в продакшн-окружении;
- корпоративные платформы управления данными часто предоставляют модули словаря и онтологии как часть набора метаданный и политики, с готовыми API для интеграции.
Жизненный цикл наполнения: создание, нормализация, семантизация
Эффективное управление семантическим слоем требует системного подхода к наполнению и поддержке. Это включает триггеры и процессы, обеспечивающие устойчивость и качество словаря, онтологии и их соответствие реальной бизнес-деятельности.
- Выявление и сбор терминов: работа начинается с активного участия бизнес-владельцев и стейкхолдеров. В рамках интеракций с подразделениями выполняются интервью, анализ документов, оценка существующих словарей и глоссариев. Результатом становится перечень терминов, который затем нормализуется и объединяется с существующей семантикой.
- Нормализация и агрегация: после сбора выполняется устранение дубликатов, привязка синонимов к основным терминам, согласование формулировок и единых стилей наименований. В этот этап включается поиск соответствий между бизнес-терминами и концепциями онтологии.
- Семантизация и связь с данными: каждому термину присваиваются контексты использования, примеры дата-пайплайнов, связанные датасеты и атрибуты. В составе семантизации строится связь между термами и сущностями данных, что упрощает навигацию и поиск.
- Версионирование и история изменений: в процессе наполнения и изменений создаются версии терминов и концепций. Ведение журнала изменений позволяет отследить источник изменений, ответственных лиц и влияние на целевые данные и процессы.
- Качество и валидация: регулярные проверки на непротиворечивость между терминами и концепциями, полноту словаря, соответствие нормативным требованиям и политикам доступа. В рамках контроля качества используются метрики и аудиты.
- Управление жизненным циклом: процедуры добавления, обновления и удаления терминов документируются в рабочих процессах и политике управления изменениями. Важно обеспечить согласование и прозрачность для всех стейкхолдеров.
Практические принципы наполнения:
- участие бизнес-пользователей: формируем общую дефиницию и контекст, обеспечиваем практическую применимость терминов;
- минимизация дублирования: тщательная проверка на соответствие существующим терминам и концепциям;
- связь с данными: каждый термин должен быть привязан к конкретным датасетам, полям и источникам, чтобы обеспечить понятность и прозрачность;
- поддержка локализаций: если бизнес присутствует в нескольких регионах, поддерживаем локальные варианты формулировок и их централизованное управление;
- постановка ожиданий: четко прописаны роли, ответственности и требования к качеству, чтобы избежать «разделения ответственности» и неэффективной коммуникации.
Версии, согласование и аудит
- Версионирование: каждое изменение должно сопровождаться версией. Это позволяет откатывать изменения и анализировать влияние на данные.
- Workflow согласования: внедряем формальные процессы утверждения, включая участие стейкхолдеров из бизнеса и технических владельцев. В случае переработки определения — фиксируем новую версию.
- Аудит и прозрачность: журнал изменений, кто сделал что и когда, обеспечивает трассируемость и повышает доверие к семантике.
При подходе к наполнению следует учитывать особенности контента. Термины, используемые в финансовой, юридической или операционной функциях, требуют большей формализации и надлежащих источников. В то же время для инженерной и аналитической аудитории может потребоваться более техническая детализация примеров использования и связанных данных.
Управление изменениями и качество: политики, процессы и KPI
Эффективное управление семантикой требует системного подхода к изменениям, чтобы не создавать «мостов знаний» без учета контекста и источников. В крупных организациях рекомендуется внедрить четкую политику управления словарем и онтологией, включающую следующие элементы:
- процесс добавления и обновления терминов: кто имеет право инициировать изменения, какие проверки должны осуществляться, какие данные необходимы для обоснования изменений;
- правила согласования и эскалации: определение уровней согласования и критериев для ускорения критически важных изменений;
- управление синхронизацией данных: как изменения в словаре влияют на данные в каталоге и какие миграционные шаги требуются;
- политика устранения конфликтов: механизмы выявления и разрешения конфликтов между терминами и концепциями, а также между различными подразделениями;
- обеспечение аудита и соответствий: хранение истории изменений, доказательств согласования, а также соответствие требованиям регуляторов или внутренних стандартов.
Ключевые метрики (KPI) для оценки эффективности управления семантикой:
- охват семантикой: доля ключевых бизнес-доменов, для которых определены словарь и базовые концепты;
- полнота связи с данными: процент датасетов и полей, связанных с терминами и концепциями;
- достоверность и согласованность: доля терминов без противоречий с онтологией и отсутствующих дубликатов;
- частота использования терминов: насколько часто бизнес-пользователи ссылаются на термины в запросах и описаниях;
- скорость обновления: среднее время между запросом на изменение и его внедрением в продакшн;
- качество поиска: улучшение релевантности результатов поиска после внедрения семантики;
- аудит и соответствие: доля изменений, прошедших аудит и утверждение по установленной политике.
Важно обеспечить баланс между стабильностью семантики и потребностями бизнеса в динамике изменений. В рамках governance-реализаций стоит рассмотреть практику «модерации изменений» — предварительно ограничивать изменения к критическим терминам, запускать пилоты и параллельно поддерживать устоявшиеся версии. Такой подход снижает риск ошибок и помогает адаптироваться к новым бизнес-процессам.
Внедрение и практические сценарии: шаги, роли и риски
Ниже приводятся основные шаги внедрения семантики в Data Catalog в контексте корпоративной среды, включая распределение ролей и типичные риски.
- Этап подготовки: формирование и согласование целей проекта, определение стейкхолдеров, ролей и бизнес-области, где семантика будет идти вплотную с повседневной работой. На этом этапе уточняется формат и методы хранения словаря и онтологии, выбираются технологии и начальные наборы терминов.
- Этап дизайна: создание концепций, иерархий таксономий и определений, определение связей между терминами и данными, утверждение политики версионирования и управления изменениями. В этом этапе особенно важна активная вовлеченность бизнес-владельцев и архитекторов данных.
- Этап реализации: разворачиваются технические компоненты, интеграционные точки, API и сервисы для доступа к семантике, настройка индексирования и поисковых механизмов, миграция первоначального словаря и онтологии в продакшн-среду.
- Этап пилота: тестирование на ограниченном наборе доменов и пользователей, сбор отзывов, корректировка и настройка процессов согласования. Пилот позволяет проверить реальную пользу и выявить узкие места.
- Этап масштабирования: расширение словаря и онтологии на другие домены, поддержание версий и управление изменениями по всей организации, внедрение процессов обучения пользователей и изменений процессов.
- Этап эксплуатации: поддержка и развитие семантики, регулярные обновления, аудит и мониторинг, связь с политиками качества данных и данными об использованием.
Роли и ответственности в рамках внедрения:
- Data governance council: стратегическое направление, приоритизация доменов, обеспечение соответствия регуляторным требованиям.
- Data stewards: ежедневное управление терминами, согласование изменений, обеспечение качества и контекстов.
- Data owners: ответственность за данные и понятие их контекста в рамках своей области; участие в принятии решений по терминам и концепциям.
- Catalog administrators: техническое сопровождение среды, поддержка API и интеграций, настройка прав доступа и безопасность.
- Аналитики семантики: поддержка поиска и вывода знаний, мониторинг использования терминосистемы и аналитическая поддержка бизнес-решений.
Типичные риски и способы их снижения:
- риск дублирования и противоречий: реализуйте строгие правила нормализации и дельты изменений, проведение периодических ревизий;
- риск фрагментации терминов между подразделениями: создайте единый реестр терминов с механизмами согласования и автоматических уведомлений;
- риск перегрузки пользователей: запустите обучение и понятные шаблоны использования термина в интерфейсе каталога, а также примеры сценариев;
- риск несогласованности между бизнес-терминами и техническими аспектами: поддерживайте связи между терминами, концепциями и техническими данными, чтобы сохранять контекст;
- риск технической сложности и затрат: начинайте с минимального жизнеспособного набора словаря и онтологии в рамках пилота, затем постепенно расширяйте.
Примеры сценариев внедрения в корпоративной среде:
- сектор закупок и цепочек поставок: унифицированный словарь терминов для контрактов, поставщиков и характеристик материалов, обеспечение единой терминологии в отслеживании поставок;
- финансовый блок: единый словарь терминов для финансовых инструментов, риск-метрик и регуляторных данных, обеспечение соответствия стандартам;
- маркетинг и аналитика: консолидированный набор понятий и концепций для сегментов клиентов и кампаний, где семантика улучшает согласование между командами и данные становятся более понятными.
Особенности взаимодействия с инструментами и продуктами
- интеграции с Open-Source решениями: Protégé для моделирования онтологий, SKOS-словарь для совместной работы и миграции между системами; эти инструменты можно использовать на этапах дизайна и тестирования.
- взаимодействие с продуктовыми решениями Data Catalog: в крупных компаниях доминируют коммерческие каталоги (Collibra, Alation и т.п.). Они часто предоставляют модули для управления словарями и интеграцию с данными и lineage, что упрощает эксплуатацию и управление семантикой.
- архитектурные компромиссы: часто встречается компромисс между полным формальным онтологическим слоем и прагматичным словарем; оптимальным является гибрид, где базовая семантика поддерживается в графовой базе, а более легковесные правила — в словаре.
Key takeaways
- Онтологии, таксономии и бизнес-словарь данных формируют семантический backbone Data Catalog и поддерживают понимание смысла данных на уровне бизнеса и техники.
- Разделение на слои словаря, концепций и технических метаданных обеспечивает гибкую архитектуру и управляемое развитие семантики.
- Стратегия наполнения опирается на участие бизнес-владельцев, регламенты версионирования, контроль качества и прозрачность изменений.
- Управление семантикой требует формализованных процессов, KPI и аудита для устойчивой эксплуатации и соответствия регуляторным требованиям.
- Интеграция словаря и онтологии с данными, метаданными и данными о lineage обеспечивает мощные возможности поиска, аналитики и соблюдения политики.
- Внедрение целесообразно начинать с пилотной зоны и постепенно масштабировать, сочетая графовые технологии для семантики и индексированные решения для поисковой функциональности.
- В качестве инструментов можно использовать как open-source решения для моделирования и проверки семантики, так и коммерческие каталоги для управления жизненным циклом данных и контроля изменений.
FAQ
1) Что именно такое онтология в контексте Data Catalog?
- Это формальная модель предметной области, включающая понятия, их свойства и отношения между ними. Она позволяет системе не только хранить данные, но и понимать смысл связей между ними, что поддерживает семантический поиск и выводы на основе контекста. Онтология даёт машинное понимание, а словарь данных — человеческое описание и контекст использования. Вместе они образуют устойчивый каркас для аналитики и управления.
2) В чем разница между термином и концептом?
- Термин — лексическая единица, часто бизнес-формулировка (например, «клиент», «счет-фактура»). Концепт — абстрактная единица в онтологии, которая описывает сущность и ее свойства. Термин может быть синонимом или локальным выражением концепта; концепт может связывать несколько терминов через синонимы или контексты применения.
3) Как связать бизнес-термины с данными в каталоге?
- Связь достигается через атрибуты термина: ссылки на связанные датасеты, поля, источники, владельцев и примеры использования. В онтологическом слое устанавливаются связи между концептами и данными, а в словаре фиксируются контексты применения и правила использования терминов. Это обеспечивает единый язык и уменьшает риск неоднозначности.
4) Какие форматы и стандарты применяются для онтологий и словарей?
- Распространены SKOS для таксономий и словарей, RDF/OWL для формальных онтологий. Эти форматы поддерживают версионирование, валидацию и обмен между системами. В реальных проектах часто сочетаются графовые базы (для концептов) и реляционные или документальные хранилища (для терминов и атрибутов), с экспортом/импортом в RDF/OWL по мере необходимости.
5) Какие интеграционные паттерны оптимальны для больших организаций?
- Гибридная архитектура с графовым слоем для семантики и индексируемым слоем метаданных. API-first подход с RESTful/GraphQL для доступа к терминам и концептам; подписки на события об изменениях для синхронизации с другими системами. Поддержка экспорта через стандартные форматы (SKOS/RDF) для обмена между системами.
6) Какие KPI отражают качество семантики?
- Покрытие доменов семантикой, полнота связей между терминами и данными, доля однозначно определённых терминов, скорость обновления словаря, точность и согласованность терминов, качество поиска и удовлетворенность пользователей.
7) С каким уровнем бюджета и сроками следует планировать внедрение?
- На старте разумно запланировать пилот на одном-двух доменах с минимально необходимым набором словаря и онтологии. Масштабирование требует дополнительных ресурсов на участие бизнес-владельцев, развитие инфраструктуры и поддержку процессов управления изменениями. Важно устанавливать реалистичные сроки для каждой фазы, а также непрерывно демонстрировать бизнес-ценность через улучшения в поиске и качестве данных.
8) Какие риски характерны для семантического слоя и как их снизить?
- Риск дублирования и противоречий — обеспечить нормализацию и строгие процессы согласования. Риск фрагментации между подразделениями — единый реестр терминов с механизма измерения и согласования. Риск перегрузки пользователей — начать с минимального набора доменов и обеспечить понятные шаблоны использования терминов. Риск технической сложности — реализовать минимально жизнеспособный набор семантики и постепенно расширять, избегая «перегруза» системы.
9) Какой порядок действий при расширении словаря на новые домены?
- Оценить бизнес-ценность и потребности домена, собрать терминологию в сотрудничестве с владельцами, проверить на дубликаты, предложить концепты и связи в онтологии, зафиксировать определения и привязать к данным, протестировать в пилоте, затем внедрить в продакшн и обновить документацию.
10) Какие открытые инструменты наиболее полезны на разных стадиях проекта?
- Для дизайна онтологий и словарей полезны Protégé или аналогичные редакторы, поддерживающие SKOS/OWL; для интеграции и эксплуатации в Data Catalog чаще применяют коммерческие решения с модулями управления словарями и интеграцией с метаданными, а также графовые базы (для концептов) и полнотекстовый поиск (для удобного доступа пользователей). Важно выбирать инструменты, которые хорошо интегрируются с существующими системами управления данными и обеспечивают требования аудита и безопасности.


