

Оркестрация дата пайплайнов в системе подготовки данных
Для обработки больших данных нужна система, которая будет играть роль оркестратора. С помощью оркестратора данные из различных источников загружаются в хранилище. В качестве оркестратора может выступать уже готовое решение, такое как Apache Airflow, или собственные системы управления пайплайнами данных.
Airflow – это open source инструмент для создания, мониторинга и оркестрации пайплайнов, написанный на Python. Часто Airflow называют ETL-инструментом, но Airflow – это оркестратор, который управляет системами и фреймворками и следит за статусом выполнения задач по обработки данных. Однако, Airflow имеет возможность самостоятельно данные. Для оркестровки потоков операций используется представление в виде направленного ациклического графа (DAG). DAG позволяет запускать задачи последовательно, устанавливая разлчные правила перехода между ними. Задачи также можно запускать параллельно. Airflow может запускать операции по обработке данных по определённому расписанию или по событию.
Оркестрация процессов обработки данных с помощью Apache Airflow в Lamoda
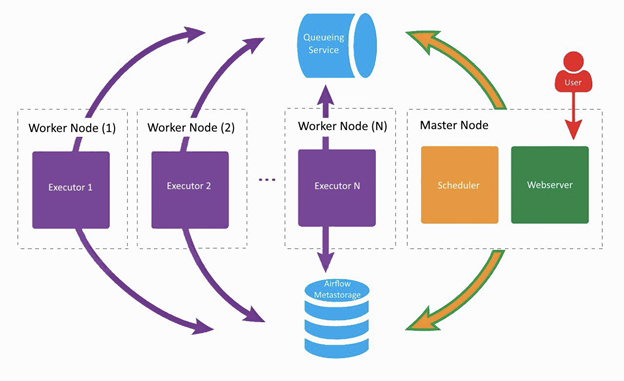
В компании Lamoda Airflow выполняет роль оркестратора процессов обработки больших данных, с его помощью которого данные из внешних систем попадают в Hadoop, обучаются ML модели и проводятся проверки качества данных, расчеты рекомендательных систем, различных метрик, А/Б-тестов и многое другое. С помощью оркестратора можно решить множество задач, не ограничиваясь запуском чего-то в Hadoop кластере. Airflow позволяет запускать Python-код, выполнять Bash команды, поднимать Docker контейнеры и поды в Kubernetes, выполнять запросы в бд и другое.
Lamoda использует два воркера. Воркер – это место, где запускается код и выполняются задачи. Один из них используется для регулярных базовых задач, а второй – для обучения ML моделей. На отдельном сервере находятся веб-сервер и scheduler. Веб-сервер – это веб-интерфейс, показывающий, что сейчас происходит с пайплайном. Scheduler – запускает пайплайны, когда настает их время. Он представляет собой Python-процесс, который периодически ходит в директорию с пайплайнами, подтягивает оттуда их актуальное состояние, проверяет статус и запускает. Все компоненты общаются между собой через очередь задач и базу метаданных.
Операторы, которые используются в Lamoda:
- Основной оператор – это LamodaDockerOperator. В основе лежит стандартный оператор, а к нему добавили монтирование актуальных конфиг-файлов Hadoop, прокидывание некоторых переменных окружения по умолчанию и еще парочку мелочей.
- LamodaHiveОperator – тоже оператор, который был изменен. Он отправляет запросы в Hive. В нем заменили тип хука, который использовался под капотом у этого оператора, с HiveCliHook на HiveServer2Hook.
- Следующий интересный оператор – это ExternalTaskSensor. С помощью пайплайны связаны между собой.
- BashOperator, PythonOperator – очевидно, запускают bash-команду и python код соответственно.
Леруа Мерлен развернули коммунальный Apache Airflow для 30+ команд и сотни разработчиков
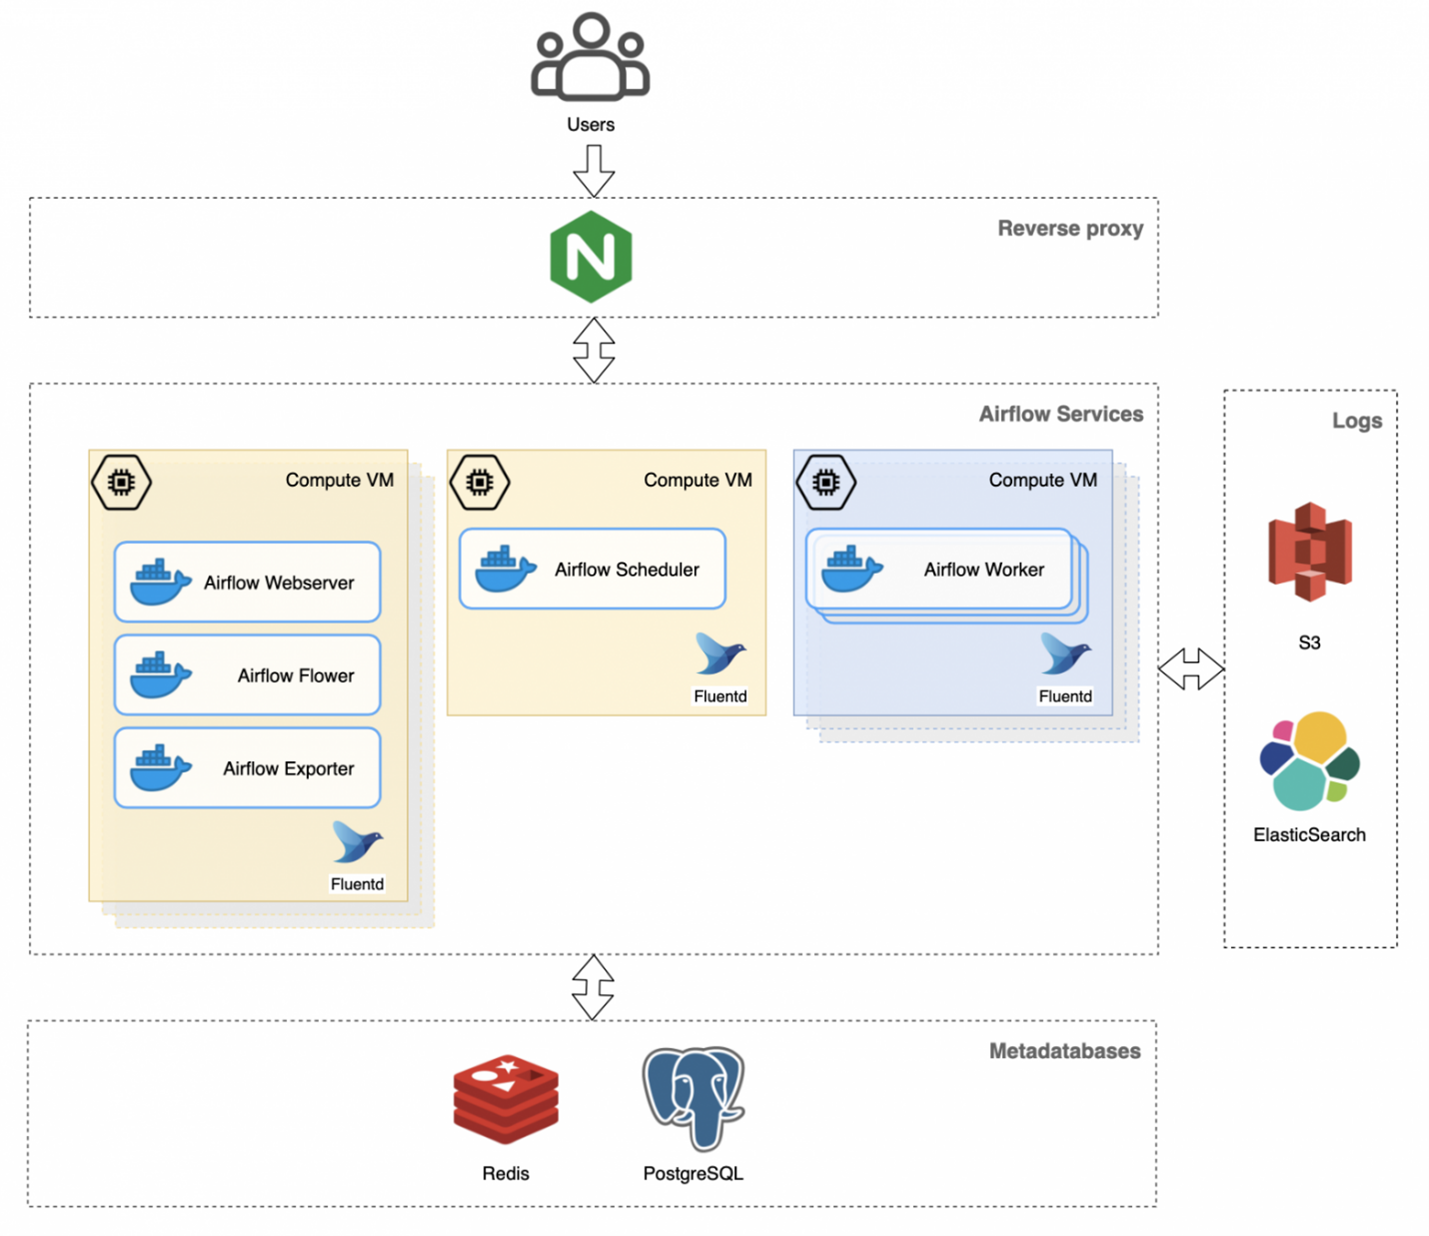
Сервисы Airflow в Леруа Мерлен развёрнуты в Docker контейнерах на VM в облаке. В качестве базы данных используется PostgreSQL и Redis как MQ (Airflow CeleryExecutor).
Логи DAGов сохраняются на S3 через настройки Airflow, логи самих сервисов (Docker контейнеров) через Fluentd пересылаются в Elasticsearch.
Пользователи обращаются через reverse proxy (Nginx) к развёрнутым инстансам Airflow Webserver.
Вся конфигурацию для Airflow передается через environment variables для запускаемых Docker контейнеров. Конфигурация содержится в deploy-репозитории.
Для каждого модуля настраивается конфигурация, в которой указывается какие worker для этого модуля нужно развернуть, на каких хостах, с какими переменными или секретами внутри.
Т.к. кластер коммунальный, а в Airflow нет гибкого RBAC для разграничения доступа на создание и изменение подключений, настройки подключений производятся администраторами кластера по запросам пользователей.
В компании используется Prometheus, как хранилище метрик, для мониторинга кластеров был разработан Prometheus Exporter с нужными метриками.
Exporter содержит общие метрики по состоянию кластера для SRE платформы.
Теле2 превратили Airflow 2.х в SaaS-решение
Tele2 радикально пересмотрели подход к использованию Airflow. Изначально использовался Production Airflow версии 1.10.12 в одном экземпляре, развёрнутом при помощи docker-compose на выделенной виртуальной машине. Рабочая нагрузка — 50–60 DAGов с частотой запуска от раза в 10 минут до раза в час плюс несколько DAGов с запуском раз в месяц. За основу был взят образ от Puckel, который впоследствии модифицировали дополнительными библиотеками и драйверами, а затем его перевели на CentOS. Данное решение имело несколько проблем: необходимость «букинга» стендов, под новые стенды нужны дополнительные ресурсы, возможность поломки стендов пользователями и другое.
Требования к решению:
- Временное хранилище для DAGов, куда складывалась бы промежуточная информация во время исполнения задач DAGа и которое удалялось бы после завершения.
- Возможность экспериментировать с различными версиями и набором библиотек и версиями самого Airflow без опасения сломать стенд.
- Возможность быстрой смены Executor’ов Airflow.
- Разграничение прав и доступов пользователей.
- self-hosted решение.
Инфраструктурным сердцем для SaaS-решения стал Kubernetes.
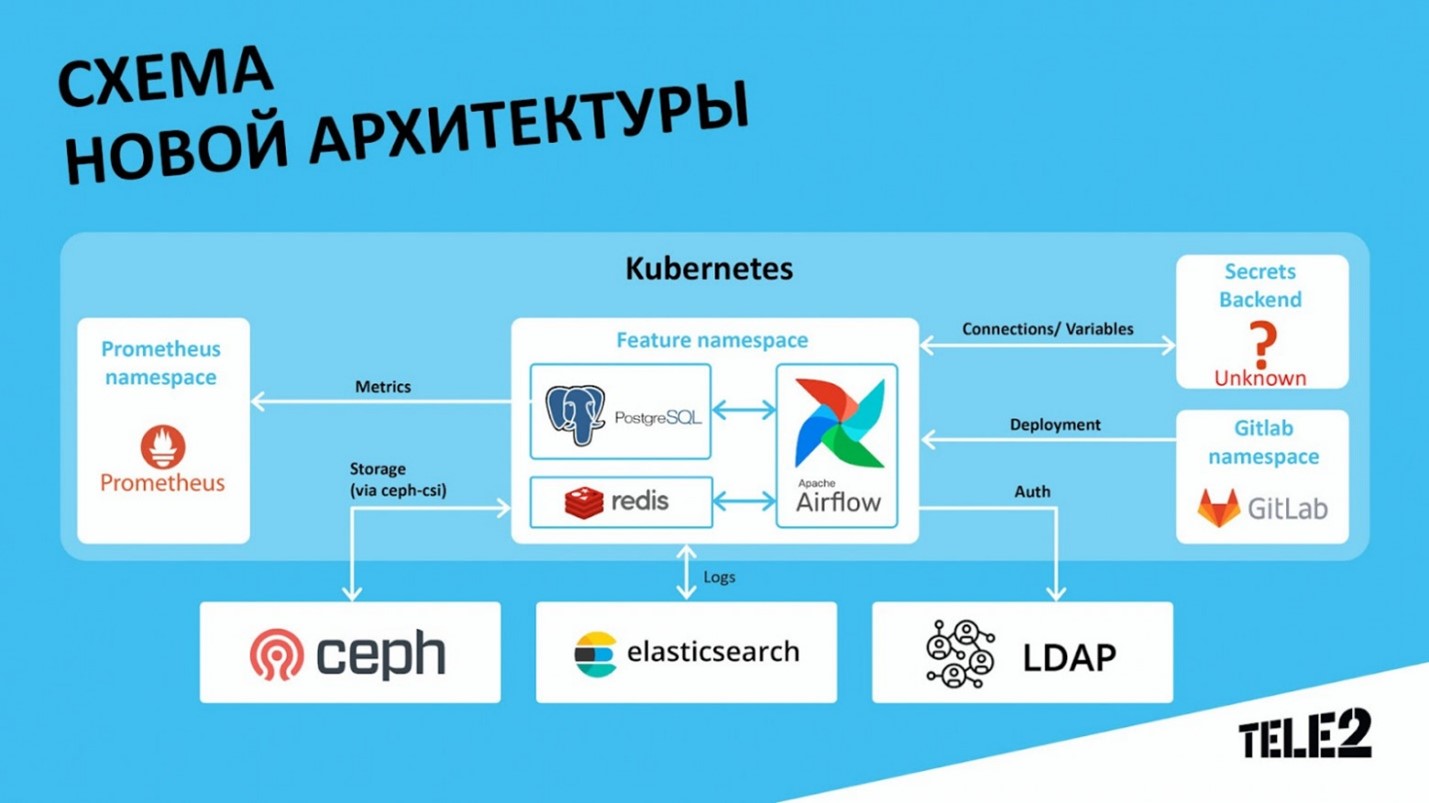
Для логов сначала ипользовался Elasticsearch, а затем S3. Сервисная БД — PostgreSQL. В качестве хранилища DAGов и промежуточного хранилища для них используется механизм K8s Persistent Volume и данные volume’ы хранятся на Ceph. Авторизация пользователей осуществляется через LDAP. В качестве мониторинга был выбран Prometheus. Для хранения секретов используется решение Hashicorp Vault.
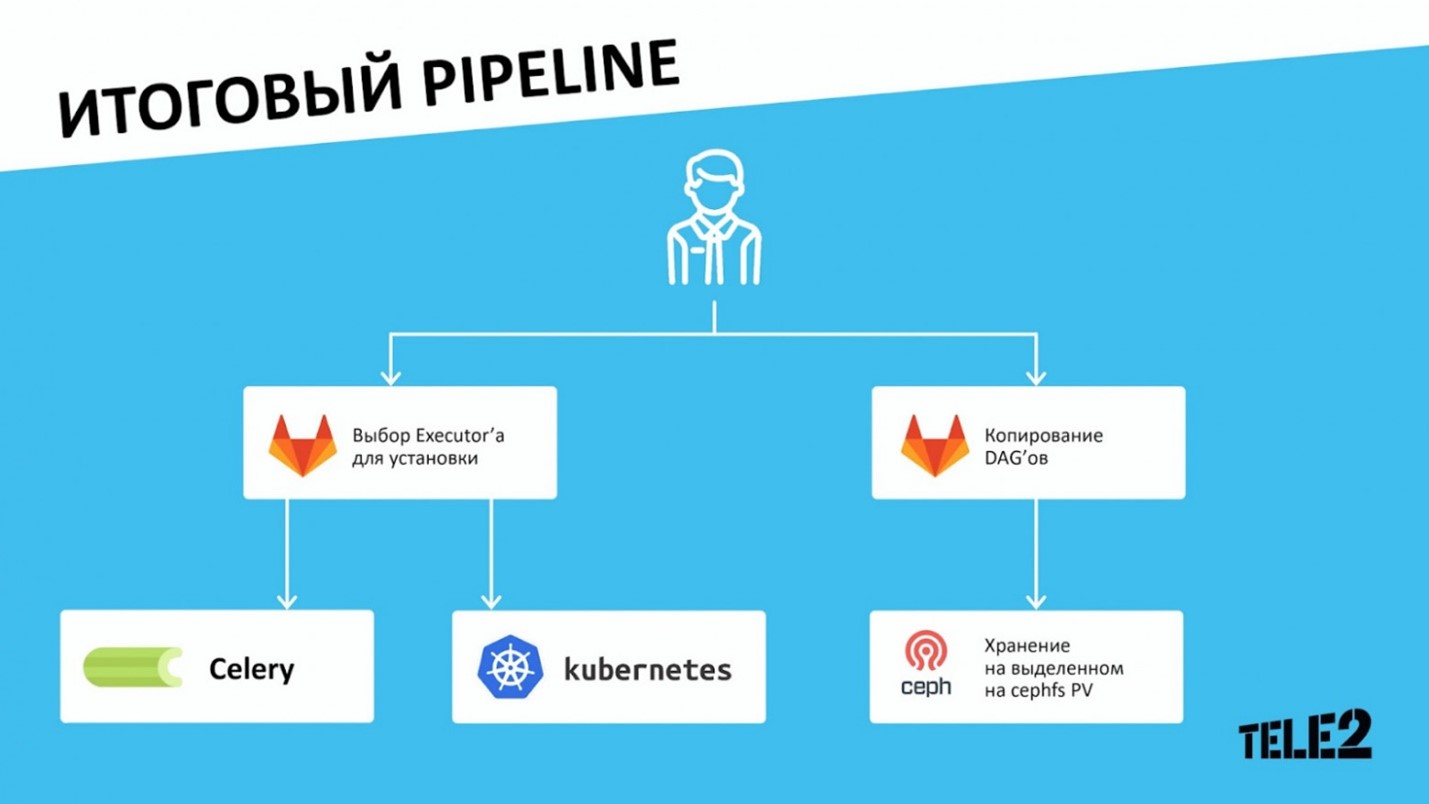
Процесс деплоя происходит следующим образом. При коммите собирается артефакт с DAGами, после чего пользователь в gitlab-ci pipeline имеет выбор из трёх кнопок: создать стенд с Celery Executor’ом, создать стенд с Kubernetes Executor’ом или же скопировать на имеющийся стенд свои DAGи.
Преимущества от реализации проекта:
- Централизованное хранилище логов.
- Версионированность Connections и Variables.
- Пользователь сам выбирает версию Airflow и набор библиотек.
- K8s-executor сократил затраты ресурсов.
- Полная изоляция пользователей.
- Масштабируемость проекта ограничена лишь ресурсами.
- Ресурсы больше не простаивают.
- Администрирование.
-
Отказоустойчивость Production.
Газпромбанк создает эластичный DAG
DAG позволяет собирать отдельные задачи в полноценные процессы. Задачи можно выполнять последовательно, устанавливая разные правила перехода между ними. Можно запускать задачи параллельно, особенно удобно делать это внутри кластера Kubernetes, когда каждая параллельная задача оформляется в виде отдельного k8s PODа. К слову, и сам Airflow, в Газпромбанке крутится тоже внутри кубер-подов. Каждой задаче необходим набор конфигурационных параметров, которые хранятся в Airflow Variables. Словарь из Airflow Variable содержит какие-то постоянные значения, которые, как правило, один раз бетонируются, и потом, меняются довольно редко. Своего рода setup.ini для реализованного процесса. Словарь из ручного запуска используется несколько иначе. Это возможность оперативного вмешательства в работу процесса. Например, большинство загрузок данных выполняются регулярно, как правило, раз в сутки в своё время. В ходе эксплуатации, особенно на этапе запуска, а особенно отладки, возникает необходимость скорректировать глубину захвата данных. Необходимо менять значения переменных внутри работающего кода простым способом. Значение переменной внутри блока кода должно быть назначено по следующему сценарию: сначала посмотреть, а нет ли переменной с таким именем внутри словаря из ручного запуска DAGa – если есть, взять значение, если нет – то посмотреть, а нет ли переменной с таким именем внутри Airflow Variable – и снова по уже озвученному сценарию. И наконец, если нигде такой переменной не обнаружилось, то присвоить значение из заданных в коде параметров.
Оркестрация обработки данных в AirFlow в Билайн
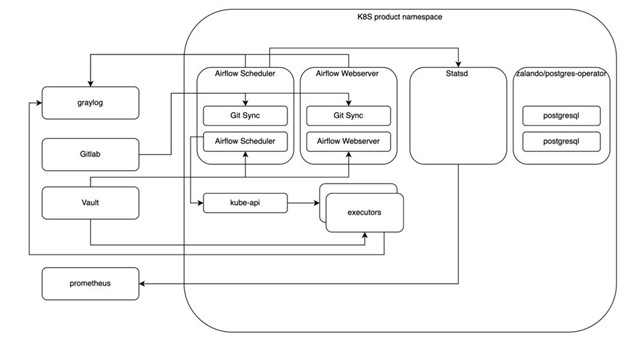
Билайн с 2020 года начал внедрять Airflow для оркестрации задач. Airlow в компании запускается только на Kubernetes для каждой команды – свой экземпляр с соблюдением всех правил по безопасности. Продуктовые команды разделены по namespaces, выполнение каждого оператора происходит в отдельно поднимаемом поде неймспейса продукта. Все секреты хранятся в Vault. В самом Vault используется Kubernetes-аутентификация. Все логи приложений в Kubernetes (и AirFlow не исключение) просматриваются через GrayLog. Метрики scheduler-а из statsd забираются Prometheus, поверх них строится алертинг и визуализация в Grafana. DAG-и для каждой продуктовой команды хранятся в GitLab и оттуда через CI/CD доставляются на продуктивный контур. Для работы каждого инстанса AirFlow используется Postgres с автоматическим failover, который также запускается на Kubernetes.
М.Видео – Эльдорадо разработали собственную систему управления пайплайнами данных
Для управления пайплайнами данных М.Видео – Эльдорадо решили разработать собственную систему – Wombat. Решение создать собственную систему управления пайплайнами данных появилось после теста множества готовых решений. В Airflow, например, не хватало основных блоков, были критичными такие возможности, как интеграция системы управления пайплайнами с системой сборки и CI, интеграция с Kubernetes, возможность управления артефактами и валидации данных. В команде разработки М.Видео – Эльдорадо поддержку сервисов в продакшене ведут инженеры DevOps. Они привыкли работать с пайпланами, которые описываются не кодом, а конфигами в форматах, подобных yaml. Пайплайны в форме ориентированных ацикличных графов описываются в формате, который используется в стандартных инструментах CI и DevOps.
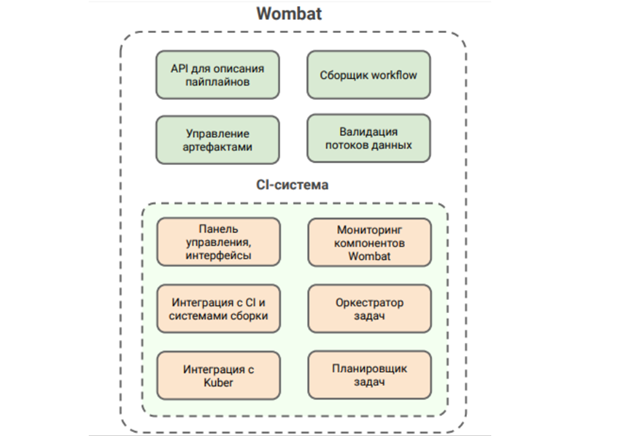
Wombat – промежуточный слой между описанием пайплайнов и CI-системой, при помощи которой реализуется работа с ними в продакшене. Благодаря такой схеме работы решается проблема с хранением артефактов данных и их версионированием.
Ашан развернул платформу в публичном облаке
Облачная платформа Mail.ru Cloud Solutions была выбрана Ашаном для развертывания.
В проекте используются следующие сервисы Mail.ru Cloud Solutions:
- Cloud Big Data на основе Hadoop и Spark. Хранилище сырых и холодных данных, в которое будет поступать необработанная информация из различных источников
- СУБД ClickHouse. Хранилище горячих данных, где будут размещаться продуктовые витрины
- Kubernetes aaS.
- GitLab. Конвейер CI/CD. Доступен в Marketplace Mail.ru Cloud Solutions.
- AirFlow. Оркестратор ETL-процессов, тоже есть в Marketplace Mail.ru Cloud Solutions.
Схема взаимодействия развернутых компонентов платформы выглядит так:
Сырые данные из On-premise-источников (пока только в пакетной форме) в инкрементном виде ежедневно загружаются в Hadoop — с использованием Apache Sqoop и Talend. Для загрузки выбираются только те данные, что необходимы для наших ML-решений.
В Hadoop проводится очистка данных и дата-аудит при помощи настроенных процедур Data Quality. Они не только проверяют соответствие между источником и получателем данных, но и выполняют первичный анализ данных с точки зрения заложенной бизнес-логики.
По итогам проверок в Hadoop:
- данные, успешно прошедшие процедуры Data Quality, загружаются в детальный слой очищенных данных Hadoop;
- данные, не прошедшие процедуры Data Quality, удаляются.
Данные из Hadoop попадают в Spark. После ETL данные из Spark передаются в ClickHouse. Это касается наиболее часто используемых витрин, так как ClickHouse ориентирован в первую очередь на быстрый вывод горячих данных.
Еще используется GitLab для поддержки процессов CI/CD и Apache Airflow — оркестратор, позволяющий управлять сложными цепочками последовательных ETL-процессов.


