

Перспективная архитектура данных для повышения качества данных
В этой статье мы рассмотрим лучшие практики создания надежных систем данных для получения высококачественных данных.
Качество данных - неотъемлемая часть инженерии данных. Поскольку любые инсайты хороши и пригодны ровно настолько, насколько хороши и пригодны исходные данные, создание надежных и устойчивых систем данных, предоставляющих исключительно высококачественные данные, является святейшей обязанностью команды инженеров по обработке данных. Достижение и поддержание надлежащего качества данных - задача непростая…
В этой статье мы рассмотрим ключевые компоненты систем инженерии данных, которые необходимы для получения высококачественных данных:
- Мониторинг качества данных - как измерить корректность выходных данных при любом конвейере данных и как обеспечить корректность выходных данных не только сегодня, но и в обозримом будущем;
- Восстановление данных - как выполнить восстановление данных, чтобы минимизировать негативное воздействие на последующих пользователей (в случае сбоев в работе приложений);
- Предотвращение регрессий качества данных - как предотвратить неожиданные регрессии при изменении источников данных или при добавлении новых функций в существующие приложения для работы с данными.
Мониторинг качества данных
По мере развития бизнеса меняются и данные. Измерение качества данных никогда не было одноразовой задачей, важно постоянно контролировать качество данных в конвейерах данных. Самый первый шаг в мониторинге качества данных - это определение метрик качества данных на основе определенных показателей.
Определение качества данных
Определение качества данных - это установление ожиданий касательно выходных данных и измерение отклонений фактически полученных данных от установленных ожиданий в виде количественных показателей. При определении показателей качества данных первое, что должны учитывать инженеры по обработке данных, - это вопрос: "Какую истину представляют собой данные?" Например, выходная таблица должна содержать все события, связанные с показом рекламы, которые произошли на сайте розничной сети. Метрики качества данных должны быть разработаны таким образом, чтобы система данных точно отражала эту истину.
Чтобы точно измерить качество данных в системе данных, инженеры по обработке данных должны отслеживать не только базовые показатели работоспособности и производительности приложения (такие как отказы в выполнении заданий, задержки обработки и т.д.), но и специализированные метрики, основанные на бизнес-показателях. Поэтому дата-инженеры должны очень хорошо разбираться в основных бизнес-проблемах.
Поскольку бизнес-модель определяет характер данных, бизнес-контекст позволяет дата-инженерам лучше понять значение данных, схемы трафика, а также потенциальные побочные эффекты.
Несмотря на то, что каждая система данных служит для различных бизнес - целей, некоторые общие закономерности в показателях качества данных все-таки существуют, ознакомьтесь с содержанием Таблицы № 1.
|
МЕТРИКИ ДЛЯ ИЗМЕРЕНИЯ КАЧЕСТВА ДАННЫХ В КОНВЕЙЕРЕ ДАННЫХ |
|
|---|---|
|
Тип |
Ограничения |
|
«Здоровье» приложения |
Количество успешно выполненных или запущенных заданий (для потоковой передачи) должно быть равно N. |
|
SLA / задержки |
Задание должно быть выполнено до 8 утра (PST )ежедневно. Максимальная задержка обработки событий должна составлять < 2 секунд (для потоковой передачи). |
|
Схема |
Колонка account_id должна иметь тип INT и не может быть NULL |
|
Значения столбцов |
Столбцы account_id должны содержать только целые положительные числа. Столбец account_type может иметь только следующие значения: FREE, STANDARD или MAX. |
|
Сопоставление с историей |
Общее количество подтвержденных заказов на любую дату должно быть в пределах +20%/-20% от среднего значения за последние 30 дней. |
|
Сопоставление с другими наборами данных |
Количество отгруженных заказов должно соотноситься с количеством подтвержденных заказов. |
Внедрение мониторов качества данных
После определения списка показателей качества данных эти показатели должны быть зафиксированы как часть системы данных, а мониторинг показателей должен быть максимально автоматизирован. В случае обнаружения нарушений качества данных необходимо немедленно оповестить дежурных дата-инженеров. В современном мире данных команды инженеров по обработке данных зачастую пользуются несколькими приложениями для работы с пакетными и потоковыми данными, поэтому не стоит забывать о том, что метрики качества данных для пакетных и потоковых систем разные.
Системы пакетной обработки данных
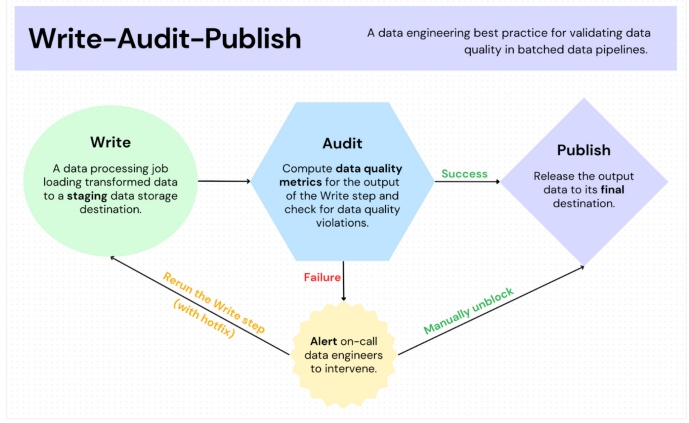
Паттерн Write-Audit-Publish (WAP) - это лучшая практика инженерии данных, широко используемая для контроля качества данных в конвейерах пакетной обработки данных. Он подчеркивает важность постоянной оценки качества данных перед их передачей последующим пользователям.
Системы потоковой передачи данных
К сожалению, паттерн WAP неприменим к потокам данных, поскольку приложения потоковой обработки данных должны обрабатывать данные безостановочно, любая приостановка производственных потоковых заданий для устранения каких-либо проблем с качеством данных неприемлема. В архитектуре Lambda вывод систем потоковой обработки событий также хранится в хранилище Lakehouse (например, в таблице Apache Iceberg или Apache Hudi ). В результате дата-инженеры также часто внедряют мониторы качества пакетных данных на основе WAP в таблицах Lakehouse.
Для мониторинга качества данных в режиме, близком к реальному времени, одним из вариантов является реализация проверок качества данных в виде запросов в режиме реального времени к выходным данным, таким как тема Apache Kafka или источник данных Apache Druid. Для крупномасштабного вывода обычно применяется выборка, что позволяет повысить эффективность запросов к агрегированным метрикам. Такие вспомогательные фреймворки, как Schema Registry, также могут быть полезны для обеспечения совместимости выходных событий с ожидаемой схемой.
Другой вариант заключается в том, чтобы фиксировать показатели качества данных по каждому событию в рамках логики приложения и записывать результаты в хранилище данных временных рядов. Этот вариант предполагает дополнительные расходы, но позволяет лучше видеть промежуточные этапы/операции с данными и упрощает поиск и устранение неисправностей. Например, если логика приложения решит отбрасывать события, содержащие недостоверные account_id, account_type или order_id, то при выпуске новой версии системы появится большое количество событий с недостоверными account_id, метрики качества данных на основе выходных данных покажут снижение общего количества выходных событий. Однако без метрик или журналов промежуточных этапов/операций с данными будет сложно определить, какая логика фильтрации или колонка является первопричиной.
Восстановление данных
Абсолютно каждый конвейер данных в какой-то момент дает сбой… К числу наиболее распространенных причин сбоев относятся следующие:
- Несовместимые обновления исходных данных (например, из исходных таблиц были удалены критически важные столбцы);
- Сбои в работе систем исходных или исходных данных (например, исходные базы данных стали недоступны);
- Измененная истина данных (например, логика обработки данных устарела после выхода нового продукта);
- Человеческий фактор (например, в новой сборке появились новые ошибки, которые остались необработанными).
Поэтому все системы данных должны иметь возможность постоянного пополнения, чтобы минимизировать влияние потенциальных сбоев на последующие бизнес-процессы. Кроме того, в системах потоковой обработки данных возможность дозагрузки также необходима для запуска больших заданий потоковой обработки.
Системы пакетной обработки данных
Решения по хранению для пакетных систем, такие как AWS S3 и GCP Cloud Storage, относительно недороги, а хранение исходных данных обычно не является ограничивающим фактором при резервном копировании. Пакетные данные часто записываются и считываются по разделам событийного времени, а задания по обработке данных планируются на определенные интервалы времени и имеют четкие временные границы начала и завершения.
Основная техническая проблема при заполнении конвейеров пакетных данных заключается в отслеживании данных: какие задания обновляли, в какие временные диапазоны и т.д. Четкая последовательность данных позволяет дата-инженерам легко определить последующие задания, на которые негативно повлияли проблемные разделы данных. Современные форматы таблиц Lakehouse, такие как Apache Iceberg, предоставляют доступные для запросов журналы изменений на уровне таблиц и снимки истории, что позволяет пользователям вернуть любую таблицу к определенной версии в случае, если недавнее обновление данных повредило таблицу. Чем меньше метаданных о происхождении данных, тем больше ручной работы потребуется для оценки последствий и восстановления данных.
Системы потоковой передачи данных
Исходные данные, используемые в потоковых системах, таких как Apache Kafka, часто имеют ограниченный срок хранения из-за высокой стоимости хранения данных. Например, для потоков данных в веб-масштабе хранение данных часто устанавливается на уровне нескольких часов, что позволяет сохранить затраты на разумном уровне. Поскольку устранение сбоев может занимать несколько часов, а то и дней, срок хранения исходных данных может истечь еще до их пополнения. В результате сохранение данных часто становится проблемой при резервном заполнении потоков событий.
Ниже приведены самые распространенные методологии обратного заполнения для систем потоковой передачи данных:
|
МЕТОДЫ НАПОЛНЕНИЯ СИСТЕМ ПОТОКОВЫХ ДАННЫХ |
|
|---|---|
|
Метод |
Описание |
|
Воспроизведение исходных потоков |
Повторная обработка исходных данных за проблемный период времени до того, как истечет срок хранения в исходных системах (например, Apache Kafka). Многоуровневое хранилище может помочь снизить стоимость хранения данных. |
|
Lambda- архитектура |
Поддержание параллельного приложения для работы с пакетными данными (например, Apache Spark), считывающего исходные данные из хранилища Lakehouse с длительным сроком хранения. |
|
Kappa - архитектура |
Приложение для потоковой передачи данных способно передавать данные как из потоков данных (для производства), так и из хранилища Lakehouse (для пополнения). |
|
Унифицированная пакетная и потоковая передача данных |
Фреймворки для обработки данных, такие как Apache Beam, поддерживают как потоковый (для производства), так и пакетный режим (для резервного копирования). |
Предотвращение регрессий качества данных
Допустим, в конвейере данных реализован полный набор метрик качества данных и механизм восстановления данных, гарантирующий, что в любой момент можно будет восстановить достоверные исторические данные. Что может пойти не так? Без определенных механизмов предотвращения регрессий команда дата-инженеров может лишь пассивно реагировать на проблемы с качеством данных, раз за разом тушить один и тот же пожар. Для того, чтобы действительно защитить конвейер данных, дата-инженеры должны проактивно создавать программные контракты с данными, чтобы пресечь регресс качества данных на корню.
Проблемы с качеством данных могут исходить либо от вышестоящих систем, либо от прикладной логики, поддерживаемой дата-инженерами. В обоих случаях контракты с данными должны быть реализованы программно, например, с помощью модульных тестов и/или интеграционных тестов (чтобы предотвратить попадание в производство любых изменений, нарушающих контракт).

Заключение
Качество данных должно быть главным приоритетом каждого конвейера данных, а архитектура данных должна разрабатываться с учетом обеспечения высокого качества данных. Первым шагом в создании надежных и устойчивых систем данных является определение набора показателей качества данных на основе бизнес-показателей. Показатели качества данных должны фиксироваться как часть системы данных и постоянно отслеживаться, а данные должны иметь возможность постоянного резервного копирования, чтобы минимизировать потенциальное воздействие на последующих пользователей в случае возникновения проблем с качеством данных. И последнее, но не менее важное: дата-инженеры должны создавать программные контракты с данными в виде кода, чтобы проактивно предотвращать регрессии качества данных.
Только когда системы инженерии данных надежно защищены на долгосрочную перспективу и поставляют исключительно высококачественные данные, можно со 100 - процентной уверенностью принимать бизнес-решения, основанные на данных.


