

Picodata: перезагрузка in-memory баз данных для архитектуры будущего
Сегодня мы хотим поделиться с вами видением будущего систем управления базами данных и рассказать, какое место в этом будущем занимают высокопроизводительные in-memory решения.
Если оглянуться на прогнозы десятилетней давности, многие из них сегодня покажутся нам наивными. Мы ожидали резкого падения стоимости оперативной памяти, появления энергонезависимой памяти и полного вытеснения традиционных накопителей. Тогда магистральным путем развития виделось горизонтальное масштабирование — подход, при котором нагрузка распределяется между множеством недорогих серверов. Этот тренд, известный как Webscale, стал синонимом высоких нагрузок.
Примечание:
Webscale — это архитектурный подход и набор принципов проектирования ИТ-систем, которые позволяют им масштабироваться до огромных размеров, характерных для крупнейших интернет-компаний (таких как Google, Amazon, Facebook), и справляться с экстремальными, непредсказуемыми нагрузками.
Если говорить проще, это способ построения систем, которые могут расти практически бесконечно, чтобы обслуживать миллионы или миллиарды пользователей по всему миру без потери производительности и доступности.
Ключевые характеристики Webscale:
- Горизонтальное масштабирование (Scale-Out) - вместо вертикального масштабирования (Scale-Up), которое подразумевает увеличение мощности одного сервера (больше CPU, RAM, дисков). Осуществляется путем добавления большого количества стандартных, относительно недорогих серверов (нод) в кластер. Если нагрузки растут — вы просто добавляете еще серверов. Например, чтобы удвоить производительность, вы добавляете второй, третий и т.д. сервер, а не покупаете один сервер в два раза мощнее.
- Устойчивость к отказам (Resilience и High Availability). Любой компонент системы может выйти из строя в любой момент. Архитектура должна быть спроектирована так, чтобы это не влияло на общую работоспособность системы. Достигается путем избыточности и репликации данных на множестве серверов. Если один сервер падает, его нагрузка автоматически перераспределяется на другие.
- Эластичность (Elasticity). Система может динамически "расширяться" (добавлять ресурсы при росте нагрузки) и "сжиматься" (освобождать ресурсы при спаде). Это особенно критично в облачных средах, где вы платите только за то, что используете.
- Децентрализация и распределенность. Система не имеет единой точки отказа (SPOF). Данные и сервисы распределены по многим узлам, часто в разных дата-центрах (availability zones).
- Ориентация на API и сервисы. Система строится как набор loosely coupled (слабо связанных) сервисов (микросервисов), которые взаимодействуют друг с другом через четко определенные API.
Данный подход позволяет строить глобальные, высоконагруженные и отказоустойчивые приложения. Это основа современного интернета. Однако он невероятно усложняет систему. Резко возрастает сложность разработки, эксплуатации (DevOps), обеспечения консистентности данных (приходится жертвовать строгой согласованностью в угоду доступности, следуя теореме CAP).
Однако реальность оказалась сложнее. Современные серверные накопители демонстрируют впечатляющий прогресс. Компании вроде Pascari и Solidigm анонсируют жесткие диски объемом до 122 ТБ, обеспечивающие миллионы операций ввода-вывода в секунду. Всего в восьми таких дисках можно разместить более петабайта данных. В паре с современными процессорами на 96–128 ядер, такими как AMD EPYC 9xxxx, мы получаем мощнейший вычислительный узел, мини-дата-центр в форм-факторе одного сервера.
Возникает закономерный вопрос: так ли необходимо сложное горизонтальное масштабирование, когда один сервер обладает такой мощью? Многие современные СУБД, оптимизированные под многопоточность и большие объемы памяти, например, форки PostgreSQL вроде OrioleDB, показывают производительность, сопоставимую с кластерами из нескольких машин.
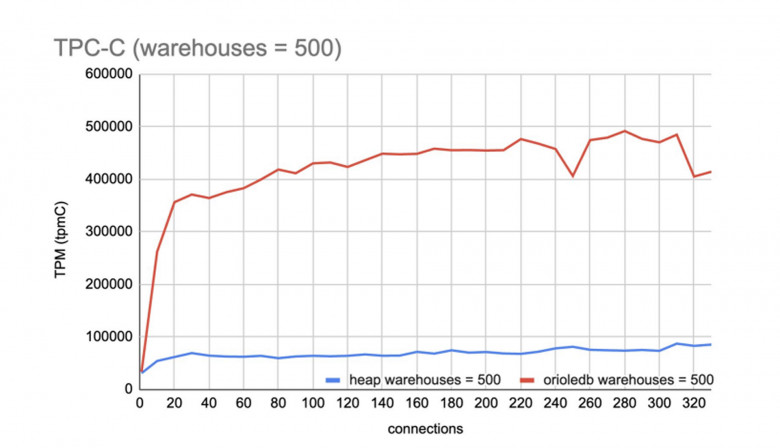
OrioleDB — это современный движок хранения для PostgreSQL, призванный заменить собой традиционный движок под кодовым именем InnoDB (который в мире PostgreSQL известен через своего предшественника и аналог). Это не просто надстройка, а глубокая переработка ключевых компонентов СУБД для эффективной работы на современном оборудовании.
Классический PostgreSQL, как и многие другие реляционные СУБД, был спроектирован в эпоху, когда оперативная память была дорогой, а диски — медленными. Его архитектура несет на себе отпечаток тех ограничений: двойная запись (данные сначала записываются в журнал предзаписи (WAL), а затем в сами таблицы, что гарантирует согласованность, но создает значительную нагрузку на ввод-вывод); буферный кэш (PostgreSQL управляет своим собственным кэшем в оперативной памяти, дублируя функциональность кэша файловой системы ОС, что приводит к лишним накладным расходам и избыточному копированию данных); структуры данных на диске (традиционные B-деревья не оптимальны для многопоточных запросов на современном многопроцессорном оборудовании, что приводит к конкуренции); проблемы с VACUUM (механизм очистки от "мертвых" записей может становиться "бутылочным горлышком" на интенсивно обновляемых таблицах, потребляя много ресурсов и вызывая замедление работы).
OrioleDB был создан, чтобы устранить эти архаизмы и сделать PostgreSQL по-настоящему высокопроизводительной СУБД для современных SSD и многопроцессорных систем.
OrioleDB — это не просто патч, а новый движок таблиц, который полностью переосмысливает работу с данными. Он использует B-деревья с механизмом copy-on-write. Это означает, что при изменении данных не происходит перезаписи страниц на месте. Вместо этого создаются новые версии страниц. Старые версии помечаются как устаревшие и впоследствии собираются сборщиком мусора.
Кроме того, OrioleDB объединяет журнал транзакций и данные в единую структуру. По сути, WAL становится основным хранилищем, а табличные файлы — лишь "снимком" (snapshot) данных на определенный момент.
Помимо всего прочего OrioleDB полагается на кэш файловой системы ОС (Page Cache). Для современных ОС (особенно Linux) это гораздо более эффективно, так как ядро ОС оптимально управляет памятью, предварительной выборкой (readahead) и вытеснением страниц.
Также OrioleDB использует усовершенствованные варианты B-деревьев (например, основанные на идеях из LSM-деревьев), которые лучше масштабируются на многоядерных системах и уменьшают конкуренцию за блокировки.
Проблема "мертвых" записей решается более эффективно и фоново, без создания пиковых нагрузок, характерных для классического VACUUM в PostgreSQL.
OrioleDB идеально подходит для высоконагруженных приложений, где классический PostgreSQL упирается в ограничения I/O или CPU:
- Высокочастотные транзакционные системы (OLTP): Финансовые платформы, биллинг, системы бронирования.
- Сервисы с интенсивной записью: Системы сбора логов, телеметрии, IoT-платформы.
- Системы, требующие низких задержек: Онлайн-игры, реальные аукцины (ad-tech), торгующие системы.
Таким образом, OrioleDB — это смелый и технически обоснованный шаг в эволюции PostgreSQL. Он не просто "ускоряет" базу, а перестраивает ее ядро для новой эпохи быстрых SSD и массового параллелизма. Если вы столкнулись с ограничениями производительности в PostgreSQL, особенно на нагрузках, связанных с записью, OrioleDB — это одно из самых перспективных направлений для решения этой проблемы без смены самой СУБД.
Далее рассмотрим горизонтально масштабируемые системы, такие как ScyllaDB, которые извлекают из одного узла на порядок большую производительность, чем классические базы данных. На трех узлах средней мощности ScyllaDB может обеспечивать 500 000 запросов в секунду.
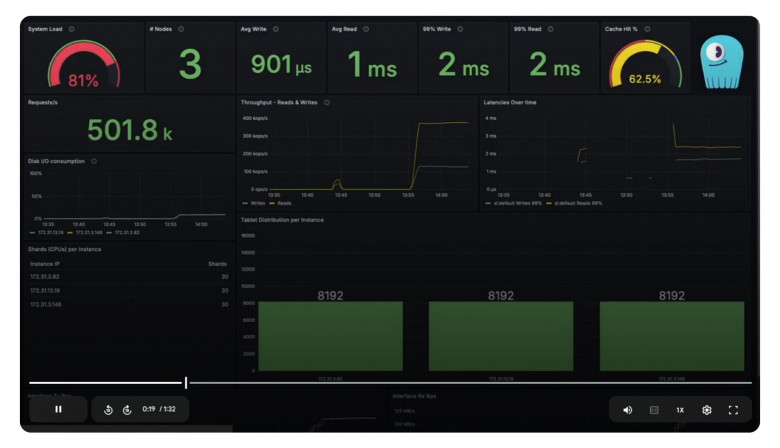
ScyllaDB — это высокопроизводительная, отказоустойчивая распределенная NoSQL СУБД с открытым исходным кодом, совместимая на уровне API с Apache Cassandra, но переписанная на C++ вместо Java. Это не форк, а полностью переработанная реализация с архитектурой, ориентированной на современное оборудование. Ключевая философия: "Что, если Cassandra могла бы быть быстрее?"
Совместимость:
- CQL (Cassandra Query Language)
- Протоколы подключения (бинарный, Thrift)
- Форматы данных на диске (SSTable)
- Инструменты (cqlsh, nodetool)
Распределенная архитектура:
- P2P (peer-to-peer) без единой точки отказа
- Репликация на основе стратегий (NetworkTopologyStrategy, SimpleStrategy)
- Поддержка нескольких дата-центров
- Tunable consistency (ONE, QUORUM, ALL, LOCAL_QUORUM)
Сравнительные тесты:
Нагрузка: 1 млн операций/сек
Кластер: 3 узла

Cassandra:
- Задержка (p99): 10-50 мс
- CPU утилизация: 80-90%
- Потребление памяти: Высокое, с GC паузами

ScyllaDB:
- Задержка (p99): < 5 мс
- CPU утилизация: 30-50%
- Потребление памяти: Стабильное, без пауз
Сравнение с другими решениями
|
Характеристика |
Cassandra |
ScyllaDB |
Aerospike |
|---|---|---|---|
|
Язык |
Java |
C++ |
C |
|
Архитектура |
Thread-per-core |
Shard-per-core |
Hybrid |
|
Производительность |
Средняя |
Высокая |
Очень высокая |
|
Задержка (p99) |
Переменная |
Стабильно низкая |
Очень низкая |
|
Операционные затраты |
Высокие |
Средние |
Низкие |
|
Сообщество |
Большое |
Растущее |
Нишевое |
В целом ScyllaDB доказала, что архитектурные инновации могут давать кратный прирост производительности без потери совместимости. Это идеальный выбор для компаний, которые упираются в ограничения Cassandra, нуждаются в предсказуемо низкой задержке, хотят снизить TCO (total cost of ownership), имеют растущие нагрузки реального времени
При правильной эксплуатации ScyllaDB обеспечивает производительность уровня "железных" решений с гибкостью open-source платформы. Это один из лучших примеров эволюции NoSQL баз данных в эпоху массового параллелизма и высокоскоростных сетей.
Очевидно, что дело не только в выборе между горизонтальным и вертикальным масштабированием. Ключевой фактор — внутренняя архитектура СУБД, которая должна соответствовать современному оборудованию, эффективно используя множество ядер и высокоскоростные накопители.
Ключевые тренды в мире СУБД: на что обратить внимание
Современный ландшафт систем управления базами данных определяют несколько ярко выраженных тенденций.
Во-первых, это явное разделение вычислений и хранения. Эта парадигма, противоречащая классическому принципу локальности данных, стала популярной с ростом облачных технологий. Масштабировать вычислительные ресурсы независимо от хранилища оказалось проще и зачастую дешевле. Такие инструменты, как Trino, DuckDB с ее облачным аналогом MotherDuck, и Neon, активно используют этот подход. Однако за снижение стоимости хранения и упрощение масштабирования приходится платить задержками. Мы наблюдаем контртренд, представленный, например, проектом Turso, и уверены, что растущий спрос на near-real-time аналитику в ближайшие 5–10 лет вновь вернет нас к конвергентным архитектурам, где вычисления и хранения находятся рядом.
Во-вторых, это закрытие исходного кода и ориентация на облака. Вендоры все чаще отказываются от открытых лицензий в пользу проприетарных. Это касается MongoDB, Elasticsearch, ScyllaDB, Greenplum, CockroachDB, Timescale и многих других. Причины разные: защита от облачных провайдеров, монетизация в модели DBaaS. Деглобализация также бьет по open-source: мы видим географические ограничения для разработчиков, глубокие форки проектов в Китае, растущую консервативность мейнтейнеров.
Это приводит в первую очередь к фрагментации лицензий (AGPL, BSL, SSPL). Совместимость между ними отсутствует, что дробит сообщество. Кроме того, это приводит и к жесткой привязке к облакам: многие СУБД максимально раскрывают свой потенциал только в виде управляемого сервиса у конкретного провайдера.
В этих условиях по-настоящему открытыми остаются лишь платформенные игроки, предлагающие целые экосистемы, а не одну базу данных.
Тренд на polyglot persistence, когда в рамках одной архитектуры используются разные СУБД под конкретные задачи, жив и здоров. Более того, рынок продолжает дробиться, появляются новые узкоспециализированные решения для AI, аналитики, встраиваемых систем. Новым витком развития стала модульность. Если раньше строительными блоками для СУБД были лишь единицы проектов вроде RocksDB, SQLite или H2, то сегодня эта экосистема растет:
- Apache DataFusion Kernel — аналитический оптимизатор запросов, используемый в различных продуктах.
- Библиотека etcd-raft используется как модуль репликации в etcd и CockroachDB.
- Cassandra-accord —пример выделения алгоритма управления транзакциями в отдельный проект.
- DuckDB может использоваться как встраиваемая библиотека анализа данных.
- Turso переписал sqlite на Rust, сделав его родным для Rust-экосистемы.
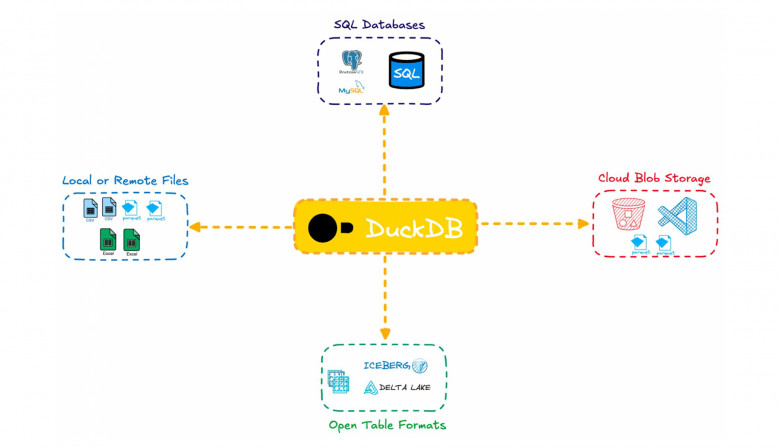
Это указывает на будущее, где СУБД будут собираться из готовых, высококачественных компонентов, как современные приложения собираются из библиотек.
Почему резидентные СУБД сегодня актуальны как никогда
На фоне этих трендов может показаться, что эра резидентных in-memory СУБД прошла. Зачем хранить все в оперативной памяти, если диски стали такими быстрыми? Однако это глубокое заблуждение.
Современный SSD обеспечивает время отклика в 10–20 микросекунд. Доступ к оперативной памяти занимает 10–20 наносекунд. Разница все еще составляет три порядка величины, то есть тысячу раз. Но главная проблема кроется в другом. В микросервисной архитектуре между моментом запроса к данным и возвратом ответа пользователю возникают огромные накладные расходы: планировщик операционной системы может добавить 50 микросекунд, сетевая задержка внутри дата-центра — еще 200–300 микросекунд. На этом фоне разница между диском и памятью действительно кажется незначительной.
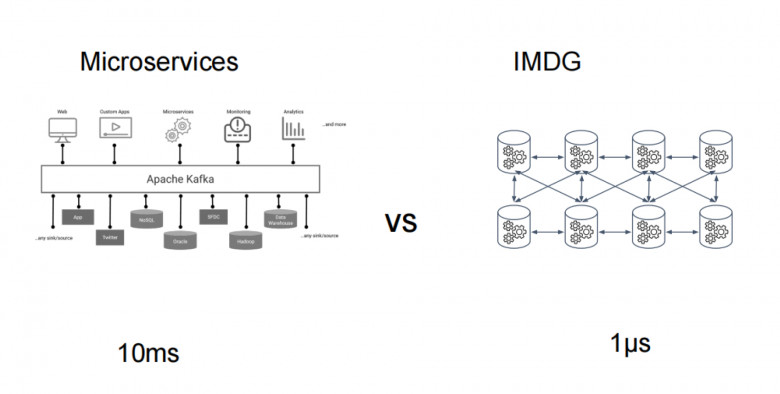
Ошибка архитекторов в данном случае — в принятии этого факта как данности. Вместо того чтобы бороться с накладными расходами, они складывают о них. Правильный вопрос: а что, если отказаться от идеи разделения и разместить критичную к скорости бизнес-логику непосредственно внутри СУБД, в виде плагинов или хранимых процедур? Это возвращает нас к тому самому ускорению на 3–5 порядков, которое дает прямой доступ к данным в памяти, минуя все промежуточные слои.
Примеры сценариев, где такой подход дает решающее преимущество:
- Интеграция данных и витрины: создание высокодоступного и производительного личного кабинета клиента для компаний федерального масштаба, где данные агрегируются из десятков источников.
- Финансовые операции: тарификация в реальном времени, высокочастотная торговля, real-time bidding в рекламе, скоринг кредитных заявок. Здесь "чуть быстрее" означает "существенно выигрываем в деньгах".
- Промышленный Интернет вещей: компрессия и анализ потоковых данных с датчиков непосредственно в момент их поступления.
- Ускорение ERP-систем: расчет себестоимости, зарплаты, формирование оперативной отчетности для крупных холдингов.
Во всех этих случаях резидентная СУБД, способная исполнять бизнес-логику рядом с данными, становится не просто инструментом, а ключевым конкурентным преимуществом.
Проблемы традиционного подхода: хранимые процедуры и микросервисы
Несмотря на потенциальные выгоды, подход с размещением логики в базе данных часто отвергается. И у этого есть причины, часть из которых — объективные сложности.
Во-первых, это сложность управления разработкой. В эпоху DevOps, CI/CD и контейнеризации мы привыкли к определенным практикам: версионирование кода в Git, независимое масштабирование stateless-сервисов, постепенные rollout-обновления. Мир хранимых процедур, написанных на архаичных языках вроде PL/SQL, часто существует вне этих процессов.
Во-вторых, это сложность отладки и тестирования. Как интерактивно отлаживать хранимую процедуру, работающую с реальными производственными данными? Как быть уверенным, что новая логика не создаст "горячих точек" и не приведет к деградации производительности? Практики тщательного тестирования миграций и логики СУБД развиты слабо.
В – третьих, это сложность обновлений. Как согласованно обновить логику на всех узлах распределенного кластера без простоя? Инструменты вроде Flyway или Liquibase помогают с миграцией схем, но не с версионированием и развертыванием распределенной бизнес-логики. Откат в случае неудачи может быть невозможен.
Именно эти вызовы мы и решили устранить в Picodata, создав не просто базу данных, а целостную платформу для разработки и эксплуации высоконагруженных приложений.
Как Picodata решает эти проблемы: отказоустойчивость и управление кластером
Основой для надежной работы является отказоустойчивый и легко управляемый кластер. Picodata построена на архитектуре shard-per-core, где данные разделены на шарды, каждый из которых обслуживается отдельным процессом на своем ядре процессора. Это полностью исключает блокировки и конкуренцию за ресурсы.
Для обеспечения отказоустойчивости каждый шард реплицируется на несколько инстансов, образующих репликасет. Данные внутри шарда дополнительно делятся на бакеты объемом в десятки мегабайт, что позволяет гибко и точно балансировать нагрузку, перемещая не целые шарды, а их небольшие части.
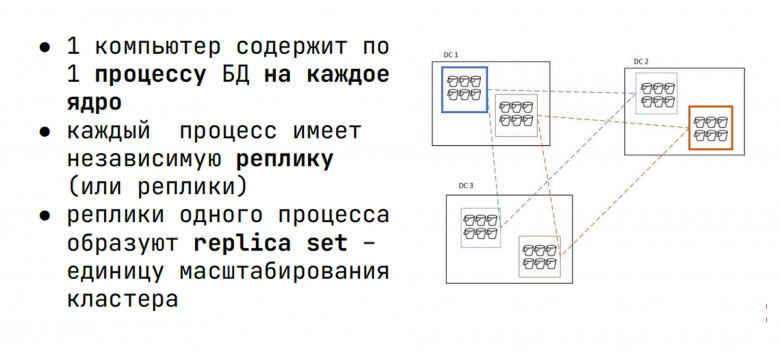
Чтобы управление таким кластером не превращалось в кошмар администратора, мы реализовали два ключевых концепта:
- Встроенный state provider. Вместо использования внешних сервисов вроде etcd, все метаданные о топологии и схеме кластера хранятся в системных таблицах и реплицируются между всеми узлами с помощью консенсус-алгоритма Raft. Это делает кластер самодостаточным, позволяет быстро развертывать и восстанавливать его после сбоев.
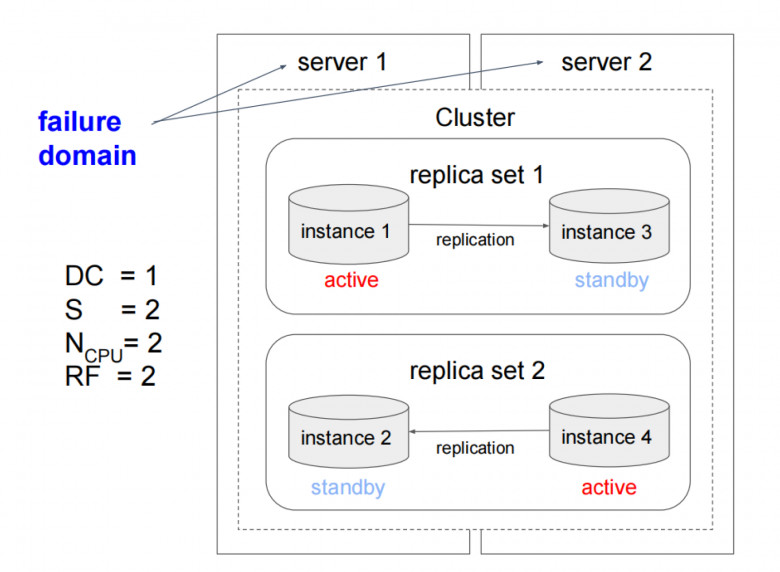
- Домены отказа и тиры. Администратор просто указывает атрибуты размещения каждого инстанса, например, datacenter: msk. Система автоматически понимает топологию и размещает реплики данных так, чтобы обеспечить максимальную отказоустойчивость. Для управления кластером достаточно двух операций: добавить инстанс или удалить инстанс. Все процессы балансировки и восстановления происходят автоматически.
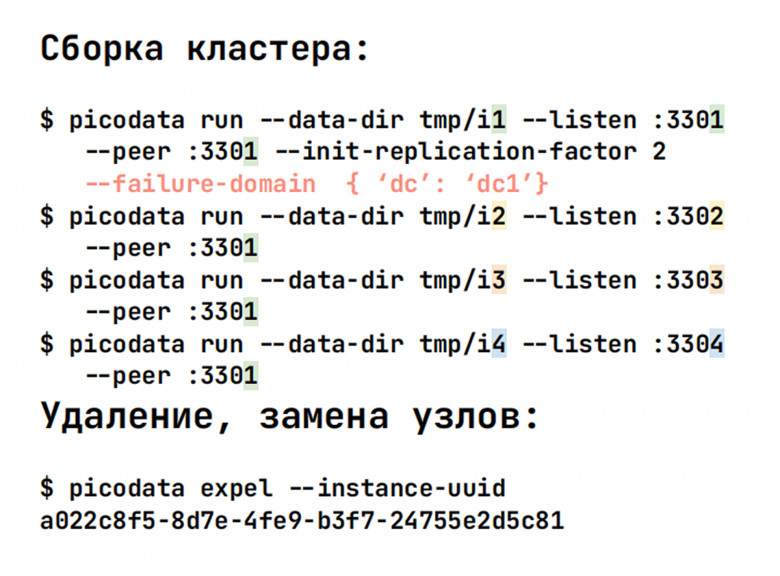
Домен отказа не обязан описывать именно дата-центр, он может задавать и конкретный сервер или стойку внутри дата-центра.
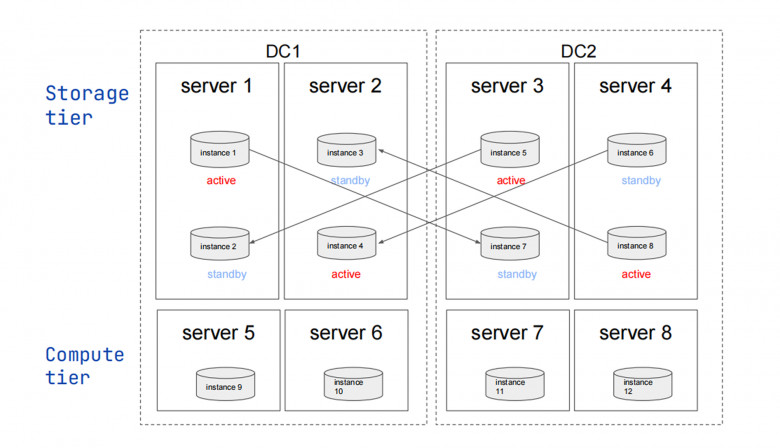
Тиры позволяют создавать сложные, асимметричные топологии. Например, выделить часть узлов под вычисления, а другую — под хранение. Или настроить схему 2+2, где при падении одного дата-центра данные остаются доступны для записи в другом, без необходимости в третьем ДЦ. Это дает беспрецедентную гибкость для построения архитектуры, идеально соответствующей вашим бизнес-требованиям.
Управление кодом: Blue-Green Deploy для логики в СУБД
Самое главное — мы распространили лучшие практики микросервисной архитектуры на код, выполняемый внутри базы данных. Наша реализация Blue-Green Deploy для плагинов Picodata позволяет безопасно обновлять бизнес-логику без простоев и с возможностью мгновенного отката.
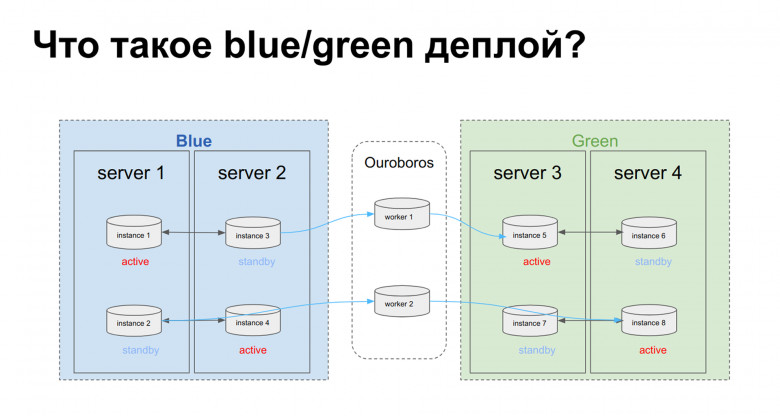
Процесс выглядит следующим образом:
- Установка плагина. Загружается манифест новой версии плагина, написанного на Rust. Манифест описывает его функционал, зависимости и SQL-скрипты для миграции схемы данных.
- Манифест - специальный файл с описанием, что за плагин устанавливается, как он собирается, какой у него функционал и т.д.
name:weather_cachedescription:That one is created as an example of Picodata's plugin version: 0.1.0 services: - name:weather_servicedefault_configuration: openweather_timeout: 5 migration:migrations/0001_weather.db
- Выполнение миграции. Атомарно на всех узлах кластера выполняются up-скрипты, которые подготавливают схему данных для новой версии логики:
<>·-- pico.UP CREATE TABLE "weather"(id UUIDNOT NULL,latitude NUMBERNOT NULL,longitude NUMBERNOT NULL,temperature NUMBERNOT NULL,PRIMARY KEY (id))USING memtxDISTRIBUTEDBY(latitude, longitude);-- pico.DOWN DROP TABLE "weather";
- Настройка конфигурации. Для новой версии плагина задаются параметры, которые реплицируются по всему кластеру.
- Включение новой версии. После успешной миграции и настройки новая версия плагина одновременно активируется на всех узлах. Старая версия продолжает работать параллельно.
- Отключение старой версии. После успешного тестирования работы новой версии под нагрузкой старая версия плагина отключается и удаляется. В случае возникновения проблем выполняется откат: активируется старая версия и выполняются down-скрипты миграции.
Для дополнительного удобства мы разработали инструмент pike, который автоматизирует сборку, упаковку и развертывание плагинов. А плагин ouroboros позволяет настраивать логическую репликацию между кластерами Picodata, создавая полные копии продакшн-среды для тестирования новых версий логики на реальных данных без какого-либо влияния на основную систему.
Pike — это официальная утилита командной строки (CLI), созданная для автоматизации полного жизненного цикла плагинов. Это не просто инструмент сборки, а комплексная платформа для разработки, тестирования, развертывания и управления бизнес-логикой в распределенной in-memory СУБД.
Это мощный инструмент, который превращает сложный процесс разработки и развертывания распределенной бизнес-логики из искусства в инженерную дисциплину. Он обеспечивает стандартизацию процессов разработки, безопасность развертываний через Blue-Green стратегии, наблюдаемость работы плагинов в production, а также автоматизацию рутинных операций.
Для компаний, использующих Picodata в высоконагруженных сценариях, Pike становится критически важным инструментом, позволяющим быстро и безопасно доставлять изменения в работающие системы без простоев и рисков для бизнеса.
Ouroboros — это плагин логической репликации для Picodata, который обеспечивает асинхронную репликацию данных между разными кластерами. Назван в честь мифического змея, кусающего себя за хвост, что символизирует циклическую природу репликации данных.
Ouroboros решает критически важную задачу, а именно создание и поддержание актуальных копий кластеров Picodata для:
- Blue-Green деплоя
- Тестирования на реалистичных данных
- Аварийного восстановления
- Геораспределения данных
Это мощнейший инструмент, который превращает Picodata из просто быстрой in-memory СУБД в enterprise-готовую распределенную платформу. Он обеспечивает непрерывность бизнеса через надежную репликацию, безопасность развертываний через Blue-Green стратегии, геораспределение для глобальных приложений, а также аварийное восстановление с минимальными RPO/RTO.
Для компаний, использующих Picodata в production, Ouroboros становится критически важным компонентом инфраструктуры, позволяющим строить отказоустойчивые, масштабируемые и надежные системы.
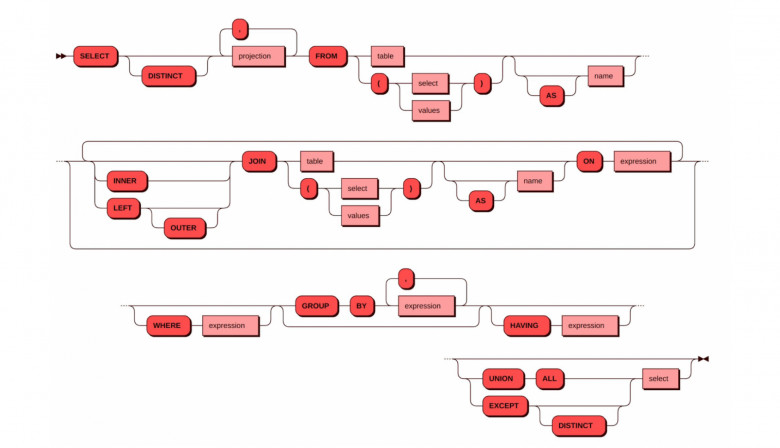
Эффективный SQL для распределенных данных
Мощь плагинов была бы неполной без высокопроизводительного и гибкого SQL-движка. Picodata использует сетевой протокол PostgreSQL, что обеспечивает совместимость с большинством инструментов и драйверов экосистемы Postgres, такими как psql, DBeaver и многими другими.
В отличие от некоторых распределенных СУБД, где SQL является надстройкой над NoSQL-хранилищем, что часто приводит к неэффективным JOINам и перемещениям данных между узлами, Picodata предоставляет разработчику инструменты для управления коллокацией данных.
Коллокация по ключу
При создании таблиц можно указать ключ распределения. Например, для таблиц orders, payments и sessions указать DISTRIBUTED BY (client_id). Это гарантирует, что все данные одного клиента будут физически расположены на одном узле кластера. В результате большинство транзакций, затрагивающих одного клиента, выполняются локально, без сетевых издержек и блокировок.
По умолчанию данные разбиваются между всеми узлами кластера по ключу распределения:
CREATE TABLE ITEM (
    I_ID INTEGER NOT NULL,
    I_IM_ID INTEGER,
    I_NAME VARCHAR(24),
    I_PRICE NUMBER,
    I_DATA VARCHAR(50),
    PRIMARY KEY (I_ID)
)
USING MEMTX DISTRIBUTED BY (I_ID);

bash


pkill --full "i2"

pkill --full "i4"

SELECT I_ID FROM ITEM WHERE I_ID=1;
-- результат:
+------+
| I_ID |
+======+
|  1   |
+------+
(1 rows)

SELECT I_ID FROM ITEM WHERE I_ID=2;
-- результат:
error: requested bucket is unreachable
Глобальные таблицы
Для небольших справочников, которые должны быть доступны на всех узлах, можно создать таблицу с распределением GLOBALLY. Это идеально подходит для измерений в аналитических сценариях, когда факт-таблицы распределены, а справочники реплицированы на все узлы.
CREATE TABLE WAREHOUSE (W_IDINTEGER NOT NULL,W_NAMEVARCHAR(10)NOT NULL,W_TAXDOUBLE,W_YTDDOUBLE,PRIMARY KEY (W_ID))USING MEMTX DISTRIBUTED GLOBALLY;
Такой подход позволяет строить действительно масштабируемые приложения, где производительность растет линейно с добавлением новых узлов в кластер.
Таким обазом, Picodata — это не просто еще одна in-memory СУБД. Это переосмысление роли резидентных баз данных в эпоху, когда мощности одного сервера делают ненужным сложное горизонтальное масштабирование для множества задач. Мы создали инструмент, который сочетает в себе raw-производительность in-memory вычислений с удобством современной платформы для разработки, включая управление кластером, версионирование кода и безопасные деплои.
Мы остаемся верными философии открытого кода, распространяя ядро продукта под лицензией BSD. Для корпоративных заказчиков мы предлагаем коммерческую версию, включающую сертификацию ФСТЭК, расширенные функции для работы с промышленными данными, инструменты миграции с проприетарных СУБД и замены таких систем, как Redis или Cassandra.
Наша дорожная карта развития включает внедрение оконных функций, материализованных представлений, стоимостного оптимизатора запросов и колоночного хранения. Мы уверены, что за in-memory технологиями — будущее высоконагруженных приложений, и наша цель — быть локомотивом этого движения.
Если ваша компания сталкивается с вызовами производительности, если задержки в обработке данных стоят вам реальных денег, если вы ищете надежную и открытую платформу для построения архитектуры следующего поколения — давайте обсудим, как Picodata может стать вашим стратегическим преимуществом.


