

Почему VMware Greenplum - это та самая векторная база данных, которая Вам нужна для анализа информации?
Введение
Greenplum 7, предстоящий релиз хранилища данных Greenplum на базе PostgreSQL v12, ознаменует собой важнейшую веху для сообщества Greenplum. Этот релиз будет поддерживать множество новых расширений для ИИ/МО, таких как pgvector и postgresML.
Эти расширения органично дополняют существующие возможности Greenplum, обеспечивая поддержку неструктурированных данных в хранилище данных с помощью векторных эмбеддингов. Это расширяет возможности федерации данных, обеспечивая беспрепятственный запрос (как чтение, так и запись) к различным базам данных и хранилищам данных, потоковые возможности для получения данных в режиме реального времени из Kafka и RabbitMQ, а также геопространственную аналитику с помощью PostGIS и текстовую аналитику с помощью полнотекстового поиска и GPText (построенного на базе Apache SolR).
Этот обширный набор функций дополнен широким спектром возможностей машинного обучения в базе данных, которые включают поддержку Python, R, расширения MADlib и контейнеры. Все эти возможности и не только позволяют эффективно обучать, настраивать и развертывать модели в среде Greenplum.
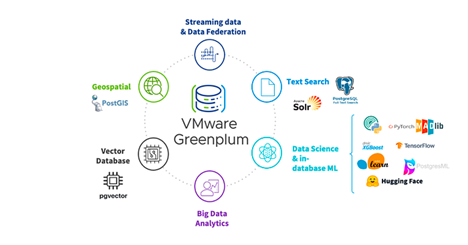
В этой статье мы рассмотрим влияние pgvector на Greenplum и изучим новые горизонты, которые оно открывает.
Кроме того, мы покажем, почему VMware Greenplum является отличным выбором для компаний, которые ищут современное хранилище данных/платформу, оснащенную возможностями векторного поиска, предназначенными для решения аналитических задач.
pgvector — расширение векторного поиска для PostgreSQL
pgvector - это расширение векторной базы данных с открытым исходным кодом для PostgreSQL. Оно позволяет хранить векторные эмбеддинги и выполнять поиск векторного сходства в PostgreSQL, что особенно полезно для приложений, связанных с обработкой естественного языка, например, построенных на основе GPT-моделей OpenAI.

Расширение pgvector привносит новые возможности в PostgreSQL, превращая его в векторную базу данных. Это стало отличным решением для разработчиков, стремящихся создавать новые AI-приложения, оснащенные функцией поиска векторных подобий, сохраняя при этом соответствие ACID объектно-реляционной базы данных, такой как PostgreSQL.
Универсальность и эффективность векторных баз данных делают их ценными для широкого спектра приложений в самых различных отраслях. Среди них можно выделить следующие:
- Обработка естественного языка (NLP): Векторные базы данных облегчают семантический поиск и анализ текста благодаря эффективной работе с эмбеддингами слов или векторами документов. Они позволяют решать такие задачи, как классификация документов, анализ настроений и извлечение ключевых слов, помогая организациям разобраться в огромных объемах текстовых данных из таких источников, как социальные сети, форумы, взаимодействие с клиентами, и, что сейчас наиболее важно, оперативные данные LLM.
- Поиск и распознавание изображений: обратный поиск изображений, обнаружение объектов и распознавание лиц...
- Системы рекомендаций: для современных платформ электронной коммерции и контента, анализ предпочтений пользователей для создания персонализированных и высоко релевантных рекомендаций пользователям в режиме реального времени.
VMware Greenplum + pgvector: векторная база, предназначенная для анализа данных
Благодаря векторным возможностям, представленным в pgvector, Greenplum делает гигантский скачок вперед, позиционируя себя как уникальное хранилище данных и отличную векторную базу данных, оптимизированную для аналитических целей.

Однако Вы можете задаться вопросом: «Действительно ли Greenplum соответствует всем критериям надежной и проверенной векторной базы данных?»
Если обратиться к основам, то векторные базы данных обладают способностью хранить и извлекать векторы как многомерные точки.
Они расширяют свои возможности, обеспечивая эффективный и быстрый поиск ближайших соседей в N-мерном пространстве. Векторные базы данных обычно управляются индексами k-nearest neighbor (k-NN) и подкрепляются такими алгоритмами, как Hierarchical Navigable Small World (HNSW) и Inverted File Index (IVF), а также предлагают дополнительные функциональные возможности, такие как управление данными, отказоустойчивость, контроль доступа и искусный механизм запросов.
Из приведенного выше описания мы можем извлечь требования к по-настоящему продвинутой векторной базе данных, которая в идеале характеризуется следующими параметрами:
- Векторное хранилище.
- Поиск векторного сходства с различными метриками расстояния.
- Индексирование.
- Скорость.
- Надежность (отказоустойчивость и высокая доступность).
- Распределенная архитектура.
- Масштабируемость.
С учетом этого фреймворка давайте посмотрим, как именно Greenplum удовлетворяет каждому из этих требований:
1. Векторное хранилище (хранение векторов и эмбеддингов):
Перед хранением векторов в Greenplum необходимо включить расширение pgvector, выполнив следующий оператор CREATE EXTENSION:
CREATE EXTENSION vector;
Чтобы создать таблицу для хранения векторов, используйте следующую команду SQL, изменяя соответствующие размеры по мере необходимости:
CREATE TABLE vectors_table (
      id BIGSERIAL PRIMARY KEY,
      embedding VECTOR(3)
);
Команда создает таблицу vectors_table с колонкой embedding, способной хранить векторы с 3 измерениями.
Вы можете хранить векторы в своей таблице, выполнив оператор INSERT, подобный следующему (для хранения эмбеддингов):
INSERT INTO vectors_table (embedding) VALUES ('[1,2,3]'), ('[4,5,6]');
Эта команда вставляет в таблицу vectors_table с предоставленными эмбеддингами две новые строки.
2. Поиск векторного сходства с различными метриками расстояния:
Чтобы получить векторы и вычислить сходство, используйте операторы SELECT и встроенные векторные операторы.
Например, Вы можете найти наиболее похожий элемент на заданный эмбеддинг с помощью следующего запроса:
SELECT * FROM vectors_table ORDER BY embedding <-> '[3,1,2]' LIMIT 1;
Этот запрос вычисляет Евклидово расстояние (расстояние L2) между заданным вектором и векторами, хранящимися в таблице vectors_table, сортирует результаты по вычисленному расстоянию и возвращает 5 наиболее похожих векторов.
- pgvector also supports inner product (<#>) and cosine distance (<=>).
3. Индексирование:
Использование индекса на столбце вектора может повысить производительность запроса при незначительных затратах на запоминание.
Вы можете добавить индекс для каждой функции расстояния, которую хотите использовать. Например, следующий запрос добавляет индекс в столбец вложения для функции расстояния L2:
CREATE INDEX ON vectors_table USING ivfflat (embedding vector_l2_ops) WITH (lists = 100);
В настоящее время pgvector поддерживает алгоритм индексирования Inverted File Flat (ivfflat) для приблизительного поиска ближайших соседей.
4. Скорость:
Интеграция pgvector существенно расширяет возможности Greenplum по векторному семантическому поиску.
Строгое тестирование производительности, проведенное в нашем лабораторном кластере Greenplum, включающем три сегментных хоста на вычислительных движках GCP стандарта c2-standard-16c, дало замечательные результаты.
Наш кластер продемонстрировал менее 250 миллисекунд для косинусного поиска в Greenplum по векторной таблице, содержащей 500 миллионов строк, каждая из которых имеет по 512 измерений!

Следите за новостями! В ближайшей статье будут приведены дополнительные сведения о производительности векторного поиска Greenplum.
5. Надежность (отказоустойчивость и высокая доступность):
Хранилище данных Greenplum - это надежная распределенная система, в которой реализованы возможности автоматического обнаружения неисправностей и самовосстановления.
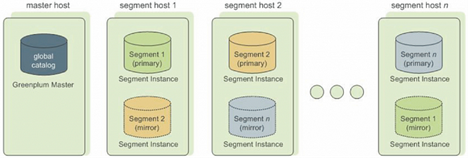
- Отказоустойчивость и балансировка нагрузки: Зеркалирование обеспечивает автоматическое восстановление после сбоев, при котором, если основной сегмент становится недоступным, трафик может быть перенаправлен на зеркальный сегмент. Такая балансировка нагрузки гарантирует, что запросы и рабочие нагрузки продолжат обрабатываться даже во время сбоев.
- Улучшенная целостность данных: Зеркалирование повышает целостность данных, предоставляя вторую копию данных, которую можно использовать для проверки и сравнения. Это помогает выявить и устранить несоответствия или ошибки, которые могут возникнуть в основной копии. Даже если одна копия данных будет скомпрометирована, зеркальная копия останется нетронутой
6. Распределенная архитектура:
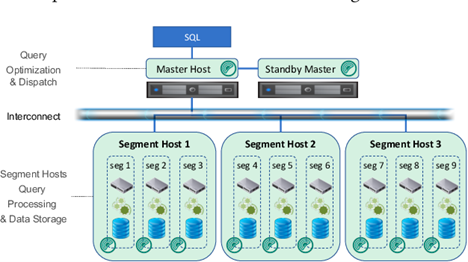
MPP архитектура Greenplum разделяет данные и задачи между несколькими узлами, обеспечивая их параллельную обработку. Такая структура повышает производительность запросов и отказоустойчивость, поскольку задачи могут быть распределены и выполняться одновременно.
7. Масштабируемость:
Эластичная масштабируемость Greenplum позволяет легко расширять систему за счет добавления новых узлов, удовлетворяя растущие потребности в данных и пользователях без ущерба для производительности.
Заключение
В данной статье мы не только подтвердили исключительные технологические возможности VMware Greenplum и расширения pgvector, но и показали, почему это решение является отличным выбором для компаний, желающих расширить свои платформы данных для новых рабочих нагрузок ИИ/МО.
Являясь современным хранилищем данных и векторной базой данных, Greenplum предлагает своим пользователям непревзойденный набор функций, включающий в себя векторное хранилище, молниеносную производительность запросов, отказоустойчивость, высокую доступность, масштабируемость и многое-многое другое.
В условиях постоянно меняющегося ландшафта аналитики данных платформа данных Greenplum не только отвечает, но и превосходит требования современного бизнеса, стремящегося к расширенным аналитическим возможностям. Интеграция с расширением pgvector выводит ее на передовые позиции в отрасли, предоставляя организациям продвинутые инструменты, необходимые для извлечения значимых инсайтов из огромных массивов векторных данных.


