

Поэтапная стратегия внедрения: от нуля к устойчивому процессу
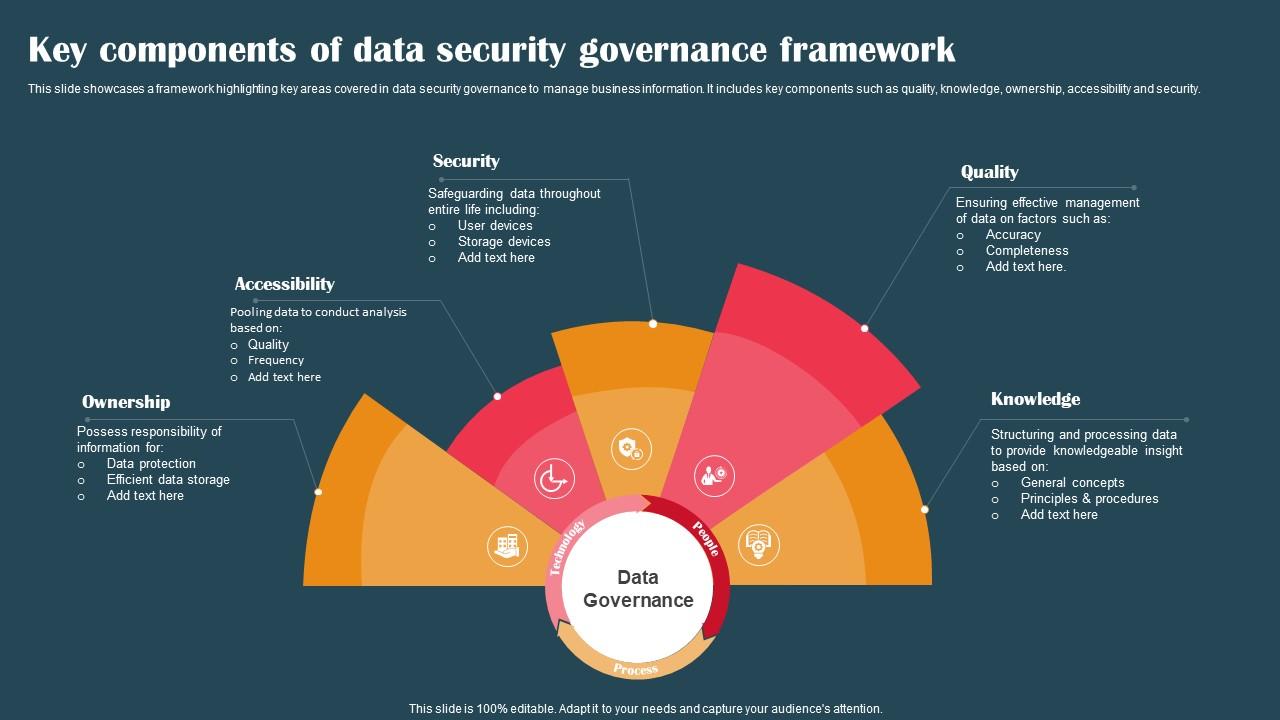
Data Governance (управление данными) — это система правил, ролей и процессов, обеспечивающая управление данными как ценностью. Это не только про хранение данных, но и про качество, доступность, соответствие регуляторным требованиям и устойчивость к изменениям в бизнесе. В этой главе мы разложим по полочкам поэтапную стратегию внедрения Data Governance с нуля до устойчивого, зрелого процесса. Мы затронем теорию, методологии, практические примеры (open-source и российские решения), приведем конкретные технические детали и инструменты, обсудим риски и ограничения, а затем дадим блок FAQ, который станет хорошим справочным материалом для новичка.
Ключевые понятия, которые пригодятся в дальнейших разделах:
- Metadata и Meta Data Catalog (каталог данных) — место хранения описаний данных, их атрибутов, источников и зависимостей.
- Data Stewardship (ответственные за данные) — роли, которые обеспечивают соблюдение правил качества и политики управления.
- Data Quality (качество данных) — набор метрик и процедур для оценки точности, полноты, своевременности и непротиворечивости.
- Data Lineage (происхождение данных) — отслеживание путей данных через системы и трансформации.
- Policies и Compliance — политические и регуляторные требования, которые нужно соблюдать.
- KPI и измерение зрелости — показатели, которые оценивают эффективность управления данными на разных этапах.
Что такое Data Governance и зачем он нужен
Data Governance — это управляемая деятельность по принятию решений об использовании данных и их управлении. Основные цели:
- Повышение доверия к данным внутри организации.
- Обеспечение соответствия требованиям (например, регуляторы, безопасность, приватность).
- Повышение эффективности аналитики за счет унификации определений, стандартов и процессов.
- Предотвращение данных-«силосов» и ускорение внедрения Data as a Product.
Ключевые термины:
- Управление данными (Data Governance) — политики, процедуры и роли, которые обеспечивают качество, доступность и использование данных.
- Каталог данных (Data Catalog) — систематизированная база описаний данных для поиска, понимания и управления.
- Категоризация и качество данных (Data Quality) — набор правил и метрик для проверки корректности и полноты данных.
- Роли и ответственности (RACI, Data Steward) — кто отвечает, кто выполняет, кто консультирует, кто информирован.
- Метаданные (Metadata) — данные о данных: источник, формат, владельцы, частота обновления, lineage.
- Модель зрелости (Maturity Model) — ступени развития управления данными: начальный уровень, управляемый, определённый, количественно управляемый, оптимизируемый.

Модель зрелости управления данными
Одна из наиболее понятных моделей — пятиуровневая:
- Initial (Инициализация): минимальные процессы; данные в разных системах, без единой политики.
- Managed (Управляемый): создан реестр владения, начало документирования источников и правил качества.
- Defined (Определённый): политики документированы, роли закреплены, начаты программы по каталогизации.
- Quantitatively Managed (Количественно управляемый): измерения зрелости, SLA по качеству, отчётность по метрикам.
- Optimizing (Оптимизируемый): непрерывное улучшение, автоматизация контроля, данные становятся продуктом.
Путь от 1 к 5 требует последовательности шагов, но принципы остаются едиными: ясноdefined роли, согласованные политики, единая лексика данных и устойчивые механизмы контроля.
Архитектура и принципы проектирования
Основные принципы:
- Прозрачность и доступность: все участники должны видеть, какие данные доступны и какие требования к ним применяются.
- Единая семантика: единые определения атрибутов, бизнес-терминов и справочников.
- Контроль доступа и приватность: политика доступа к данным, соответствие нормативам (персональные данные, банк, гос сектор).
- Потребительский подход: данные рассматриваются как продукт для бизнес-пользователей и аналитиков.
- Инкрементальность внедрения: начать с малого пилотного домена и постепенно расширять охват.
Типичная архитектура может выглядеть так:
- Источники данных (OLTP, файлы, облачные хранилища)
- Каталог данных (Data Catalog)
- Платформа качества данных (DQ)
- Линия данных (Data Lineage)
- Метаданные и политики (Policy Management)
- Роли stewards и согласование
- Потребительские сервисы: BI, Data Science, Reports
Практические примеры
Путь внедрения: phased approach
Фаза 0: Основа для старта
- Назначение команды, сбор требований, выбор инструментов.
- Сформулированный набор ключевых доменов данных (например: клиенты, продажи, продукты).
Фаза 1: Каталогизация и начальный контроль качества
- Ввод первого каталога, определение бизнес-терминов, интеграция с источниками, базовые правила качества.
Фаза 2: Политики, роли и процессы
- Назначение Data Stewards, фиксация политик, установка проверок.
Фаза 3: Масштабирование и автоматизация
- Расширение доменов, автоматическое обновление линейности и видимости, внедрение мониторинга.
Фаза 4: Управление зрелостью и непрерывное улучшение
- Метрические панели зрелости, регулярные ревизии, улучшение процессов.
Пример: внедрение Data Governance в финансовой организации
Контекст: банк внедряет управление данными для регулирования подготавливаемых отчетов и аналитики.
Действия:
- Определение доменов: клиенты, транзакции, риски, продукты.
- Создание Data Steward команды: бизнес-аналитики, риск-менеджеры, ИТ.
- Развертывание каталога на основе open-source решений (см. ниже).
- Введение политики качества: валидность полей, полнота записей, согласованность между системами.
- Мониторинг показателей качества и SLA на обновления данных.
Результаты:
- Уменьшение времени подготовки регуляторной отчетности на 40%.
- Повышение доверия к данным аналитиков и бизнес-пользователей.
- Снижение количества проблем с данными в BI-отчетах.
Практические примеры инструментов (open-source)
- Apache Atlas: каталог метаданных и управление политиками. Хорошо подходит для Hadoop-экосистемы и совместим с открытыми стандартами.
- Amundsen: открытый каталог данных с фокусом на поиск и метаданные; легко расширяется.
- DataHub: платформа каталога данных с расширяемыми сущностями, lineage и управлением политиками.
- Great Expectations: инструмент контроля качества данных с декларативными ожиданиями и тестами.
- OpenLineage: стандарт для отслеживания lineage, интегрируется с Orchestration и инструментами обработки данных.
- OpenTelemetry и другие инструменты мониторинга: для наблюдаемости процессов обработки данных.
Эти решения можно объединять в стек: каталог данных (Amundsen/DataHub), качество (Great Expectations), lineage (OpenLineage), политика и управление доступом (Atlas). Ниже приведена таблица с типовыми вариантами.
Таблица: сравнительная таблица инструментов
| Инструмент | Тип | Основные возможности | Примеры сценариев использования | Преимущества | Ограничения |
|---|---|---|---|---|---|
| Apache Atlas | Каталог + политика | Метаданные, классификация, lineage, политики | Глобальный каталог для корпоративного Hadoop-ETL | Глубокая интеграция в экосистему Hadoop | Может требовать затратной настройки; не всегда «из коробки» для облачных данных |
| Amundsen | Каталог | Поиск, метаданные, интеграции | Поиск данных аналитики и бизнес-терминов | Быстрый старт, активное сообщество | Лимитированный функционал политики на старте |
| DataHub | Каталог | Метаданные, lineage, политика, расширяемость | Управление данными в больших облачных/облачных стеках | Гибкость, поддержка масштабирования | Требует правильной настройки интеграций |
| Great Expectations | Качество | Определение ожиданий, тесты качества | Контроль качества входных данных в пайплайнах | Ясные тесты, прозрачные отчеты | В большом объёме можно усложнить конфигурацию |
| OpenLineage | Lineage | Стандарт для lineage, интеграции | Передача информации о lineage между системами | Стандартность и совместимость | Требует внедрения в пайплайнах |
| Российские решения (нарицательно) | Каталог/качество | Локализация, интеграции с локальными системами, приватность | Вендор-оснащение в рамках локального рынка | Соответствие локальным регуляциям, поддержка на русском языке | Могут быть ограничены экосистемой и сообществом |
Примеры практических шагов внедрения с использованием Open-Source стеков
Шаг 1: Установка и конфигурация каталога
- Развертываем Amundsen/DataHub на виртуальных машинах или в Kubernetes.
- Подключаем источники данных (например, базы данных PostgreSQL, хранилища S3/облако, файлы CSV).
- Определяем бизнес-термины и роли в каталоге.
Шаг 2: Интеграция метаданных и lineage
- Настраиваем OpenLineage для пайплайнов Airflow или Prefect.
- Включаем автоматическую генерацию lineage на уровне источников и трансформаций.
Шаг 3: Контроль качества
- Создаем набор ожиданий в Great Expectations для критичных источников (например, клиентские данные, транзакции).
- Связываем результаты тестов с каталогом и дашбордами.
Шаг 4: Политики и роли
- Определяем роли Data Steward, Data Owner, Data Consumer.
- Вводим политики доступа и сроков обновления данных.
Шаг 5: Мониторинг и улучшение
- Устанавливаем панель мониторов по качеству, линейности, загрузке данных.
- Планируем регулярные ревизии и обновления политик.
Архитектура внедрения
- Источники данных: OLTP БД, файловые хранилища, SaaS-источники.
- Каталог данных: Amundsen/DataHub/Atlas, в зависимости от контекста.
- Стратегия качества данных: Great Expectations, собственные проверки.
- Линейность данных: OpenLineage, виде линейности от источника до потребителя.
- Политики и безопасность: роли, доступ, соответствие требованиям.
- Производители и потребители: BI, Data Science, аналитика.
Пример конфигурации: YAML для политики качества
# политики качества данных (пример)
quality_policies:
  - name: "Проверка полноты полей клиента"
    dataset: "db.crm_clients"
    conditions:
      - field: "client_id"
        required: true
        min_length: 1
      - field: "email"
        required: true
        pattern: "^[\\w.+-]+@[\\w.-]+\\.[a-zA-Z]{2,}$"
    actions:
      - type: "notify"
        to: ["data-team@example.com"]
      - type: "flag"
        target: "data_quality_dashboard"
  - name: "Уникальность транзакций"
    dataset: "db.transactions"
    conditions:
      - field: "transaction_id"
        unique: true
    actions:
      - type: "audit"
        destination: "data_audit_log"
Пример конфигурации: базовый пайплайн в Airflow с OpenLineage
# airflow DAG с включенным OpenLineage
from airflow import DAG
from airflow.operators.bash import BashOperator
from datetime import datetime

with DAG('sample_etl_with lineage', start_date=datetime(2024,1,1), schedule_interval='@daily') as dag:
    extract = BashOperator(task_id='extract', bash_command='python extract.py')
    transform = BashOperator(task_id='transform', bash_command='python transform.py')
    load = BashOperator(task_id='load', bash_command='python load.py')

    extract >> transform >> load
OpenLineage интегрируется через SDK в ваши задачи, чтобы автоматически регистрировать lineage.
Пример: аудит данных и метаданных (Python)
# простой пример аудита данных через Great Expectations
import great_expectations as ge
from datetime import datetime

context = ge.get_context()
suite = context.create_expectation_suite(
    expectation_suite_name="crm_clients_suite"
)

# пример: ожидание непустого email
suite.add_expectation(
    expectation_type="expect_email_to_be_valid",
    kwargs={"column": "email"},
)

# сохранить и запустить
context.add_or_update_expectation_suite(suite)
results = context.run_checkpoint(checkpoint_name="crm_clients_checkpoint")
Российские решения и локализация
Важно: в российском рынке зачастую встречаются локализованные решения и сервисы у отечественных поставщиков, которые учитывают локальные регуляторные требования и интеграции с отечественной инфраструктурой. В практических кейсах это может означать:
- локальные каталоги данных, поддерживающие русский язык и бизнес-термины;
- интеграции с локальными системами учёта, бухгалтерии и ERP;
- соответствие требованиям ФЗ-152 и другим регуляторным актам в части обработки персональных данных.
Стратегия внедрения в российских условиях обычно включает:
- участие локальных стейкхолдеров и юридического отдела;
- настройку процессов соответствия и аудита;
- использование локальных решений совместно с открытым ПО в гибридном стеке.
Риски и ограничения
- Перегрузка управлением данными: попытка централизовать все данные может привести к бюрократии и снижению скорости принятия решений. Важно найти баланс между контролем и автономией команд.
- Сопротивление бизнес-пользователей: без вовлечения бизнес-ролей, данные могут рассматриваться как «второй этаж» ИТ.
- Стоимость владения и сложность поддержки: внедрение Data Governance требует ресурсов на поддержание каталогов, политик и мониторинга.
- Приватность и регуляции: нарушение приватности личной информации может привести к штрафам; конкретные политики должны соответствовать требованиям GDPR, локальным законам и регламентам.
- Мобильные/облачные среды и совместимость: миграция в облако может менять контроль доступа и политики; необходимо продумать кросс-облачность.
- Слабая линейность данных (data lineage): отсутствие полной линии данных снижает доверие к данным.
- Проблемы качества данных: хорошие политики требуют сбалансированного бюджета и времени на качественную подготовку данных.
- Выбор инструментов: выбор конкретных инструментов критично влияет на гибкость и скорость внедрения.
- Риски связанные с vendor lock-in и зависимостью от поставщиков: особенно если вы начинаете с монокультурной платформы.
Стратегии снижения рисков:
- Начинайте с пилотного домена и малого объема данных, постепенно расширяя охват.
- Вводите минимально достаточные политики и роли, затем постепенно усложняйте.
- Устанавливайте реестр рисков и регулярно проводите review.
- Внедряйте автоматизированный мониторинг и оповещения на ключевые показатели.
- Поддерживайте обучение и участие бизнес-пользователей.
Выводы
- Поэтапная стратегия внедрения Data Governance строится на четко определенных ролях, политиках, и прогрессивном расширении охвата данных.
- Начало с пилотного домена и базовых метрик позволяет скорректировать подход без крупных затрат.
- Каталог данных, управление качеством и lineage должны работать в связке; они поддерживают прозрачность, доверие и соответствие регуляторным требованиям.
- Open-source решения позволяют быстро собрать стек и адаптировать под конкретную инфраструктуру; отечественные решения часто хорошо подходят для локальных требований и интеграции с локальными системами.
- Ключ к успеху — участие бизнеса, ясная коммуникация, реальная ценность от получаемых данных и устойчивый цикл улучшений.
FAQ (Вопрос–Ответ)
1) Что такое Data Governance и чем он отличается от Data Management?
- Data Governance — это набор политик, ролей и процессов, которые управляют принятием решений об использовании данных, обеспечивают соответствие и качество. Data Management — более широкое понятие, включающее саму работу с данными, их хранение, обработку и поддержку жизненного цикла. Governance — надстройка, обеспечивающая контроль и согласованность.
2) Какие ключевые роли необходимы для начала проекта Data Governance?
- Data Owner (владельцы данных) — отвечают за бизнес-донирование, определение ценности; Data Steward — операционные лица, следят за качеством и политиками; Data Architect/IT — поддерживают архитектуру и инструменты; Data Consumer — пользователи данных, которые получают выгоду от данных.
3) Какие метрики и KPI важны на старте?
- Доля полей с валидными значениями, полнота данных, точность, согласованность между системами, время реакции на инциденты качества, процент данных в каталоге, доля активированных lineage, скорость обнаружения и исправления ошибок.
4) Какие инструменты выбрать для старта?
- Для каталога: Amundsen, DataHub, Apache Atlas. Для качества данных: Great Expectations. Для lineage: OpenLineage. Можно сочетать открытое ПО с локальными решениями; выбор зависит от инфраструктуры и регуляторных требований.
5) Какую архитектуру рекомендуется выбрать?
- Гибридная архитектура: каталог данных + система качества + lineage + политики и роли + интеграции с потребителями (BI, Data Science). Важно обеспечить совместимость между слоями и возможность расширения.
6) Какие риски наиболее критичны и как ими управлять?
- Риск бюрократизации, риск низкого вовлечения бизнеса, риск превышения бюджета. Управлять можно через пилотные проекты, раннюю вовлеченность бизнес-пользователей, чётко прописанные ROI и SLA для процессов.
7) Как соблюдать приватность и регуляторные требования?
- Внедрять политики доступа и защиты персональных данных, регулярные аудиты, шифрование и контроль версий политик. Обеспечивать соответствие требованиям локального законодательства и международным нормам, если требуется.
8) Как измерить зрелость Data Governance?
- Используйте maturity-модель (1–5 уровней). Оценивайте по релевантности политики, наличию ролей, полноте каталога, качеству данных, линейности и мониторингу. Регулярно публикуйте дашборды по прогрессу.
9) Какие примеры реальных результатов можно ожидать?
- Сокращение времени на подготовку регуляторной отчетности, снижение числа ошибок данных в BI, улучшение доверия бизнес-пользователей к данным, снижение дублирования и повышенная повторяемость процессов.
10) Как начать прямо сегодня?
- Сформируйте маленькую команду (Data Owner, Data Steward, IT-архитектор). Определите 2–3 домена данных для пилота. Выберите инструменты Open-Source под ваши условия, настройте каталоги, запустите первые проверки качества и простые политики. Постепенно расширяйте.


