

Построение хранилища данных для традиционной отрасли
Лучший компонент для Вас - это тот, который подходит Вам больше всего. В нашем случае у нас не слишком много данных, которые необходимо обрабатывать, но нам все же хотелось бы иметь простую в использовании и обслуживании платформу данных.
Это часть цифровой трансформации гиганта рынка недвижимости. В целях конфиденциальности мы не будем раскрывать все бизнес-данные, но предоставим Вам подробное представление о хранилище данных и стратегиях по его оптимизации.
Итак, приступим к делу.
Архитектура
Наша архитектура данных может быть разделена на 4 части:

- Интеграция данных: обеспечивается за счет Flink CDC, DataX и функцией Multi-Catalog в Apache Doris;
- Управление данными: мы используем Apache Dolphinscheduler для управления жизненным циклом скриптов и привилегиями при управлении мультиарендой, а также для мониторинга качества данных;
- Оповещения: мы используем Grafana, Prometheus и Loki для мониторинга ресурсов и журналов компонентов;
- Сервисы данных: в данном случае BI-инструменты обеспечивают взаимодействие с пользователями, например, обработка запросов и анализ данных.
1. Таблицы
Мы создаем таблицы измерений и таблицы фактов, центрируя каждый операционный объект, включая клиентов, дома и т.д. Если существует ряд действий, связанных с одним и тем же операционным объектом, то они должны быть записаны одним полем. (Это урок, который мы извлекли из нашей предыдущей хаотичной системы управления данными).
2. Слои
Наше хранилище данных разделено на пять концептуальных слоев. Для планирования сценариев DAG между этими слоями мы используем Apache Doris и Apache DolphinScheduler.
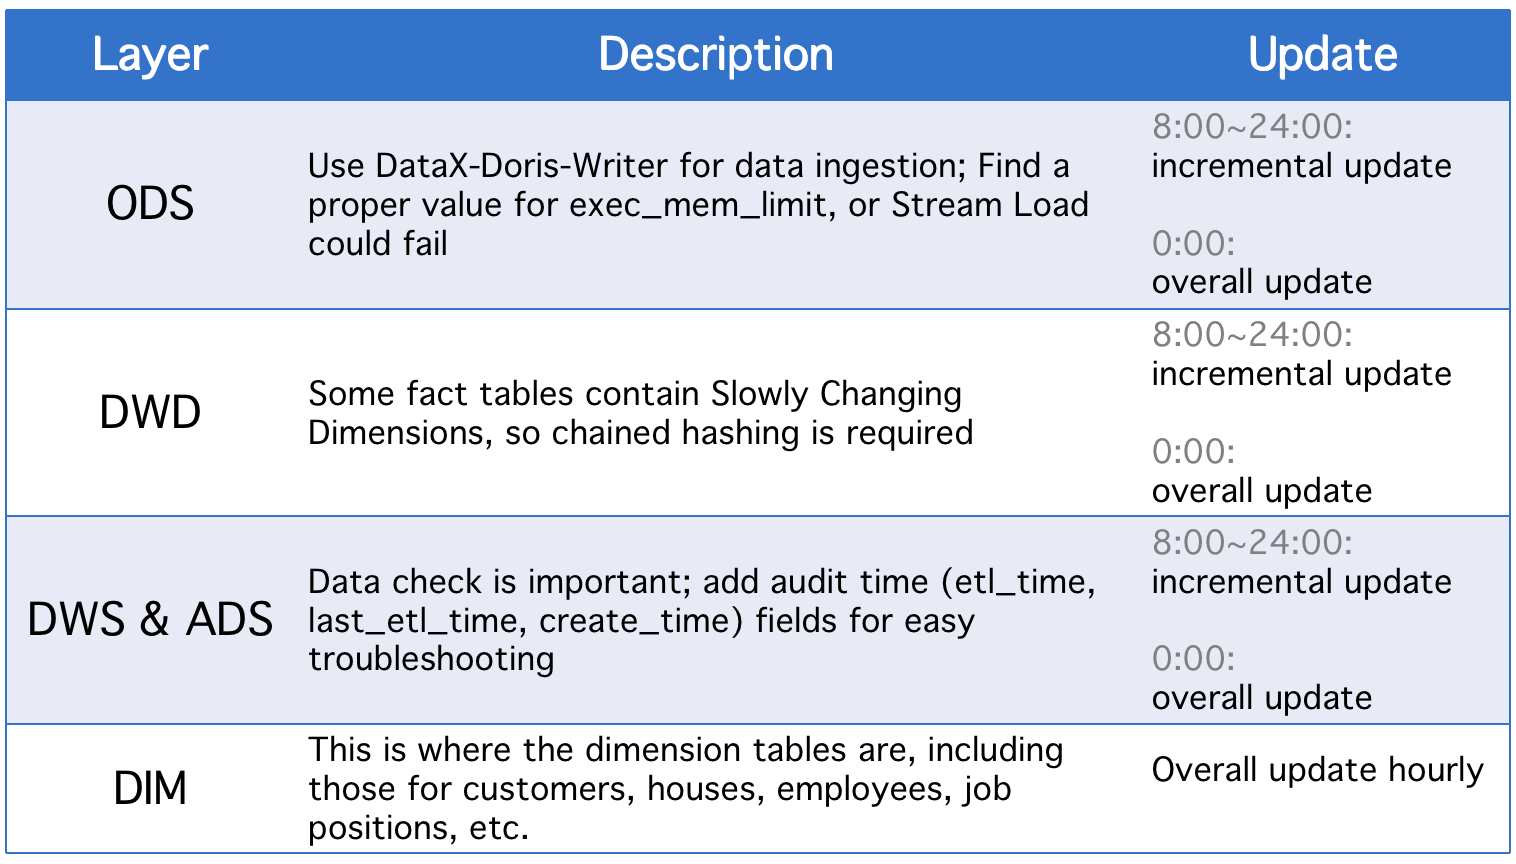
Ежедневно слои проходят общее обновление, а также инкрементные обновления в случае изменения полей исторического состояния или неполной синхронизации данных в таблицах ODS.
Стратегии инкрементного обновления
(1) используйте where >= "activity time -1 day or -1 hour" вместо where >= "activity time
Это необходимо для того, чтобы предотвратить дрейф данных, вызванный разрывом во времени выполнения скриптов планирования. Допустим, при интервале выполнения 10 мин скрипт выполняется в 23:58:00, а новая «порция» данных поступает в 23:59:00. Если мы установим where >= "время активности, то этот фрагмент данных за день будет пропущен.
(2) Перед выполнением скрипта получите идентификатор первичного ключа таблицы, сохраните его во вспомогательной таблице и используйте where >= "ID in auxiliary table"
Это необходимо для того, чтобы избежать дублирования данных. Дублирование данных может произойти, если использовать модель Unique Key в Apache Doris и назначить набор первичных ключей, поскольку при изменении первичных ключей в исходной таблице эти изменения будут записаны, и соответствующие данные будут загружены. Данный метод позволяет исправить ситуацию, но он применим только в том случае, если исходные таблицы имеют автоинкрементные первичные ключи.
(3) Разбейте таблицы на разделы
Что касается автоинкрементных данных, основанных на времени, таких как таблицы журналов, то в них может быть меньше изменений в исторических данных и состоянии, но объем данных достаточно велик, поэтому может возникнуть большая нагрузка на общее обновление и создание snapshots. Поэтому лучше разбить такие таблицы на разделы, чтобы при каждом инкрементном обновлении нам нужно было заменять только один раздел. (При этом, возможно, придется следить за дрейфом данных).
3. Общие стратегии обновления
(1) Очистите таблицу
Очистите таблицу, а затем занесите в нее все данные из исходной таблицы. Это применимо для небольших таблиц и скриптов с отсутствием активности пользователей в утренние часы.
(2) изменить таблицу tbl1 и заменить на tbl2
Это атомарная операция, которая целесообразна для больших таблиц. Каждый раз перед выполнением скрипта мы создаем временную таблицу с той же схемой, загружаем в нее все данные и заменяем ею исходную таблицу.
Приложение
- ETL: каждую минуту
- Конфигурация для первого развертывания: 8 узлов, 2 фронтенда, 8 бэкендов, гибридное развертывание
- Конфигурация узла: 32C * 60GB * 2TB SSD
Вы можете использовать данную конфигурацию в качестве эталона и масштабировать свой кластер на ее основе. Развертывание Apache Doris очень простое. Другие компоненты не требуются.
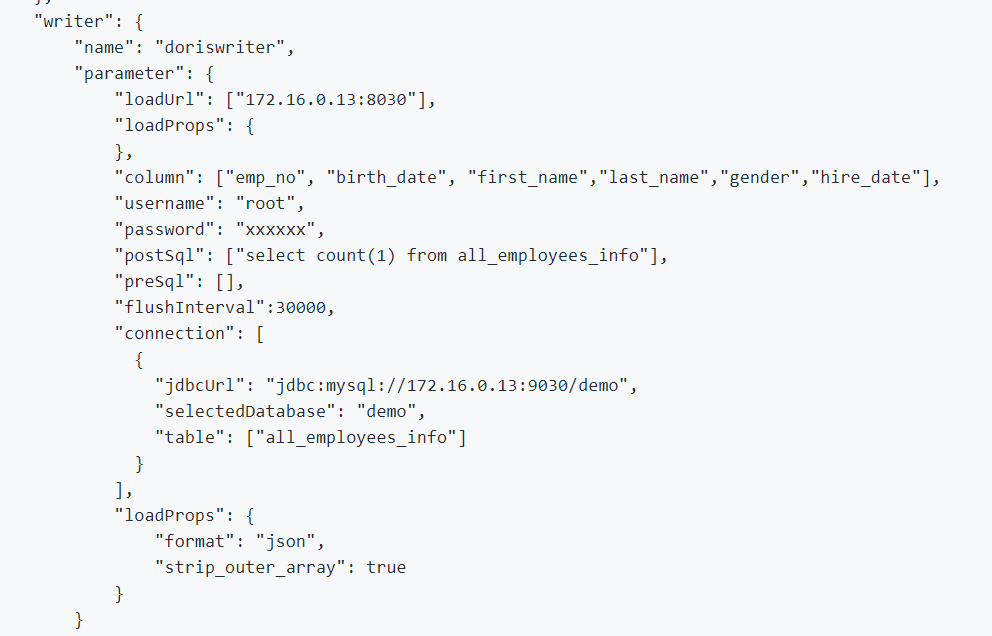
1. Для интеграции offline данных и данных журнала мы используем DataX, который поддерживает формат CSV и читает многие реляционные базы данных, а Apache Doris предоставляет программу DataX-Doris-Writer;
2. Для синхронизации данных из исходных таблиц мы используем Flink CDC . Затем мы агрегируем метрики в режиме реального времени с помощью Materialized View или Aggregate Model из Apache Doris. Поскольку в режиме реального времени нам нужно обрабатывать только часть метрик, и мы не хотим генерировать слишком много соединений с базой данных, мы используем только одно задание Flink для обслуживания нескольких исходных таблиц CDC. Для этого используются функции Dinky по объединению нескольких источников и полной синхронизации с базой данных, либо можно самостоятельно реализовать задание Flink DataStream по объединению нескольких источников. Следует также отметить, что Flink CDC и Apache Doris поддерживают изменение схемы;
SQL
EXECUTE CDCSOURCE demo_doris WITH ('connector' = 'mysql-cdc','hostname' = '127.0.0.1','port' = '3306','username' = 'root','password' = '123456','checkpoint' = '10000','scan.startup.mode' = 'initial','parallelism' = '1','table-name' = 'ods.ods_*,ods.ods_*','sink.connector' = 'doris','sink.fenodes' = '127.0.0.1:8030','sink.username' = 'root','sink.password' = '123456','sink.doris.batch.size' = '1000','sink.sink.max-retries' = '1','sink.sink.batch.interval' = '60000','sink.sink.db' = 'test','sink.sink.properties.format' ='json','sink.sink.properties.read_json_by_line' ='true','sink.table.identifier' = '${schemaName}.${tableName}','sink.sink.label-prefix' = '${schemaName}_${tableName}_1');
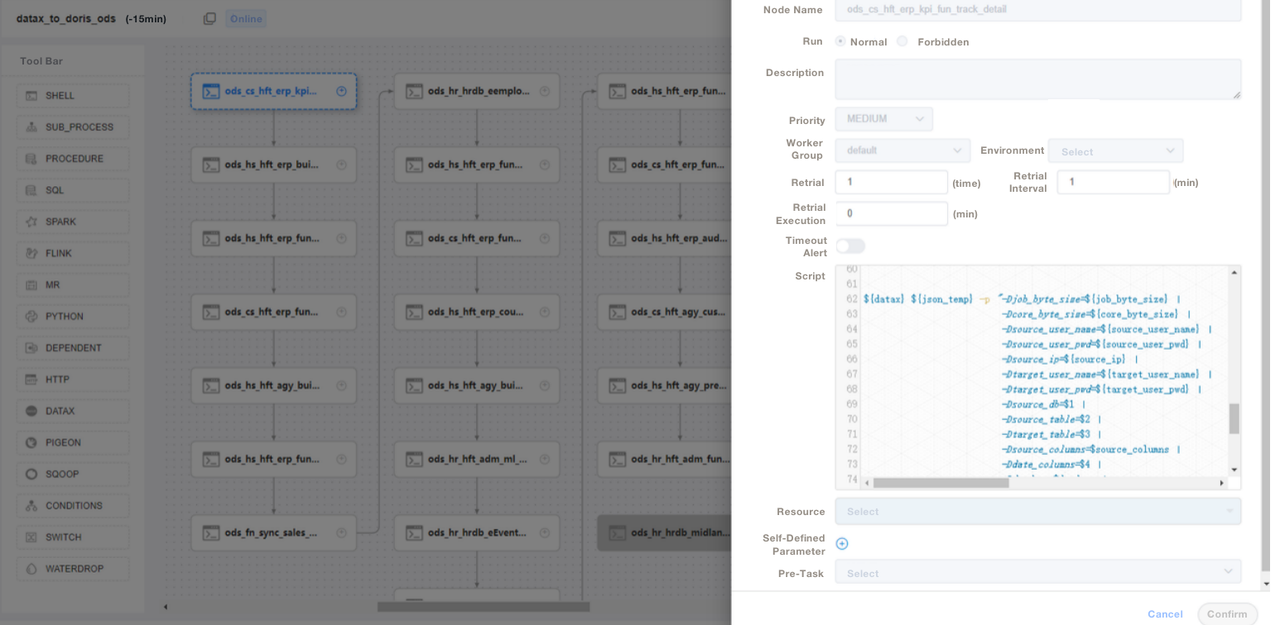
3. Мы используем скрипты SQL или "Shell + SQL" и осуществляем управление жизненным циклом. На уровне ODS мы пишем общий файл задания DataX и передаем параметры для каждой исходной таблицы, вместо того чтобы писать задание DataX для каждой исходной таблицы. Таким образом, мы значительно упрощаем выполнение задачи. Управление ETL-скриптами Apache Doris осуществляем в DolphinScheduler, где также ведется контроль версий. В случае возникновения ошибок в производственной среде мы всегда можем сделать откат
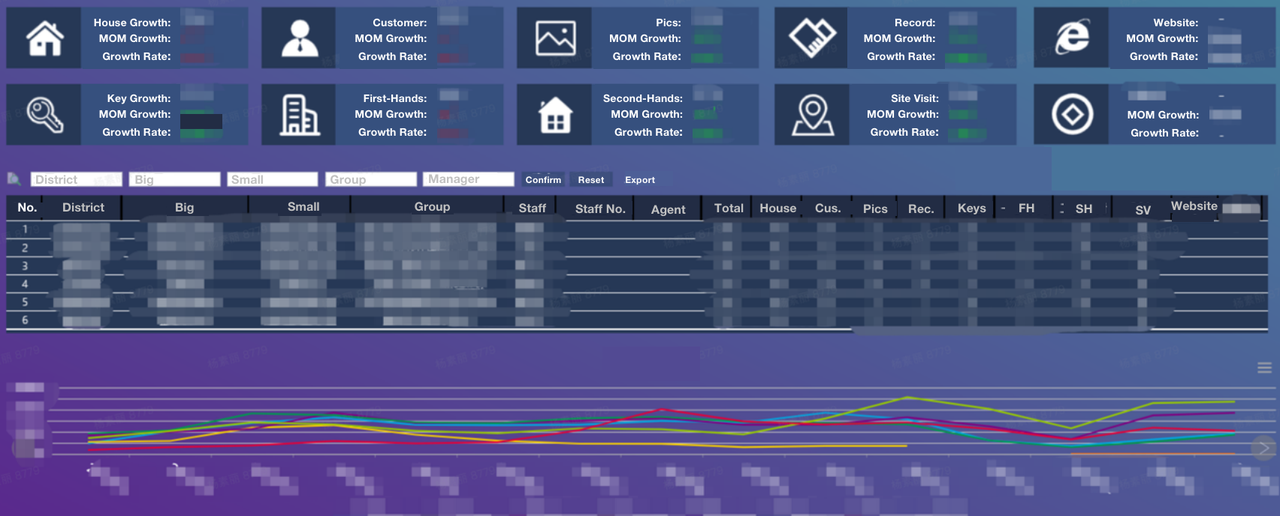
4. После ввода данных с помощью ETL-скриптов мы создаем страницу в нашей программе по созданию отчетов. С помощью SQL мы назначаем привилегии различным учетным записям, в том числе привилегии на изменение строк, полей и глобальных словарей. Apache Doris поддерживает привилегированный контроль учетных записей, который работает так же, как и в MySQL.
Мы также используем резервное копирование данных Apache Doris для аварийного восстановления, журналы аудита Apache Doris для мониторинга эффективности выполнения SQL, Grafana+Loki - для оповещения о метриках кластера и Supervisor - для мониторинга процессов узловых компонентов.
Оптимизация
Data Ingestion
Мы используем DataX для потоковой загрузки (Stream Load) автономных данных. Это позволяет нам регулировать размер каждой партии. Метод Stream Load возвращает результаты синхронно, что полностью соответствует требованиям нашей архитектуры. Если мы выполним асинхронный импорт данных с помощью DolphinScheduler, то система может посчитать, что скрипт уже выполнен, и это приведет к путанице. Если Вы используете какой-либо другой метод, мы рекомендуем выполнить show load в shell-скрипте и проверить состояние регекс-фильтрации, чтобы убедиться в успешности импорта.
Модель данных
Для большинства наших таблиц мы используем модель уникальных ключей Apache Doris. Данная модель обеспечивает идемпотентность скриптов данных и позволяет эффективно избегать дублирования данных.
Чтение внешних данных
Для подключения к внешним источникам данных мы используем функцию Multi-Catalog в Apache Doris. Она позволяет создавать отображения внешних данных на уровне каталогов.
Оптимизация запросов
Мы рекомендуем помещать наиболее часто используемые поля несимвольных типов (например, int и where clauses) в первые 36 байт, чтобы в точечных запросах можно было фильтровать их за миллисекунды.
Словарь данных
Для нас создание словаря данных важно потому, что это в значительной степени снижает затраты на коммуникацию с персоналом, которая может стать головной болью в большом коллективе. Для создания словаря данных мы используем программу information_schema в Apache Doris. С ее помощью мы можем быстро получить полную картину таблиц и полей и тем самым повысить эффективность работы.
Характеристики
Длительность офлайн data ingestion: в течение нескольких минут;
Обработка запросов: для таблиц, содержащих более 100 млн. строк, Apache Doris отвечает в течение одной секунды, а на более сложные запросы - в течение пяти секунд;
Ресурсоемкость: для создания подобного хранилища данных требуется небольшое количество серверов. Степень сжатия данных Apache Doris, составляющая 70%, позволяет сэкономить большое количество ресурсов.
Опыт и заключение
На самом деле, до того как мы перешли к нынешней архитектуре данных, мы пробовали работать с Hive, Spark и Hadoop для того, чтобы создать автономное хранилище данных. Оказалось, что Hadoop - это излишество для такой компании, как наша, поскольку у нас не слишком много данных для обработки. Важно найти тот именно тот инструмент, который подходит именно Вам.
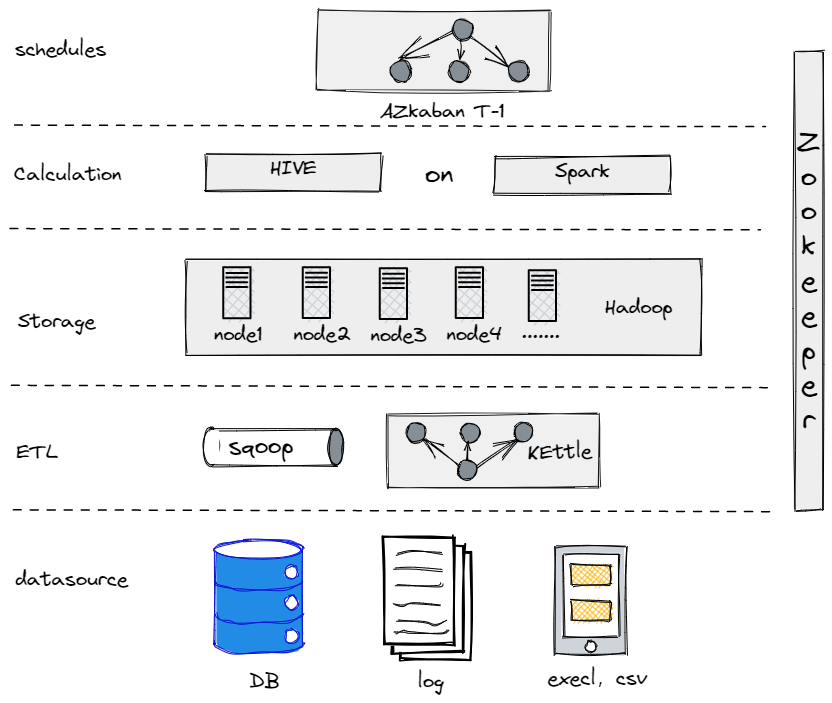
Наше предыдущее офлайн хранилище данных
С другой стороны, для плавного перехода к большим данным необходимо сделать платформу данных как можно более простой в использовании и обслуживании. Именно поэтому мы остановились на Apache Doris. Она совместима с протоколом MySQL и предоставляет богатый набор функций, что избавляет нас от необходимости разрабатывать собственные UDF. Кроме того, она состоит только из двух типов процессов: фронтендов и бэкендов, поэтому ее легко масштабировать и контролировать.


