

Правильная архитектура данных
Узнайте о различных подходах к формированию архитектуры данных. Почему это должно волновать Вас?
Как структурировать данные? Это зависит от архитектуры данных, которую Вы выберите, вариантов масса - от монолитной базы данных до современного подхода pub-sub. В этой статье Вы узнаете, как по-разному может быть спроектирована экосистема данных и как эффективнее формировать команды архитекторов данных.
Традиционный подход
Сегодня приложения, как правило, отделены от систем данных. Для использования всего потенциала активов данных DWH доступны для записи и чтения всем желающим, как показано на рис. 1.
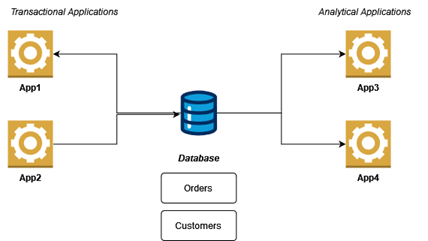
Проектирование баз данных было и до сих пор остается чрезвычайно важным. Поскольку приложения обновляют данные (например, таблицы), и многие системы их читают, очень важно правильно спроектировать эти самые таблицы. Архитекторы должны обладать глубокими знаниями о принципах работы приложений.

Разделение аналитических Datastore
С появлением аналитических приложений потребность в чтении данных выросла в разы, что вызвало конфликт с записью данных. Считывающие устройства часто вызывали проблемы с производительностью у записывающих устройств, конкурируя за одни и те же ресурсы. Читателям требовались дополнительные структуры, такие как индексы, которые мешали писателям. Читателям также требовались структуры данных в специальных форматах, например, в «столбцовом» формате, которые значительно уступали по эффективности обновлению одной записи, характерному для транзакционных систем.
Это привело к разработке нового типа хранилища данных, названного аналитическим. Аналитические хранилища получали необходимые им данные из различных транзакционных хранилищ с помощью процесса, обычно обозначаемого как Extract/Transform/Load (ETL). Аналитическим хранилищам приходилось хранить данные в разных форматах, «сплющивать» несколько таблиц для того, чтобы создать более «плоские» таблицы, разрабатывать разные модели (часто называемые размерными, чтобы противопоставить их обычным реляционным моделям) и так далее. Именно этим и занимался этап T из ETL.
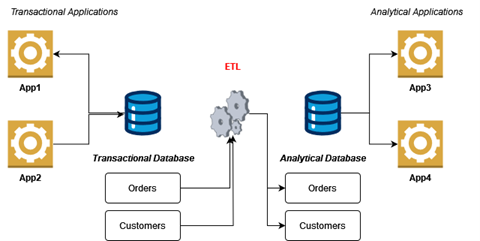
До тех пор пока задержка данных не была проблемой. Отставание на несколько часов для многих приложений не имело никакого значения. Если требовались данные в режиме реального времени, например, чтобы узнать текущий статус заказа, транзакционную систему можно было запросить для отдельных записей, а для больших отчетов, таких как продажи на конец дня или за месяц, можно было использовать аналитическое хранилище, которое было разработано с учетом массового доступа только на чтение. Все было хорошо.
Позже такое положение дел привело к появлению нового типа архитекторов данных, которые стали разбираться во всех тонкостях проектирования аналитических систем данных, в частности, в моделировании размерностей.
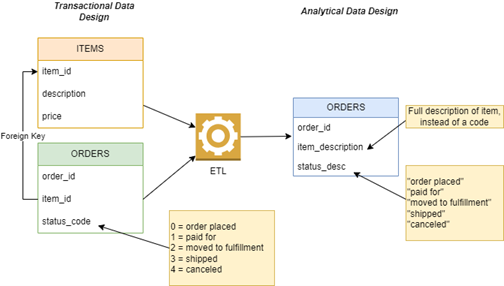
Большинство данных в аналитических хранилищах создаются с четко определенными метками во время проектирования процесса ETL. Рассмотрим пример на рис. 3 [обратите внимание на то, что это очень упрощенный вид преобразования, позволяющий проиллюстрировать его суть]. В столбце status_code указаны 0, 1, 2 и т. д. Что они означают? Аналитические хранилища получили их и преобразовали в описательные значения, такие как «Положен в корзину», «Заказан», «Платеж обработан» и т. д. Таким образом, мы имели дело с транзакционными системами, а не аналитическими. Все были счастливы.
Сервис-ориентированная архитектура
Посмотрите на рис. 2. Многие приложения пишут в центральное хранилище данных. Например, есть таблица ORDERS, которая содержит заказы от клиентов. Все приложения пишут в нее и читают из нее. Как и многое другое, эта таблица нуждается в обслуживании: нужно добавить новые столбцы, перенести данные на более быструю платформу данных и так далее. Каких приложений это касается?
Это настоящий кошмар. Чем крупнее компания, тем сложнее ее технологические системы. Определить, какие приложения будут затронуты, не говоря уже о том, каким образом, - задача из области фантастики. Для ее решения были созданы сложные процессы анализа изменений, но потребность в человеческих знаниях и опыте никуда не исчезла.
В начале XXI века появилась новая парадигма, призванная решить эту и многие другие проблемы. Предложение состояло в том, чтобы создать одно приложение, скрывающее за собой реальные хранилища данных. Таким образом, таблица ORDERS не будет видна никому, кроме специального приложения, называемого «сервисом», скажем, order_service. Этот сервис будет принимать запросы от всех остальных на запись данных и выдачу данных о заказах. Изначально сервис использовал специализированный протокол под названием Simple Object Access Protocol (SOAP). Позже область применения этого сервиса была ограничена, и появился новый термин - микросервис. Протоколом доступа стал http, а взаимодействие с ним было строго стандартизировано как Representational State Transfer (REST), как показано на рис. 4.
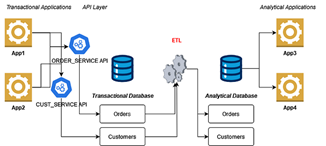
Такое решение принесло ощутимую пользу для архитектуры данных. Поскольку базовые активы данных не были доступны никому, кроме микросервиса, знания архитекторов данных не должны были выходить за его пределы. Микросервис определял интерфейсы, такие как accept_order, вместе с большим количеством параметров. Запись в единственную таблицу ORDERS или в несколько таблиц; хранится ли в столбцах статус в виде 0, 1, 2 и т. д. или в более описательном виде, за пределами микросервиса не имело никакого значения. Аналогичным образом, технологию хранения данных можно было корректировать в соответствии с меняющимися бизнес-потребностями.
Затем команды по архитектуре данных были разделены и приведены в соответствие с отдельными сервисными командами, что еще больше снизило зависимость от унаследованных знаний.
Группы сервисов
Очень скоро возникла новая проблема. Микросервисы стали слишком гранулированными. Рассмотрим это на рисунке 5. Есть микросервисы для accept_order, process_order, send_to_fulfillment и так далее. Они должны работать с одной и той же таблицей. Согласно принципу микросервисов, таблицы не могут быть общими для всех них сразу; поэтому у каждого из них есть таблица ORDERS, которая вначале практически одна и та же, но по мере обработки ее содержимое будет меняться.
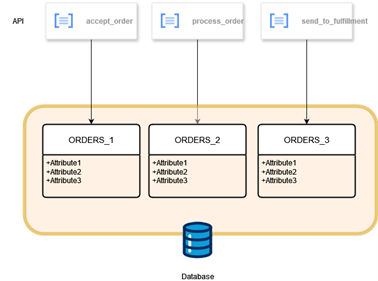
Создание избыточного количества копий данных - это табу в архитектуре данных. Такое положение дел приводит к измененному дизайну микросервисов, с «общей» таблицей, используемой многими микросервисами в их «семействе», иногда называемом «доменами». В данном случае мы определили домен под названием Orders, в котором все эти отдельные сервисы работают с одной и той же таблицей ORDERS. Эта таблица не видна никому за пределами семейства. Аналогичным образом существует еще одно семейство микросервисов для клиентов, которые взаимодействуют только с одной таблицей CUSTOMERS. Это семейство не может видеть таблицу ORDERS.
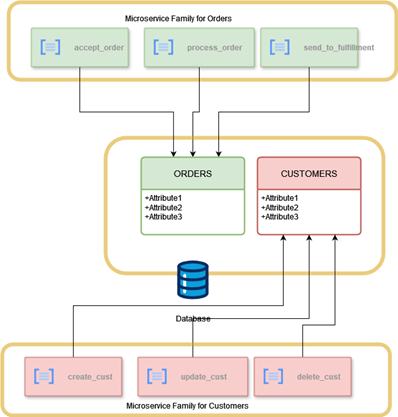
Такая система создала новый риск: изменения базового хранилища данных будет влиять на микросервисы. Однако, вскоре нашлось решение данной проблемы - принадлежность микросервисов одному семейству нивелировала эту зависимость.
Развитие ETL
Заметьте, что в вышеописанной истории аналитические хранилища остались практически в стороне. Дизайн микросервисов, распространенный в транзакционных системах, не прижился в аналитическом мире. Почему?
Причины:
- Микросервисы, реализуемые через вызовы API, обычно обрабатывают записи в сериализованном виде. Многим приложениям для работы с аналитическими данными необходим доступ сразу ко всем данным, причем немедленно. Например, приложение Spark сначала собирает все данные в RDD в собственной памяти кластера и только потом начинает работать с ними. Если оно будет получать все записи за раз, это будет очень медленно. Поэтому ему нужен прямой доступ к хранилищу данных.
- Некоторые аналитические инструменты должны получать данные строго в определенном формате. Например, Amazon Sagemaker может получить доступ к данным только в бакетах S3 или через Lake Formation, а не через вызовы API.
Поэтому прямой доступ к хранилищам аналитических данных по-прежнему остается главным требованием. Как же это меняет ситуацию с командами, занимающимися архитектурой данных?
Они должны быть экспертами в своей области. Но обеспечить постоянное наличие экспертных знаний сложно. Люди переезжают, полученные знания нельзя упаковать и оставить на месте. Поэтому над вопросом передачи знаний и опыта необходимо работать.
Продукты данных
С ростом числа аналитических сценариев использования выросла и потребность в аналитических хранилищах. Поэтому нам пришлось меньше полагаться на архитекторов, которые должны были указывать пользователям, что им использовать, и перейти к модели самообслуживания, при которой пользователи могли бы определять это самостоятельно. Это привело к разработке продуктов данных, которые содержат полезную информацию и доступны в каталоге, открываемом различными инструментами. Исчерпывающие метаданные позволяют потребителям самостоятельно находить искомую информацию.
Например, продуктом данных может быть ORDERS, которая извлекается процессом ETL представляется в виде одной или нескольких таблиц в аналитическом хранилище. Если потребителям нужен другой элемент данных, они должны отправить запрос «владельцу» этого продукта данных, участия архитекторов данных в этом случае не требуется. Архитекторы данных необходимы для принятия решений по другим аспектам систем данных - выбор технологии, формата, устойчивости и так далее.
Продукты данных обычно создаются специалистами, которых часто называют стюардами данных. В некоторых организациях я видел, как обе эти роли - управляющего и архитектора - выполняют одни и те же люди; но при этом я уверен, что их индивидуальные задачи отличаются, они могут и должны быть разными.
Потоковая передача данных
До сих пор мы говорили о точечных решениях, использующих ETL для перемещения, преобразования и загрузки данных в целевое хранилище. Даже в организации среднего размера будет практически невозможно масштабировать это решение с множеством источников и пунктов назначения. С появлением Data Mesh это становится еще сложнее. Для одних и тех же данных существует несколько мест назначения. Возможно, существует и вероятность изменения технологии. Как решить эту проблему?
Здесь на помощь приходит другой тип архитектуры. Как показано на рис. 7, системы-издатели публикуют свои данные в заранее определенном формате схемы в потоковую систему. Все потребители забирают полезную нагрузку из потока. Издатели не знают, кто является потребителями; все, что они делают, - это публикуют его в известной структуре. Главное слово - «известной»; структура или схема хорошо известна и определена в некотором каталоге, где потребители без проблем могут ее найти.
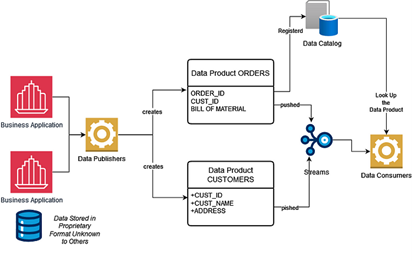
Такая схема освобождает системы от необходимости строить мосты (ETL) от источника к месту назначения. Если требуется новая аналитическая платформа, достаточно поднять ее и выбрать полезную нагрузку из потока. Нет необходимости строить целую систему ETL.
В этом случае требования к архитектуре данных в значительной степени зависят от точного и эффективного определения схемы, которую издатели должны будут публиковать. Архитекторы должны хорошо разбираться в бизнес-схеме публикации, а также в нюансах, которые могут возникнуть при использовании терминов, и так далее. С другой стороны, системы-потребители, потребляющие данные из потока, получат от издателей точные и понятные данные, но им может потребоваться выполнить преобразования, чтобы сделать их полезными для своих систем. Давайте рассмотрим это на конкретном примере.
Имеется два потока данных, поступающих следующим образом:
- ORDERS: поток всех заказов, поступающих из систем заказов. Он содержит идентификатор заказа, а также подробную информацию о заказе.
- FULLFILMENTS: поток всех активных заказов, поступивших на склад, но еще не выполненных. Он содержит идентификатор заказа и сведения о его выполнении, такие как склад и работник, которому он был передан.
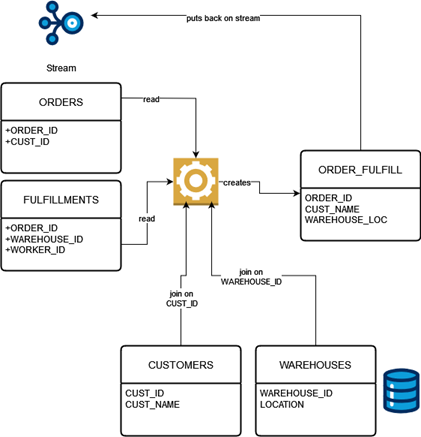
Это совершенно разные потоки данных, поскольку они поступают из разных систем и содержат разные типы данных. Однако отделу обслуживания клиентов нужен дашборд, содержащий детали заказа, детали склада и т. д. Поэтому приложение на другом конце потока объединяет два эти потока, соединяя их по ORDER_ID, получает информацию о клиентах и товарах из соответствующих баз данных и создает третий обогащенный поток. Этот третий поток может быть передан другим приложениям для сохранения в каком-либо хранилище данных.
Обратите внимание, мы проводили преобразования, но не создавали конвейеры ETL. Мы были полностью свободны в определении систем и преобразований по своему усмотрению. В этом и заключается сила раздельной архитектуры. Архитекторы данных на стороне потребления должны знать, какие структуры данных они получают, нужно ли к ним присоединяться (и если да, то как и с помощью чего), как выбрать правильную технологию для их сохранения и так далее.
Заключение
Основываясь на своем личном опыте, могу сказать, что разделенная потоковая архитектура данных является единственным практичным и масштабируемым способом для организации среднего размера, а команды по архитектуре данных должны быть укомплектованы распределенным образом. Но если Вы планируете монолитную архитектуру на основе ETL, то имеет смысл создать централизованную команду по архитектуре данных.


