

Прием данных в Clickhouse
Введение в Clickhouse
ClickHouse - это высокопроизводительная колоночно-ориентированная база данных, предназначенная для быстрого поиска данных и эффективного хранения огромных массивов информации. Инновационная колоночная архитектура хранения данных в сочетании с передовыми методологиями сжатия и индексами делает ее высокоэффективной в плане управления данными и обработки запросов к петабайтам данных в распределенных кластерах. Высокоспециализированная аналитическая система полностью отвечает всем требованиям современных прогрессивных организаций, полагающимся в своей деятельности на проверенные данные.
Подключение к ClickHouse
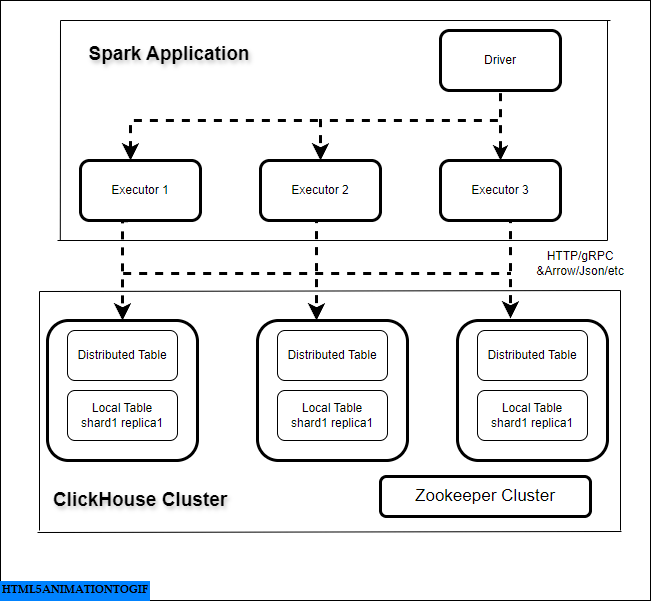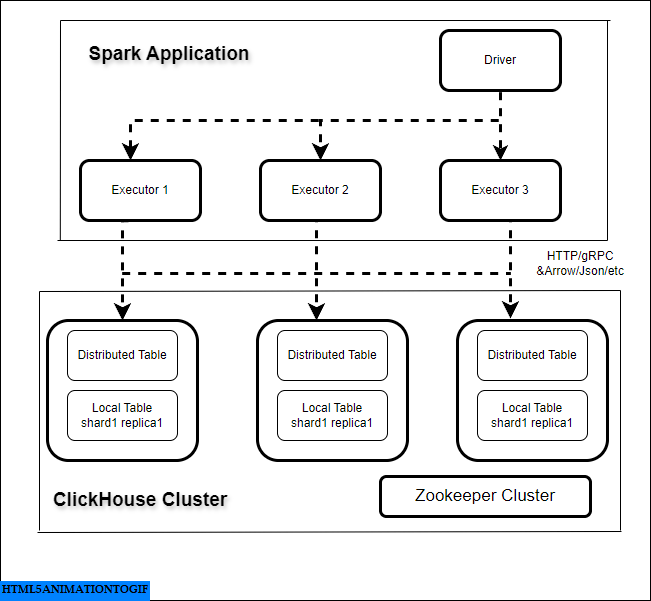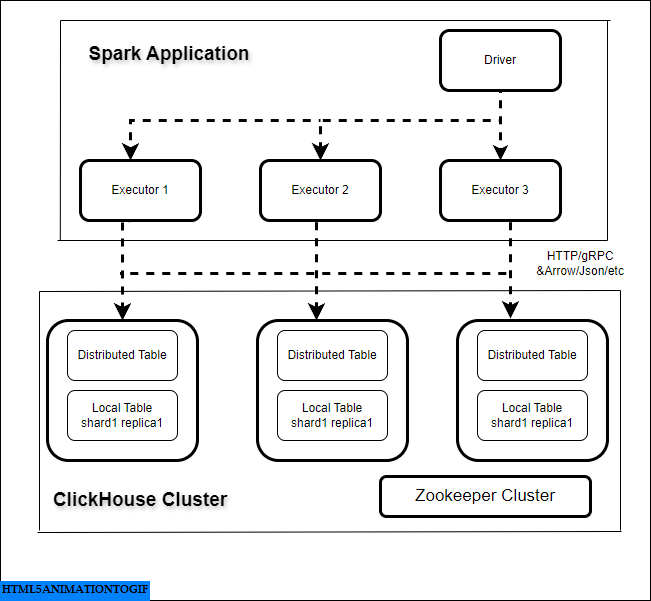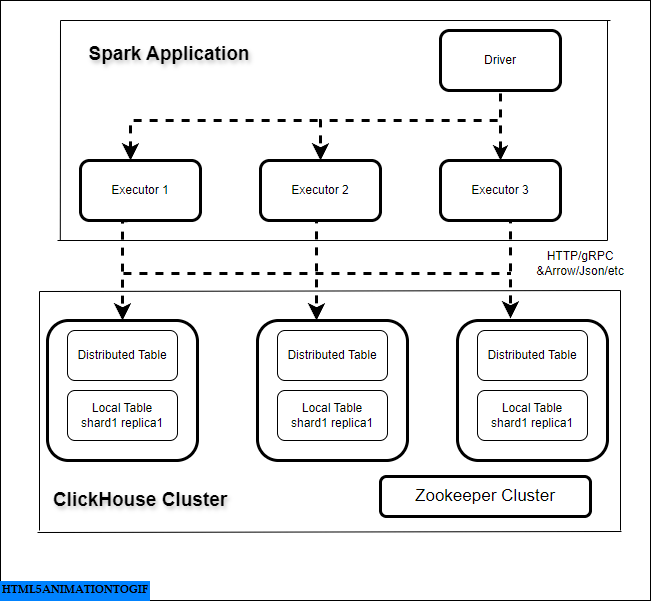
Архитектура ClickHouse Spark:
- Убедитесь в том, что Ваша политика сети соответствует следующим:
- Узлы драйвера и исполнителя Spark имеют доступ к HTTP-порту ClickHouse;
- Если Spark обращается к кластеру ClickHouse, убедитесь в том, что между узлами драйвера и исполнителя Spark и каждым узлом кластера ClickHouse установлена стабильная связь
- Рассмотрите возможность подключения с помощью Python-коннектора ClickHouse clickhouse-connect==0.7.4.
- Установите JAR com.clickhouse:clickhouse-jdbc:0.6.0 на Ваш кластер для того, чтобы создать стабильное JDBC-соединение Spark.

Python коннектор Clickhouse
## We need to provide below details
jdbc_driver = "com.clickhouse.jdbc.ClickHouseDriver"
host = "Host URL"
port = "Port"
user = "Username"
password= "Password"
database = "Database"
options = "ssl=false"
Создание ClickHouse-client
import clickhouse_connect
client = clickhouse_connect.get_client(host=host, port=port, username=user, password=password)
Запуск SQL - запросов
client.command(sql)
ClickHouse JDBC коннектор для Spark
Считывание данных из таблицы Delta в df_res в виде Dataframe
df_res = spark.sql(sql)
Написание DataFrame для таблиц Clickhouse
jdbc_url = f"jdbc:clickhouse://{host}:{port}/{database}?{options}&user={user}&password={password}"
df_res.write \
.format("jdbc") \
.mode("append") \
.option("driver", jdbc_driver) \
.option("url" ,jdbc_url) \
.option("dbtable" , "clickhousepoc01.user_attributes_02") \
.option("batchsize", 100000) \
.option("numPartitions", 16) \
.save()
Ключевые моменты по оптимизации: для обеспечения эффективной пакетной обработки с оптимальным уровнем параллелизм .настройте размер партии и количество партиций
Создание таблицы ClickHouse
1. Движок → зависит от каждого конкретного случая. Наиболее распространенным вариантом является MergeTree, предназначенный для вставки большого количества данных. Другой популярный механизм - ReplacingMergeTree - позволяет избежать дублирования записей.
2. Укажите TTL (time to live)
{toDateTime(`timestamp`) + toIntervalDay(1) TO VOLUME ‘cold’, toDateTime(`timestamp`) + toIntervalDay(10) DELETE} → это позволит управлять таблицей вручную, что позволит Вам правильно распределить табличное пространство.
3. ORDER BY
4. storage_policy = ‘tiered’, ttl_only_drop_parts = 1
5. Найдите столбцы с низкой кардинальностью или создайте их с помощью параметра
LowCardinalityEx: state LowCardinality(String)
6. По возможности сожмите столбцы
Например, platform_id String CODEC(ZSTD(3))


