

Проектирование измерений: суррогатные и естественные ключи
Измерения в хранилищах данных проектируются так, чтобы поддерживать историю изменений и давать повторяемые, легко воспроизводимые результаты. В контексте Slowly Changing Dimensions (SCD) важным элементом являются ключи: естественные (business keys) и суррогатные (surrogate keys). Вы, начинающий аналитик или инженер по данным, должны понять, почему в моделировании измерений целесообразно использовать суррогатные ключи, как они относятся к естественным ключам и как проектировать измерения с учетом требований к скорости, масштабируемости и точности. Эта глава посвящена дизайну измерений: когда и зачем применяют суррогатные ключи, какие типы изменений размерностей поддерживают (SCD Type 1, 2, 3 и др.), как сочетать суррогатные и естественные ключи в звездной схеме, а также – какие практические решения существуют в открытом коде и в российском IT-ландшафте. Мы разберем теорию, приведем примеры реализации на реальных СУБД и инструментальных стеках, обсудим риски внедрения и ограничения, а в конце — ответы на практические вопросы.
Ключи и их роль в моделировании измерений
- Естественный ключ (natural key, бизнес-ключ) — это ключ, который присутствует во внешнем источнике данных и имеет смысл бизнес-пользователю. Например, номер заказа, идентификатор клиента в системе продаж, артикул продукта от производителя. Естественные ключи часто уникальны в пределах источника, однако они мало пригодны для глобального объединения данных из разных источников: они могут обновляться, дублироваться, меняться без аудита, что усложняет консолидацию.
- Суррогатный ключ (surrogate key) — это искусственный ключ, созданный в хранилище данных. Обычно это непрерывно возрастающее целочисленное значение (sequence, auto-increment) или UUID. Суррогатный ключ не содержит бизнес-логики и служит стабильной идентификацией строк размерности и связей с фактами. В большинстве современных архитектур суррогатный ключ назначают именно на уровне_dimension_, а факт содержит внешний ключ к суррогатному ключу размерности.
Зачем нужны суррогатные ключи в измерениях
- Независимость от источников. Даже если в разных системах есть разные бизнес-ключи для одного и того же субъекта, суррогатный ключ позволяет унифицировать единицы измерения внутри хранилища.
- Историчность и версии. Суррогатные ключи облегчают хранение истории изменений в размерностях (SCD), а также позволяют хранить несколько версий объекта под одним бизнес-ключом.
- Скорость и целостность связей. Фактная таблица обычно ссылается на суррогатные ключи размерностей. Это обеспечивает компактность ключей, ускоряет соединения и упрощает обновления истории.
- Управление изменениями. С суррогатным ключом можно clearly отделять изменения (например, атрибуты адреса, статуса) в отдельные версии, сохраняя линейное восприятие изменений и аудит.
Грань измерения ( grain )
Понимание грани измерения критично: она определяет уровень детализации, на котором мы регистрируем данные. Например, грань измерения в dimension_time может быть по дню, а грань факт-таблицы — по продажам за конкретную дату и конкретного клиента. Неправильно выбранная грань приводит к аномалиям при агрегации и усложняет реализацию SCD. При проектировании суррогатных ключей важно определить:
- какие бизнес-ключи являются естественными кандидатами для бизнес-ключей размерности;
- какие изменения в атрибутах относятся к одной и той же сущности и должны сохраняться как новые версии (SCD);
- как обновлять факт-таблицу при изменении версий размерностей.
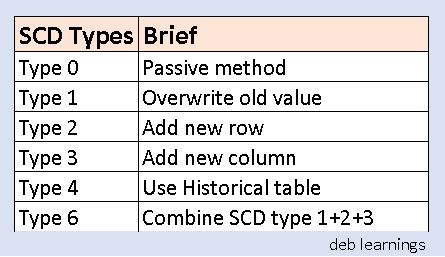
Типы изменений размерностей в SCD
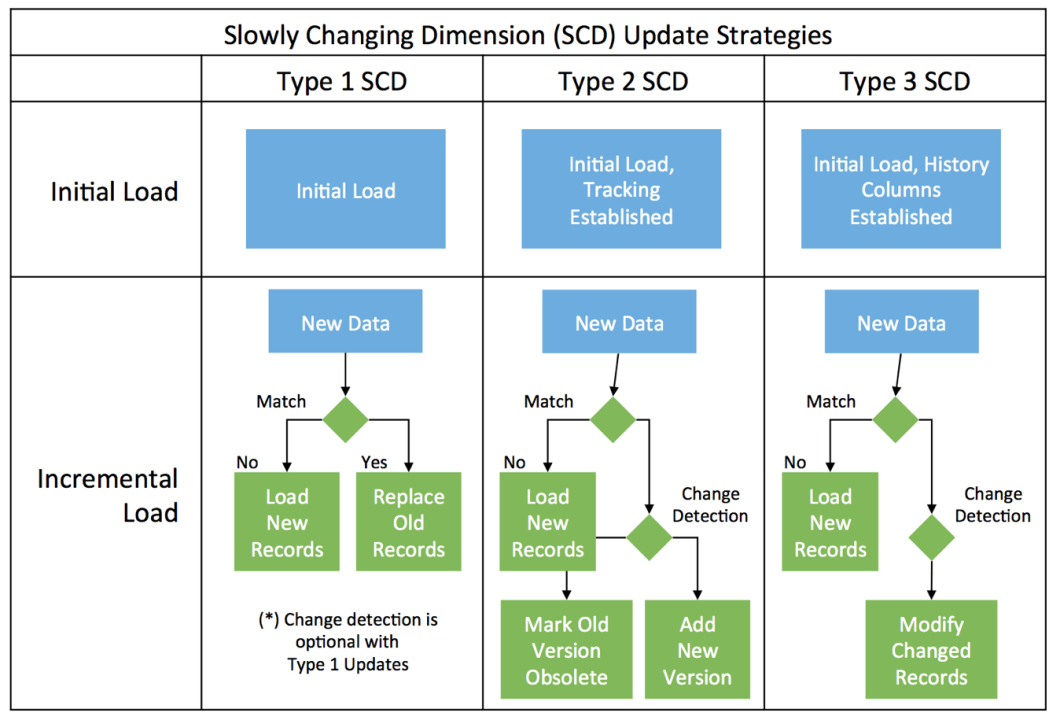
- SCD Type 1 (замещение). Старые значения теряются, атрибуты размерности перезаписываются. Нет сохранения истории по атрибутам. Простой вариант, когда история не важна, или когда необходимо убрать «шумиху» в аналитике.
- SCD Type 2 (версии). В размерности добавляются новые записи при изменении атрибутов; старые версии фиксируются через дату окончания действия, текущая версия помечается как активная. История атрибутов сохраняется.
- SCD Type 3 (двойная версия). В размерности сохраняются ограниченное число предыдущих значений в дополнительных столбцах (например, предыдущий адрес). Менее гибко, но проще в реализации и экономично в хранении.
- SCD Type 4, 5, и далее — расширенные подходы, включая отдельные «исторические» таблицы или плавающие слои, использование хранилищ типа Data Vault или другие методики разделения исторических деталей. В большинстве практических проектов обычно достаточно Type 1/2/3.
Связь между естественными и суррогатными ключами в звёздной схеме
- Факт-таблица хранит внешние ключи к размерностям. Рекомендуется использовать суррогатные ключи размерностей в качестве внешних ключей в фактах, чтобы не зависеть от источников и чтобы история измерений могла варьироваться независимо от бизнес-ключей источников.
- Нередко встречается ситуация, когда в факт-таблице сохраняется и естественный ключ: например, для целей экспресс-анализа или интеграции с источниками; однако это добавляет риск рассогласования и усложняет обновления. В большинстве стандартных архитектур факт sсылается только на суррогатные ключи размерностей.
- Важная деталь: если в процессе интеграции размерности мы работаем в режиме SCD Type 2, то факт-таблица должна ссылаться на текущую версию суррогатного ключа размерности на момент каждой продажи или события. Для корректной истории иногда применяют «insert-лезвие»: сохраняем новую версию размерности и связываем факт с новой версией, когда событие относится к новой версии.
Методологии проектирования суррогатных и естественных ключей
- Определение бизнес-ключей. Сформулируйте список естественных ключей, которые уникально идентифицируют сущности в источнике. Учитывайте, что бизнес-ключи могут меняться, и это следует компенсировать суррогатами.
- Выбор типа суррогатного ключа. В реляционных СУБД обычно выбирают целочисленный суррогат (BIGINT), который генерируется последовательностью. В масштабируемых облачных системах можно использовать UUID или базы с автоматическими генераторами ключей, но для связывания с фактами целочисленные ключи чаще эффективнее.
- Определение граней и исторических потребностей. Решите, какие изменения размерности должны храниться (абсолютно для Type 2 или ограниченно для Type 3). Определите даты начала и окончания действия версии и поле current/is_current.
- Архитектура хранения. В идеале размерности разделяются от фактов; факты ссылаются на суррогатные ключи размерностей. В некоторых системах применяют денормализацию или слои данных (OLAP-модули), но базовый подход — отдельные таблицы размерностей и факт-таблица.
- Обработка изменений. Решите, каким образом будет происходить детекция изменений: по хешу атрибутов, по сравнениям между входным набором данных и текущей активной версией, или по CDC (Change Data Capture) из источников.
- Верификация и тестирование. Введите тесты на консистентность ключей, корректность версий, и на соответствие бизнес-правилам. В dbt или аналогичных системах можно задавать тесты на уникальность бизнес-ключей и на отсутствие «просроченных» версий.
Практические примеры
Пример 1: базовый SCD Type 2 для размерности клиента
Предположим, у нас есть источники данных с полями:
customer_id (естественный бизнес-ключ, строка)
name, city, country (атрибуты, которые могут меняться)
last_updated (датa изменения)
Целевая размерность dim_customer имеет суррогатный ключ customer_sk, и колонки:
customer_sk (PK, суррогатный ключ)
customer_id (естественный ключ; служит бизнес-ключом, может дублироваться в разных версиях, но здесь он остается полем для бизнес-логики)
name, city, country
start_date, end_date
is_current (boolean, или end_date IS NULL как признак текущей версии)
ETL-процесс (упрощенная логика Type 2):
1) Получить поступившую запись: incoming = (customer_id, name, city, country, load_date).
2) Найти существующую текущую версию по customer_id: existing = SELECT customer_sk, name, city, country FROM dim_customer WHERE customer_id = incoming.customer_id AND end_date IS NULL;
3) Если существующей текущей версии нет:
- Вставить новую запись с новым customer_sk (например, через sequence), start_date = load_date, end_date = NULL, is_current = true.
4) Если существует и атрибуты не изменились: ничего не делать.
5) Если существует, атрибуты изменились:
- Обновить существующую версию: end_date = load_date 1, is_current = false.
- Вставить новую версию с новым customer_sk, start_date = load_date, end_date = NULL, is_current = true; сохранить атрибуты name, city, country.
6) Факт-таблица sales_fact с внешними ключами на dim_customer.customer_sk и другими суррогатными ключами размерностей.
Пример SQL-обобщенный (для иллюстрации, без синтаксиса конкретной СУБД):
- Вставка новой версии:
insert into dim_customer (customer_sk, customer_id, name, city, country, start_date, end_date, is_current)
values (nextval('dim_customer_sk_seq'), 'CUST123', 'Иванов Иван', 'Москва', 'Россия', '2025-07-01', NULL, TRUE);
Обновление старой версии:
update dim_customer
set end_date = '2025-06-30', is_current = FALSE
where customer_id = 'CUST123' and end_date is NULL;
Программная вставка новой версии уже описана выше.
Пример 2: суррогатные и естественные ключи в рамках одного процесса ETL
Входной источник: таблица customers_source(customer_id, name, city, country, updated_at).
Dim таблица: dim_customer(customer_sk, customer_id, name, city, country, start_date, end_date, is_current).
Факт: fact_orders(order_id, order_date, customer_sk, amount, product_id, ...).
ETL-логика:
Для каждой новой записи из customers_source:
- Найти текущую версию (customer_id = incoming.customer_id, end_date is NULL).
- Если нет текущей версии — создать новую запись dimension.
- Если есть и атрибуты совпадают — пропустить.
- Если есть и атрибуты изменились — закрыть текущую версию и создать новую.
Связи фактов: когда мы загружаем факт-данные, используем customer_sk из dim_customer соответствующей текущей версии на момент продажи.
Практические примеры на конкретных платформах (open-source и российские решения)
Open-source решения и стековые подходы
- PostgreSQL + dbt. В PostgreSQL удобно реализовать суррогатные ключи через sequences, и строить SCD Type 2 через классический ETL-скрипт с проверкой текущих версий. dbt помогает управлять моделями размерностей как версии: модель dim_customer со столбцами customer_sk, customer_id, name, city, country, start_date, end_date, is_current; тесты dbt проверяют уникальность по customer_id в рамках активной версии.
- Apache Spark + Delta Lake. В Spark можно реализовать SCD Type 2 на уровне преобразований, сохраняя версии в Delta Lake с использованием версий и временных штампов; Delta Lake обеспечивает ACID и эффективную компрессию, что важно при больших объемах.
- Apache NiFi / Apache Airflow. Эти инструменты можно использовать для оркестрации загрузок, CDC, и обработки изменений. У NiFi есть готовые процессоры для извлечения изменений, а у Airflow — DAG-и для последовательной обработки версий размерностей.
- ClickHouse (российская экосистема). В качестве примера российской разработки можно привести использование движка ReplacingMergeTree и версии столбца version или дата окончания действия. В ClickHouse можно реализовать суррогатные ключи при загрузке, а затем в процессе MergeTree-консолидировать версии. Это эффективное решение для аналитических запросов на больших объемах и часто используется в российских проектах на больших дата-центрах.
- Greenplum. Распределенная PostgreSQL-совместимая СУБД, которая хорошо подходит для хранилищ больших данных. Реализация SCD Type 2 в Greenplum аналогична PostgreSQL, но учитывает распределение по сегментам.
- Яндекс DataSphere (облачная платформа). Хотя конкретные реализации зависят от используемого хранилища (к примеру, Snowflake, BigQuery или локальный PostgreSQL), концепции суррогатных ключей и SCD остаются едиными: размерности с суррогатными ключами и фактная таблица с внешними ключами к суррогатным ключам размерностей.
Российские и open-source примеры реализации SCD в контексте SCD Type 2
- Реализация SCD в ClickHouse: применяют ReplacingMergeTree с версионностью. Например, каждая запись dimension имеет версию и признак текущей версии; окно MergeTree запускается в фоне, чтобы объединить старые версии и создать одну текущую запись. Это хорошо работает для больших объемов и предоставляет низкие задержки.
- PostgreSQL в российских проектах часто используется как база данных для историй размерностей, а также как источник для ETL-процессов: последовательности для суррогатных ключей, триггеры или процедуры для обработки SCD Type 2.
- В рамках экосистемы открытых инструментов, локальные решения по интеграции данных (ETL) часто строятся на Apache NiFi и Apache Airflow, с подключением к русскоязычным репозиториям и документации, что позволяет адаптировать процессы под профиль российских данных и нормативные требования.
Выбор типа суррогатного ключа и хранение
- Целочисленный суррогатный ключ (BIGINT). На практике рекомендуется использовать непрерывную генерацию ключей через последовательность или генератор в СУБД. Это обеспечивает компактность и хорошие показатели соединений с фактами.
- UUID. Подходит для распределённых систем и когда требуется глобальная уникальность без координации между узлами. Однако UUID имеет больший размер и может повлиять на производительность соединений и индексов.
- Естественные ключи в качестве ключей размерностей. В некоторых редких случаях можно хранить естественные ключи в качестве внешних ключей в факт-таблицах, но чаще всего это создает сложности при консолидации и обновлениях.
Типы изменений и их хранение
- SCD Type 2. В размерности хранится каждая версия записи. Необходимо по крайней мере:
  суррогатный ключ (customer_sk),
  бизнес-ключ (customer_id),
  атрибуты, которые нужно отслеживать,
  start_date, end_date,
  is_current (или аналогичный флаг активной версии).
- SCD Type 1. Просто перезаписываем атрибуты. Никакой истории.
- SCD Type 3. Храним ограниченное количество предыдущих значений (например, предыдущий город). Это менее гибко и чаще применяется в простых сценариях, где история изменений нужна ограниченно.
Эти принципы применяются и в российских реалиях, где часто применяется хранение истории в отдельной размерности и использование стандартных инструментов (PostgreSQL, ClickHouse, Greenplum) в контексте строгих нормативов и требований к аудиту.
Проектирование и архитектура процессов ETL
- Архитектура: размерности с суррогатными ключами и факт-таблицы, где факт содержит внешний ключ к суррогатному ключу размерности. История изменений в размерности не влияет на сам факт — она влияет через связь с версией размерности на момент фактов.
- CDC и инкрементальные загрузки: для эффективной загрузки изменений можно использовать CDC (Change Data Capture) источников или сравнивать новые данные с текущей версией размерности.
- Архитектура обновлений: для Type 2 загрузка может происходить пакетно ночью, но при необходимости — онлайн-обновления через потоковую обработку. В части больших систем рекомендуется использовать потоковую обработку и атомарные транзакции.
- Тестирование и качество данных: тесты должны проверять отсутствие дубликатов бизнес-ключей в активной версии, корректность версий, валидность дат начала/окончания, и непротиворечивость версий между размерностями.
Риски и ограничения
- Рост объема данных. SCD Type 2 ведет к экспоненциальному росту размерности. Требуется план хранения, компрессии, архивирования и периодических очисток устаревших версий.
- Согласованность ключей между размерностями и фактами. Ошибки в ETL-процессе могут привести к рассогласованию ключей, что вредно для аналитики.
- Эффективность запросов. По мере роста истории производительность может снижаться без надлежащей индексации и partitioning. В некоторых случаях нужно использовать денормализацию или специализированные движки (например, ClickHouse, Delta Lake).
- Сложности миграций. Перевод существующих данных в новую модель (например, переход с Type 1 на Type 2) требует тщательного планирования, тестирования, контроля качества и откаты.
- Временные задержки данных. Часто история должна быть актуальной для поздних загрузок. Это требует подходов к CDC и к mensajes-задержек в загрузке.
- Комплаенс и аудит. В различных юрисдикциях возможны требования к аудиту и хранению истории изменений. Нужно обеспечить прозрачную трассируемость изменений и доступ к версии источников.
Выводы
- Суррогатные ключи позволяют отделить бизнес-ключи от физической идентификации элементов в хранилище, что упрощает консолидацию данных из разных источников и обеспечивает более устойчивое хранение истории.
- В рамках SCD важно определить грань измерения и выбрать подходящий тип изменений: Type 1 для простых случаев без истории, Type 2 для полного хранения истории, Type 3 для ограниченной истории. В большинстве практических проектов для размерностей рекомендуется Type 2.
- Практическая реализация зависит от используемой СУБД и инструментов. В открытом стеке можно использовать PostgreSQL + dbt + Airflow, Delta Lake на Spark, или ClickHouse с ReplacingMergeTree для реализаций высокого объема. В российских условиях часто встречаются решения на базе ClickHouse и PostgreSQL, а для комплексной аналитики — Greenplum, Yandex DataSphere и др.
- Важность правильной архитектуры: предсказуемые ETL-процессы, четко определенная грань измерений, единая логика обновления версий размерностей и корректные ссылки фактов на суррогатные ключи размерностей.
FAQ (вопросы и ответы)
1) Что такое суррогатный ключ и зачем он нужен в SCD?
Суррогатный ключ — это искусственный идентификатор, не зависящий от бизнес-логики источника (часто целочисленный). Он нужен для независимости от изменений естественных ключей источников, упрощения связей с фактами и эффективного хранения истории в размерностях. Он позволяет сохранять версии размерности и связывать факты с конкретной версией сущности.
2) В чем разница между SCD Type 1 и Type 2?
Type 1 замещает старые значения новыми без сохранения истории. Type 2 добавляет новую версию записи размерности, закрывает старую версию и помечает новую как текущую. Type 2 обеспечивает полноту истории атрибутов и позволяет анализировать изменения по времени.
3) Как выбрать грань измерения для проекта?
Грань измерения — это детализированность, на которой регистрируются данные. Необходимо выбрать грань, соответствующую аналитическим требованиям: для продаж за день хватит дневной грани, для поведения клиента — возможно нужен более детальный временной разрез. Неправильная грань ведет к некорректной агрегации и усложняет реализацию SCD.
4) Какие типы СУБД и инструменты лучше использовать в открытом коде для SCD?
Open-source стек: PostgreSQL (с sequences для суррогатов), dbt для моделирования, Airflow или NiFi для оркестрации, Delta Lake или Apache Iceberg для управления версиями и ACID. Для больших объемов и российского контекста можно рассмотреть ClickHouse (ReplcingMergeTree с версионированием) и Greenplum. Эти решения поддерживают реализованные схемы SCD и хорошо масштабируются.
5) Какие риски связаны с внедрением SCD Type 2?
Основные риски: рост объема данных и затрат на хранение, сложность ETL-логики и тестирования, риск рассогласования ключей между размерностями и фактами, задержки в загрузке обновлений и необходимость аудита. Важно заранее планировать схемы хранения, индексы, partitioning и тестовые сценарии.
6) Какие практические подходы применяют в российском рынке?
В России часто применяют PostgreSQL и ClickHouse как базовые хранилища. ClickHouse часто выбирают за скорость и масштабируемость в аналитике, используя ReplacingMergeTree для реализации версий размерностей. Также популярны Greenplum и Yandex DataSphere для более крупных дата-ферм. Инструменты ETL/оркестрации — Airflow и NiFi, адаптируемые под российские требования и локальные источники.
7) Как связать факт-таблицу с размерностями при SCD Type 2?
Факт-таблица должна ссылаться на суррогатные ключи размерностей. При изменении версии размерности факты должны связываться с версией размерности на момент события. В типичной реализации факт-таблица содержит ссылки на dim_customer.customer_sk, что обеспечивает точную историю продаж и анализа по клиентам.
8) Что делать, если источник данных изменяет естественный ключ?
Если источник может менять естественный ключ, суррогатный ключ в размерности позволяет изолировать эти изменения. При появлении нового естественного ключа или изменений бизнес-логики мы работаем через обновления размерности и создаем новые версии. В некоторых случаях можно предварительно нормализовать естественные ключи, чтобы минимизировать их изменение.
9) Какие показатели важны для контроля качества при внедрении SCD?
Контроль качества должен охватывать уникальность бизнес-ключей в активной версии, корректность start_date/end_date и is_current, отсутствие «утерянных» версий, согласованность ссылок между размерностями и фактами, а также корректность транзакционных единиц в ETL (атомарность загрузок, откаты).
10) Как выбрать между UUID и целочисленным суррогатным ключом?
Целочисленный суррогат (BIGINT) обычно быстрее в соединениях и эффективен по памяти и индексации, особенно в больших таблицах. UUID обеспечивает глобальную уникальность без координации между узлами и упрощает распределенные среды, но стоит дороже по памяти и скорости индексов. Выбор зависит от архитектуры: локальная монолитная база — целочисленный ключ; распределенная облачная система или необходимость глобальной уникальности — UUID.
Проектирование измерений с суррогатными и естественными ключами — это баланс между гибкостью, историчностью и производительностью. Суррогатные ключи упрощают консолидацию разнородных источников и позволяют полноценно хранить историю изменений в размерностях (SCD Type 2). Правильная граница измерения, грамотная архитектура ETL и продуманная стратегия обновления версий позволяют получить устойчивую, масштабируемую и аудируемую систему аналитики. В рамках открытых и российских решений можно выбрать стек под конкретные требования проекта: от PostgreSQL и dbt до ClickHouse и Delta Lake в зависимости от объема данных, скорости загрузок и необходимости сложной аналитики. В любом случае ключевые принципы остаются одинаковыми: разделение размерностей и фактов, использование суррогатных ключей для связей, сохранение истории по версии, и обеспечение качества данных через тестирование и аудит.
Вопрос–Ответ (FAQ) ч. 2
1) Что произойдет, если мы проигнорируем суррогатные ключи и будем строить связи напрямую по естественным ключам?
Вероятно, мы столкнемся с проблемами консолидации данных из разных источников, особенно если естественные ключи изменяются. Это затруднит поддержание истории, усложнит обновления и повысит риск дубликатов. Суррогатные ключи позволяют отделить бизнес-ключи от физической идентификации и упрощают версии. Поэтому в большинстве проектов рекомендуется использовать суррогатные ключи размерностей и связывать факты через них.
2) Как избежать чрезмерного роста размерности при SCD Type 2?
Берите разумно грамотную грань измерения и ветвление версий. Ограничение роста достигается за счет разумной политики архивирования (например, удалять устаревшие версии через год, если бизнес-потребности позволяют) и выбора стратегий хранения (например, хранение только атрибутов, которые действительно изменились, в версиях). Также можно использовать компрессию и архивацию старых версий, если бизнес-потребность в них уменьшается.
3) Какие особенности стоит учитывать при использовании ClickHouse для SCD?
ClickHouse хорошо подходит для аналитики с большим объемом данных. Реализация SCD может быть выполнена через использоваие ReplacingMergeTree и версий, либо через добавление новой версии размерности и последующее слияние. В ClickHouse важно грамотно организовать партиционирование, индексацию и периодическое слияние версий, чтобы запросы оставались быстрыми.
4) Какие задачи лучше держать в Type 1, а какие — в Type 2?
Если важна только текущая сущность без сохранения истории изменений, Type 1 подходит. Если нужно отслеживать историю изменений атрибутов (когда и как изменились данные), используйте Type 2. В большинстве анализа ключевой считается история, поэтому Type 2 чаще предпочтителен для размерностей, а Type 1 применяется для вспомогательных полей или в случаях, когда история не критична.
5) Как обеспечить прозрачность версий для пользователей?
Устанавливайте clear поля start_date и end_date, а также is_current (или аналог) в размерностях. В аналитических отчётах можно показывать версию по дате факта или использовать «песочные часы» — смотреть данные на конкретную дату. Вопрос аудита решается через логирование ETL-операций и хранение метаданных об изменениях.
6) Что делать, если источники данных не поддерживают CDC?
Можно реализовать сравнение входных записей с текущей версией размерности по бизнес-ключу и атрибутам. Это может быть пакетная загрузка, где на каждом проходе сравниваются новые данные с текущей активной версией и принимаются решения для вставки новой версии или пропуска изменений. Это требует аккуратно продуманной логики в ETL.
7) Какие практики тестирования стоит внедрить?
Тестируйте уникальность бизнес-ключей в активной версии, корректность start_date/end_date и is_current, целостность связей между размерностями и фактами, а также целостность истории. В dbt можно определить тесты на уникальность, не-null, и пользовательские тесты на логику обновления версий.
8) Как выбрать между PostgreSQL и ClickHouse для реализации SCD?
Если вам нужна оперативная аналитика на больших объемах с гибкими запросами и сложной историей — может подойти ClickHouse с версионированием. Если требуется строгое ACID-поддержка, богатый набор инструментов для ETL и удобное управление схемами, можно начать с PostgreSQL. В реальных проектах часто комбинируют: хранение и обработку в Go-слоях и аналитика на ClickHouse, или хранение в PostgreSQL с последующим экспорта в ClickHouse для аналитики.
9) Могут ли суррогатные ключи использоваться в качестве естественных ключей в другом источнике?
Да, суррогатные ключи служат внутри хранилища данных, но источники могут требовать естественных ключей. В таких случаях при экспорте или интеграции можно сохранить бизнес-ключ как отдельное поле в факт-таблице и воспользоваться суррогатным ключом размерности для связей внутри хранилища. Это обеспечивает совместимость между системами и сохраняет историю.
10) Какие шаги предпринять на старте проекта, чтобы успешно реализовать SCD?
- Определите грань измерения и набор атрибутов, которые подлежат истории.
- Выберите стратегию суррогатных ключей и формата хранения (целочисленные ключи, UUID).
- Спроектируйте dim-таблицы и факт-таблицу; определите связи и версии.
- Разработайте ETL-процессы с поддержкой CDC или инкрементной загрузки.
- Внедрите тесты качества данных и аудит изменений.
- Выберите стек инструментов (open-source и/или российские решения) в зависимости от ваших требований к объему и скорости загрузок.
- Запланируйте мониторинг и управление growth-рисками.
Готовы приступить к проектированию измерений в вашей системе? Ваша задача — выбрать правильную грань, определить бизнес-ключи и спроектировать суррогатные ключи так, чтобы ваша система аналитики могла надежно хранить историю изменений и обеспечивать быстрые и точные ответы на вопросы бизнеса.


