

Различные виды стека данных
от открытых источников до платных продуктов
При построении инфраструктуры данных важно выбрать правильные инструменты. Существуют различные общепринятые и проверенные временем решения, в том числе облачные, которые доступны абсолютно каждому.
Так каким же типом стека данных воспользуетесь Вы?
Ваш стек данных может быть представлен в виде копии основной базы данных, которую Вы анализируете при помощи любого инструмента, работающего, на Ваш взгляд, наиболее эффективным образом.
Но как только Вы «вырастите» из этого типа стека, Вы увидите, что выбор других вариантов на самом деле достаточно широк: это могут быть open source решения или предложения от компаний, известных по всему миру.
Все из них достаточно хороши в зависимости от целей и предпочтений конечного пользователя, а по большому счету и от того, насколько красочно менеджер по продажам в состоянии позиционировать свой продукт =)
Давайте пройдемся по типам стека данных, с которыми мне довелось иметь дело.
Репликация базы данных
В своем прошлом посте я писал о том, как программист может передать данные аналитику с помощью выдержек из Excel/CSV. Другим способом может стать репликация базы данных.
По сути, речь идет об операциях «копировать» - «вставить».
Основным плюсом данного подхода является его простота – нет необходимости разбираться в сложных ИТ-решениях.
В этом случае аналитик может быстро приступить к работе по составлению отчетов и проанализировать имеющиеся данные. А это значит, что Вы сможете быстро получить ответ на интересующие Вас вопросы.
Если такой простой метод может достаточно быстро дать информацию о ROI, тогда почему же компании не пользуются только им, а постоянно находятся в поиске других решений? Наверное, потому что у данного подхода есть свои недостатки ...
Например, одна из основных проблем, которая может возникнуть в зависимости от того, как настроена Ваша база данных, — это отслеживание изменений.
Допустим, у Вас есть таблица покупателей, и в этой таблице есть такое поле, как город проживания. Здорово! Но нередко, случается так, что покупатели меняют свое место проживания, и соответствующие поля приходится обновлять. Это означает, что информация о предыдущем городе будет потеряна.
Поэтому, если Вас попросят подсчитать количество покупателей в конкретном городе и сравнить его с аналогичным показателем в прошлом году, Вы не сможете точно ответить на этот вопрос. Вероятность ошибки слишком велика …
Другой серьезной проблемой является отсутствие централизации данных, между тем, как одной из основных целей создания системы хранения данных является то, что Вы можете централизовать все свои данные в одном месте.
Конечно, есть и другие плюсы и минусы, о которых мы не говорим в этой статье. Для начала репликации базы данных может быть вполне достаточно. Однако со временем Вам, вероятно, придется пересмотреть инфраструктуру данных, чтобы решить некоторые из проблем, упомянутых выше.Open-source стеки данных

Еще одним способом организации данных могут стать 100% open source решения или 3 почти бесплатных продукта.
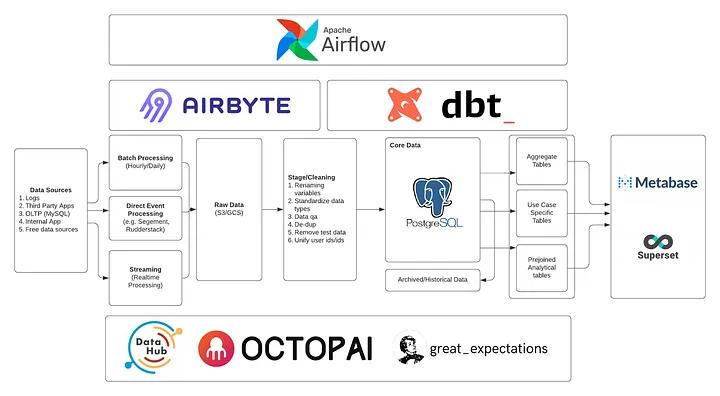
Например, Вы можете сделать свой выбор в пользу Postgres, Airflow, Airbyte, Datahub, а также Metabase.
Это open-source продукты, которые, как правило, имеют бесплатные версии.
Когда компании стремятся снизить стоимость ИТ - решений и хотят при этом иметь сильную команду инженеров в области ИТ, open-source предложения могут стать отличным вариантом.
Существуют некоторые инструменты и решения, которые могут помочь компаниям существенно сократить расходы, выступая в качестве оркестратора данных.
Open-source продукты – отличный вариант, особенно если Ваша компания в состоянии содержать команду профессиональных ИТ-инженеров. Я знаю множество компаний, которые предпочитают именно его по множеству причин. Некоторым людям нравится само понятие open-source. Другие не хотят тратить много времени на менеджеров по работе с клиентами и их внутреннюю бюрократию, только лишь для того, чтобы пользоваться новыми технологиями (с которыми, кстати, достаточно успешно могут поспорить многие open-source продукты).
Как бы то ни было, open – source решения имеют полное право на существование.
Стек данных от известных компаний
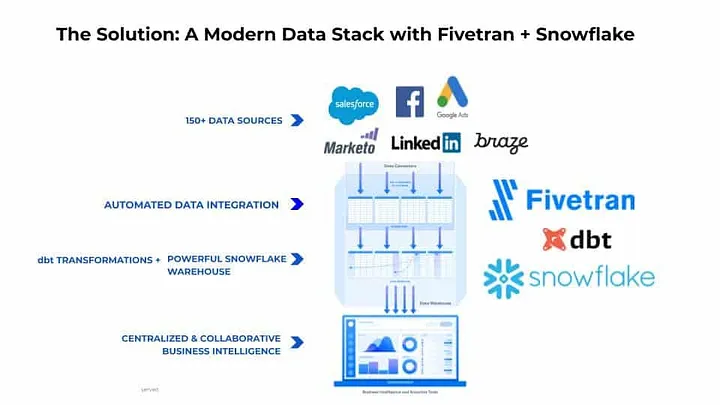
Антиподом open-source решений является стек данных от известных компаний. Это своего рода Apple в сфере IT и BI: Fivetran, Snowflake и Looker.В настоящее время они являются одними из наиболее популярных инструментов (конечно, есть и другие). И это я еще не назвал всеобщего любимца публики - dbt.
Они действительно востребованы, и у этого есть множество причин. В том числе, сильная маркетинговая политика компаний-производителей.
Как правило, данные решения более дорогие, что обусловлено все теми же инвестициями в маркетинг. Безусловно, они во многом оптимизируют рабочие процессы, но будьте готовы к тому, что это обойдется Вам недешево.
Облачный стек данных
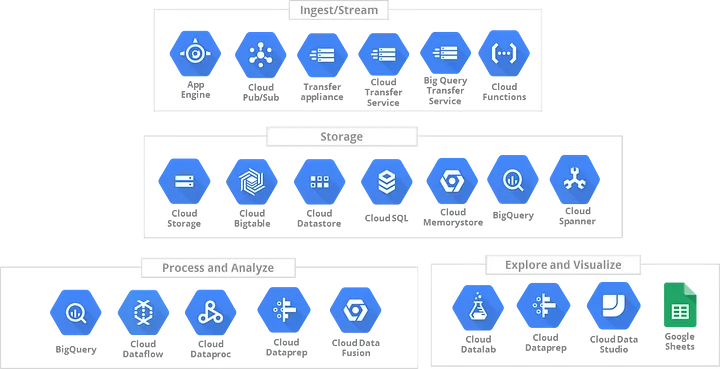
Еще одним видом стека данных являются облачные решения. Они, как правило, почти на 100% основаны на облачных продуктах, которыми уже пользуется компания.
То есть, если компания использует AWS, тогда целесообразно рассмотреть такие сервисы, как AWS Glue, EMR, MWAA, Redshift, а также Quicksight.
Если это Bigquery, тогда обратите внимание на Looker, Cloud Composer и Dataproc.
И даже не говорите мне про Azure!
У облачного типа стека данных нет каких-либо серьезных недостатков. Вообще говоря, они создаются консультантами или инженерами, которые имели дело только с одним типом стеком данных или просто предпочитают какое-то конкретное решение. В любом случае, данные продукты в определенном смысле проще в обслуживании с точки зрения логистики.
Вы будете использовать те же самые IAM и ключи API, так что вряд ли столкнетесь с какими-либо трудностями.
С другой стороны, поскольку поставщики облачных услуг не на 100% сосредоточены на инфраструктуре данных, уровень предоставляемых услуг не всегда достаточно высокий. Например, недавно я сделал видео-обзор про MWAA vs Cloud Composer Vs Astronomer. Когда компания полностью сфокусирована на лучших практиках или инструментах, как правило, это приводит к наиболее лучшим результатам.
По крайней мере, с точки зрения возможностей, поддержки и так далее. Но при этом я считаю, что есть много веских причин и для того, чтобы стек данных был настроен с использованием одного облака, особенно если Ваши команда хорошо разбирается в его провайдере.
Гибридный стек данных
Конечно, зачастую компании останавливаются не только на одном из вышеупомянутых видов стека данных, а предпочитают гибридный вариант
Вполне возможно использование Fivetran наряду с BigQuery или Dagster и Snowflake. Кроме того, open-source решения вполне могут применяться наряду с платными продуктами.
Это достаточно распространенный случай, поскольку стеки данных формируются со временем и зачастую разными инженерами данных. Все это естественным образом приводит к гибридному варианту организации хранения данных.
Ключевым моментом здесь является обеспечение того, чтобы Вы заранее установили стандарты хранения данных и задокументировали процесс. Таким образом, независимо от того, какие инструменты Вы выберете в будущем, основные цели стека данных останутся неизменными.
Так какой же вариант выбрать?
Выбор наиболее подходящего решения
Естественно, каждая компания выбирает что-то свое. Я лишь еще раз хотел бы подчеркнуть тот факт, что выбор временного решения неизбежно приведет к большому количеству переделок в будущем.
Когда Вы меняете модели, типы данных или другие ключевые компоненты, Вы тратите много времени на преобразования, перенастройку, переобучение и т.д.
Поэтому я со всей ответственностью рекомендую Вам итерации. Главное, чтобы они были в правильном направлении.


