

Руководство по миграции крупного хранилища данных: от хаоса к управляемому процессу. Практический опыт и дорожная карта
Мы часто сталкиваемся с ситуациями, когда необходимость миграции становится критической: моральное и техническое устаревание инфраструктуры, санкционные ограничения, невозможность масштабирования и растущие затраты на поддержку. Принятие решения о миграции — это только первый шаг. Главный вызов — спланировать этот многолетний процесс так, чтобы не парализовать текущую бизнес-активность, уложиться в бюджет и сроки и в итоге получить современную, эффективную и управляемую платформу.
В этой статье мы поговорим об уникальном опыте планирования миграции одного из крупнейших в стране хранилищ данных объемом более 1 ПБ. Мы не только расскажем о проблемах, с которыми столкнулись, но и предложим готовые, апробированные решения и детальную дорожную карту, которую вы сможете адаптировать под свои нужды.
Наш проект был инициирован в 2024 году. Хранилище данных, служившее бизнесу верой и правдой долгие годы, подошло к критической точке. Дальнейшее масштабирование на старой проприетарной западной платформе стало невозможно ввиду известных причин на международной арене. Рост объемов данных и потребность в новых аналитических возможностях требовали перехода на современную российскую платформу.
Ключевой вызов состоял не в самом переносе данных, а в сохранении непрерывности бизнес-процессов. Хранилище питало сотни отчетов и десятки критически важных систем-потребителей. Любая ошибка или длительный простой могли обернуться миллионными убытками. Поэтому мы начали не с написания скриптов переноса, а с глубокого и всестороннего обследования всей системы.
Мы решили построить детальный, пообъектный план миграции, который минимизирует риски и позволит управлять процессом, а не плыть по течению.
Фаза 1: Глубокое обследование и инвентаризация. Как найти все нити в гигантском клубке
Исходная ситуация была типичной для многих крупных проектов: неполная документация, отсутствие полного атрибутного Data Lineage (прослеживаемости данных) и понимания всех взаимосвязей. В хранилище и связанных с ним «песочницах» насчитывалось более 9000 объектов, опутанных настоящей паутиной зависимостей.
Основные риски на данном этапе заключались в том, чтобы, во-первых, не пропустить критические зависимости - отключение или миграция одного объекта может неожиданно «положить» десятки отчетов и систем, о связях с которыми никто не знал.
Во-вторых, нам было крайне важно учесть все наши специфические требования касательно бизнеса - Без понимания того, какие данные, с каким качеством и к какому сроку нужны бизнесу, новое хранилище рискует оказаться бесполезным.
И, наконец, нам было просто необходимо определиться с планируемым объемом работ - без четких границ проект миграции может превратиться в сизифов труд.
Учитывая все выше сказанное, мы отказались от хаотичных совещаний и разработали серию структурированных опросников для разных бизнес-подразделений.
Для каждого отчета мы определили ID, назначение, владелец, требования к актуальности, качеству и безопасностили данных.
Для каждой системы-потребителя мы обозначили ее назначение, бизнес-процессы, в которых она задействована, контактные лица.
А для источников данных мы провели детализацию вплоть до отдельных атрибутов, откуда берутся данные для каждого показателя.
В результате мы получили исчерпывающий список всех бизнес-критичных объектов и поняли, на чем базируется каждая функция. Это позволило отделить «зерна от плевел» и сфокусироваться на главном.

Фаза 2: Восстановление Data Lineage и классификация. Как увидеть всю систему целиком
Следующей задачей было восстановление полной цепочки движения данных от источника до потребителя. Существующие метаданные были фрагментарны.
Мы разработали и внедрили алгоритм, который автоматически выстраивал полный Data Lineage для любого объекта хранилища, вплоть до исходных систем. Это позволило нам устранить «разрывы» в существующих метаданных, выявить «теневую» IT-инфраструктуру и обнаружить большое количество витрин, созданных в «песочницах» непромышленным способом. Их «опромышливание» стало отдельной задачей в проекте. Далее, мы провели четкую классификацию - отнесли каждый объект к одному из стандартных слоев хранилища:
- RAW - слой сырых данных;
- DDS - детальный слой данных (Data Detail Store);
- BaseMart - слой базовых витрин;
- BusinessMart -слой бизнес-витрин;
- SandBoxes - «песочницы» для аналитиков.
Пример: Алгоритм показал, что ключевая витрина для расчета KPI отдела продаж зависела от данных из пяти различных источников, проходила через три промежуточные таблицы в DDS и одну в BaseMart, а также имела три копии в разных «песочницах» с небольшими вариациями. Это знание позволило нам создать единую, авторитетную версию этой витрины в новом хранилище.
Фаза 3: Оценка трудозатрат. От абстрактных оценок к точным метрикам на основе алгоритмов
Любой проект требует бюджета и сроков. Классические экспертные оценки «на глазок» для проекта такого масштаба не просто неточны — они опасны.
Поэтому мы решили сделать следующее.
Во-первых, мы создали детальный справочник всех видов работ, необходимых для миграции каждого типа объектов. От разработки логической модели и архитектурного ревью до проведения приемочных испытаний и развертывания.
Во – вторых, для каждого вида работ мы определили «драйвер» — измеримую сущность, от которой зависят трудозатраты. Например, для работы «Создать логическую модель в Power Designer» драйвером стало «количество атрибутов таблицы DDS», а для работы «Сформировать требования к витрине» - «количество бизнес-витрин».
Далее, для сложного процесса анализа и миграции SQL-кода (хранимых процедур, представлений) мы применили научный подход — метрики Холстеда. Наш специалист адаптировал этот алгоритм для SQL, что позволило оценивать сложность кода по объективным параметрам, таким как, количество уникальных операторов и операндов, общий словарь программы, объем и сложность разработки, а также расчетные трудозатраты в человеко-часах.
SELCnt_methodAScalc_name-- Наименование способа расчета (наименование процедуры, вьюхи),tablekindAScalc_type-- Тип расчета (V-вьюха, P-процедура),Count(DISTINCTCASE WHEN token_type= 'Operation'THEN metric_name ELSENULLEND)ASnu_op-- Количество уникальных служебных слов (операций),Count(DISTINCTCASE WHEN token_typein('Operand','Common') THEN metric_name ELSENULLEND)ASnu_opd-- Количество уникальных операндов (столбцы, таблицы),Sum(CASE WHEN token_type= 'Operation'THEN metric_value ELSENULLEND)ASn_sm_op-- Общее число служебных слов (операций),Sum(CASE WHEN token_typein('Operand','Common') THEN metric_value ELSENULLEND)ASn_sm_opd-- Общее число операндов (столбцы, таблицы),nu_op+nu_opdASn_dict-- Словарь скрипта = nu_op+nu_opd,n_sm_op+n_sm_opdASn_length-- Длина скрипта = n_sm_op+n_sm_opd,n_length*(Log(n_dict)/Log(2))ASv_length-- Объём скрипта = n_length*log2(n_dict),(nu_op*n_sm_opd)/(2*nu_opd)ASd_length-- Сложность разработки = (nu_op*n_sm_opd)\(2*nu_opd),d_length*v_lengthASe_length-- Усилия при разработке = d_length*v_length,18 ASk_psy-- Психологический фактор (От 5 до 20, берем 13),e_length/k_psyASt_length-- Трудозатраты = e_length\k_psy,t_length/3600 AScost_mh-- Трудозатраты в часах,NULL ASctg_complex_name-- Категория сложности зависит от d_length и максимально сложного способа расчета из ctg_complex (пока оставляем пусто) FROMmigration.t_obj_complexity
Данный подход позволил нам перевести дискуссию о сроках и бюджете из области субъективных споров в область объективных данных. Все заинтересованные стороны — и заказчик, и исполнитель — смогли опереться на прозрачные и верифицируемые расчеты.
Фаза 4: Стратегия миграции: Декомпозиция и планирование. Как съесть слона по частям
Мигрировать петабайтное хранилище единым махом — технически невозможно и экономически нецелесообразно. Ключ к успеху — правильная декомпозиция.
На данном этапе мы в первую очередь осуществили миграцию ядра (RAW, DDS, BaseMart). Эти слои мы разбили по функциональным блокам (например, «ассортимент», «чеки», «операции»). Каждый блок мог разрабатываться и мигрироваться относительно независимо, что позволяло вести работы параллельно и сокращать общие сроки.
Далее мы осуществили миграцию витрин (BusinessMart и SandBoxes). В данном случае функциональное разбиение не сработало, так как бизнес-витрины являются кросс-функциональными. Мы применили механистический, но эффективный подход, а именно построили полные деревья зависимостей для каждой витрины, отсортировали их так, чтобы каждая последующая витрина в списке зависела от предыдущих и сгруппировали этот отсортированный список в пулы так, чтобы трудозатраты на миграцию каждого пула были примерно равны.
Пример: Пул 1 включал в себя 15 витрин общей сложностью 500 человеко-часов. После его миграции на новую платформу могли перейти 5 ключевых отчетов для финансового департамента и 2 системы-потребителя. Это позволяло бизнесу начинать получать пользу от нового хранилища уже на ранних этапах проекта, а не ждать его полного завершения через несколько лет.
Фаза 5: Дорожная карта. Визуализация многолетнего пути
На основе всей собранной информации мы построили финальную дорожную карту, состоящую из двух крупных этапов:
Этап 1: Миграция ядра хранилища (RAW, DDS, BaseMart)
- Работы ведутся параллельно по нескольким функциональным блокам;
- Для каждого блока работы идут по циклу: Системный анализ -> Миграция RAW -> Миграция DDS -> Миграция BaseMart
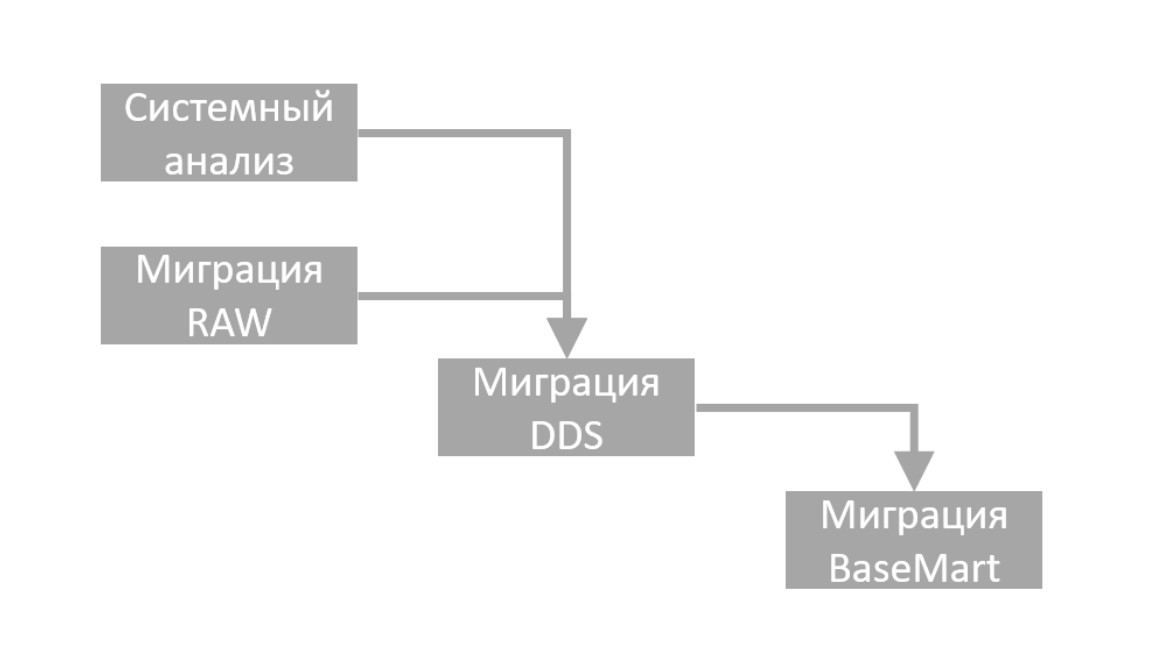
- Поэтапный ввод блоков в эксплуатацию.
Этап 2: Миграция витринного слоя (BusinessMart, SandBoxes)
- Работы ведутся строго последовательно, пул за пулом;
- Каждый последующий пул зависит от предыдущих;
- Поэтапный вывод отчетов и систем-потребителей со старой платформы и подключение к новой.
Наша дорожная карта была рассчитана в нескольких сценариях (оптимистичный, реалистичный, пессимистичный) и легко пересчитывалась при изменении приоритетов, дат готовности источников или доступности ресурсов.
Итоги проделанной работы или почему этот подход работает
Миграция большого хранилища данных — это в первую очередь организационный и управленческий вызов. Наша методика позволяет превратить этот хаотичный процесс в управляемый проект с четкими результатами для нескольких групп пользователей.
Преимущества с точки зрения руководящего состава:
- Прозрачность и управляемость - Вы видите не просто сроки, а поэтапный план получения конкретных бизнес-результатов (ввод отчетов, отключение систем);
- Контроль рисков - раннее выявление зависимостей и узких мест предотвращает сюрпризы и срывы сроков;
- Обоснованный бюджет - расчет трудозатрат на основе алгоритмов, а не догадок, позволяет точно планировать финансирование;
- Поэтапная окупаемость - бизнес начинает получать выгоду от нового хранилища уже в процессе миграции, а не после ее окончания.
Преимущества с точки зрения IT-Директора и Архитектора:
- Качественное новое хранилище - процесс миграции становится поводом для санации данных, устранения legacy-кода и построения чистой, документированной архитектуры;
- Оптимальное использование ресурсов - параллельная работа над разными функциональными блоками ускоряет общие сроки;
- Минимальное влияние на текущие процессы - поэтапный ввод/вывод функциональности позволяет избежать простоев и катастрофических рисков.
Преимущества с точки зрения бизнес-пользователей:
- Непрерывность процессов - Ваши отчеты и системы продолжают работать без сбоев на всех этапах миграции;
- Единая версия правды - устранение дублирующих и противоречивых витрин из «песочниц» повышает доверие к данным.
- Новые возможности- платформа открывает доступ к более быстрому и глубокому анализу.
Мы уверены, что наш опыт и отработанная методика помогут вашей компании провести миграцию максимально гладко, предсказуемо и с максимальной отдачей для бизнеса. Мы готовы предложить вам полный цикл услуг — от первоначального аудита и построения дорожной карты до полной реализации проекта «под ключ».


