

Практическое руководство от экспертов: три роковые ошибки в архитектуре Data Lake, DWH и BI, которые ежедневно стоят вашим компаниям тысяч долларов
Добрый день! Мы — команда экспертов в области инженерии данных и аналитики. Наша компания специализируется на построении, аудите и оптимизации высоконагруженных аналитических систем: от создания надежных Data Lake и DWH до внедрения эффективных BI-решений.
В своей ежедневной практике мы сталкиваемся с последствиями одних и тех же ошибок, которые допускают аналитики и инженеры данных. Эти ошибки кажутся незначительными на этапе разработки, но в промышленной эксплуатации они оборачиваются колоссальными финансовыми потерями, потерей доверия бизнеса к данным и бесконечными часами работы на аварийные ситуации.
В этом материале мы подробно разберем три самых распространенных и дорогостоящих антипаттерна. Мы не просто покажем, «как не надо», но и дадим четкие, практические рекомендации, как выстроить процессы правильно, чтобы ваша аналитическая платформа стала реальным активом, а не источником головной боли и расходов.
Ошибка №1: Беспечное использование SELECT * — иллюзия экономии времени и источник катастроф
Начнем с самой базовой, но от того не менее опасной привычки — использования конструкции SELECT * в продакшен-коде.
Аналитик исследует новую таблицу, ему нужно быстро посмотреть на данные. SELECT * FROM table_name LIMIT 10 — самый быстрый и очевидный способ. Проблема начинается тогда, когда этот исследовательский запрос, не меняясь, мигрирует в ETL-процедуру, дашборд или отчет. Кажется, что это экономит время: не нужно перечислять десятки колонок, но эта экономия — лишь иллюзия, который очень дорого обходится и вот, почему:
-
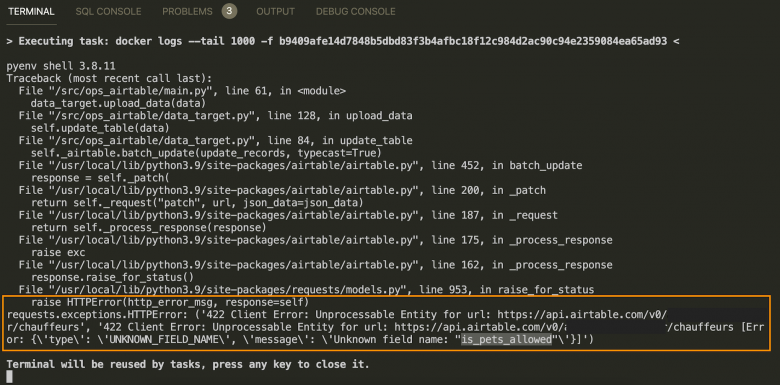
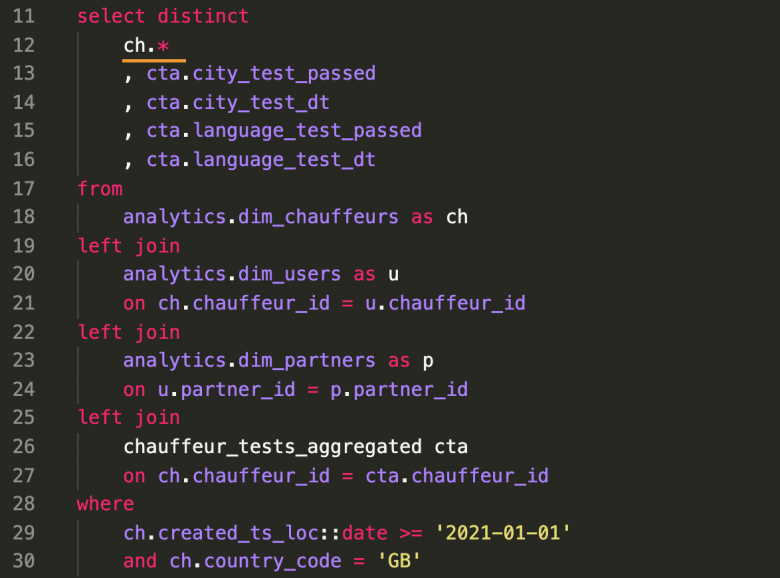
Хрупкость архитектуры и скрытые зависимости. Ваш ETL-скрипт, отчет или интеграция начинают неявно зависеть от текущей структуры таблицы. Представьте, что в таблицу-источник добавили новую колонку с техническими данными, которые не должны попадать в витрину. Или, что хуже, удалили неиспользуемую, как всем казалось, колонку. Ваш скрипт, использующий
SELECT *, либо начнет падать с ошибкой, либо, что страшнее, молча продолжит работу, но уже с неправильным набором данных. Поиск причины такого падения может занять часы, ведь явных указаний на то, какие колонки ожидались, в коде нет.
-
Утечка конфиденциальных данных. Это критически важный риск с юридическими и репутационными последствиями. В большой широкой таблице могут находиться колонки с персональными данными (PII), финансовой информацией, внутренними служебными метками.
SELECT *вслепую выгрузит всё это наружу. Например, при интеграции с внешней системой (например, Airtable, как в оригинальном примере) вы можете случайно экспортировать туда данные, которые никогда не должны были покидать периметр вашего DWH. Принцип наименьших привилегий (Least Privilege Principle) должен применяться и к данным: предоставлять доступ только к тем данным, которые необходимы для решения конкретной задачи, и ни байтом больше. -
Нерациональное использование вычислительных ресурсов и денег. Современные колоночные СУБД (ClickHouse, BigQuery, Snowflake, Redshift и др.) оптимизированы под работу с колонками, а не со строками. Когда вы делаете
SELECT *, вы заставляете систему читать все колонки каждой строки, даже если вам нужны всего три из них. Это, во-первых, слишком медленно - увеличивается время выполнения запроса из-за избыточного I/O. А, во –вторых, это слишком дорого – стоимость облачных решениях (BigQuery, Snowflake) стоимость запроса напрямую зависит от объема просканированных данных. Вы платите реальные деньги за чтение ненужных гигабайт информации.

Пример:
У клиента из e-commerce-сегмента ежедневно «проваливалась» критически важная процедура обновления витрины товаров. Причина оказалась в том, что в исходную таблицу товаров из источника добавили новое поле is_test. ETL-процедура, использовавшая SELECT *, пыталась вставить его в целевую таблицу, где этого поля не было. Процедура падала, витрина не обновлялась, что блокировало работу отдела маркетинга на несколько часов каждый день. Решение было простым: явно перечислить все необходимые колонки в запросе. Это сделало процедуру стабильной и невосприимчивой к добавлению в источник новых, нерелевантных полей.
Что делать, чтобы избежать подобных ошибок?
Во-первых, всегда явно указывайте колонки - явно перечисляйте все необходимые колонки в SELECT. Да, это требует больше времени на написание, но это инвестиция в стабильность и прозрачность.
Во-вторых, используйте шаблоны и код-генерации. Если таблица содержит 100+ колонок и перечислять их вручную нерационально, используйте инструменты для генерации такого кода. Например, в dbt можно использовать макрос {{ dbt_utils.star() }} с указанием исключений.
В-третьих, внедрите линтеры SQL - внедрите в процесс код-ревью автоматические проверки (линтеры), которые запрещают использование SELECT * в моделях, предназначенных для продакшена.

Ошибка №2: Злоупотребление CTE (Common Table Expressions) — лабиринт, из которого невозможно выбраться
CTE — это замечательный инструмент для структурирования сложных SQL-запросов. Он повышает читаемость кода, позволяя разбивать большую задачу на логические этапы. Однако его чрезмерное использование превращает запрос в монстра, которым невозможно управлять.
Пример красивого использования CTE в модели dbt: https://gist.github.com/kzzzr/5cccc74f6d9eeb189ae6fdba1b2ec14a
{{
    config(
        materialized='ephemeral'
    )
}}

WITH accepted AS (
    SELECT DISTINCT
          request_id
        , LAST_VALUE(car_id IGNORE NULLS) OVER
            (PARTITION BY request_id ORDER BY event_ts_utc ASC
               ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) as car_id
    FROM {{ ref('flt_orders_logs') }}
    WHERE event_status in ('accepted')
    GROUP BY
        request_id
        , car_id
        , event_ts_utc
)

SELECT
      reserved.request_id
    , DECODE(reserved.car_id, accepted.car_id, false, true) as is_prebook_to_asap

FROM {{ ref('int_requests_first_reservations') }} as reserved
    LEFT JOIN accepted USING(request_id)
Рассмотрим случай, когда аналитик начинает решать сложную задачу. Он создает первую CTE для базовой фильтрации, вторую — для джойна, третью — для агрегации. Потребовалось добавить еще одно условие? Проще создать четвертую CTE, чем разбираться в уже написанных. Процесс повторяется, и скоро запрос обрастает 10, 20, а иногда и 40 CTE.
Почему это плохо:
- Падение производительности и рост стоимости. Не все СУБД умеют оптимизировать запросы с большим количеством CTE. Зачастую каждая CTE материализуется во временную таблицу (в памяти или на диск), и только затем над ней производятся операции. Это означает, что если на первом этапе вы отфильтровали 1 млн строк, но в каждой последующей CTE вы их агрегируете и уменьшаете до 1000 строк, система все равно может сначала материализовать все эти миллионы, а уже потом проводить агрегацию. Это колоссальные непроизводительные затраты CPU, памяти и I/O.
- Создание «узких мест» (bottlenecks) и спагетти-кода. Запрос с десятками CTE становится черным ящиком. Невозможно понять логику преобразования данных, не пройдя мысленно всю цепочку. Такой код крайне сложно рефакторить и почти невозможно повторно использовать. Новые изменения вносятся не оптимизацией существующей логики, а путем добавления все новых и новых CTE поверх существующих, что еще больше усугубляет проблему.
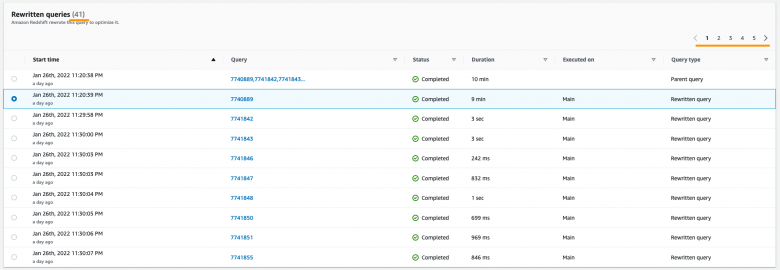
Пример плана запроса: https://gist.github.com/kzzzr/6499510ac7fa0004fd32ed30e1df4541
- Блокировка развития и высокие пороги входа. Новому члену команды потребуется непропорционально много времени, чтобы разобраться в такой кодовой базе. Любые изменения становятся рискованными и требуют многочасового анализа. Это тормозит развитие всей аналитической платформы.
Пример:
У крупного ритейлера отчет о продажах выполнялся 45 минут. Анализ показал, что основной запрос дашборда состоял из 28 CTE. Каждая CTE по отдельности была логична, но вместе они создавали сложнейший граф вычислений. Оптимизатор СУБД не справлялся. Мы разбили монолитный запрос на несколько материализованных представлений (материализованных views или таблиц), организовав четкий конвейер данных. В результате время выполнения отчета сократилось до 3 минут, а нагрузка на базу данных уменьшилась в разы.
Что делать, чтобы избежать подобных ошибок?
Во-первых, используйте принцип «Фильтруй как можно раньше» (Filter Early) - переносите условия фильтрации и агрегации как можно ближе к источнику данных, а не в финальный SELECT. Это drastically сокращает объем данных, которые проходят через всю цепочку преобразований.
Во-вторых, не забывайте о методе “разделяй и властвуй” - вместо одного гигантского запроса с CTE разбейте логику на несколько отдельных материализованных слоев (таблиц или представлений). Это улучшит читаемость, производительность и позволит повторно использовать результаты на разных этапах.
В-третьих, документируйте и визуализируйте - используйте инструменты вроде dbt, который позволяет автоматически строить граф зависимостей (DAG) всех ваших моделей. Это наглядно показывает сложные узлы, которые требуют оптимизации.
В – четвертых, установите лимиты - на уровне код-стайла команды установите правило о максимальном разумном количестве CTE в одном запросе (например, 5-7). Если их больше — это сигнал, что логику нужно пересматривать.
Ошибка №3: Игнорирование принципа DRY (Don't Repeat Yourself) — хаос в метриках и бесконтрольный рост затрат
Принцип DRY — краеугольный камень software development — гласит: «Каждая часть знания должна иметь единственное, непротиворечивое и авторитетное представление within a system». В контексте аналитики это означает, что каждая бизнес-метрика должна рассчитываться в одном месте и только один раз.
В распределенных командах разные аналитики из разных отделов (маркетинг, финансы, операционный менеджмент) решают схожие задачи. Часто они создают свои собственные версии расчета одних и тех же показателей (LTV, CAC, конверсия и т.д.), не зная, что такая логика уже где-то реализована. Возникает «калейдоскопичность» расчетов.
Почему это плохо:
- Разные версии правды — потеря доверия к данным. Это самый разрушительный риск. Когда финансы предоставляют один показатель выручки, а маркетинг — другой, это парализует процесс принятия решений. Руководство перестает доверять данным вообще, и вся ценность вашего DWH сводится на нет. Время уходит не на анализ, а на выяснение, «чья же цифра правильная».
- Неэффективное использование ресурсов. Один и тот же сложный расчет, требующий джойнов нескольких больших таблиц, выполняется десятки раз в разных местах для разных отчетов. Вы платите за одни и те же вычисления снова и снова.
- Невозможность глобальных изменений. Если бизнес решил изменить формулу расчета ключевой метрики, вам придется искать и править ее во всех местах использования. Это длительный, рискованный и дорогой процесс, велик шанс что-то упустить.
- Захламление хранилища устаревшим кодом (Legacy). По нашим оценкам, в среднем до 30% кодовой базы в проектах — это устаревшие, неиспользуемые, но все еще работающие скрипты и витрины. Они создают нагрузку на систему, мешают ориентироваться в актуальных активах и требуют ресурсов на поддержку.
Пример:
В компании-разработчике мобильных приложений мы обнаружили 17 различных определений и реализаций расчета «удержания пользователей» (Retention). Каждое подразделение строило его под свои нужды, часто на разных уровнях данных. Это привело к полной неразберихе в отчетности. Наша задача состояла в том, чтобы определить единое, авторитетное определение Retention, материализовать его в виде централизованного слоя данных (таблицы) и перенастроить все дашборды и отчеты на использование этого единого источника. В результате консолидации не только исчезли разночтения, но и нагрузка на систему снизилась на 40% за счет устранения дублирующих вычислений.
Что делать, чтобы избежать подобных ошибок?
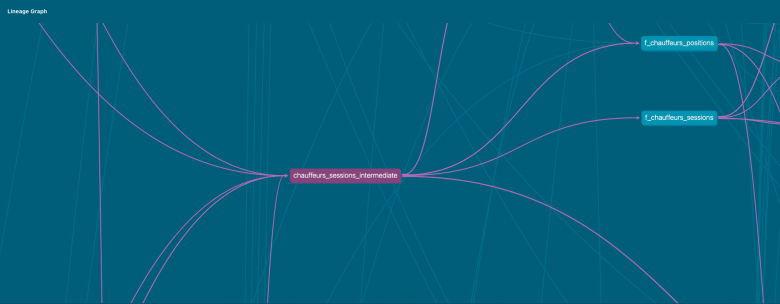
Во-первых, визуализируйте граф зависимостей (DAG) для поиска болевых мест.
Во-вторых, следуйте принципам секционирования хранилища данных.
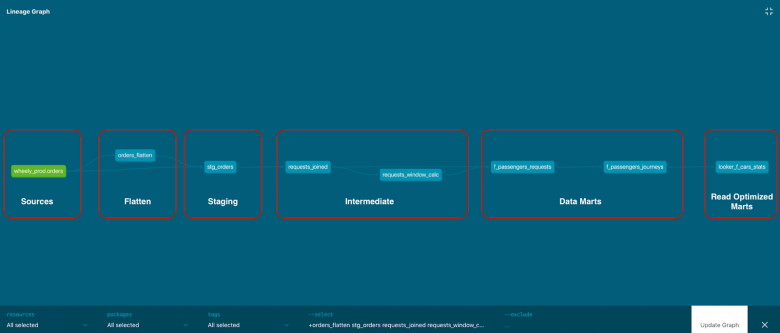
В – третьих, создайте единый слой метрик (Metrics Layer) - выделите и формализуйте расчеты ключевых бизнес-показателей в отдельный, централизованный слой. Это могут быть материализованные таблицы, представления или специализированные инструменты (например, MetricFlow).
В - четвертых, создайте глоссарий данных (Data Catalog), где каждое поле и метрика имеют четкое бизнес-описание, формулу и указание на источник. Инструменты вроде Datahub, Amundsen или dbt docs идеально для этого подходят.
В-пятых, регулярно анализируйте DAG (Directed Acyclic Graph) ваших преобразований. Инструменты вроде dbt или Apache Airflow наглядно показывают, какие модели являются центральными узлами и используются чаще всего. Это точки для потенциальной консолидации.
В - шестых, внедрите процессы «сборки мусора» (Garbage Collection) - регулярно (ежеквартально) проводите аудит ваших данных и кода. Выявляйте и отключайте неиспользуемые таблицы, витрины и отчеты. Это высвобождает ресурсы и упрощает архитектуру.
В целом, все описанные выше проблемы — это не просто технические недочеты. Это системные сбои в процессах разработки и эксплуатации аналитики. Их решение лежит не только в области написания качественного SQL-кода, но и в области внедрения правильной культуры работы с данными (Data Culture), выбора подходящих инструментов и выстраивания эффективных процессов.
Помните, что инвестиции в правильную архитектуру и процессы окупаются многократно: за счет снижения cloud-расходов, увеличения скорости разработки, уменьшения количества инцидентов и, что самое главное, за счет предоставления бизнесу надежных данных для принятия стратегических решений.


