

Сложности в области инженерии данных
Для того чтобы лучше понять паттерны проектирования, а также то, насколько они полезны, нужно знать, с какими проблемами ежедневно стакиваются дата-инженеры. Скажу честно, их очень много...
Жизненный цикл данных
Давайте посмотрим на жизненный цикл инженерии данных и определим, на каком именно этапе люди испытывают больше всего трудностей.
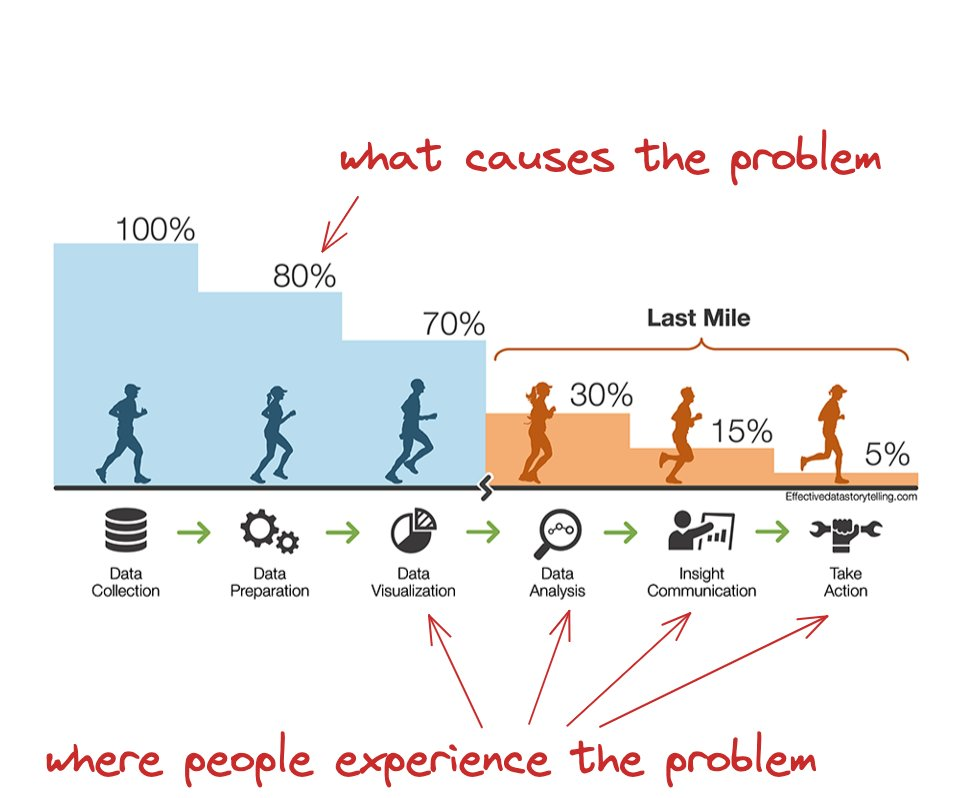
Такую же картину я наблюдал, когда начинал свой путь. Нам постоянно приходилось исправлять ошибки, возникающие при внедрении систем сбора данных, созданных до нас. Каждый день или неделю появлялись непротестированные, непроверенные, а иногда и «нежданные» данные, которые нужно было обрабатывать.
Рисунок 1 отлично иллюстрирует жизненный цикл данных, давайте обсудим каждый его этап подробнее:
Все собранные данные - это те данные, которые, по нашему мнению, необходимы для принятия решений в будущем.
Самая важная часть, а также то, что как раз и вызывает больше всего проблем – это обработка всех полученных данных и уточнение бизнес-требований к данным, которые следовало бы обсудить намного раньше.
Визуализация данных, главным образом, для нетехническим специалистов. В современном мире это могут быть целые наборы данных, поскольку с ними могут работать более подкованные в области данных специалисты (спасибо dbt и другим аналогичным решениям).
На этом можно было бы остановиться, но мы можем углубиться и рассмотреть машинное обучение, а также вычисления с помощью сложных или специализированных инструментов.
Интерпретация данных и правильное донесение полученной информации так же важны, как и все предыдущие шаги.
Вы же знаете, как это обычно бывает: «Мой дашборд показывает неправильное число», «Почему эта агрегация не включает число X», «Блин, мы неправильно прочитали данные» или «к сожалению, мы поторопились с выводами». Иногда нам нужно скорректировать полученные данные, что особенно сложно в условиях работы в режиме реального времени.
Можно ли как-то избавить себя от всего этого?

От рабочего процесса к результату: Пирамида рабочих задач
Мне очень нравится иллюстрация, представленная ниже, на которой мы сравниваем свои рабочие задачи и сопоставляем их с функциями и результатами. Это хорошо увязывается с тем, что мы обсуждаем чуть выше, где инженерия данных была изначально представлена, как функциональная инженерия данных.
В современном мире дата-инженеры выполняют огромное количество задач, каждая из которых называется рабочим продуктом. Обычно мы проектируем снизу вверх:
- Создание инфраструктуры данных: выбор формат хранения данных (база данных, формат таблиц) и принятие решения о том, каким образом мы хотим осуществлять оркестровку (bash, SQL, Python).
- Построение основы данных: моделирование схемы данных, перевод бизнес-логики на SQL/Python, определение слоев базы данных;
- Организация доступа к данным: решение о способе представления данных заинтересованным лицам: дашборд, интерактивные блокноты или простой набор данных и т.д.
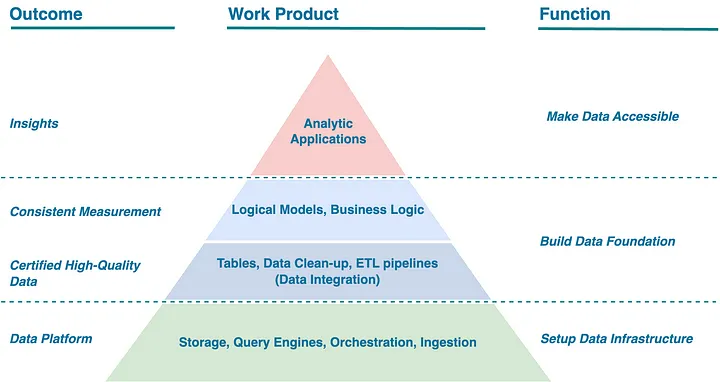
В итоге мы получим ту самую информацию, которую так искали, и все это - благодаря идеально настроенной платформе данных, позволяющей работать с высококачественными данными.
Не усложняйте
Сегодня мы можем выбирать из широкого спектра инструментов, но разумно выбрать небольшое количество, иначе Вы очень сильно усложните себе жизнь. Это очень важно понимать. Кроме того, если Вы располагаете достаточным количеством ресурсов, использование открытого исходного кода защитит Вас от привязки к определенному поставщику, а также позволит свободно вносить любые изменения в платформу данных.
Если с ресурсами или временем у Вас проблемы, то целесообразно выбрать специализированные инструменты, предлагаемые Вашими поставщиками.
Проблемы, характерные для каждого этапа жизненного цикла инженерии данных
Что лежит в основе самых распространенных проблем? Для ответа на этот вопрос предлагаю обратить на еще одну горячо любимою мной иллюстрацию – жизненный цикл инженерии данных.
Для того чтобы понять, какие проблемы существуют в области инженерии данных, нужно посмотреть на инженерию данных в целом. Именно здесь жизненный цикл инженерии данных подходит как нельзя лучше.
Сегодня дата-инженеры контролируют абсолютно весь процесс разработки данных, начиная со сбора данных из различных источников и заканчивая предоставлением полученной информация, которая затем будет использована в других процессах. Для этого им необходимо знание всех этапов жизненного цикла инженерии данных, а также умение объективно оценивать целесообразность использования того или иного инструмента для работы с данными.
Проблемы могут возникать абсолютно на каждом этапе, создавая риски по снижению производительности, скорости, гибкости, масштабируемости, простоту, совместимости и т.д.

Все определения, используемые мной в этом обзоре, включая жизненный цикл инженерии данных, взяты из замечательной книги, написанной Джо и Мэттом под названием Основы инженерии данных . В этой главе я сосредоточусь не на общих определениях, а на проблемах, которые возникают на каждом этапе рассматриваемого нами процесса. Ключевые проблемы каждого этапа жизненного цикла инженерии данных.
Сложности, связанные с генерацией и сбором данных
Данные генерируются в геометрической прогрессии, поскольку их «производит» практически каждое устройство. Слой генерации - это то самое место, где создается огромное количество данных.
Это приложения, веб-сайты и устройства, которые мы используем каждый день. Это наши исходные системы, из которых мы получаем данные, которые затем анализируем. Эти системы очень важны для нас, дата-инженеров, однако, к нашему большому сожалению, мы не можем их контролировать.
Генерация и частота поступления данных зависит от используемого приложения. Это могут быть как приложения, работающие в режиме реального времени и выдающие новые данные каждую минуту, так и более традиционные системы, например, бухгалтерские продукты.
Увеличение объема данных сопряжено со следующей проблемой - найти нужные и действительно ценные данные не так-то просто. Не все данные полезны, а обрабатывать возросший объем информации иногда очень сложно. Нам нужны более мощные серверы или новые подходы. Вот почему мы стали свидетелями беспрецедентного темпа роста таких гигантов облачных технологий, как Amazon, Microsoft и and Google. Подробнее об этом поговорим чуть позже.
Мы, дата-инженеры, как правило, не имеем прямого доступа к исходным продуктам. Мы копируем или, лучше сказать, синхронизируем данные, чем связано несколько проблем. Чтение данных снижает скорость работы серверов, в худшем случае это может привести к ошибке, особенно в том случае, если производство захочет обновить данные, пока мы их читаем. Существует несколько подходов к оперативному чтению этих изменений, например, использование триггеров БД или доступ к данным в ночное время, но об этом мы поговорим в разделе «Интеграция данных».
Другое дело - схема данных, где поля можно добавлять, удалять или даже изменять.
Сложности, связанные с хранением данных
Следующая проблема заключается в том, что после получения данных нам необходимо определиться с тем, где мы будем их хранить - в DWH, Data Lake или в Data Lakehouse.
Хранение очень важно. У нас есть несколько вариантов. Используем ли мы простую реляционную базу данных Postgres или будем хранить данные в более дешевом хранилище S3, но при этом согласимся с более медленным выполнением запросов и более высокими накладными расходами на управление распределенными файлами?
Все это зависит от того, сколько данных есть у нас сейчас и сколько может быть в будущем. Конечно делать прогнозы достаточно сложно, но можно ориентироваться на такое понятие, как 3 V (volume - объем, velocity – скорость и variety - разнообразие), превосходно обобщающее наши проблемы с хранением данных:
- Объем - это огромные объемы данных, которые могут быть получены, например, из мобильных телефонов, социальных сетей, Интренета и т. д.
- Скорость – это скорость, с которой все эти головокружительные объемы данных генерируются, собираются и анализируются.
- Разнообразие - типы данных, начиная от структурированных данных (таких как имена и номера телефонов, которые аккуратно зафиксированы в традиционных БД) и заканчивая неструктурированными данными (такими как изображения, аудиозаписи и обновления в социальных сетях).
Сложности, связанные с приемом данных
Далее следует интеграция или прием данных.
Здесь мы решаем, как получить данные, хранящиеся на нашем уровне хранения. Это может быть простой простого bash-скрипт до сложной платформы ETL (Extract Transform Load) или ELT (Extract Load and Transform). Не обременяйте себя тем, чтобы понять разницу между этими парадигмами, они становятся все более и более похожими.
Я бы определил процесс интеграции (приема) данных следующим образом:
Интеграция данных - это процесс объединения данных из различных систем-источников в единое целое. Это может быть достигнуто с помощью ручной интеграции (скрипты), виртуализации данных или интеграции приложений.
На мой взгляд, интеграция данных (data integration) и поглощение данных (data ingestion) – это по большому счету одно и то же. Хотя есть один нюанс интеграция на один уровень выше, она почти не связана с этапом генерации.
Архитектура и моделирование данных
Именно на этом этапе важную роль играет моделирование данных и разработка продуманной архитектуры данных Вам нужно подумать о том, как дублировать данные и на каком уровне. Как упростить процесс? Чего ожидают Ваши бизнес-пользователи от последнего слоя представления данных? Знают ли они, что такое размерное моделирование?
Каковы сценарии использования данных, которые я получаю? Могу ли я использовать эти данные повторно, а не создавать несколько версий одного и того же набора данных?
Прежде чем начать вводить какие-либо данные, необходимо ответить на такие простые вопросы, как:
- Какие данные следует ввести, а какие - нет?
- Как часто они нужны, например, для ответов на критические бизнес-вопросы?
-
Как мы будем модифицировать уровень хранения? Будем ли мы использовать классическую архитектура DWH совместно с
staging-cleansing-core-mart? - Часто ли меняются исходные данные, есть ли смысл использовать что-то вроде Data Vault или какой-либо другой подход?
- В каком формате чаще всего поступают данные (например, полуструктурированные или неструктурированные)? Может ли мой уровень хранения справиться с ними (или файлы Parquet не могут быть напрямую интегрированы в MySQL)?
- Мы получаем данные из реляционной базы данных, API или экспортированных файлов?
- Кто является пользователями и заинтересованными сторонами, которые будут использовать наш продукт данных?
Все эти вопросы в значительной степени связаны со слоем трансформации или даже обслуживания данных. Давайте еще раз вспомним основу жизненного цикла данных, прежде чем мы погрузимся в следующие два слоя:
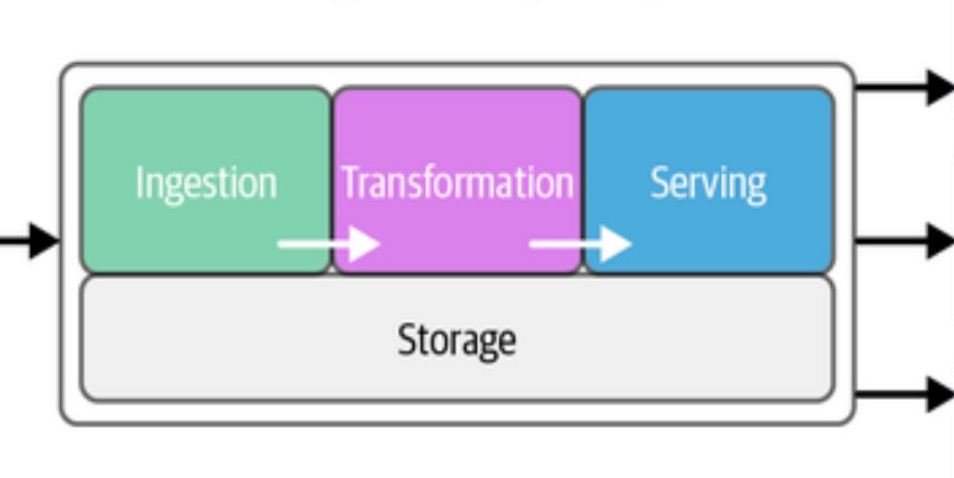
Правильные вопросы и знание домена
Иногда эти вопросы сложно задать заранее, а иногда гораздо проще посоветоваться с экспертами по домену. В любом случае, чем лучше дата-инженер понимает поставленную перед ним задачу и ожидания заинтересованных сторон, тем лучше будет конечный результат его работы.
Сложности, связанные с преобразованием данных
Теперь перейдем к части, представляющей огромный интересов для дата- инженеров, а именно - к автоматизации бизнес-логики Excel с помощью SQL или Python.
Это, пожалуй, самая важная часть, поскольку слой трансформации - это то место, где бизнес-логика внедряется в код. Чем лучше Вы это сделаете, тем точнее в обслуживающем слое будут цифры, тем меньше будут сопутствующие расходы.
Одна из основных проблем на данной стадии заключается в обновление бизнес-логики. Логика должна пересматриваться по мере изменения потребностей бизнеса. Понимание и обновление бизнес-логики часто требует длительных обсуждений, встреч и глубокого понимания бизнес-процессов.
Еще один аспект, который нужно учесть – выбрать наиболее оптимальный продукт из всего многообразия доступных решений крайне сложно.
Вечный вопрос: сохранять ли данные или определить их логически и сохранять по требованию? Нужно ли создавать OLAP – кубы, обеспечивающие субсекундные ответы на запросы? Или нас вполне устраивают более медленные ответы на запросы?
Вариантов много, и понять, что лучше, заранее бывает не так просто, как хотелось бы. Здесь также пригодится моделирование данных или архитектуры, о которых мы говорили ранее. Если Вы не постараетесь продумать все заранее, вполне возможно, что в определенный момент Вам придется как следует раскошелиться, поскольку какие-то операции нужно будет делать по нескольку раз.
Сложности, связанные с обслуживанием данных
Слой обслуживания является самым важным - не для дата-инженеров, а для клиентов и сотрудников, использующих наши данные. Именно здесь мы «продаем» нашу работу. У Вас могут быть самые лучшие обновленные и очищенные данные, но они никому не интересны, если Вы не можете их презентовать и подобрать нужные графики.
Поэтому очень важно рассказать историю о своих данных. Сделайте так, чтобы люди поняли, откуда взяты исходные данные, как Вы их агрегировали и какие выводы сделали. Если людям это понравится, Вы - в дамках.
Во-первых, Вы должны выбрать формат, подходящий той или иной категории конечных пользователей. Что это – крутой дашборд, блокнот, набор данных или даже приложение? Или Вам нужен экспорт в Excel? Или аналитический API для data scientistов?
Кроме того, с самого начала убедитесь в том, что архитектура и моделирование слоя трансформации полностью соответствуют требованиям выбранного инструмента. Могут ли они работать с фактами и измерениями или им нужна одна большая таблица или реляционные таблицы?
Наглядное и эффектное представление KPI и метрик – залог успеха.
Дополнительные нюансы
Помимо основных этапов жизненного цикла инженерии данных и связанных с ними сложностями есть еще некоторые нюансы, которые вполне можно назвать подводными камнями: это безопасность и конфиденциальность данных, управление ими, DataOps, архитектура данных, оркестровка, разработка ПО и т.д
Сложности, связанные с оркестрацией рабочих процессов
При использовании технологий оркестрации часто приходится управлять промежуточными этапами, такими как подготовка, разделение, очистка и копирование данных между системами или форматами. Это особенно актуально для неструктурированных данных, которые впоследствии должны быть структурированы.
Инструменты оркестрации должны точно моделировать зависимости между вычислениями и вызывать их в нужное время. Это предполагает глубокое понимание последовательности и условий, при которых должны выполняться различные задачи с данными. Для определения зависимостей данных дата-инженеры очень часто используют такие языки, как Python.
Также очень важно следить за тем, какие вычисления были выполнены, а какие – нет, а также управлять ошибками. Поскольку оркестровщики могут устанавливать контрольные точки качества данных, они должны четко определять, когда что-то идет не так, и понимать, как можно эти ошибки исправить.
Инструменты, используемые для оркестрациии, проделали длинный путь от базовых планировщиков задач, таких как cron, до современных оркестраторов, интегрированных с Modern Data Stack. Эта эволюция отражает переход от фокусировки исключительно на задачах к более целостному подходу, включающему активы данных и сложные рабочие процессы.
Выбор инструмента оркестровки имеет решающее значение. То же самое касается и того, на каком языке программирования будет работать выбранные Вами инструменты. Прежде всего, они должны обеспечивать эффективное управление метаданными для мониторинга и автоматизации, а также быть открытыми. В конце концов, они должны быть интегрированы в весь жизненный цикл инженерии данных.
Итак, основные задачи инструментов оркестрации:
- Управление сложностью процессов: упрощение управления сложными системами, обеспечение бесперебойного потока данных и интеграции процессов.
- Работа с гетерогенными архитектурами: при использовании разнообразных инструментов работы с данными инструменты оркестрации должны эффективно управлять и интегрировать эти гетерогенные системы, обеспечивая стабильную работу консолидированной платформы для работы с данными.
- Высокое качество данных и работа над ошибками: постоянное устранение ошибок в данных, реагирование на новые данные, поддержание качества и целостности данных, а также адаптация к происходящим изменениям;
- Data Governance: обеспечение соответствия и соблюдение политик управления данными, помощь в разрешении сложностей использования данных с точки зрения закона и этики.
- Современные инструменты оркестрации играют важную роль в решении сложнейших задача сегодняшней инженерии данных. Это не просто инструменты для планирования и управления рабочими процессами, это самые настоящие комплексные решения, отвечающие всем требованиям жизненного цикла данных.
Сложности, связанные программной инженерией
Исторически сложилось так, что инженерия данных выросла из администрирования баз данных и бизнес-аналитики. Это больше похоже на предоставление пошаговых инструкций, чем на векторы, ведущие к созданию объектно-ориентированной базы кода с возможностью многократного использования.
С развитием инженерии данных появилось большое количество паттернов программной инженерии, таких как git-интеграция, Python и тестируемость с помощью модульных тестов.
Различия между инженерией данных и программной инженерией
Существенное различие между инженерией и программной инженерией заключается в отсутствии контроля над данными. Как инженер-программист, Вы можете контролировать то, какие данные Вы получаете, Вы можете компилировать и тестировать все, что угодно.
В инженерии данных все наоборот. Мы начинаем с данных, которые не можем контролировать, и переходим к контролю на более высоких уровнях.
В сравнении с программной инженерией инженерия данных является более динамичной областью. Несмотря на тенденцию к более высокоуровневым абстракциям, необходимость написания и работы с основным кодом обработки данных в таких фреймворках, как Spark или SQL, сохраняется на протяжении всего жизненного цикла инженерии данных. Владение этими навыками важно абсолютно на каждом этапе работы с данными - от сбора данных до их преобразования и предоставления конечным пользователям.
Еще один важный аспект - развитие фреймворков с открытым исходным кодом. Дата-инженеры не просто перенимают эти инструменты, но и активно участвуют в их создании. Этот непрерывный процесс инноваций, как видно на примере эволюции популярных инструментов, требует глубокой вовлеченности в открытый исходный код и понимания долгосрочных последствий внедрения инструментов.
При обработке потоковых данных дата-инженеры сталкиваются с задачами в области разработки ПО. Переход от пакетной обработки к обработке в режиме реального времени требует детального подхода к таким задачам, как объединение и создание окон. Мастерство работы с различными платформами, включая функциональные платформы, такие как AWS Lambda, или специализированные потоковые процессоры, такие как Spark, Flink и другие, становится решающим фактором успеха дата-инженера.
Очень часто эти специалисты занимаются решением задач общего назначения. Они сталкиваются с уникальными сценариями, требующими индивидуальных решений, выходящих за рамки конкретных инструментов и фреймворков. Будь то разработка новых коннекторов для источников данных или обработка сложных преобразований данных, очень важно уметь применять принципы программной инженерии.
Ко всему этому добавляется необходимость следить за появлением новых языков программирования, не отставать от Python, Scala, Java, SQL и Rust. Каждый язык обладает своими уникальными свойствами: Python отличается простотой использования, Scala - функциональным подходом, Java - корпоративной надежностью, SQL - ориентацией на базы данных, а Rust – высокой безопасностью и производительностью.
Пересечение инженерии данных и программной инженерии создает многогранную область работы с данными. Возникающие при этом проблемы требуют глубоких технических знаний, навыков стратегического прогнозирования и способности к адаптации к постоянно изменяющимся условиям.
Сложности, связанные с безопасностью данных
С каждым днем безопасность данных становится все более и более важной. Особенно для нас, дата-инженеров, ведь именно мы следим за тем, чтобы не было никаких утечек информации.
В этом плане наша задача состоит в том, чтобы защитить данные с помощью последних технологий и методик в области безопасности. По сути, мы должны опережать хакеров и при этом полагаться на самые последние инновации.
Баланс между безопасностью и инновациями очень тонок. Без инноваций нет продукта. А без соблюдения мер безопасности нет надежного проекта.
Сложности, связанные с управлением данными
Проблемы управления данными тесно пересекаются с проблемами оркестровки. Почему? Потому что очень часто оркестрация занимается сквозным управлением данными с возможностью их обнаружения, в частности, с их историей.
Еще одно пересечение в моделировании данных происходит на уровне преобразования данных.
Задача управления данными заключается в том, чтобы сосредоточиться на работе и жизненном цикле данных в целом.
Основные проблемы в области управления данными, с которыми мы сталкиваемся ежедневно:
- Хранение и операции: Баланс между масштабируемостью и рентабельностью имеет решающее значение для хранения значительных объемов данных при обеспечении быстрого и надежного доступа к ним.
- Управление жизненным циклом данных: Эффективное управление данными с момента их создания до удаления, обеспечение их актуальности, точности и соответствия политикам хранения.
- Этика и конфиденциальность данных: Защита конфиденциальных данных и соблюдение изменяющихся нормативных требований - важнейшие условия для поддержания доверия к данным.
- Обнаружение данных: Чем больше у нас данных, тем сложнее найти нужные и наиболее актуальные данные. Именно здесь на помощь приходят каталоги данных.
Сложности, связанные с DataOps
DataOps – понятие многогранное, тесно пересекающееся с Agile, lean, DevOps и продуктовым мышлением.
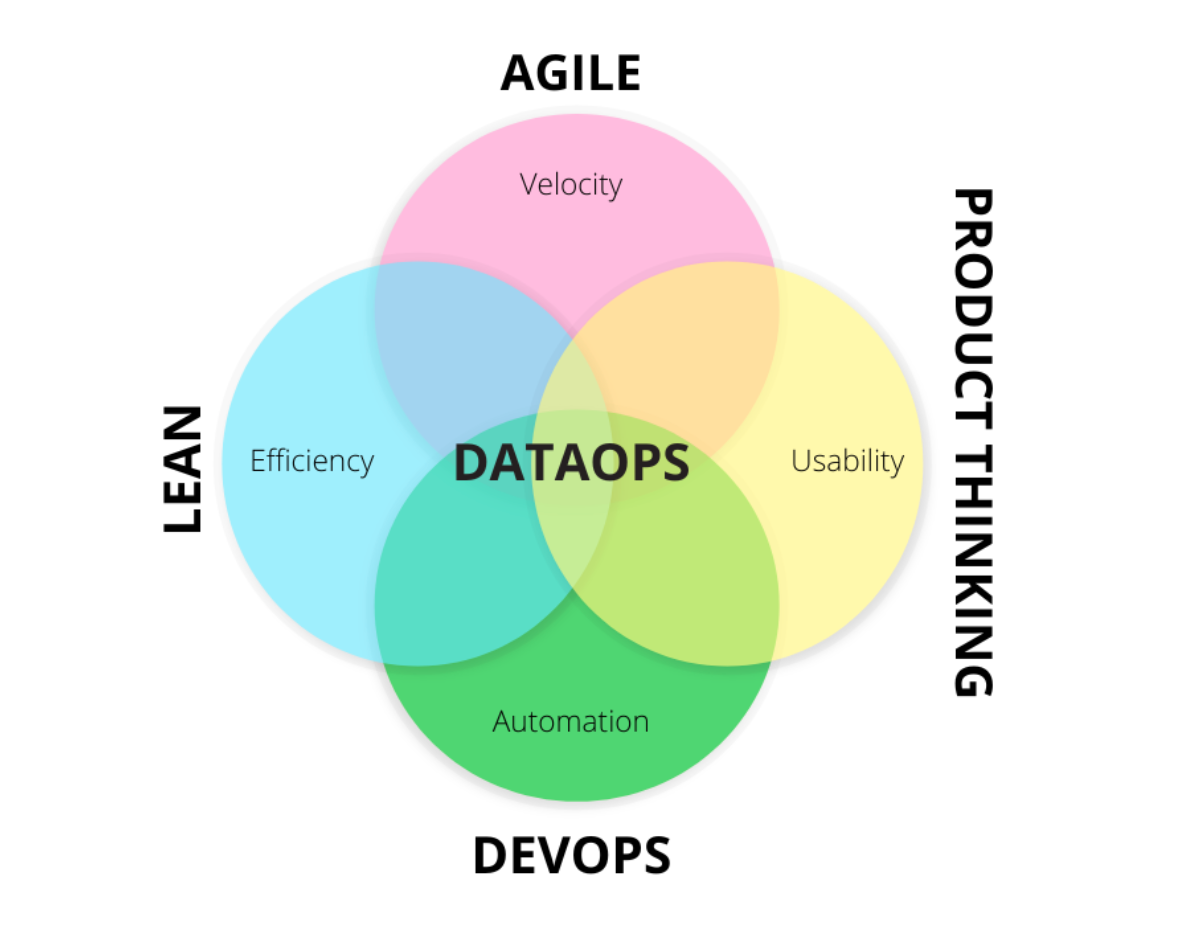
Здесь очень важно понимать отличие от DevOps: DevOps нацелен на улучшение качества программных продуктов, а DataOps – на улучшение продукта инженерии данных.
Все большую важность приобретает инфраструктура как код (IaC), что связано с требованиями повышения скорости, эффективности и автоматизации процессов. По мере того как инструментарий с открытым исходным кодом и облачные среды становятся чем-то само собой разумеющимся, дата-инженеры начинают использовать фреймворки IaC для эффективного развертывания и управления инфраструктурой.
Облачные сервисы, контейнеризация и такие инструменты, как Kubernetes и Helm, - интеграция всех этих элементов в практику DataOps требует глубокого понимания практики DataOps. Хотя такая автоматизация крайне важна, ее применение сопряжено с определенными трудностями. Она требует включения различных инструментов и процессов и их адаптации к существующим решениям. Обеспечение согласованности и надежности данных с помощью автоматизации в такой динамичной среде – задача действительно сложная.
DataOps - это еще и люди. В этом смысле очень важно внедрять и поддерживать культуру сотрудничества и постоянного совершенствования. Этот сдвиг в менталитете необходим, но требует изменения устоявшихся представлений и практики (опять же, задача непростая). Команды должны принять принципы гибкости и бережливости, что зачастую требует значительных организационных изменений.
Достижение эффективной наблюдаемости и мониторинга представляет собой еще одну проблему. DataOps требует проактивного подхода к мониторингу качества данных и производительности системы. Однако создать систем, которая позволит получать информацию в режиме реального времени, не перегружая при этом команду ложными сигналами тревоги, совсем непросто.
Сложности, связанные с архитектурой инженерии данных
Ранее мы уже обсуждали важность архитектуры инженерии данных и моделирования данных. Они важны для всего, что делает дата-инженер, особенно на начальном этапе.
Сложность, очевидно, заключается в том, что Вы должны иметь большой опыт в области создания платформ или решений для инженерии данных; в лучшем случае в Вашей команде должен быть сильный архитектор данных.
Также очень важно предварительно проработать архитектуру, только не переусердствуйте, поскольку это может помешать Вам создать POC.
Ниже приведена отличная иллюстрация архитектуры инженерии данных, отражающая всю сложность процесса проектирования платформы данных со множеством постоянно изменяющихся компонентов.
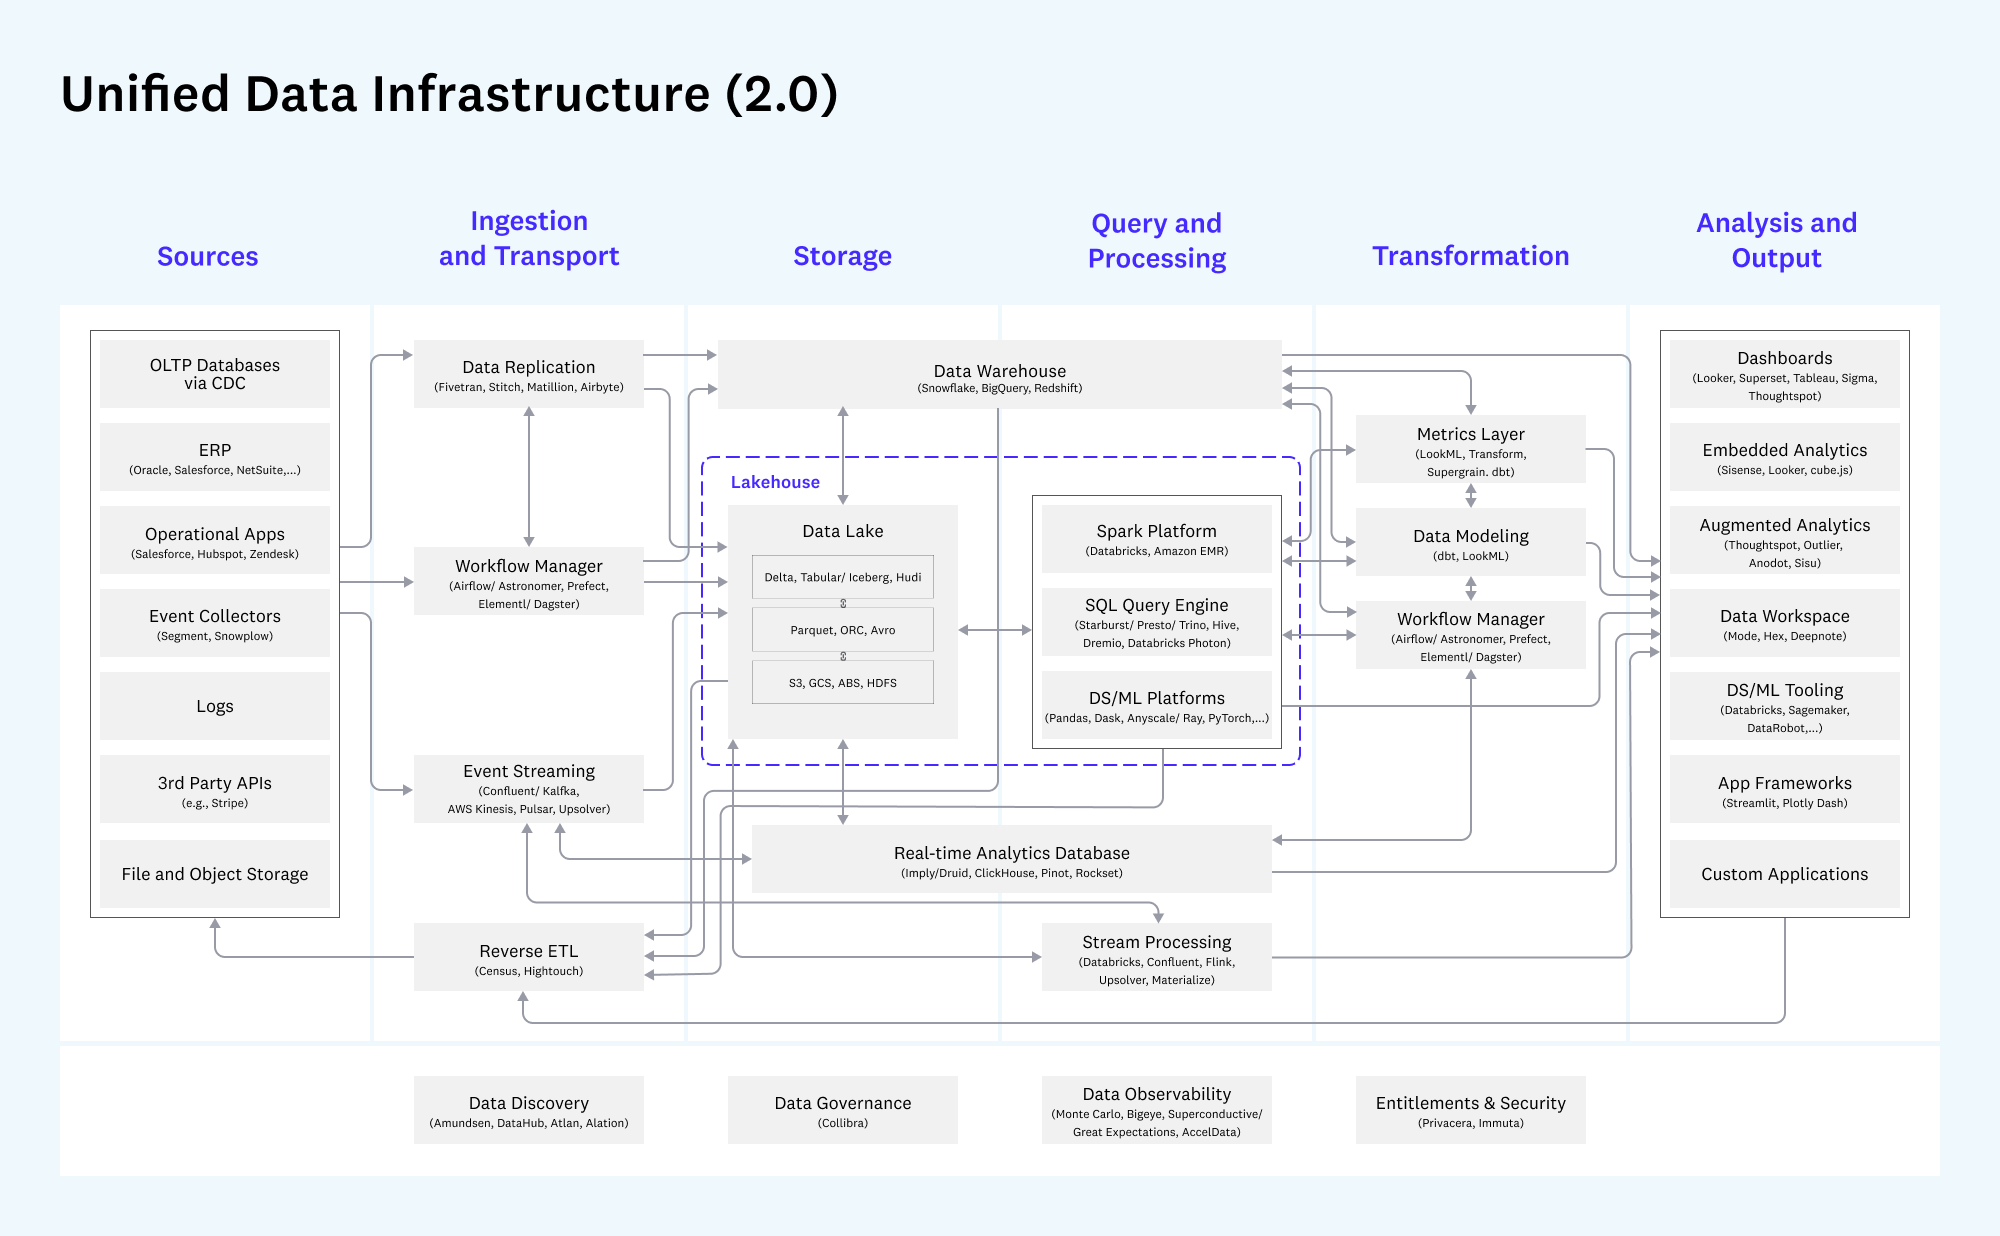
Кроме того, постоянно меняются и сами архитектуры данных. Поэтому крайне важно быть в курсе последних изменений и, как вариант, знать отличия новых архитектурных принципов от старых.
Проблемы, с которыми сталкивалась BI на протяжении всей своей истории развития
Прежде чем завершить эту главу, давайте вспомним о задачах бизнес-аналитики из которой впоследствии и выросла инженерия данных. Это поможет нам спрогнозировать будущие задачи изучаемой нами области.
У BI есть ряд существенных проблем, связанных со скоростью и прозрачностью процессов. Ниже приведен краткий обзор сложностей, с которыми сталкивался лично я или мои коллеги:
- Интеграция дополнительных источников занимает слишком много времени, а инженеры BI и без того перегружены работой. Это одна из причин, по которой в каждом отделе создаются «силосы» данных, а также разрозненные электронные таблицы Excel, которые постоянно устаревают. Низкая скорость работы – явление неприятное, которое можно устранить с помощью автоматизации хранилищ данных (DWA).
- Прозрачность процессов - проблема для пользователей, не являющихся инженерами BI. Только они могут видеть логику преобразования, которая в основном скрыта в проприетарных инструментах ETL.
- Бизнесмены или менеджеры зависят от BI-инженеров, они не могут самостоятельно получить доступ к ETL или извлечь нужные им данные в режиме реального времени.
- Сложности в работе с (полу)неструктурированными форматами данных, такими как JSON, изображения, аудио, видео, электронные письма, документы и т. д. Нарезка кубиками производится на агрегированных данных, в то время как неструктурированные данные, как описано выше, могут работать гораздо эффективнее. Кроме того, эти неструктурированные данные еще больше растягивают ночные задания ETL, поскольку их обработка занимает слишком больше времени.
- Общие данные доступны только раз в день (традиционно). Сегодня мы все получаем в режиме реального времени, того же самого мы требуем и от современных BI-систем.
Заключение
Итак, очевидно, что в области инженерии данных есть сотни проблем. Надеемся, что предложенный нами вариант их классификации в зависимости от этапа жизненного цикла инженерии данных, с которым они связаны, Вам понравится. Осознание всех этих сложностей поможет Вам лучше понять последующие главы, посвященные паттернам проектирования и лучшим практикам в изучаемой нами области.


