

Требования к данным для эффективного SIEM
Цель данной главы — познакомить нового сотрудника с тем, какие требования к данным необходимы для эффективной работы SIEM в связке с BI и DWH. SIEM (Security Information and Event Management) решает задачу объединения, нормализации и анализа больших массивов событий и логов из разных источников. В контексте курса «Использование BI и DWH при внедрении SIEM-системы» мы опираемся на принципы бизнес-аналитики и управления данными: какие данные нужны, как их собирать, хранить, обогащать и использовать для обнаружения угроз, реагирования и аудита. Важно помнить: данные — это не просто логи. Это последовательность фактов, связанных между собой по времени, источнику, формату и контексту. Как в Data Warehouse, так и в BI, мы строим единое единичное дерево данных, которое позволяет не только увидеть инциденты, но и проследить их влияние на бизнес-процессы, финансовые риски и операционную устойчивость.
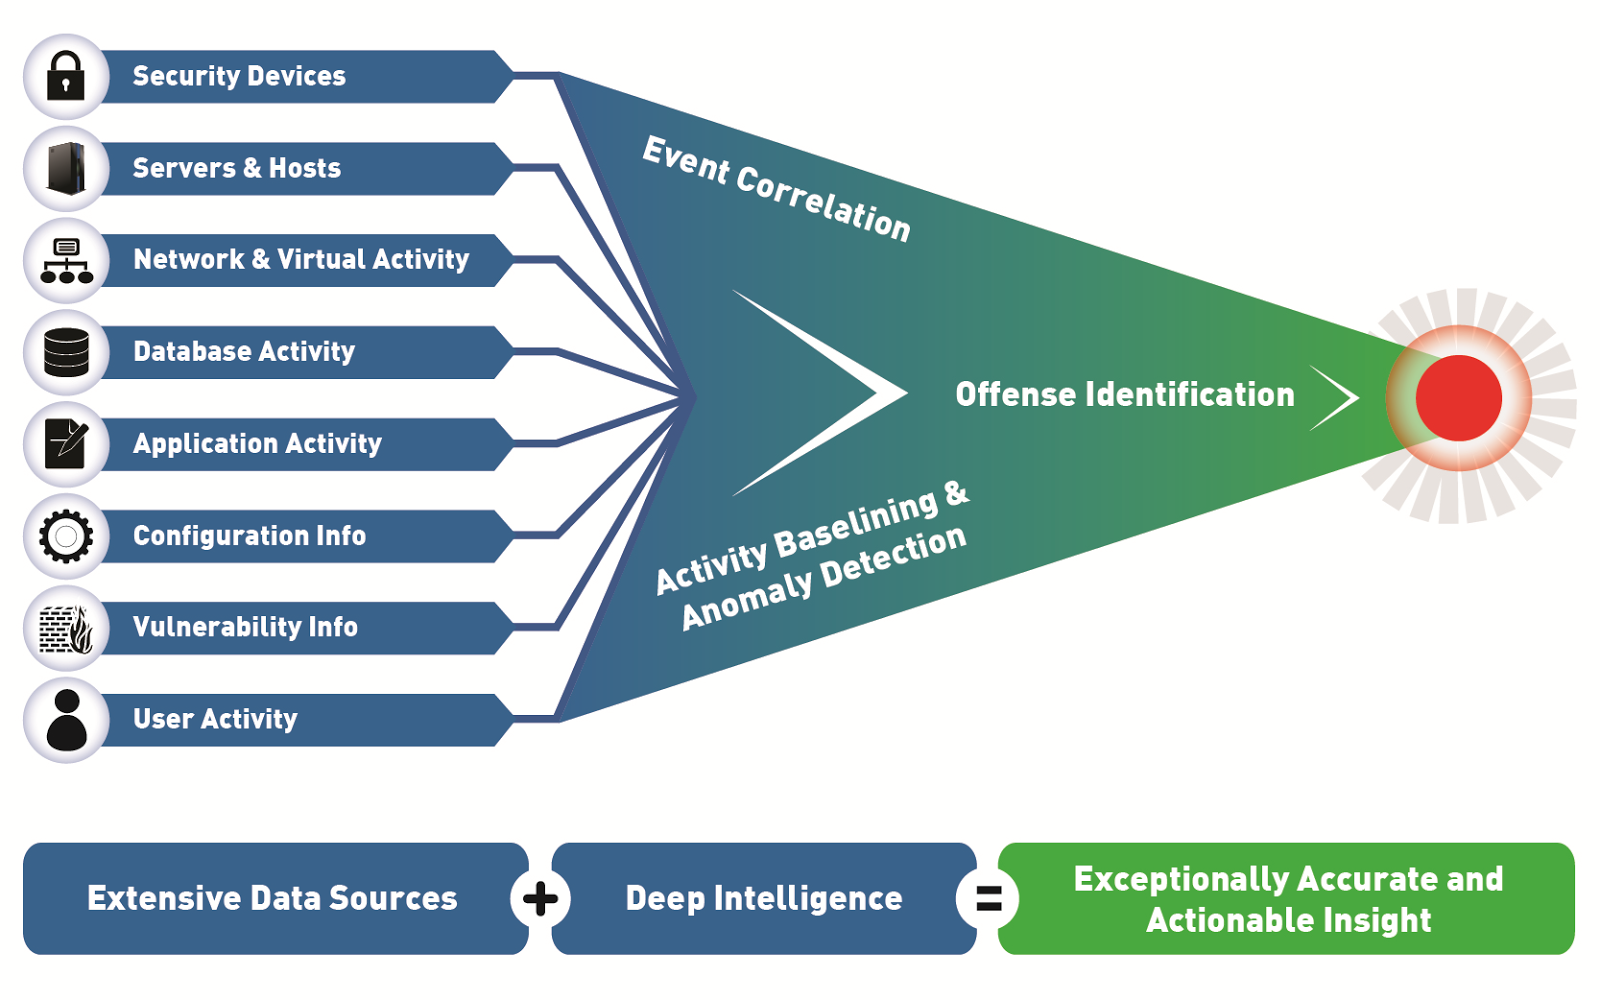
Термины и базовые понятия
- Источник данных (log source) — устройство, приложение или сервис, который генерирует события: сетевые устройства, сервера, базы данных, облачные сервисы, офисные приложения, средства защиты, пользовательские рабочие станции и т. д. В SIEM нас очень интересуют не только сами логи, но и контекст: кто что сделал, где и когда.
- Сообщение (event) и запись лога (log entry) — структурированная или полуструктурированная единица информации, обычно сопровождающаяся временной меткой, идентификатором источника и набором полей (уровень, уровень важности, сообщение об ошибке, IP-адрес, имя пользователя и пр.).
- Нормализация и единая модель данных — процесс приведения разнообразных форматов логов к единой схеме: одного набора полей, типов данных и правил заполнения. Это ключ к эффективной корреляции и анализу в BI/DWH.
- Форматы данных — стандартизированные способы представления логов: Syslog, JSON, XML, CEF (Common Event Format), LEEF (Log Event Extended Format) и др. Нормализация часто включает преобразование в один из стандартов или гибридную схему.
- МЕТРИКИ качества данных (data quality) — набор показателей, которые позволяют оценивать пригодность данных для анализа: полнота (целостность полей), точность (соответствие истине), своевременность (своевременность поступления), непротиворечивость (консистентность между полями), уникальность и корректность форматов.
- Модель данных для SIEM — обычно включает поля источника, временную метку, пользователя, хоста, события, типы угроз, коды событий, контекстные поля для обогащения (геолокация, репутация IP, контекст из TI и т. п.).
- Обогащение данных (data enrichment) — добавление дополнительной информации к сырым событиям: контекст по атакам, контекст по пользователю, данные TI (Threat Intelligence), данные об инфраструктуре и бизнес-утверждениях (кого в компании затрагивает данное событие).
- Корреляция и детекция — процессы определения связи между событиями и их совместного анализа, дающие предположения об угрозах (например, последовательность неудачных входов, затем успешный вход с нового IP и доступ к конфиденциальной папке).
- Выгрузка в BI/DWH — шаг после первичной агрегации и нормализации, когда данные становятся доступными для бизнес-аналитики, отчётности и долговременного хранение.
- Гигиена данных и хранение — правила очистки, удаления устаревших данных, архивирование, хранение в географически регулируемых локациях, соответствие требованиям локального законодательства и отраслевых регламентов (практика важна в РФ и международных проектах).
- Тайм-синхронизация и временная зона — критически важно для корреляции событий. Разные источники могут синхронизировать время по разным часовым поясам; SIEM должен унифицировать временные метки (обычно в UTC) и уметь корректно обрабатывать задержки поступления.
- Архитектура хранения данных — в SIEM мы обычно разделяем «горячие» (hot) данные для быстрой аналитики и активного расследования, «теплые» (warm) данные для менее частого доступа и «холодные» (cold) данные, которые архивируются и хранятся экономично, но доступны по требованию.
- Соответствие и приватность (privacy) — сбор и хранение персональных данных подчинено законам: GDPR, локальному законодательству РФ, политике компании. Важно предусмотреть минимизацию данных и защиту PII в рамках SIEM-потоков.
Методологии и подходы к сбору данных
- Привязка к бизнес-процессам — данные для SIEM должны быть выбраны на основании критичных бизнес-процессов и регламентов комплаенса. Это помогает снизить шум и сделать корреляции более информативными.
- Модель угроз и атрибутика — на этапе проектирования данных важно определить, какие угрозы и техники будут детектироваться, какие поля и контекст потребуются для идентификации техник MITRE ATT&CK и сопутствующих действий злоумышленников.
- Стратегия на уровне источников данных — план onboarding источников: какие поля необходимы, какой формат должен быть, какие политики сохранения и какие правила обогащения будут применяться.
- Фреймворк качества данных — определить набор проверок: есть ли ключевые поля, корректные таймстемпы, нет ли дублирования, корректно ли валидируются значения (например, IP-адреса или UUID).
- Где и как хранить данные, чтобы поддержать BI/DWH — стратегически важно решить, какие данные будут храниться в SIEM-индексах, какие передаваться в DWH (ETL/ELT), какие будут обогащены и агрегированы на уровне SIEM или BI-платформы.
- Онбординг и трансформация — процесс автоматизации сбора, конвейеры ETL/ELT, нормализация, создание «гидонов» полей для сопоставления с бизнес-объектами.
- Метрики и KPI — мониторинг задержек инъякции, пропорции потерь событий, точность детекции, доля коррелируемых инцидентов, время обнаружения и время реакции.
Практические примеры (open-source и отечественные решения)
Применение концепций на реальных примерах помогает закрепить теорию. Ниже даны типовые сценарии, которые применяются на практике.
Пример 1. Интеграция Windows-серверов через Winlogbeat и Elastic Stack
Контекст: крупная компания имеет множество Windows-серверов и AD-инфраструктуру. Требуется сбор аудита входов и административных действий.
Что делаем:
- Устанавливаем Winlogbeat на серверах, настраиваем отправку через Syslog или напрямую в Elasticsearch.
- В SIEM создаём конвейер нормализации: поля user.name, event.level, event.code, source.ip, outcome, статус аутентификации и т. д. Применяем правила корреляции: несколько неудачных попыток входа в короткий промежуток времени, затем успешный вход в новый час с другого IP.
- Обогащение: добавляем данные TI по IP-адресам, геолокацию, информацию об устройстве и приложении, контекст по пользователю из корпоративной LDAP/AD.
- Соответствие: данные хранятся в холодных сегментах через архивирование после 90 дней, с автоматическим экспортом в DWH для долгосрочной аналитики.
- В BI-платформе строим дашборды по потоку аутентификаций, инцидентам и бизнес-рискам (например, попытки доступа к финансовым системам вне рабочего времени).
Техническая деталь: формат логов Windows Event Log конвертируется в JSON через Logstash/Winlogbeat, поля маппируются в единую схему: timestamp, source, host, user, event_id, action, outcome, additional_context. В ОУ НТФ или локальной инфраструктуре это может быть реализовано через Kafka как транспорт, чтобы обеспечить масштабируемость.
Пример 2. Логирование сетевого оборудования и облачных сервисов через CEF/JSON
Контекст: сеть многоуровневая: маршрутизаторы, FW, VPN, облачные сервисы (SaaS, IaaS). Нужно централизованное хранение и корреляция.
Что делаем:
- Настраиваем сетевые устройства на отправку логов в формате Syslog/CEF или через агент, который конвертирует в единый формат.
- В SIEM создаём карту полей CEF/JSON к нашей единичной схеме: для каждого события фиксируем поля пристани (source, destination, RSSI, URI, action, method), временную метку, источник.
- Обогащение: добавляем данные TI по IP, контекст по доменам, геолокацию и известные черные списки.
- В BI создаём отчеты по уровню безопасности сети: количество инцидентов по сегментам, выявление необычных паттернов доступа, связи с внешними источниками угроз.
- Хранение: индексация по времени, хранение самых «горячих» данных в быстрых индексациях, архивирование старых данных.
Техническая деталь: примеры открытых решений — Elastic Stack, Graylog, Wazuh — поддерживают ingestion из Syslog/CEF/JSON. В России можно рассмотреть варианты интеграции отечественных систем мониторинга через стандартные интерфейсы и локальные дата-центры, обеспечивающие соответствие требованиям локального законодательства.
Пример 3. Интеграция TI и SIEM для ускорения расследований
Контекст: нужно быстрее распознавать новые техники атак и соответствующим образом фильтровать события.
Что делаем:
- Подключаем TI-платформу (Threat Intelligence Platform) — например, открытое решение совместное с SIEM и/или коммерческий продукт. TI-платформа предоставляет индикаторы компрометаций (IOC), контекст по атакам и данные по вредоносным доменам/IP.
- Коррелируем IOC с поступающими событиями SIEM: если IP в логе совпадает с IOC, автоматически создаём тревогу с указаниемированной техники атаки (MITRE ATT&CK).
- Обогащаем логи по атаке дополнительными полями, такими как вероятность, источник IOC и примерную технику атаки.
- В BI-слое формируем дашборды, показывающие связь между инцидентами, TI-данными и бизнес-объектами (пользователь, сервис, дата).
Примечание: TI-платформы обычно работают как источник дополнительных полей или как внешний источник, который SIEM периодически опрашивает для обновления контекстов.
Пример 4. Локализация хранения и соответствие требованиям — российские решения и интеграции
Контекст: крупная организация обязана хранить данные внутри территории РФ и соблюдать требования к локализации.
Что делаем:
- Размещаем данные в локальных дата-центрах и используем гибридную архитектуру: «горячие» данные в локальном SIEM, «холодные» данные архивируются в изолированной среде внутри страны.
- Подключаем отечественные интеграционные решения и сервисы, обеспечивающие соответствие требованиям к конфиденциальности и хранению данных.
- Обеспечиваем аудит доступа к данным и журналам, внедряем процессы управления данными и хранения.
Практическая заметка: отечественные решения часто предоставляют локальные версии агентов, устойчивые к специфическим регуляторным требованиям и интеграцию через официальные каналы поддержки. В сочетании с открытым стеком это позволяет выстроить гибкую и устойчивую архитектуру.
Форматы данных и нормализация
- Syslog (RFC 5424) — стандарт для сетевых устройств; хорошо подходит для транспортировки больших объёмов логов, но часто требует последующей нормализации.
- JSON — удобен для структурированных сервисов и облачных платформ; позволяет хранить вложенные данные, но требует схемы и валидаторов.
- CEF/LEEF — форматы, специально созданные для унификации полей в SIEM; часто встречаются в корпоративных устройствах безопасности и коммерческих логах.
- База имен полей (schema) — единая схема SIEM, включающая: timestamp, source, host, event_type, event_id, user, src_ip, dst_ip, src_port, dst_port, protocol, action, outcome, severity, enrichment_fields.
- Нормализация — на этапе ETL/ELT мы приводим поля к единым именам и типам данных, применяем конверсию форматов (например, timestamp к UTC), валидируем значения (IP-адреса, коды ошибок, UUID).
Пути ingestion и технологии конвейера
- Агентные подходы — Winlogbeat, Filebeat, Metricbeat и т. п. позволяют собирать логи с серверов и рабочих станций, отправлять их в SIEM через Logstash/OpenSearch/Splunkforwarder и т. д.
- Серверные конвейеры — Logstash, Fluentd, FluentBit, NiFi, которые превращают сырые логи в единый формат и отправляют в хранилище.
- Транспорт и брокеры — Apache Kafka или RabbitMQ для буферизации и масштабирования. Использование Kafka помогает decouple источников и обработчиков и обеспечивает устойчивость к пиковым нагрузкам.
- Хранение и индексация — Elasticsearch/OpenSearch, Splunk, Graylog. Для BI/DWH часто база данных SIEM не хранится forever; часть данных реплицируется в DWH (напр., PostgreSQL, Snowflake, ClickHouse, Oracle) для долгосрочной аналитики и регуляторной отчетности.
- Обогащение и TI — внешние (и внутренние) TI-источники, господдержка TI-датчиков, данные Active Directory/LDAP, геолокация IP, бизнес-метаданные и т. д.
Архитектура и хранение
- Дорожная карта хранения — горячие данные (для детекции и расследования) хранятся в быстродоступных индексах SIEM; теплые — в меньшей скорости, но с доступом; холодные — архивы для аудита и регуляторной отчетности.
- Индексирование по времени — важно для быстрого поиска по временным окнам. Разделение по дням/неделям обычно помогает ускорить запросы и снизить нагрузку.
- Нормализация на уровне данных — создаём единый словарь полей, что позволяет быстро консолидировать данные из разных источников и упрощает BI-отчеты.
Методики обеспечения качества и целостности данных
- Валидация входящих данных — валидируем обязательные поля, форматы, уникальность записей и диапазоны значений.
- Контроль дубликатов — удаление повторной передачи событий или агрессивное агрегирование повторяющихся сообщений.
- Управление несогласованностью — мониторинг и устранение несовпадений в полях (например, несовпадение IP-адресов между источниками).
- Логгирование изменений схемы — хранение версий схемы и регламент обновления, чтобы не потерять совместимость.
- Политики retention и архивирования — определение срока хранения в зависимости от типа данных и регуляторных требований; автоматизация архивации и восстановления.
Безопасность и приватность данных
- Минимизация данных — сбор только тех полей, которые необходимы для детекции и расследования; избегаем записи лишних персональных данных.
- Шифрование и доступ — шифрование в покое и при передаче; строгие политики доступа, аудит доступа к данным SIEM.
- Права доступа и сегментация — разделяем доступ к данным между командами (SOC, тесно связанные бизнес-подразделения, аудит); применяем least privilege.
- Соответствие требованиям — РФ, GDPR, локальные регуляции; внедряем процедуры по уведомлениям и отчётности при инцидентах.
Риски и ограничения внедрения
- Объем данных и шум — SIEM подвержен риску «шума» и ложных срабатываний при большом объёме данных. Важно продумать фильтры на входе, обеспечить релевантность источников и настройку порогов.
- Динамика угроз — новые техники атак требуют обновления правил корреляции и TI. Требуется цикл обновления контура правил и схем анализа.
- Задержки и задержка доступа — задержки в логах могут задержать обнаружение. Необходимо проектировать конвейеры с минимальными задержками и запасами.
- Стоимость хранения и обработки — большой объём логов и сложное нормирование приводят к высоким затратам на хранение, вычисления и лицензии. Важно оптимизировать хранение и использовать архивирование.
- Зависимость от источников — проблемы на стороне источника (неправильное форматирование, ложные отпечатки и пр.) приводят к «погрешности» анализа. Нужно обеспечить мониторинг качества входящих данных.
- Приватность и регуляторика — связываясь с данными сотрудников и клиентов, мы обязаны соблюдать требования по персональным данным, особенно при глобальных проектах. Рассматривайте локализацию и процедуры доступа.
- Интеграции и совместимость — разнообразие форматов и версий может вызывать сложности при обновлениях и расширении SIEM. Важно иметь модульные конвейеры и хорошо документированную архитектуру.
- Технологический риск — зависимость от конкретного стека (например, Elasticsearch/Logstash) может привести к ограничению гибкости. Рекомендуется рассмотреть альтернативные решения (OpenSearch, Graylog, Wazuh) и гибридные архитектуры.
- Ограничения по компетентности персонала — внедрение SIEM требует специалистов по данным, инженеров DevOps и аналитиков SOC. Необходимо инвестировать в обучение и cross-training BI/DWH и SIEM-команды.
- Правовые риски — в некоторых случаях согласование использования TI, обмена данными и внешних интеграций может потребовать согласований с юристами и документирования процессов.
Выводы
- Требования к данным для SIEM — это не только сбор больших объёмов логов, но и качественный процесс нормализации, обогащения, управления метаданными и совместной работы с BI/DWH системами. Ключевые элементы: единая модель данных, стандарты форматов (Syslog, JSON, CEF/LEEF), эффективная архитектура конвейеров, возможности TI и корреляции, а также строгие политики хранения и приватности.
- Внедрение SIEM в связке с BI/DWH требует системной подготовки: проектирования модели данных, интеграционных стратегий, регламентов по управлению качеством данных и процедур по аудиту.
- Практический подход — сочетание open-source технологий (например, Elastic Stack, OpenSearch, Graylog, Wazuh) с отеческими решениями и интеграциями, которые обеспечивают локализацию и соответствие регуляторным требованиям. Это позволяет снизить риск и повысить адаптивность к специфике российского рынка.
- В итоге, для эффективного SIEM важна не только мощная техническая база, но и грамотная методология работы с данными, прозрачная политика управления данными, а также тесная связь между командами SOC, BI и IT-инфраструктуры.
Выводы для практики
- При старте проекта определить набор источников данных, приоритеты по бизнес-объектам, требования к хранению и регуляторным нормам.
- Разработать единый словарь полей для нормализации, определить основную схему данных и принципы обогащения логов TI.
- Построить конвейеры данных: агенты на источниках, конвертация форматов, нормализация, обогащение, корреляции и последующая загрузка в SIEM и DWH.
- Внедрить цикл контроля качества данных и регулярное обновление правил корреляции, чтобы адаптироваться к изменениям угроз и бизнес-процессов.
- Уделить внимание локализации данных, хранению внутри РФ там, где это требуется, и обеспечить соответствие политике безопасности и требованиям законодательства.
Вопрос–Ответ (FAQ)
1) Что такое единая модель данных для SIEM, и зачем она нужна?
Единая модель данных — это унифицированная структура полей и форматов, которая применяется ко всем входящим источникам. Она нужна, чтобы легко и быстро сопоставлять события из разных систем, проводить корреляцию и создавать консистентные отчёты в BI/DWH. Без единой схемы растёт сложность анализа, увеличивается риск потери важных полей или ошибок в сопоставлении источников.
2) Какие форматы логов наиболее часты и какие требования к ним в SIEM?
Наиболее частыSyslog (с полем RFC 5424), JSON и форматы CEF/LEEF. Syslog подходит для сетевых устройств и серверов, но требует нормализации. JSON удобен для облачных сервисов и приложений. CEF/LEEF предназначены для унифицированного представления событий. В SIEM часто создаются конвертеры, которые приводят данные из разных форматов к единой схеме и валидируют поля.
3) Как связать SIEM и BI/DWH для долгосрочного анализа?
Связывают SIEM и BI/DWH через этапы: сбор и нормализация данных в SIEM, выбор части данных для временных периодов и передачу их в DWH по ELT/ETL-процессам, агрегацию и создание агрегатов/таблиц, которые BI может использовать для анализа. Важно поддерживать корректное хранение и архитектуру по retention policy, чтобы данные, необходимые для бизнес-аналитики, были доступны без перегрузки SIEM.
4) Какие технологические решения чаще всего применяются в открытом доступе?
Open-source решения: Elastic Stack (Elasticsearch, Logstash, Kibana), OpenSearch, Graylog, Wazuh, Apache Kafka, Apache NiFi. Эти стеки поддерживают сбор, нормализацию, хранение, обогащение и анализ логов в рамках SIEM и BI.
5) Какие есть отечественные (российские) варианты внедрения SIEM?
На российском рынке применяются локализованные практики внедрения на базе открытых стеков и интеграций с отечественными системами. Россия активно развивается в части локальные дата-центры и внедряемые интеграции TI, а также поддержки на уровне контрагентов и партнёров. В качестве примера можно рассмотреть интеграции с отечественными SIEM-решениями от крупных российских поставщиков, а также TI-платформы, интегрируемые с SIEM через стандартные интерфейсы. Важно учитывать локализацию и соблюдение регламентов по хранению и обработке данных.
6) Какие риски связаны с внедрением SIEM в BI/DWH?
Основные риски — шум и ложные срабатывания, задержки поступления логов, высокие затраты на хранение и вычисления, сложность поддержания актуальности корреляций, требования к компетенциям персонала, и регуляторные требования к данным. Нужно продумать фильтры входящих данных, настройки порогов корреляции, инфраструктуру масштабирования, методы архивирования и политику доступа к данным.
7) Какой подход выбрать — гибридный или полностью централизованный SIEM?
Гибридный подход часто предпочтительен: горячие данные для быстрого обнаружения и расследования находятся в локальном SIEM, холодные данные архивируются и доступны для аудита и регуляторной отчетности. Это помогает балансировать между скоростью реагирования иCost/Efficiency. В BI/DWH гибридная архитектура поддерживает долгосрочную аналитику без перегрузки SIEM.
8) Как обеспечить соответствие приватности и локализации данных в рамках SIEM?
Нужно определить минимальный набор персональных данных, обеспечить шифрование данных и ограничение доступа к ним, внедрить политики сегментации и аудит доступа, хранить данные внутри соответствующих территорий (если требуется законом). Важно также обеспечить документирование процессов обработки данных и взаимодействие с регуляторами.
9) Какие шаги необходимы для onboarding нового источника данных в SIEM?
1) Определить цель и контекст источника. 2) Определить поля, которые будут собираться, и формат передачи. 3) Настроить агент или коннектор и обеспечить безопасную передачу. 4) Привести данные к единому формату и проверить валидацию. 5) Обогатить данные TI и бизнес-контекстом. 6) Добавить проверки качества данных и задействовать в корреляциях.
10) Какие KPI полезно отслеживать в начале проекта SIEM?
- Время на подключение источника данных (onboarding time)
- Доля принятых и валидируемых событий
- Время задержки (latency) поступления событий
- Доля ложных срабатываний по детекциям
- Доля коррелируемых инцидентов, времени обнаружения и времени реакции
- Стоимость хранения и обработки на единицу данных
- Пропускная способность конвейера обработки логов
Данная глава ориентирована на внедрение SIEM в контексте BI и DWH, с акцентом на теоретические основы и практические кейсы. В реальном проекте детали будут зависеть от конкретной отрасли, регуляций, объёма логов и используемого стека. Важной частью является совместная работа SOC, IT-инфраструктуры и BI-команды, чтобы обеспечить не только безопасный мониторинг, но и аналитическую ценность данных для бизнеса.


