

PREWHERE в ClickHouse: теория, архитектура выполнения и практика оптимизации запросов
Введение: контекст оптимизации запросов в ClickHouse и роль PREWHERE
ClickHouse за годы своего развития сформировал комплекс методик, которые позволяют анализировать огромные массивы данных почти в реальном времени. Среди таких методик особое место занимает PREWHERE - именованный оператор, который обеспечивает раннее чтение и фильтрацию данных на уровне столбцов. В контексте широких таблиц, где число столбцов существенно превышает число реально необходимых для конкретного запроса, PREWHERE становится критическим инструментом сокращения объема считываемых данных и повышения производительности.
Ключевая идея заключается в том, что не все столбцы таблицы должны быть прочитаны на первом этапе обработки запроса. PREWHERE позволяет определить подмножество столбцов, значения которых необходимы для селективной фильтрации. Затем зафиксированные строки, удовлетворяющие условию PREWHERE, проходят дальнейшую обработку, и только после этого считываются остальные запрошенные данные. Такой подход радикально уменьшает дисковый ввод-вывод и затраты на парсинг и декодирование данных.
Истоки концепции подобной ранней фильтрации лежат в механизмах Predicate Pushdown в других СУБД, однако в ClickHouse реализация названа именно PREWHERE и требует явного указания в синтаксисе. Сравнительно с решениями, где фильтры применяются уже после чтения всех столбцов, PREWHERE позволяет экономить ресурсы, особенно на широких таблицах с большим числом столбцов и относительно низкой селективностью по целевым полям. В то же время современные оптимизаторы ClickHouse способны автоматически переносить некоторые условия из WHERE в PREWHERE, если это выгоднее по объему читаемых данных - настройка optimize_move_to_prewhere может быть включена по умолчанию и корректироваться вручную.
В этой статье мы рассмотрим PREWHERE как системный элемент архитектуры выполнения запросов: от теоретических оснований и сравнения с аналогами до практических рекомендаций по настройке, кейсов применения и методик тестирования. Структура-from общего к частному-позволяет выстроить прочную связь между концептуальными фундаментами и операционной реализацией в реальных рабочих сценариях.
Как работает оператор PREWHERE в ClickHouse: механизм раннего чтения и фильтрации
PREWHERE реализует принцип ранней фильтрации, когда данные читаются поэтапно и сначала отбираются строки, соответствующие условию, задаваемому внутри PREWHERE. Затем вторая фаза включает чтение только тех столбцов, которые нужны для вывода и дальнейшей обработки, но которые не были задействованы в PREWHERE. Это позволяет пропускать существенную часть данных в столбцах большого размера, если фильтр по ним позволяет отсечь большинство строк.
Основные моменты работы PREWHERE можно резюмировать так:
- PREWHERE применяется к одному условию в рамках одного запроса и относится к столбцам, указанным в этом условии.
- Первым этапом выполняется чтение и фильтрация по полю(ям) PREWHERE. Отфильтрованные строки помечаются и становятся «кейсами», которые будут продолжать обработку.
- На следующем этапе считываются только остальные запрошенные столбцы для уже отфильтрованных строк. Это сокращает объем данных, подлежащих чтению и декодированию.
- В большинстве сценариев высока эффективность, когда условия PREWHERE касаются столбцов с низкой кардинальностью или столбцов с компактной размерной моделью, что уменьшает общий объем глубокого чтения.
Важно понимать, что PREWHERE эффективен не всегда и не во всех комбинациях. В частности, он наиболее полезен для широких таблиц с многочисленными столбцами и когда фильтр по столбцу ограничивает значительную долю строк. В таких случаях экономия на дисковом вводе-выводе становится критичной. При этом фильтровать можно не только по «тонким» полям, но и по полям с низкой селективностью, если такое применение оправдано с точки зрения сокращения общего объема читаемых данных.
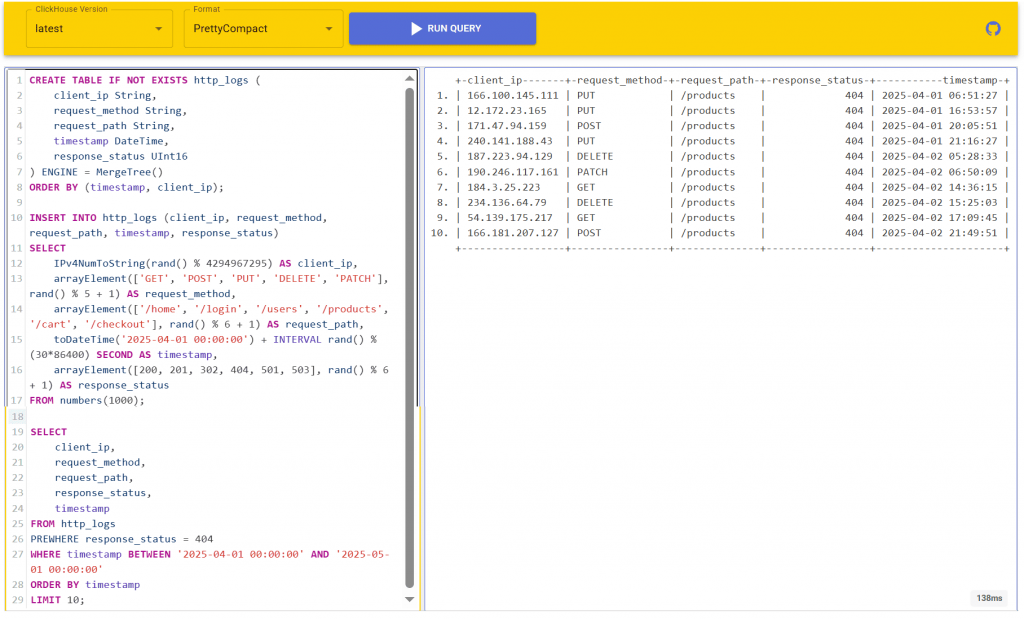
Пример из практики - таблица http_logs. В рамках PREWHERE можно задать фильтр по полю response_status и, отдельно, по времени в WHERE. В случае, когда statusCode имеет низкую кардинальность, PREWHERE может значительно уменьшить объем чтения данных по дорогим полям, таким как URL-пути или тело ответа, которые занимают больше места в памяти и на диске. Важно: в обычном SQL-запросе сначала читаются все столбцы и затем применяется фильтр; PREWHERE же меняет порядок чтения в пользу ранней фильтрации и целенаправленного чтения нужных столбцов.
Практически в ClickHouse PREWHERE может сочетаться с WHERE, а также с иными оптимизациями, такими как разреженные индексы и отложенная материализация. Комбинация PREWHERE с другими техниками позволяет построить более гибкую и производительную схему обработки запросов, особенно в системах с большими данными и ограничениями по времени отклика.
Существуют и особенности реализации: начиная с версии 23.2 ClickHouse сортирует столбцы фильтра PREWHERE по возрастанию их несжатого размера, что ускоряет многоступенчатую обработку. Начиная с версии 23.11 добавляется динамическая статистика столбцов, которая можетעודобавлять дополнительную оптимизацию порядка применения фильтров на основе реальной селективности данных, а не только размера столбца. В некоторых случаях оптимизатор может автоматически перевести часть условий из WHERE в PREWHERE, но для явного управления следует использовать настройку optimize_move_to_prewhere.
Разберём, как это влияет на план выполнения: читая меньшие по размеру столбцы в начале, система уменьшает количество данных, которое должно быть передано в последующие стадии обработки; этот подход особенно выгоден, когда данные в остальных столбцах более дорогие по объему и сжатию, и когда отбор по PREWHERE уже отсекает большую часть записей.
Теоретическая база PREWHERE: концепции раннего применения фильтров и сравнение с Predicate Pushdown
Раннее применение фильтров - это базовый концепт в аналитических СУБД. Он основан на идее, что ограничение на количество прочитанных данных должно применяться как можно раньше в цепочке обработки, чтобы минимизировать потребление вычислительных и дисковых ресурсов. В ClickHouse PREWHERE выполняет роль, аналогичную Predicate Pushdown в других системах управления базами данных, но оформленную как отдельный синтаксический элемент и управляемую операторной логикой.
- Predicate Pushdown (перевод: «распространение предикатов вниз») - общий принцип, при котором фильтры перенаправляются к самому уровню чтения данных, минимизируя объем данных, подлежащих чтению. В Vertica, Oracle, Apache Impala, Greenplum и PostgreSQL подобные концепции реализованы под разными названиями и механизмами.
- PREWHERE в ClickHouse - это конкретный механизм, который позволяет явно указать, какие колонки должны быть прочитаны на первом этапе обработки. Он не произвольная оптимизация, а стратегический элемент планирования выполнения.
- В контексте оптимизации структуры хранения и вычислительной архитектуры PREWHERE часто дополняется другими техниками: разреженные индексы (sparse indexes), отложенная материализация (lazy materialization) и специальные настройки планирования, которые усиливают эффект раннего чтения.
С точки зрения теории эффективности, принцип работает так: чем выше селективность условия PREWHERE и чем меньше размер загружаемых столбцов, тем больший выигрыш приносит раннее чтение. Однако если условие PREWHERE далеко не селективно или применяется к очень дорогим столбцам по размеру, эффект может быть нейтральным или даже отрицательным. В таких случаях разумно использовать PREWHERE по умолчанию для среднего уровня селективности, либо полагаться на автоматический перенос предикатов в PREWHERE через оптимизатор, если это приводит к меньшему объему чтения.
Сравнение с Predicate Pushdown показывает, что основная польза одинаковая - фильтрация до обработки тяжелых данных. Различие состоит в синтаксисе и контексте применения: PREWHERE - это явный оператор, который работает в рамках конкретной архитектуры ClickHouse, а Predicate Pushdown - более общий концептуальный принцип, реализуемый по-разному в разных СУБД. Это различие порождает уникальные возможности для управления и диагностики в рамках ClickHouse, которые позволяют дата-инженерам напрямую влиять на план выполнения и расход ресурсов.
Архитектура выполнения запроса с PREWHERE: этапы и порядок чтения данных
Архитектура выполнения запроса в ClickHouse с PREWHERE можно рассмотреть как последовательность этапов, где каждый шаг ориентирован на минимизацию объема данных, которые необходимо загружать и обрабатывать:
-
Разбор и планирование. На этом этапе синтаксис запроса фиксируется в плане выполнения. Выявляются потенциальные кандидаты для PREWHERE и оценивается, какие поля будут участвовать в PREWHERE, а какие - в обычном WHERE и в финальном выборе столбцов.
-
Формирование логики PREWHERE. Определяются конкретные условия для ранней фильтрации. В зависимости от версии ClickHouse и настроек оптимизма, часть условий из WHERE может быть автоматически перенесена в PREWHERE. В этом шаге рассчитывается порядок чтения столбцов по их размерности и селективности, чтобы минимизировать общий объем чтения.
-
Чтение по PREWHERE. Система читает только те столбцы, которые задействованы в PREWHERE. Выполняется фильтрация по этим столбцам. Таким образом, формируется множество строк, которое потенциально может сохраниться для последующей обработки.
-
Чтение оставшихся столбцов. Для отфильтрованных строк читаются остальные запрошенные столбцы, чтобы сформировать итоговую выборку. В этот этап вступают как столбцы, указанные в PREWHERE, так и другие столбцы, выходящие за пределы PREWHERE, но только для отобранных строк.
-
Финальная обработка. Выполняются агрегаты, сортировки, группировки и любые дополнительные фильтры, которые остаются в запросе. На этом этапе данные проходят полный путь обработки, но объем зачитанных данных уже существенно ограничен.
-
Возврат результатов. Результаты формируются и возвращаются клиенту. В рамках мониторинга и диагностики можно анализировать планы выполнения, чтобы убедиться в активности PREWHERE и корректности переноса условий.
Эти этапы подчеркнуты тем, что PREWHERE не меняет сам факт наличия WHERE, а лишь изменяет последовательность чтения и фильтрации данных. В большинстве случаев PREWHERE аргументированно ускоряет запрос за счет значительного снижения объема загружаемых данных и ускоренного прохода через слой чтения.
Декомпозиция технических компонентов и их взаимодействие во время PREWHERE включает следующие элементы:
- Движок хранения MergeTree, на котором реализованы принципы чтения столбцов и упорядочения данных.
- Строки планирования и оптимизация выражений, которые анализируют предикаты и решают, какие условия отправляются в PREWHERE.
- Механизм автоматического переноса предикатов из WHERE в PREWHERE, управляемый настройкой optimize_move_to_prewhere.
- Архитектура ввода-вывода (I/O), которая учитывает размер столбцов, их типы и сжатие.
Понимание того, как эти компоненты взаимодействуют, позволяет архитекторам и инженерам по данным оптимально настраивать конфигурации и планировать схему обработки запросов в рамках реальных нагрузок.
Декомпозиция технических компонентов и их взаимодействие во время PREWHERE
Ключевые элементы архитектуры PREWHERE в ClickHouse можно рассмотреть по ролям и взаимодействиям:
-
Столбцово-ориентированное чтение. ClickHouse читают данные по столбцам, а не по строкам. PREWHERE выбирает те столбцы, которые необходимы для ранней фильтрации, минимизируя объем "весомых" данных, которые должны быть прочитаны впоследствии.
-
Сжатие и кодирование. Типы данных и методы сжатия оказывают влияние на размер несжатых данных и, соответственно, на скорость чтения. Чем меньший размер столбца - тем быстрее он может быть прочитан и использован для ранней фильтрации.
-
Порядок чтения фильтров PREWHERE. Алгоритм сортировки столбцов PREWHERE по размеру и, позднее, по селективности, помогает минимизировать объем данных на раннем этапе. Применение этой стратегий особенно полезно для массивных наборов данных, где часть столбцов имеет высокую селективность и может существенно сузить выборку.
-
Оптимизатор. Механизм оптимизации осуществляет анализ выражений и может перенести часть предикатов в PREWHERE. Это зависит от конфигураций и версии движка. В версии 23.11 предусмотрено использование фактической селективности данных для упорядочения порядка обработки, что может дополнительно повысить эффективность PREWHERE.
-
Разреженные индексы. Взаимодействие PREWHERE с индексацией может привести к еще большему снижению объема считываемых данных в рамках ранней фильтрации, особенно для полей с низкой кардинальностью или высоким значением селективности.
-
Отложенная материализация. Этот подход дает возможность не сразу материализовать все поля и поддерживать вычисление по мере необходимости. В сочетании с PREWHERE он может уменьшать нагрузку на память и ускорять обработку.
-
Техника планирования и мониторинга. Для диагностики и оптимизации PREWHERE применяются планы выполнения, инструменты профилирования и логи запросов. Это позволяет архитекторам и администраторам оценивать эффект PREWHERE и вносить корректировки в стратегию фильтрации и настройки.
Кардинальность, размер столбцов и эффективные стратегии фильтрации
Эффективность PREWHERE во многом зависит от кардинальности и размера столбцов, поскольку эти параметры определяют стоимость чтения и фильтрации. В широких таблицах с многочисленными строками и столбцами, обработка которых имеет разную величину, PREWHERE особенно выгоден, когда:
- условие PREWHERE относится к столбцу с низкой кардинальностью. Такие поля требуют меньших затрат на хранение и обработку, и фильтр может отсечь значительную долю записей.
- фильтр по PREWHERE существенно сужает множество. Если селективность высокая, эффект экономии на I/O становится значительным.
- размер столбца в UNIX-блоках - несжатый размер - невелик по сравнению с размерами дорогих столбцов, таких как длинные строки или двоичные данные. В таких случаях сортировка по невеликим размерам столбцов позволяет ускорить обработку.
С версии 23.2 ClickHouse реализует стратегию сортировки столбцов PREWHERE по возрастанию несжатого размера, что ускоряет многоступенчатую обработку. С версии 23.11 добавляется дополнительная статистика столбцов, которая позволяет выбирать порядок обработки на основе фактической селективности, а не только размера. Эти изменения делают PREWHERE более адаптивным к характеру данных и нагрузке.
Понимание кардинальности важно и для решений, касающихся использования PREWHERE с вложенными JSON-структурами или сложными полями. В таких случаях оптимизация может быть более сложной и требовать анализа отдельного случая, чтобы определить, какая часть данных действительно выигрывает от ранней фильтрации.
Интеграция PREWHERE с другими оптимизациями: разреженные индексы, отложенная материализация и настройки
PREWHERE не существует в вакууме. В реальных системах он работает в связке с несколькими другими механизмами оптимизации:
-
Разреженные индексы. Для полей с малыми размерами и высокой селективностью разреженные индексы могут существенно усилить эффект PREWHERE, позволив системе быстро определить набор строк, удовлетворяющих предикату, без чтения большого объема данных по всей таблице.
-
Отложенная материализация. В случаях, когда наборы полей слишком крупные, можно отложить их материализацию до момента, когда они действительно понадобятся. Комбинация PREWHERE с отложенной материализацией уменьшает давление на оперативную память и ускоряет обработку за счет уменьшения числа столбцов, читаемых на ранних стадиях.
-
Настройки планирования. В ClickHouse существуют настройки, которые управляют тем, как и когда предикаты могут быть перенесены в PREWHERE. Например, optimize_move_to_prewhere, по умолчанию часто включен, но может быть отключен вручную для экспериментов или в случае неэффективности переноса.
-
Оптимизация порядка чтения. Как упоминалось выше, порядок применения фильтров по PREWHERE зависит от размера столбцов и их селективности. Современные версии ClickHouse (с 23.11 и далее) добавляют статистику столбцов, которая позволяет адаптивно менять порядок чтения фильтров в реальном времени.
Эти интеграции подчеркивают, что PREWHERE - это элемент экосистемы оптимизации, который требует учета контекста данных и архитектуры системы. Эффективное использование PREWHERE предполагает синергетическое сочетание с индексацией, материализацией и настройками планирования.
Практические примеры оптимизации: кейс на http_logs
Рассмотрим практический кейс на примере таблицы http_logs, которая может быть характерна для инфраструктуры логирования веб-приложения. Пример базы данных и сценария:
-
Таблица http_logs:
- client_ip String
- request_method String
- request_path String
- timestamp DateTime
- response_status UInt16
- ENGINE = MergeTree()
- ORDER BY (timestamp, client_ip)
-
Пример заполнения (псевдосценарий) демонстрирует типовую структуру данных: значения client_ip, request_method, request_path, timestamp и response_status.
-
Задача: найти первые 10 случаев HTTP-ответов со статусом 404 за период с 2025-04-01 до 2025-05-01, вернуть время и поля клиента.
-
Запрос с PREWHERE:
SELECT client_ip, request_method, request_path, response_status, timestamp
FROM http_logs
PREWHERE response_status = 404
WHERE timestamp BETWEEN '2025-04-01 00:00:00' AND '2025-05-01 00:00:00'
ORDER BY timestamp
LIMIT 10;
-
Объяснение шагов:
- ClickHouse читает сначала столбец response_status через PREWHERE и отбирает строки с 404. Этот столбец имеет низкую кардинальность (много повторяющихся значений для кодов статуса), поэтому фильтр по этому полю эффективен и позволяет отсеять большую часть строк на ранней стадии.
- Затем применяется фильтр по timestamp: из ранее отфильтрованных строк остаются те, которые попадают в заданный диапазон времени.
- Наконец, читаются остальные столбцы (client_ip, request_method, request_path) только для отфильтрованных строк, что экономит ресурсы по сравнению с чтением всех столбцов для всех строк.
-
В сравнении с вариантом без PREWHERE:
SELECT client_ip, request_method, request_path, response_status, timestamp
FROM http_logs
WHERE response_status = 404
AND timestamp BETWEEN '2025-04-01 00:00:00' AND '2025-05-01 00:00:00'
ORDER BY timestamp
LIMIT 10;
В этом случае весь набор запрошенных столбцов читается сразу, а затем применяется фильтр по всему набору. Если запросы работают на больших таблицах и столбцах с большими размерами, PREWHERE может dramatically снизить общий объём читаемых данных и время выполнения.
-
Важная деталь: можно отключать PREWHERE через настройки для сравнения; например, SETTINGS optimize_move_to_prewhere = false; это позволяет увидеть эффект отключения PREWHERE и сравнить его с использованием PREWHERE. Важно помнить, что PREWHERE сокращает количество считываемых данных, а неnecessarily количество обработанных строк: объем читаемых файлов может быть существенно меньше, но число обработанных строк может быть одинаковым между версиями запроса с PREWHERE и без PREWHERE.
-
Вывод: PREWHERE в данном кейсе отлично подходит для таблиц логирования, где столбцы с низкой кардинальностью и небольшим размером позволяют раннюю фильтрацию на этапе чтения, что кратно ускоряет последующую обработку и уменьшает нагрузку на систему.
-
В заключение отметим, что PREWHERE работает преимущественно с табличными движками семейства MergeTree. В запросах может быть только одно условие PREWHERE, и в редких случаях применение PREWHERE к полю с большим размером может не давать преимуществ. Однако, при правильной настройке и выборе сценариев, PREWHERE становится мощным инструментом оптимизации чтения данных.
Сравнительный анализ PREWHERE и аналогов в других СУБД
Рассмотрим контекст сопоставления PREWHERE с аналогами в разных СУБД и как это влияет на выбор архитектурной стратегии:
-
Predicate Pushdown в Vertica, Oracle, Apache Impala, Greenplum и PostgreSQL. Это общее концептуальное направление, которое стремится переносить фильтры ближе к источнику данных. В некоторых системах аналогичный эффект достигается через различные уровни оптимизации plan, фильтры и индексы. Однако в ClickHouse PREWHERE реализован как явный оператор в синтаксисе, что обеспечивает прямой контроль над тем, какие столбцы читаются на ранних стадиях.
-
В MySQL и MariaDB существуют концепции Condition Pushdown в контексте подзапросов и внешних таблиц. Это демонстрирует эволюцию подходов к раннему чтению, но не идентичную реализацию PREWHERE в ClickHouse.
-
Apache Druid и Snowflake реализуют похожие внутренние механизмы для раннего применения фильтров, часто в рамках колонно-ориентированной архитектуры и специфических форматов индексов. Но различия в деталях реализации, синтаксисе и настройках делают PREWHERE уникальным инструментом в ClickHouse.
-
В контексте схемы данных и производительности PREWHERE является специфическим элементом ClickHouse, который требует явного указания в запросе и тесно связан с особенностями движков семейства MergeTree. Это делает PREWHERE мощным, но требовательным к правильному применению и анализу планов выполнения.
Сравнительный анализ показывает, что PREWHERE является эффективной стратегией, но требует внимательного подхода к выбору полей, порядка фильтрации и настройкам системы. В реальных проектах полезно сочетать PREWHERE с другими техниками оптимизации и адаптировать стратегию к характеру данных и нагрузке.
Метрики эффективности и методики тестирования
Эффективность PREWHERE должна оцениваться по совокупности факторов, включая экономию IO, скорость выполнения и стабильность выполнения. В рамках методики тестирования можно использовать следующие метрики:
-
Объем читаемых данных (IO volume). Основной KPI - суммарный объем прочитанных данных до и после применения PREWHERE. Снижение этого параметра прямо коррелирует с экономией ресурсов.
-
Время выполнения (execution time). Время между отправкой запроса и получением результатов. Снижение времени выполнения при сохранении точности результатов является главным признаком эффективности PREWHERE.
-
Число прочитанных строк против числа возвращаемых строк. В идеальном случае число прочитанных строк не сильно отличается между PREWHERE и без PREWHERE, тогда следует обратить внимание на снижение объема считанных столбцов.
-
Затраты на CPU и память. Изучение использования CPU и памяти позволяет оценить, насколько PREWHERE влияет на вычисления и кэширование.
-
Эффективность сжатия. Учет того, как PREWHERE влияет на сжатие и декодирование столбцов, особенно в контексте разрежённых индексов и отложенной материализации.
-
Надежность и устойчивость под нагрузкой. В условиях реальной эксплуатации следует проверить, сохраняется ли ускорение на пиковых нагрузках и при изменении распределения данных.
Методика тестирования включает:
- Валидационные тесты на тестовых выборках с известной селективностью PREWHERE.
- Бенчмаркинг на реальных рабочих нагрузках и в условиях имитации пиковых периодов.
- Сравнение вариантов: PREWHERE против PREWHERE без переноса автоматизации, а также различных конфигураций optimize_move_to_prewhere и использования отложенной материализации.
- Анализ планов выполнения через EXPLAIN и системные логи, чтобы увидеть факты переноса предикатов и порядок чтения.
Диапазон применимости PREWHERE зависит от характера данных, структуры таблицы и сценариев запроса. В идеальном случае постановка PREWHERE должна сопровождаться мониторингом и постоянной валидацией в условиях продакшена, чтобы обеспечить устойчивую производительность.
Кейсы применения в реальных сценариях
-
Аналитика веб-логов и телеметрии. Таблицы с десятками столбцов, где фильтрация может происходить по одному из столбцов с небольшой кардинальностью - PREWHERE позволяет существенно уменьшать объем читаемых данных.
-
Фиксация событий в телекоммуникациях. При больших объемах событий, где фильτры применяются к полям с высокой селективностью, PREWHERE может значительно снизить нагрузку и ускорить анализ.
-
Финансовый сектор и риск-аналитика. В сценариях, где нужно быстро фильтровать по конкретным кодам и временным окнам, PREWHERE позволяет оптимизировать обработку больших массивов данных, сохраняя точность.
-
E-commerce и поведенческий анализ. При анализе поведения пользователей и торговых событий, где множество столбцов содержит данные различной ценности, PREWHERE помогает сосредоточиться на релевантных полях и снизить накладные расходы.
-
Мониторинг IoT и телеметрии. В условиях больших данных и потоков метрик, где фильтры часто ориентированы на конкретные пороги и статусы, PREWHERE обеспечивает быструю фильтрацию и экономию на объёме чтения.
-
Отчетность и dashboard-аналитика. При формировании регулярной отчетности, где фильтры применяются к небольшой части полей, PREWHERE поддерживает быструю генерацию отчетов и уменьшение времени задержки.
Эти кейсы демонстрируют практическую ценность PREWHERE и показывают, как архитекторы данных и инженеры могут адаптировать стратегию под конкретный бизнес контекст и требования по времени отклика.
Интеграция технологических стеков и их синергия
PREWHERE хорошо вписывается в современный стек аналитики данных и цифровой трансформации:
-
Интеграция с колоночными форматами хранения и сжатия. PREWHERE максимально эффективен вместе с колоночными форматами и сжатиями, которые позволяют быстро отобрать минимальные столбцы для ранней фильтрации.
-
Синергия с обширной индексацией и словарями кодирования. В сочетании с разреженными индексами и словарными кодировками PREWHERE может усилить эффект фильтрации и упростить доступ к данным.
-
Взаимодействие с отложенной материализацией и кэшами. Отложенная материализация уменьшает нагрузку на ресурсные узлы, и PREWHERE дополняет это за счет ранней фильтрации.
-
Инструменты мониторинга производительности. Инструменты профилирования планов выполнения и логирования запросов позволяют быстро определить, какие части PREWHERE работают эффективно, а какие требуют перенастройки.
-
Архитектура распределенных систем. В распределенных кластерах PREWHERE требует согласованности плана и тщательного анализа производительности в каждом ноде, чтобы получить общее выигрыш.
Синергия этих элементов обеспечивает эффективную реализацию PREWHERE в рамках современных проектов по обработке больших данных.
Возможности применения PREWHERE в различных экономических секторах
-
Финансовые услуги. В системах анализа операций, риска и аудита PREWHERE может значительно ускорить обработку больших наборов транзакционных данных, где фильтры часто применяются к столбцам с низкой кардинальностью.
-
Розничная торговля и онлайн-ритейл. Читать только необходимые столбцы в рамках периодов времени и фильтров по статусам и методам позволяет ускорить расчеты и анализ клиентской активности.
-
Производство и IoT. В сборе метрик и телеметрии PREWHERE помогает снизить задержки в анализе потоков событий при больших данных.
-
Здравоохранение и биоинформатика. При анализе больших наборов клиника-данных и тестовых результатов, где фильтры применяются к узким полям, PREWHERE может снизить задержки и повысить скорость анализа.
-
Телкоммуникации и онлайн-платежи. Резкое снижение IO-объема и ускорение анализа позволяют быстрее выявлять аномалии и паттерны в телекоммуникационных сетях и платежных системах.
Эти примеры показывают, как PREWHERE дополняет стратегию обработки данных в разных секторах, где важны скорость, масштабируемость и экономия ресурсов.
Анализ рисков, ограничений и уязвимостей с метриками эффективности
-
Ограничение одного PREWHERE на запрос. В текущей реализации PREWHERE поддерживает максимум одно условие. Это накладывает ограничения на сложные фильтрации и требует грамотной постановки условий.
-
Выбор полей для PREWHERE. Не все поля подходят для PREWHERE: слишком большой размер столбца или отсутствие селективности может привести к меньшему эффекту или даже ухудшению производительности.
-
Потенциальная потеря гибкости. Частые изменения в запросах и сценариях могут потребовать дополнительной настройки и мониторинга, чтобы PREWHERE оставался эффективным.
-
Влияние на план выполнения. Неправильная настройка переноса предикатов может привести к неэффективному плану выполнения и повышенным затратам.
-
Сложности диагностики. В отдельных случаях трудно определить, как именно PREWHERE влияет на план выполнения, и какие элементы требуют перенастройки. Требуется детальная аналитика и мониторинг планов выполнения.
-
Совместимость с другими движками. PREWHERE поддерживается в MergeTree и в некоторых сценариях может иметь ограничения в частных конфигурациях. Важно учитывать конкретную архитектуру и версию ClickHouse.
Метрики эффективности и методы оценивания риска включают в себя сравнение планов выполнения через EXPLAIN, анализ объема чтения, время выполнения и влияние на компрессию. Важно помнить, что PREWHERE может давать отрицательный эффект в некоторых случаях, поэтому мониторинг и адаптация являются критически важными.
Конкурентный анализ конкурирующих решений и их дифференциация
-
Vertica, Oracle, Apache Impala, Greenplum, PostgreSQL и другие СУБД реализуют концепцию Predicate Pushdown, но реализация PREWHERE в ClickHouse отличается строго заданным синтаксисом и возможностью явной конфигурации на уровне запроса через PREWHERE и optimize_move_to_prewhere. Это дает архитекторам в ClickHouse больше контроля над тем, какие столбцы обрабатываются на раннем этапе.
-
В других системах стратегия ранней фильтрации реализована в виде автооптимизаций или через механизмы пересечения фильтров и индексации, но ClickHouse делает явный упор на явном указании PREWHERE и на упоре на скорость и эффективность в рамках столбцовых форматов и сжатий.
-
Дифференциация: уникальная синтаксическая реализация PREWHERE, тесная интеграция с движком MergeTree, а также возможности оптимизации порядка обработки фильтров, в том числе за счет статистики столбцов начиная с версии 23.11. Эти особенности позволяют ClickHouse достигать существенных преимуществ в сценариях обработки больших массивов данных.
Позиционирование PREWHERE как специфической техники ClickHouse в сравнении с аналогами подтверждает её уникальность и практическую ценность в рамках данного стека технологий.
Практические рекомендации по настройке управления и диагностике PREWHERE
-
Явное использование PREWHERE. Для получения максимального контроля следует явно указывать PREWHERE там, где фильтрация по малым столбцам потенциально сэкономит значительные объёмы данных. Однако при этом важно внимательно анализировать, какие столбцы и какие условия лучше поместить в PREWHERE, чтобы не ухудшить общую производительность.
-
Контроль оптимизатора через optimize_move_to_prewhere. По умолчанию оптимизатор может переносить часть условий в PREWHERE. Но для некоторых сценариев может быть полезно отключить этот механизм и проверить влияние на план выполнения, используя SETTING optimize_move_to_prewhere = false.
-
Анализ планов выполнения и профилирование. Регулярный просмотр PLANes и использование инструментов мониторинга запросов помогает выявлять узкие места в чтении и корректировать стратегию PREWHERE.
-
Внимание к размерам полей. Предпочтение отдавать полям меньших размеров и полям с низкой кардинальностью для PREWHERE. Это позволит минимизировать объем чтения и увеличить эффективность ранней фильтрации.
-
Комбинация с разреженными индексами и отложенной материализацией. В реальных условиях следует тестировать сочетания PREWHERE с данными механизмами, чтобы определить оптимальный баланс между скоростью и ресурсами.
-
Управление инструкциями. В составе архитектуры системного окружения следует внимательно управлять настройками, чтобы PREWHERE не приводил к нежелательному поведению для конкретной нагрузки.
-
Диагностика риска. Перед внедрением на продакшн-проекты следует провести тесты на регрессии и стресс-тесты, чтобы убедиться, что PREWHERE приносит фактическую выгоду в ваших данных.
Эти рекомендации помогут архитекторам и администраторам систем по данным успешно внедрять PREWHERE и поддерживать оптимизацию выполнения запросов в ClickHouse.
Исходный текст статьи
В настоящей работе мы перепроходим основную идею PREWHERE и расширяем её в академическом ключе. Мы рассмотрим теоретическую базу и архитектуру выполнения, обсудим интеграцию с другими оптимизациями, приведем кейсы на традиционных примерах, включая http_logs, и сравним PREWHERE с аналогами в других СУБД. В рамках анализа мы опишем методы тестирования, риски и рекомендации по настройке, чтобы аудит данных и архитекторы имели полное представление о возможностях PREWHERE и допустимых практиках.
Далее мы детализируем архитектуру выполнения PREWHERE и разберем, как она взаимодействует с различными элементами SUT и инфраструктуры, включая переопределяемые планы выполнения, механизм переноса предикатов и использование разрежённых индексов и отложенной материализации. Также мы рассмотрим конкретные примеры и кейсы, включая кейсы на http_logs, чтобы показать реальную эффективность.
Вопрос-Ответ
Вопрос: Что такое PREWHERE и как он влияет на чтение данных?**
PREWHERE - это оператор в ClickHouse, который позволяет выполнять раннюю фильтрацию на уровне определённых столбцов. Это позволяет сначала прочитать и отфильтровать данные по PREWHERE, а затем прочитать оставшиеся столбцы только для отфильтрованных строк, что значительно сокращает объем дискового ввода-вывода и ускоряет выполнение запроса.
Вопрос: Какой эффект имеет PREWHERE на широкие таблицы?**
На широких таблицах PREWHERE особенно эффективен: он позволяет пропускать чтение больших столбцов, когда фильтр по PREWHERE значительно отсеивает строки. Этим достигается существенная экономия IO и времени выполнения.
Вопрос: Может ли оптимизатор автоматически перенести часть условий в PREWHERE?**
Да, начиная с оптимизации в ClickHouse, существует настройка optimize_move_to_prewhere, которая может автоматически переносить некоторые условия из WHERE в PREWHERE. В некоторых случаях это повышение эффективности, в других - требуется контроль вручную.
Вопрос: Какие ограничения существуют для PREWHERE?**
Прежде всего, в одном запросе поддерживается одно условие PREWHERE. Также не все поля подходят для PREWHERE; применение к большим столбцам может не привести к улучшению, и иногда наоборот может снизить производительность. PREWHERE работает с табличными движками семейства MergeTree.
Вопрос: Какие кейсы являются наиболее подходящими для PREWHERE?**
Наиболее подходящими сценариями являются запросы с фильтрацией по столбцам с небольшой кардинальностью и substantialные размеры таблиц, где PREWHERE может существенно уменьшить объем чтения. Примеры включают логи веб-сервера (http_logs), телеметрию и аналитическую панель.
Вопрос: Как PREWHERE взаимодействует с другими оптимизациями?**
PREWHERE может сочетаться с разреженными индексами и отложенной материализацией. Эти техники могут дополнительно усилить эффект ранней фильтрации и снизить нагрузку на систему, особенно в контексте больших таблиц и сложных запросов.
Вопрос: Какие меры контроля и диагностики применяются для PREWHERE?**
Важны планы выполнения, EXPLAIN, мониторинг системных логов запросов и сравнение версии запроса с PREWHERE и без PREWHERE. Также полезно тестировать различные варианты конфигураций optimize_move_to_prewhere и анализировать влияние на объем чтения и время выполнения.
Вопрос: Каковы принципы выбора столбцов для PREWHERE?**
Как правило, следует выбирать столбцы с низкой кардинальностью и небольшим несжатым размером, которые позволяют эффективную раннюю фильтрацию. В дальнейшем следует исследовать селективность возведение PREWHERE и доступность функциональности в рамках версии ClickHouse.
Вопрос: Какие типичные ошибки встречаются при использовании PREWHERE?**
Типичные ошибки включают чрезмерную привязку PREWHERE к дорогим столбцам, неоправданное включение больших столбцов в PREWHERE и игнорирование использования оптимизатора, что может привести к минимизации преимущества или даже ухудшению производительности.
Вопрос: Какие шаги следует предпринять перед внедрением PREWHERE в продакшн?**
Необходимо провести тестирование на подмножествах данных, сравнить с аналогическими запросами без PREWHERE, проверить влияние на план выполнения и оценить экономию IO и время выполнения. Определение оптимального набора условий и столбцов для PREWHERE требует анализа конкретной рабочей нагрузки и структуры данных.
Вопрос: Как PREWHERE помогает в сценариях реального времени?**
PREWHERE позволяет ускорять запросы в реальном времени, минимизируя IO и ускоряя обработку для больших датасетов. Это достигается за счет ранней фильтрации и сокращения объема данных, которые нужно загружать в дальнейшем этапе обработки.
Вопрос: В чем основная разница между PREWHERE и обычной WHERE в ClickHouse?**
Обычный WHERE применяется после чтения всех указанных столбцов, тогда как PREWHERE сначала читает и фильтрует только те столбцы, которые задействованы в PREWHERE, а затем читает остальные столбцы только для отфильтрованных строк. Это отличие обеспечивает значительную экономию IO и ускорение, когда условия PREWHERE селективны и столбцы небольшие по размеру.
Вопрос: Какие практические рекомендации по настройке PREWHERE можно сделать для команды архитекторов данных?**
Рекомендуется явное использование PREWHERE там, где он приносит выигрыш, контроль за оптимизатором через optimize_move_to_prewhere, анализ планов выполнения и мониторинг планов на продакшене, а также сочетание PREWHERE с разреженными индексами и отложенной материализацией для повышения общей эффективности. Важно тестировать на реальных сценариях и держать под контролем риски, связанные с ограничениями PREWHERE.
Вопрос: Какие сегменты статьи были наиболее важны для понимания тем PREWHERE?**
Важнейшие сегменты включают теоретическую базу и концепцию раннего применения фильтров, архитектуру выполнения и порядок чтения данных, практические кейсы на http_logs, интеграцию с другими оптимизациями, а также методики тестирования и оценки эффективности.
Вопрос: Какие перспективы развития PREWHERE ожидаются в будущих версиях ClickHouse?**
В рамках эволюции ClickHouse можно ожидать дальнейшее развитие адаптивного планирования PREWHERE, расширение автоматического переноса предикатов и улучшение статистических моделей столбцов для более тонкой оптимизации порядка обработки фильтров, а также углубление интеграции с отложенной материализацией и индексами, что может сделать PREWHERE еще более эффективным в сценариях больших данных.
Список вопросов и ответов охватывает ключевые тезисы статьи и предоставляет систематическую памятку о PREWHERE, её теории, архитектуре и практическом применении.


