

Типы данных и движки в ClickHouse
В современных корпоративных проектах данные служат не только источником материалов для отчетности, но и основой для предиктивной аналитики, мониторинга и автоматизированной эксплуатации бизнес-процессов. В условиях роста объема событий, телеметрии и логов критически важно двигаться от традиционных реляционных подходов к специализированной аналитической архитектуре, которая сочетает высокую производительность, масштабируемость и гибкость моделирования данных. В этом контексте ClickHouseвыступает одной из наиболее взвешенных реализаций колоночного аналитического хранилища, предлагая богатый набор движков, типов данных и паттернов проектирования, позволяющих строить эффективные DWH-решения.
Цель данного урока состоит в том, чтобы системно рассмотреть типы данных и движки в ClickHouseи связать их с практическими подходами к проектированию аналитического хранилища. Рекомендованный результат - сформированное представление о том, как выбор типа данных и движка влияет на скорость записи и чтения, как правильно проектировать партиционирование и сортировку для временных рядов, какие внешние и специальные движки существуют и для каких сценариев они применимы, а также какие риски, ограничения и метрики являются критичными на стадиях внедрения и эксплуатации.
Стратегически задача состоит в переходе от общих принципов к практическим паттернам: сначала определить архитектурные принципы, затем выбрать движки и типы данных под конкретные кейсы, далее описать принципы мониторинга, синергии в технологическом стеке и, наконец, привести примеры применения в реальных сценариях. В ходе изложения будут пояснены базовые термины: OLAP, DWH, ETL/ELT, MergeTree, PARTITION BY, ORDER BY, индексы данных, словари и репликация. Особое внимание уделяется тому, как материалы в ClickHouse раскрываются на практике: как создаются таблицы, как проектируются партиции, как работают слияния и обновления, и какие метрики позволяют оценивать устойчивость рабочих нагрузок.
Прежде чем перейти к конкретным механизмам и компонентам, важно зафиксировать фундаментальное соотношение между задачами бизнес-аналитики и техническими решениями. Первая часть разбирает, какие типы данных и как именно влияют на производительность аналитических запросов. Вторая часть посвящена архитектурным принципам ClickHouse, включая роль движков, хранения и запроса. Далее последовательно рассматриваются технологические компоненты и их взаимодействие, базовый аналитический движок MergeTree, механизмы партиционирования и сортировки, а затем - практическая демонстрация и кейсы. В конце будут рассмотрены риски, показатели эффективности и сравнительный анализ с альтернативами.
Типы данных ClickHouse и их влияние на производительность
Выбор типа данных в ClickHouse не ограничивается корректностью представления значения. Он определяет плотность хранения, компрессию, скорость чтения и влияние на планирование запросов. В аналитических нагрузках, где доминирует последовательный доступ к столбцам, типы данных оказывают решающее влияние на производительность и экономию ресурсов.
Ключевые принципы работы с типами данных в ClickHouse:
- Сжатие и кодированиезависят от конкретного типа. Например, числовые типы часто обеспечивают хорошую компрессию за счет плотной упаковки значений, тогда как строковые типы требуют грамотного выбора кодирования и использования оптимизированных представлений.
- LowCardinality (LowCardinality(String)) является эффективным механизмом сокращения памяти и ускорения агрегаций для полей с малым количеством уникальных значений, таких как классификаторы, коды статусов и прочие категориальные признаки. Однако чрезмерная детализация может снизить производительность при вставке и усложнить обновления.
- Nullableи обработка пропущенных значений: Nullable(T) позволяет явно моделировать отсутствие значения, но добавляет накладной расход на хранение и вычисления. В некоторых случаях целесообразно применять отдельные сигнальные флаги или двуслойные схемы хранения.
- Дата, время и временная метка: Date, DateTime, DateTime64 и их вариации (например, DateTime64(3)) дают точность до миллисекунд или микросекунд и поддерживают корректное и эффективное индексирование по времени, что критично для временных рядов.
- Специализированные типы: IPv4, IPv6, Decimal, UUID и другие типы оптимизируют хранение специализированных данных и облегчают фильтрацию и агрегацию. При этом важно понимать лимиты по точности, диапазону значений и скорости сравнения.
- Двухуровневая стратегия: для некоторых полей целесообразно использовать альтернативы, например, хранение идентификаторов в виде UInt64 и в отдельных столбцах держать человеко-читаемое представление или применить словари.
Идеальные практики:
- проектируйте столбцы с учетом частоты использования в фильтрах и группировках; для часто фильтируемых категориальных признаков применяйте LowCardinality;
- используйте DateTime64 для временных меток с высокой точностью и соответствующими настройками “precision”;
- избегайте избыточной детализации там, где она не приносит аналитической пользы, чтобы избежать расхода памяти и снижения скорости выполнения;
- устойчивость к изменениям и обновлениям может потребовать дополнительных механизмов (например, ReplacingMergeTree или словари), чтобы сохранить корректность результатов.
Рассматривая влияние типов данных на производительность, следует помнить, что выбор не является одноразовым решением. Он зависит от характера рабочих нагрузок: запросы по диапазону времени, точность агрегаций, частота обновления данных и требования к задержке. Эффективное проектирование начинается с анализа реальных сценариев чтения и записи и заканчивается настройкой компрессии, индексов и схемы представления данных под конкретные бизнес-цели.
Архитектура ClickHouse: движки, хранение и запросы
Архитектура ClickHouse строится на принципе разделения ответственности между компонентами: клиенты формируют SQL-запрос, серверная часть распознает запрос, планирует его выполнение и обменивается с системой хранения данных. Центральную роль играют двигки хранения, структура хранения и механизм выполнения запросов. Важнейшее отличие ClickHouse от некоторых традиционных систем - это ориентированность на колоночное хранение и высокую пропускную способность чтения больших объемов данных.
Основные элементы архитектуры:
- Клиентская часть: принимает SQL-запросы и возвращает результаты. В реальной инфраструктуре это могут быть BI-инструменты, сервисы аналитики, ETL/ELT-агенты или кластеры рабочих нагрузок.
- Серверная часть: управляющая логика, планировщик запросов и исполнительный движок. Здесь происходит разбор запроса, оптимизация, выбор движков и параметры исполнения.
- Движки хранения: основа для записи и чтения данных. В ClickHouse существует набор специализированных движков, начиная с базовых jednoduch-движков и заканчивая продвинутыми системами для распределения и буферизации.
- Хранение данных на диске: данные хранятся в виде частей (parts) внутри каждого партиционного сегмента. Архитектура MergeTree обеспечивает эффективное слияние в фоновом режиме, что позволяет поддерживать высокую производительность при больших объёмах данных.
- Репликация и распределение: для обеспечения доступности и масштабируемости ClickHouse поддерживает репликацию и распределенные запросы. Distributed-движок не хранит данные сам по себе, но позволяет выполнять запросы на нескольких узлах, тем самым достигая горизонтального масштабирования.
- Профилирование и мониторинг: система данных о состоянии выполнения запросов, задержках, пропускной способности, статусе фоновых процессов и состоянии партиций, что критично для эксплуатации.
Эта архитектура обеспечивает баланс между скоростью вставки и скорость анализа. В реальном сценарии выбор конкретного движка для таблицы определяется характером нагрузки: для больших временных рядов с периодическими обновлениями предпочтение часто отдают MergeTree, тогда как для взаимодействия с внешними источниками применяются соответствующие внешние движки. Важной концепцией является то, что данные в ClickHouse хранятся столбцами, что позволяет компрессии быть эффективной и обеспечивать быстрый доступ к нужным полям при выполнении аналитических запросов.
Декомпозиция технических компонентов и их взаимодействие
Источник эффективности ClickHouse лежит в четком разделении ответственности между компонентами и в принятых паттернах интеграции. Ниже приводится разбор ключевых компонентов и их взаимодействий в рамках типовой аналитической среды.
- Архитектура на уровне сервера: внутри кластера работают узлы, каждый из которых обеспечивает вычисления и хранение локальной части данных. В зависимости от конфигурации узлы могут быть реплицируемыми для отказоустойчивости и масштабируемости.
- Исполнение запросов: планировщик разбирает SQL, выбирает стратегию выполнения по частям и движкам, оптимизирует вычисления, применяет индексацию и фильтрацию на уровне данных.
- Фоны и фоновые процессы: MergeTree осуществляет асинхронное слияние частей, дефрагментацию данных и обновление индексов минимакс. Такие процессы позволяют поддерживать высокую скорость чтения даже после больших нагрузок на запись.
- Хранилище и данные: данные распаковываются и хранятся в виде частей и партиций на диске. Параметры хранения зависят от используемого движка и конфигурации файловой системы, включая политики TTL и управление удалением старых данных.
- Управление версиями и обновлениями: для некоторых сценариев важно поддерживать актуальность записей, возможна реализация через ReplacingMergeTree, TTL-условия и процессы оптимизации.
- Мониторинг и управление качеством обслуживания: сбор метрик по latency, throughput, lag merge, объему данных и состоянию партиций позволяет оперативно реагировать на деградации и корректировать конфигурацию.
Понимание взаимодействия этих компонентов помогает проектировать DWH-архитектуру в стиле «построение от принципов к реализации»: сначала определить требования к задержке, пропускной способности и консистентности, затем выбрать движок и типы данных, и только после этого переходить к настройке партиционирования, сортировки и индексов.
MergeTree как базовый аналитический движок: структура и принципы
MergeTree представляет собой ядро большинства аналитических таблиц в ClickHouse. Он обеспечивает эффективное чтение и агрегацию за счет структурирования данных в части (part) и партиций, поддерживает сортировку по заданной ORDER BY, а также предоставляет механизмы индексации и ускорения выборок.
Ключевые принципы MergeTree:
- data parts: данные организованы в части, которые могут быть независимо читаемыми и слияемыми позже. Части облегчают параллелизм и ускоряют выполнение запросов за счет локализованного доступа к данным.
- ORDER BY: порядок столбцов в этом выражении определяет физический сортировочный ключ. Он влияет на скорость фильтрации и агрегаций. В отличие от традиционной индексации, сортировка в ClickHouse применяется как внутренняя оптимизация доступа к данным, что делает выборку по критериям ORDER BY чрезвычайно эффективной.
- PRIMARY KEY и sorting key: в ClickHouse структура PRIMARY KEY чаще использована в сочетании с ORDER BY, возле ключа сортировки формируются требования к уникальности и быстрым точкам доступа; однако в контексте ClickHouse ключи не обеспечивают полного уникального индекса как в традиционных СУБД, а подсказывают планировщику запросов, как лучше организовать чтение.
- Минимальные и максимальные значения: механизмы в MergeTree поддерживают диапазонные индексы и skip-индексы, что существенно ускоряет фильтрацию по диапазонам.
- Слияние и сжатие: MergeTree выполняет фоновые операции слияния и удаления устаревших или помаркивающих данных, что поддерживает хорошую последовательность чтения и эффективную компрессию.
Эффективность MergeTree достигается через:
- грамотный выбор ORDER BY, который определяет физическую сортировку и, следовательно, выборку по диапазону времени и другим признакам;
- разумное использование типов данных и особенно внимания к формулам партиционирования;
- баланс между частями и нагрузкой на мониторинг фоновых процессов.
Реализация MergeTree позволяет строить гибкие модели данных, которые адаптируются к различным сценариям: от высокочастотной записи временных рядов до сложной агрегации больших массивов событий. В дальнейшем будут рассмотрены практические примеры партиционирования и настройка параметров, чтобы обеспечить оптимальный баланс между скоростью загрузки и эффективной аналитикой.
Партиционирование в MergeTree: методы и примеры
Партиционирование является критическим инструментом для оптимизации запросов по временным рядам и для управления данными на уровне хранения. В MergeTree партиционирование задается выражением PARTITION BY, а затем ClickHouse автоматически создает отдельные директории на диске для каждой партиции. Это позволяет выполнять элементарные фильтры на уровне партиции, снижая объем сканируемых данных и ускоряя запросы.
В типовом сценарии партиционирование по времени - наиболее распространенное решение. Например, если временная метка timestamp охватывает множество месяцев, можно разбивать данные по месяцу или по году и месяцу:
- PARTITION BY toYYYYMM(timestamp): разбиение по году и месяцу. Это позволяет быстро исключать целые месцевые секции при фильтрациях по времени.
- В то же время, выбор ORDER BY (timestamp, user_id) обеспечивает эффективную агрегацию и поиск по временным диапазонам и дополнительному ключу пользователя.
Управление партициями включает:
- просмотр существующих партиций: системный набор метаданных и системные таблицы ACC, которые позволяют отследить активные и неактивные партиции;
- перераспределение партиций: добавление новых, удаление старых в рамках политики TTL;
- принудительное слияние или удаление устаревших данных: в определенных условиях возможно применение OPTIMIZE TABLE, чтобы ускорить очистку и уменьшить фрагментацию.
Практические принципы:
- для временных рядов и логов рекомендуется использовать частое партиционирование по времени, при этом баланс между количеством партиций и эффективностью чтения важен: слишком мелкие партиции приводят к большему числу файлов, а слишком крупные - к увеличению объема сканируемых данных;
- если аналитика часто включает диапазоны и выборки по пользователям, можно комбинировать партиционирование по времени и упрощенную фильтрацию по дополнительным признакам в ORDER BY.
Понимание влияния партиционирования на планирование запросов является фундаментом для эффективного проектирования DWH на ClickHouse. В практических кейсах корректная настройка PARTITION BY позволяет существенно сократить задержки при чтении и повысить пропускную способность аналитических запросов.
ORDER BY, сортировка и индексирование в MergeTree
ORDER BY в MergeTree определяет физическую сортировку данных внутри каждой части. Этот выбор напрямую влияет на скорость выполнения фильтров и агрегаций, особенно при работе с большими объемами временных рядов. В ClickHouse отсутствуют традиционные “индексы” как в row-store базах; вместо этого применяются механизмы сортировки и минимакс-индексации.
Ключевые аспекты:
- сортировка по ORDER BY задает порядок значений. Фильтрация по диапазонам и точечные фильтры работают быстрее, когда условия соответствуют сортировке.
- минимакс-индексы и других контекстуальных индексов: внутри части создаются индексы на уровне минимального и максимального значений, что позволяет skipping-эффектам пропускать участки данных, не соответствующие запросу.
- настройка index_granularity и прочих параметров: параметры управляют размером блоков, используемых для минималистических индексов, и влияют на скорость чтения и памяти.
- единство ORDER BY и первичного ключа: хотя первичный ключ обычно ассоциируется с уникальностью, в ClickHouse эта концепция больше относится к ускорению операций фильтрации. ORDER BY влияет на физическую сортировку и доступ к данным, особенно в диапазонных выборках.
Практические подходы к выбору ORDER BY:
- если запросы часто фильтруют по времени и идентификатору пользователя, разумно выбирать ORDER BY так, чтобы первые ключи соответствовали временной оси, а затем уникализировали запросы по второму признаку.
- для больших наборов данных и частых диапазонных запросов по полям с высокой дисперсией можно учитывать сортировку по нескольким критериям, чтобы минимизировать количество сканируемых строк.
- при настройке параметров следует учитывать нагрузку на CPU и диск: избыточно сложный ORDER BY может привести к перерасходу ресурсов на вставку.
Эти принципы обеспечивают эффективную работу аналитических запросов и позволяют проектировать устойчивые и масштабируемые схемы данных.
Практическая демонстрация: создание таблицы access_logs с партиционированием
Для закрепления материала рассмотрим практический пример, адаптированный под обычную локальную установку ClickHouse. Целью будет демонстрация создания таблицы с партиционированием по месяцу и упором на типичные поля веб-логов.
-
Удаление старой таблицы (если существует): DROP TABLE IF EXISTS my_first_db.access_logs;
-
Создание новой таблицы с партиционированием: CREATE TABLE my_first_db.access_logs ( timestamp DateTime64(3), event_type LowCardinality(String), user_id UInt64, ip_address IPv4, url String, duration_ms UInt32 ) ENGINE = MergeTree() PARTITION BY toYYYYMM(timestamp) ORDER BY (timestamp, user_id);
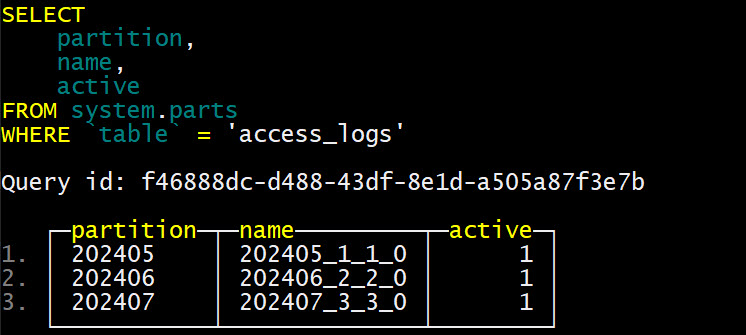
Здесь toYYYYMM(timestamp) извлекает год и месяц из временной метки (например, 202406 для июня 2024 года). ClickHouse автоматически создаст отдельные директории для каждой партиции на диске.
-
Вставка данных: INSERT INTO my_first_db.access_logs (timestamp, event_type, user_id, ip_address, url, duration_ms) VALUES ('2024-05-15 10:00:00.123', 'page_view', 100, '192.168.1.1', '/old_home', 150), ('2024-05-15 10:00:01.456', 'click', 100, '192.168.1.1', '/old_button_a', 20), ('2024-06-19 10:00:00.123', 'page_view', 101, '192.168.1.1', '/home', 150), ('2024-06-19 10:00:01.456', 'click', 101, '192.168.1.1', '/button_a', 20), ('2024-06-19 10:00:02.789', 'page_view', 102, '10.0.0.5', '/products', 300), ('2024-06-20 10:00:03.000', 'page_view', 101, '192.168.1.1', '/contact', 100), ('2024-06-20 10:00:04.111', 'click', 102, '10.0.0.5', '/product_details', 50), ('2024-07-01 08:00:05.222', 'page_view', 103, '172.16.0.10', '/home', 200), ('2024-07-01 08:01:05.222', 'page_view', 104, '172.16.0.11', '/home', 250);
-
Проверка партиций (локальная инсталляция или через системные таблицы):
- в инструменте clickhouse-client можно посмотреть созданные партиции и их состояния. Например: SELECT partition, active FROM system.parts WHERE table = 'access_logs' AND database = 'my_first_db' AND active = 1;
Рассмотренный пример демонстрирует простую схему партиционирования и сортировки, применимую к базовым кейсам веб-аналитики и логирования. В реальных проектах подобные таблицы дополняются дополнительными полями и настройками TTL, чтобы упростить хранение длительных периферийных данных.
Проверка партиций и мониторинг состояния на локальной инсталляции
После создания и загрузки таблицы важно обеспечить постоянный мониторинг состояния партиций, фоновых процессов и общей производительности. В ClickHouse существуют системные таблицы и инструменты, которые позволяют наблюдать за структурой данных и процессами, происходящими на узле или кластере.
-
Проверка существующих партиций: SELECT partition, active, modification_time FROM system.parts WHERE table = 'access_logs' AND database = 'my_first_db' ORDER BY partition;
-
Состояние фоновых процессов (слияние, очистка, обновления): SELECT FROM system.merges WHERE table = 'access_logs' AND database = 'my_first_db'; SELECT FROM system.mutations WHERE table = 'access_logs' AND database = 'my_first_db';
-
Объём занимаемого пространства и структура данных: SELECT partition, bytes_on_disk, marks FROM system.parts WHERE table = 'access_logs' AND database = 'my_first_db' ORDER BY partition;
-
Общая статистика сервера:
SELECT * FROM system.metrics;
SELECT FROM system.clusters; -- если используется кластер SELECT FROM system.asynchronous_networks;
- Визуализация задержек и нагрузки:
- latency по запросам (при использовании внешних инструментов мониторинга);
- throughput по чтению и записи;
- lagMerge как показатель задержки слияния.
Эти данные позволяют аналитическому архитектору и инженерам по эксплуатации своевременно выявлять узкие места, планировать масштабирование и корректировать конфигурацию партиционирования, чтобы поддерживать необходимый уровень SLA и качество сервиса.
Другие двигатели ClickHouse: общая характеристика и сценарии
Помимо MergeTree, ClickHouse предлагает ряд движков, каждый из которых предназначен для специфических сценариев. Основной мотив - обеспечить эффективное хранение и обработку для разных типов данных и рабочих нагрузок без необходимости полного переноса в сложный комплекс.
- Простые движки: предназначены для небольших объемов, где данные записываются последовательно и не изменяются. Не поддерживают ORDER BY, PARTITION BY. Применяются для временных таблиц, небольших логов и дебага.
- Движки для внешних систем: позволяют читать данные напрямую из внешних источников без импорта в ClickHouse. Это относится к Kafka, MySQL, PostgreSQL, ODBC/JDBC, S3, URL, File. Использование таких движков полезно при необходимости голого чтения или подключения к потоковым системам, облачным хранилищам или другим источникам данных.
- Специальные движки: Dictionary, Distributed, Buffer. Dictionary - хранение словарей в памяти для быстрого сопоставления значений; Distributed - обеспечивает выполнение распределенных запросов по нескольким серверам ClickHouse; Buffer - временная буферизация данных перед их записью в другие движки, обычно MergeTree.
Применение:
- Простые движки подходят для журналирования и тестирования; они обеспечивают простые сценарии без сложной аналитики.
- Внешние движки применяются, когда данные должны обрабатываться напрямую из источников, например, чтение потоков Kafka или загрузка данных из S3.
- Dictionary позволяет ускорить сопоставления и обработку больших наборов категориальных признаков в реальном времени.
- Distributed обеспечивает масштабируемость аналитики по кластеру и упрощает обработку больших рабочих нагрузок.
- Buffer применяется как этап буферизации для последующей записи в MergeTree, что помогает справиться с всплесками нагрузки.
Понимание особенностей каждого движка позволяет архитектору выбирать оптимальные паттерны интеграции и проектирования DWH. В связке с MergeTree они образуют мощный инструмент, который покрывает широкий спектр сценариев от локальных инсталляций до крупных кластерных конфигураций.
Простые движки: особенности и ограничения
Простые движки в ClickHouse - это легкие варианты хранения, которые эффективны при работе с малыми объёмами данных или когда требования к аналитике минимальны. Их основное преимущество - простота и скорость, но это достигается за счет ограничений по функциональности.
-
Основные характеристики:
- простота хранения без сложной индексации и без поддержки ORDER BY и PARTITION BY;
- чтение и запись в линейной последовательности;
- отсутствие сложных механизмов слияния.
-
Когда использовать:
- для временных таблиц, логов малого объема и процессов быстрой отладки;
- для тестирования концепций, где не требуется полноценная аналитика;
- в средах, где важна простота и минимальные накладные расходы.
-
Ограничения:
- отсутствие поддержки сложного аналитического синтаксиса;
- меньшая эффективность при запросах с фильтрациями и агрегациями;
- ограниченная управляемость в больших кластерах.
Понимание ролей простых движков помогает выбрать правильный инструмент для специфичной задачи и избежать излишнего усложнения архитектуры. В реальных проектах они часто применяются в роли вспомогательных таблиц или тестовых стендов.
Движки для внешних систем: Kafka, MySQL, PostgreSQL, ODBC/JDBC, S3, URL, File
ClickHouse поддерживает взаимодействие с внешними системами через специализированные движки, позволяющие считывать данные без их прямого копирования. Это облегчает интеграцию и снижает затраты на перенос.
- Kafka: движок для прямого чтения потоков данных в режиме реального времени. Применяется в сценариях реального времени, когда события публикуются в Kafka и требуют немедленной аналитики, без промежуточной загрузки.
- MySQL/PostgreSQL: позволяют выполнять прямые чтения из реляционных баз данных. Это полезно, если данные уже хранятся в этих системах и требуется объединение с ClickHouse без импорта. Однако реализация может ограничиваться задержками и синхронизацией.
- ODBC/JDBC: универсальные коннекторы для интеграции с различными источниками данных, включая старые системы, ERP, CRM и прочие базы.
- S3: прямой доступ к данным в облачном хранилище. Чаще применяется для хранения архивных данных и больших наборов файлов в формате Parquet, ORC и т. п.; ClickHouse может считывать данные без импортирования, поддерживая эффективную обработку.
- URL и File: позволяют получать данные по URL или из файловой системы. Это полезно для интеграции сайтов, лог-файлов и прочих источников, которые можно загрузить по сетевым путям или в виде файлов.
Когда использовать внешние движки:
- для чтения источников, которые регулярно обновляются и не требуют немедленного копирования в ClickHouse;
- когда данные существуют в других системах, доступ к ним осуществляется через коннекторы;
- в случаях, когда требуется минимизировать задержки обновлений и сохранить консистентность между системами.
Особенности:
- внешние движки читают данные без полного импорта, однако некоторые запросы могут потребовать синхронизации и кэширования на стороне ClickHouse;
- следует учитывать латентность доступа к внешним системам и влияние на производительность запросов;
- конфигурация и безопасность соединений (аутентификация, шифрование) являются критическими аспектами.
Эти механизмы расширяют реальную сфокусированность архитектуры на интеграции с существующим технологическим стеком и позволяют комбинировать эффективность аналитики внутри ClickHouse с данными из внешних систем.
Специальные движки: Dictionary, Distributed, Buffer
Помимо обычных движков, ClickHouse включает ряд специальных средств, расширяющих функциональность и расширяющих возможности по управлению данными и вычислениями.
- Dictionary: хранение словарей в памяти и на диске для быстрого сопоставления. Это полезно для ускорения обработки большого числа значений категориальных признаков путём преобразования их в целочисленные коды, что уменьшает объем памяти и ускоряет вычисления. Dictionary эффективно применяется в таких сценариях, как сопоставление идентификаторов, конвертация кода статуса, региональные сопоставления и др.
- Distributed: не хранит данные на самом сервере, но позволяет выполнять распределенные запросы по нескольким серверам ClickHouse. Это конструктор кластера, который позволяет масштабировать аналитические задачи над большим числом узлов и обрабатывать огромные объемы данных.
- Buffer: временная буферизация данных перед их записью в другие движки (обычно MergeTree). Буферизация помогает сгладить пики нагрузки и снизить влияние всплесков на производительность, предоставляя устойчивую запись в основной движок хранения.
Понимание роли этих инструментов помогает проектировать устойчивые решения, которые комфортно работают в условиях высокой нагрузки, требующей параллелизма и масштабирования.
Теоретическая база: основы управления версиями, словари, обновления и ReplacingMergeTree
Теоретические принципы управления версиями и обновлениями в ClickHouse реальны и влияют на согласованность данных в аналитических системах. В частности, механизм ReplacingMergeTree обеспечивает упорядочение записей по ключу версии и обновление данных в рамках процедуры объединения и замены старых версий на новые.
-
ReplacingMergeTree: базовый подход к обновлениям данных без поддержки полноценной транзакционности. Задача - обеспечить уникальность по user_id и корректное обновление записей на основе версионной колонки (version). Главные принципы:
- ORDER BY - задает ключ сортировки, который определяет порядок записей в партициях;
- version - колонка версии, которая позволяет определить более новые изменения;
- процесс слияния: между несколькими версиями одной сущности выбирается наиболее актуальная на основе версии.
- Управление версиями: для использования ReplacingMergeTree требуется дизассоциация между версией и уникальностью, а также понимание того, что замена не мгновенная и может потребовать времени на фоновые задачи.
- Идентификация дубликатов: задача устранения дубликатов и обеспечение уникальных записей для конкретного ключа может быть достигнута через адаптацию схемы и обработку на этапе вставки.
- OPTIMIZE TABLE FINAL: этот пункт** - средство принудительной агрегации и удаления устаревших версий данных в ход слитий. В реальном эксплуатации его применение должно быть осознанным, так как может повлиять на производительность в больших объемах данных.
Таким образом, ReplacingMergeTree представляет собой мощный инструмент, который позволяет поддерживать актуальность записей в условиях обновляющихся источников данных. Однако он требует внимательного проектирования и тестирования, чтобы определить оптимальные параметры слитий и мониторинга.
Интеграция технологических стеков и синергия: архитектурные паттерны и коннекторы
Современные архитектуры требуют синергии между ClickHouse и остальными компонентами технологического стека. В этом контексте архитектурные паттерны и коннекторы помогают выстраивать устойчивые инфраструктуры данных.
- ELT-подход: изменение фокуса с традиционного ETL на ELT, когда данные сначала загружаются в низкоуровневый слой в ClickHouse, а затем преобразовываются уже внутри системы аналитики, обеспечивая большую гибкость и мощность вычислений.
- Интеграция через коннекторы: внешние движки и коннекторы обеспечивают прямой доступ к источникам данных, что позволяет минимизировать задержку и сложность миграции. Взаимодействие с Kafka, PostgreSQL, MySQL, S3 и другими системами может происходить как через прямой загрузке, так и через промежуточные механизмы.
- Репликация и распределенность: Distributed-движок обеспечивает горизонтальное масштабирование и разворачивает запросы через несколько нод, сохраняя высокую доступность. В реальных сценариях это позволяет обеспечить устойчивость к сбоям и непрерывность анализа на больших кластерах.
- Cache and buffers: Buffer-движки используются для снижения давления на основной движок за счет временной буферизации изменений. Это полезно при резких всплесках или когда источники данных имеют переменный характер нагрузки.
- Архитектурные паттерны интеграции: пакетная загрузка (batch), стриминг (streaming), микросервисы (service-layer) и сервисная аналитика (analytics layer) - в зависимости от требований к латентности и сложности обработки. Выбор паттерна часто зависит от того, как данные проходят через слой конвертации и агрегации и как быстро нужна аналитика.
Теоретическая база интеграции и практические коннекторы создают основу для устойчивых систем, которые адаптируются к различным источникам данных и бизнес-тотребованиям. Эффективное сочетание паттернов с подходящими движками позволяет достигать высокой производительности и устойчивости в рамках реальных инфраструктур.
Кейсы применения в реальных сценариях: временные ряды, веб-аналитика и логи
ClickHouse демонстрирует существенную пользу во многих типах бизнес-аналитических сценариев. Ниже приведены наиболее распространенные кейсы, которые иллюстрируют принципы проектирования, применяемые движки и подходы к партиционированию.
-
Временные ряды: для телеметрии и мониторинга онлайн-сервисов характерна потребность в быстрой агрегации по временным диапазонам, вливания данных в реальном времени и эффективному хранению больших объемов событий. MergeTree с корректной партиционированием по времени и настройками индексации обеспечивает высокую скорость.
-
Веб-аналитика: анализ поведения пользователей на сайте включает обработку большого объема кликов, просмотров страниц и транзакций. В таких сценариях эффективна модель с большим количеством полей и категориями. Использование LowCardinality, многократно сортируемых ключей и фильтрации по времени обеспечивает быстрый доступ к данным.
-
Логи: логи несут огромное количество событий и требуют устойчивого хранения и эффективной агрегации. Партиционирование по времени помогает управлять старением логов, а сортировка по времени и IP-адресам обеспечивает быстрый просмотр по диапазону.
-
Интеграции с внешними системами: данные из потоков Kafka, источников S3, баз данных PostgreSQL/MySQL и внешних файлов позволяют гибко комбинировать данные без лишних затрат на перенос.
-
Аналитические тренды: временные тренды, корреляции между признаками потребления и операционные показатели - в контексте ClickHouse формируются мощные конвейеры, где данные проходят через слои конвертации и обогащения.
Практические кейсы показывают, что правильная реализация партиционирования, грамотный выбор ORDER BY и эффективное использование внешних движков и словарей могут существенно повысить скорость анализа и уменьшить задержку доступа к данным.
Возможности применения в экономических секторах: финансы, телеком, ритейл, промышленность
ClickHouse находит применение в широком диапазоне отраслей благодаря своей скорости и масштабируемости. В финансовом секторе он может использоваться для анализа торговых потоков, мониторинга рисков и аудита событий в реальном времени. В телекоммуникациях - для мониторинга QoS, анализа телеметрии и поведенческих паттернов пользователей. В розничной торговле - для анализа поведенческих паттернов в онлайн и офлайн каналах, оптимизации ценообразования и управления запасами. В промышленности - для анализа сенсорных данных, мониторинга оборудования и предиктивной аналитики.
- Финансы: обработка больших объемов временных рядов, торговых лент, риск-аналитика, аудит и соответствие требованиям регуляторов.
- Телеком: обработка телеметрии, событий и журналов, анализ взаимодействий, мониторинг качества услуг.
- Ритейл: анализ пользовательского поведения, корреляционные связи между акциями, посещениями и заказами, построение дашбордов в реальном времени.
- Промышленность: сбор данных от оборудования, анализ производственных параметров и техническое обслуживание.
Ключевые принципы в данных секторах - это баланс между задержкой, точностью и масштабируемостью, а также способность интегрировать данные из множества источников. ClickHouse предоставляет инструменты для конфигурации, которые позволяют адаптировать архитектуру под требования конкретной отрасли, включая параметры партиционирования, режимы репликации и обработку данных в реальном времени.
Анализ рисков, уязвимостей и ограничений: метрики эффективности и способы снижения
Любая архитектура аналитических систем должна учесть риски, связанные с производительностью, устойчивостью, безопасностью и стоимостью владения. В ClickHouse существуют характерные риски и подходы к их минимизации.
Основные риски:
- перегрузка запросами: чрезмерно крупные запросы или неэффективные фильтры по времени могут привести к задержкам;
- медленные фоновые процессы: задержки в MergeTree могут вызывать lag и снижение скорости обновления данных;
- неправильное партиционирование: неудачный выбор PARTITION BY может привести к перерасходу ресурсов и неэффективной фильтрации;
- обновления и версии: обновление записей через ReplacingMergeTree требует времени на слияние и может ухудшить консистентность на коротких участках времени;
- безопасность и доступ к данным: интеграция с внешними системами требует надлежащей настройки аутентификации и защиты, чтобы предотвращать несанкционированный доступ.
Метрики эффективности и способы снижения:
- latency: задержка выполнения запросов;
- throughput: пропускная способность чтения и записи;
- merge lag: задержка между поступлением данных и их полной интеграцией в дерево;
- storage usage: объем занимаемого места и темпы роста;
- количество партиций и их активность: мониторинг, чтобы предотвратить перегрузку файловой системы;
- устойчивость к сбоям: настройка репликации и стратегий восстановления.
Методы снижения рисков:
- тщательный анализ рабочих нагрузок и профилирование запросов;
- подбор ORDER BY, партиционирования и индексации для оптимизации;
- использование репликации и распределенности для повышения доступности;
- планирование и выполнение тестов на нагрузку, включая сценарии пиков;
- применение TTL и автоматическое удаление устаревших данных для контроля объема.
Эти принципы помогают сформировать устойчивую архитектуру, которая обеспечивает требуемую производительность и надёжность в условиях роста объема данных и сложности запросов.
Метрики эффективности и мониторинга: latency, throughput, merge lag, storage usage
Эффективный мониторинг является неотъемлемой частью эксплуатации ClickHouse. В рамках мониторинга критично отслеживать показатели производительности и состояние кластера. Ниже перечислены ключевые метрики и их интерпретация.
- Latency (задержка): время обработки запросов от момента отправки до получения ответа. Включает время планирования, вычисления и передачи результатов.
- Throughput (пропускная способность): количество обработанных операций в единицу времени. Включает вставку данных и выполнение запросов.
- Merge lag (задержка слияния): время, которое требуется MergeTree для завершения слияния частей и обновления индексов. Чем выше lag, тем дольше могут ждать данные об обновлениях.
- Storage usage (использование диска): объём занятого пространства и темпы роста со временем. Важно следить за ростом и планировать политику удаления устаревших данных.
- Partition activity (активность партиций): число активных партиций, частота обновлений и удалений. Влияет на планирование запросов и распределение нагрузки.
- System health (здоровье системы): процент доступности узла, ошибки и задержки.
- Query plan quality (качество плана запроса): анализ эффективности плана.
Инструменты мониторинга:
- встроенные системные таблицы ClickHouse (system.parts, system.merges, system.mutations, system.metrics);
- внешние системы мониторинга (Prometheus, Grafana);
- логирование и трассировка запросов;
- тестирование производительности на стенде.
Эффективный мониторинг обеспечивает раннее обнаружение проблем, планирование масштабирования и поддержание требуемого уровня SLA.
Конкурентный анализ решений и их дифференциация: Druid, Pinot, Snowflake, DuckDB
На рынке аналитических решений присутствуют конкурирующие платформы, каждая со своими сильными сторонами и характерными сценариями использования. Рассмотрим кратко, как ClickHouse сопоставляется с Druid, Pinot, Snowflake и DuckDB.
- Druid: ориентирован на сквозную обработку событий и OLAP-аналитику, часто применяется для дашбордов в реальном времени. Взаимодействие с ClickHouse может быть организовано как часть гибридной архитектуры, но Druid имеет собственные принципы хранения и индексации.
- Pinot: распределенная колонко-ориентированная база данных от LinkedIn, ориентированная на агрегированные запросы и быстрый запрос данных. В сравнении с ClickHouse Pinot чаще применяется в конвейерах реального времени, однако ClickHouse предоставляет большую гибкость по типам данных и источникам интеграции.
- Snowflake: облачный DWH с управляемой инфраструктурой и широкими возможностями хранения и обработки данных. ClickHouse отличается тем, что является автономной системой, которая может быть развёрнута локально или в облаке, но Snowflake обладает другими SLA и дорогой стоимостью владения.
- DuckDB: встроенная аналитическая база данных, ориентированная на локальный режим и быструю интерактивную аналитическую работу. DuckDB прекрасен для локальных сценариев и прототипирования, но ClickHouse намного выше по масштабируемости для больших объемов данных и обеспечения параллелизма.
Выбор между этими решениями зависит от целей, требований к latency, инфраструктурного бюджета и необходимости интеграции с внешними источниками данных. В корпоративной среде часто возникает Ответ: сочетание разных решений в рамках архитектуры для охвата разных сценариев - реального времени, пакетной обработки и истории.
Практические рекомендации по проектированию DWH на ClickHouse
Чтобы проектировать эффективное аналитическое хранилище на ClickHouse, следует учитывать сочетание теоретических принципов и практических нюансов:
- Определение требований: latency, throughput, SLA и объем данных. Разделить нагрузки на реальное время и пакетную обработку.
- Выбор движков и типов данных: MergeTree в сочетании с правильной схемой ORDER BY и PARTITION BY для временных рядов; применение LowCardinality для категориальных полей; использование Nullable и Decimal в зависимости от требований.
- Партиционирование и сортировка: проектировать PARTITION BY по времени для временных рядов и ORDER BY по времени и идентификатору пользователя. Рассмотреть минимакс-индексы для ускорения фильтров.
- Интеграция и коннекторы: определить источники данных** - внешние движки (Kafka, S3, URL, File), использовать Dictionary для эффективного сопоставления, рассмотреть Distributed для масштабирования.
- Управление версиями: применить ReplacingMergeTree, выбрать версию и ключ сортировки, планировать слитьи и обновления; использовать OPTIMIZE TABLE FINAL по мере необходимости, после тщательного тестирования.
- Мониторинг и эксплуатация: настроить мониторинг latency, throughput, merge lag, storage usage; планировать и тестировать процессы репликации и восстановления.
- Безопасность и комплаенс: реализовать шифрование, аутентификацию и авторизацию, контроль доступа к внешним источникам и данным внутри ClickHouse.
- Тестирование и устойчивость: симуляции пиковых нагрузок, тесты регрессии, контроль версий и агрегаций на реальных данных.
- Эволюция архитектуры: поддерживать гибкость к изменениям в источниках данных и требованиям, рассматривать расширения к кластерам и паттерны миграции.
Эти практические принципы позволяют выстроить устойчивую, масштабируемую и эффективную архитектуру DWH на базе ClickHouse, которая отвечает современным требованиям к данным и бизнес-аналитике.
В конце статьи: Вопрос-Ответ
-
Вопрос: Что такое MergeTree и почему он является базовым движком для аналитики в ClickHouse? Ответ: MergeTree - это семейство движков хранения в ClickHouse, оптимизированное под колоночное хранение, с механизмами партиционирования, сортировки, минимакс-индиксов и фонового слияния. Он обеспечивает высокую пропускную способность и эффективные диапазонные запросы, что делает его базовым выбором для аналитических таблиц.
-
Вопрос: Как выбор ORDER BY влияет на производительность запросов? Ответ: ORDER BY определяет физическую сортировку и влияет на способность быстро фильтровать по диапазонам, особенно по времени. Правильный выбор ключей ORDER BY уменьшает сканируемые данные и ускоряет агрегации.
-
Вопрос: Что дает партиционирование по месяцу в временных рядах? Ответ: Партиционирование по месяцу упрощает управление данными, ускоряет запросы в диапазоне времени и позволяет эффективно удалять устаревшие данные за счет TTL и архивирования.
-
Вопрос: Когда уместно использовать Dictionary в ClickHouse? Ответ: Dictionary применяют для быстрого сопоставления значений и уменьшения памяти за счет использования кодирования и оперативной памяти для часто встречающихся категориальных признаков.
-
Вопрос: Какие риски и ограничения следует учитывать при использовании ReplacingMergeTree? Ответ: Основные риски связаны с временной задержкой обновления версий, необходимостью планировать слития и возможность неполной консистентности между версиями данных до завершения фоновых операций.
-
Вопрос: Какие сценарии лучше всего подходят для использования внешних движков (Kafka, S3, URL, File)? Ответ: Внешние движки полезны, когда данные находятся в потоках (Kafka) или в хранилищах вне ClickHouse, и есть потребность читать данные без импорта, например для стриминга, интеграции с S3 или источниками, доступными по URL.
-
Вопрос: Какие метрики критичны для мониторинга DWH на ClickHouse? Ответ: Ключевые метрики - latency, throughput, merge lag, storage usage, активность партиций и общие показатели здоровья кластера. Они позволяют оценить производительность и планировать горизонтальное масштабирование.
-
Вопрос: Каковы основные принципы проектирования DWH на ClickHouse? Ответ: Основные принципы включают стратегический выбор типов данных и движков, продуманное партиционирование и ORDER BY, грамотную интеграцию с внешними источниками, использование словарей и паттернов распределения, а также систематический мониторинг производительности и рисков.
-
Вопрос: Какие практические принципы следует учитывать при внедрении DWH для временных рядов? Ответ: Временные ряды требуют частого партиционирования по времени, эффективного фильтра по диапазонам и грамотного подхода к хранению с использованием MergeTree и минимакс-индексов, а также мониторинга задержек в слиянии и распределения нагрузки.
-
Вопрос: Какой подход к миграции данных наиболее эффективен в ClickHouse? Ответ: Эффективна модель ELT с постепенной миграцией, использованием внешних движков для чтения и миграциями через сравнение данных, с тестированием на стенде, чтобы не нарушать текущую работу в продакшене.
-
Вопрос: Какие ключевые различия между ClickHouse и Snowflake? Ответ: ClickHouse - автономная система с широкими возможностями конфигурации и гибкостью развертывания, Snowflake - облачный DWH с управляемой инфраструктурой и специфическими SLA. Выбор зависит от бюджета, требований к управлению инфраструктурой и скорости внедрения.
-
Вопрос: Какие факторы следует учесть при выборе архитектурного паттерна для крупного кластера? Ответ: Важны требования к задержке, масштабируемости, устойчивости, доступности, стоимости, потребностям к интеграциям, уровню поддержки внешних источников и потребности в аналитической стойкости.
-
Вопрос: Какие возможности для анализа экономических данных предоставляет ClickHouse? Ответ: ClickHouse поддерживает временные ряды, кросс-разрезные агрегации, сложные фильтры и объединения, которые необходимы в финанасах, телекомму, ритейле и промышленности. Интеграции с внешними системами позволяют объединять данные из разных источников и строить эффективные дашборды.
-
Вопрос: Какие шаги предпринимать на этапе проектирования DWH? Ответ: Необходимо начать с анализа требований к нагрузкам и данным, выбрать базовый движок и партиционирование, определить стратегию интеграции, выбор словарей и режимов обновления, настроить мониторинг и провести нагрузочное тестирование на стенде.
Эта серия вопросов и ответов резюмирует ключевые тезисы статьи и подчеркивает практическую направленность рассмотренных концепций, позволяя аналитикам, архитекторам и руководителям data-направлений использовать материал в реальных проектах по проектированию DWH на основе ClickHouse.


