

Скорость вставки данных в ClickHouse: архитектура, конфигурации и стратегии оптимизации
Введение: цели анализа скорости вставки данных в ClickHouse
В контексте современных систем анализа больших данных скорость загрузки данных в хранилища и витрины является критическим параметром операционной эффективности. ClickHouse как колонноподобная система управления базами данных ориентирован на пакетную вставку больших массивов данных и демонстрирует свои особенности именно в контексте больших потоков данных. Данная статья ставит целью рассмотреть архитектурные принципы, конфигурационные параметры и практические стратегии оптимизации скорости вставки данных, чтобы аналитикам, архитекторам и руководителям data-направлений было понятно, где сосредоточены узкие места и какие подходы позволяют достигать требуемых целевых уровней пропускной способности и задержек.
Поставленная задача решается через систематическую декомпозицию факторов на три взаимосвязанных уровня: аппаратная основа (ресурсы ЦП, память, диски, сеть), внутренняя архитектура ClickHouse (табличные движки, индексы, фоновые процессы), а также внешние влияния, связанные с форматом данных, клиентскими протоколами и сетью. В рамках этого исследования особое внимание уделяется типовым паттернам нагрузки, характерным примам пакетной вставки, механизмам сжатия и репликации, а также архитектурным решениям, которые минимизируют задержку и максимизируют пропускную способность без компромиссов по целостности и надежности данных.
Ключевая мысль статьи состоит в том, что, хотя многие факторы влияют на входной поток данных, наиболее эффективные улучшения достигаются за счет продуманной балансировки между клиентской подготовкой данных, форматом передачи и внутренним процессом обработки на сервере: пакетирование, предварительная сортировка и формат данных на клиенте, минимизация времени распаковки и анализа форматов на сервере, эффективное управление фоновой работой по слиянию частей данных, а также аккуратная настройка репликации и сжатия.
Теоретическая база: принципы колоночного хранения, архитектура MergeTree и основы быстрого ввода
Колоночное хранение предполагает, что данные физически записываются столбцами, а не строками. Такой подход обеспечивает эффективную компрессию и быстрые скана форматов запросов, ориентированных на агрегирования и фильтры по нескольким столбцам. В ClickHouse основное место занимает семейство движков MergeTree, которые разделяют данные на части (parts) и поддерживают инкрементальные обновления и слияния. Архитектура MergeTree обеспечивает:
- хранение данных по столбцам, что облегчает эффективное сжатие и селективный доступ;
- упорядочение по ключу сортировки, который формирует физически упорядоченный диск разрезами;
- фоновые процессы слияния мелких частей в более крупные, что улучшает запросы и управляемость пространства;
- поддерживаемый индекс - первичный ключ, образующий упорядоченность и ускоряющий точечные и диапазонные запросы.
Основы быстрого ввода связаны с тем, что вставка в ClickHouse происходит пакетами (батчами) и параллельно обрабатывается несколькими потоками. В теоретическом плане скорость вставки определяется тремя группами факторов: вычислительная мощность и память; скорость дискового ввода-вывода и сетевые перегрузки; а также накладные расходы на распаковку, декодирование форматов и организацию блоков данных на сервере. Важной особенностью является то, что размер батча влияет на число операций записи и на время, необходимое для их завершения; слишком маленькие батчи создают перегрузку, а слишком большие батчи увеличивают латентность отдельно взятой вставки и требуют больших ресурсов сервера. Эффективная реализация быстрого ввода требует балансировки между скоростью распаковки данных, временем сортировки по ключу и эффективной записью на диск.
Ключевые понятия, которые должны быть зафиксированы при анализе скорости вставки:
- батчинг (пакетирование) данных в отправках от клиента к серверу;
- параллелизм и многопоточность на стороне сервера и клиента;
- выбор движка таблицы и ключи сортировки;
- фоновое слияние частей и влияние на ресурсы;
- форматы данных и их бинарность/текстовость;
- настройки сжатия и влияние на вычислительную нагрузку;
- репликация и координация в рамках кластера.
Декомпозиция технических компонентов и их взаимодействия
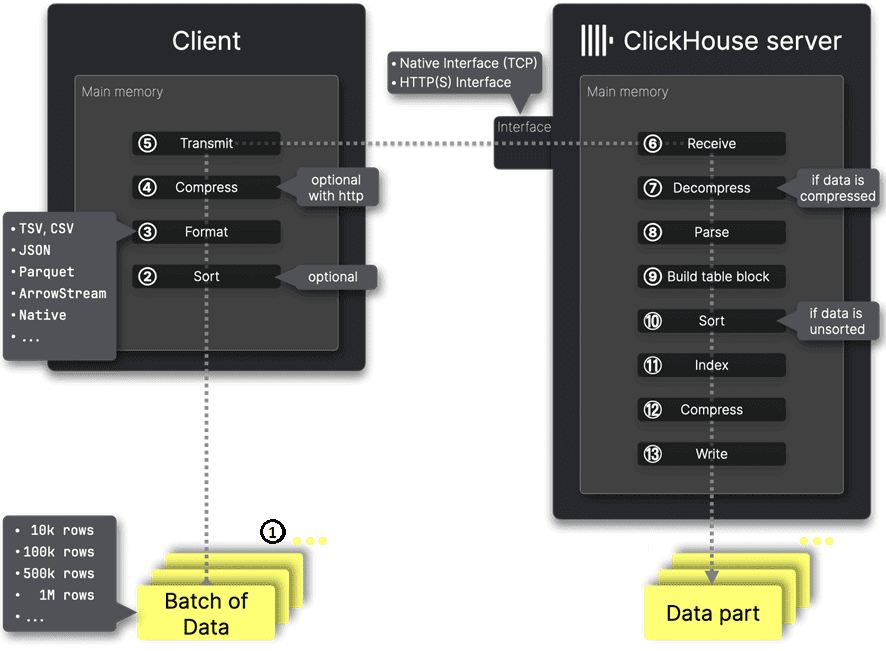
Взаимодействие между компонентами вставки данных в ClickHouse можно представить как цепочку, проходящую через клиентскую подготовку данных, сетевое сообщение и серверную обработку. На клиенте формируется пакет данных, который может быть дополнительно предварительно отсортирован по ключу сортировки (для ускорения последующей сортировки на сервере) и упакован в удобный формат. Затем данные поступают на сервер через нативный протокол ClickHouse или через HTTP-интерфейс. На сервере выполняется распаковка, анализ формата, создание блока в формате MergeTree, сортировка по первичному ключу (PK), построение разреженного индекса и применение столбцового сжатия перед записью на диск.
Взаимодействие между компонентами зависит от ряда параметров и ограничений:
- скорость сети и задержки пакетирования данных;
- размер батчей и количество рабочих потоков;
- режим выполнения вставки на клиенте (синхронный vs асинхронный);
- выбор движков таблиц и конфигурационных параметров сортировки;
- режимы сжатия и их вычислительная стоимость;
- наличие репликации и согласования через систему координации (ZooKeeper/ClickHouse Keeper);
- состояние фоновых процессов слияния и их влияние на нагрузку.
Аппаратные ресурсы и их влияние на вставку: CPU, память, диск, сеть
В основе любой операции вставки лежат физические ресурсы сервера. Эффективность вставки определяется балансом между вычислительной мощностью и пропускной способностью хранилища. Ключевые аспекты:
- CPU: ClickHouse хорошо масштабируется по ядрам. Высокая тактовая частота и количество ядер позволяют распараллеливать операции вставки, распаковку данных и применение сжатия. В рамках пакетной вставки многопоточность помогает уменьшить задержку на уровне сервера, но не всегда линейно масштабируется; предел достигается из-за конкуренции за кэш, очередей и I/O.
- память: для эффективной работы MergeTree необходим достаточный объем оперативной памяти для кеширования часто используемых данных и структур, а также для формирования блоков перед записью на диск. Недостаток памяти приводит к частым обращениям к диску и снижению производительности.
- диски: SSD существенно ускоряют запись и чтение по сравнению с HDD. Важна общая производительность дисков и возможность параллельных операций ввода-вывода. Использование RAID-массивов может увеличить пропускную способность за счет параллелизма чтения и записи.
- сеть: вставка данных в ClickHouse происходит через сеть. Высокая загруженность или низкая пропускная способность сети могут стать узким местом, особенно при больших объемах пакетной передачи. Наличие достаточной пропускной способности и минимизация задержек существенно влияют на общую скорость вставки.
Разделение нагрузки и правильная конфигурация аппаратных ресурсов помогают добиться баланса между временем записи и временем ожидания в очереди обработки. В условиях ограниченной памяти и медленного дискового ввода-вывода целесообразно рассмотреть увеличение объема кэш-памяти и оптимизацию размера батча, чтобы снизить число операций записи.
Конфигурация ClickHouse: движки таблиц, ключи сортировки, фоновые процессы слияния
Архитектура ClickHouse предполагает гибкую настройку параметров через движки таблиц, ключи сортировки и фоновые процессы. Основные принципы:
- движки семейства MergeTree обеспечивают структурированное хранение и эффективное выполнение запросов с фильтрами по колонкам. Вставка в такие таблицы записывает данные в виде партий, которые затем могут объединяться в рамках фоновой работы;
- ключ сортировки (ORDER BY) - определяет физическую упорядоченность частей данных. Правильный выбор ключа сортировки критически влияет на скорость вставки и последующих запросов. Неправильно выбранный PK может привести к неравномерному распределению и большему числу маленьких частей;
- фоновые процессы слияния (merge) объединяют мелкие части в крупные. Это повышает эффективность последующих запросов, но потребляет CPU и I/O. В период высокой вставки фоновые слияния могут конкурировать за ресурсы, что может снизить скорость вставки.
- настройки сжатия: уровень и алгоритм сжатия влияют на размер данных на диске и время записи/распаковки. Более сильное сжатие уменьшает сетевой трафик и диск, однако увеличивает вычислительную нагрузку на кодирование и распаковку.
- параметры репликации и координации: репликация обеспечивает надежность и доступность данных, но добавляет задержку из-за синхронизации между узлами. В кластере с географическим разнесением нагрузка на сеть и задержки возрастают, что может негативно сказаться на скорости вставки. В качестве альтернативы для координации часто рассматривают ClickHouse Keeper вместо ZooKeeper.
Оптимальная конфигурация зависит от характера нагрузки и целей системы. Например, для витрин данных с частыми большими пакетами данных разумно устанавливать размер батча на уровне сервера и клиента так, чтобы балансировать между количеством операций записи и временем ожидания. В то же время для реплицируемых кластеров следует продумать параметры согласования и задержки репликации, чтобы не создавать узких мест в скорости ввода.
Пакетирование вставок: размер батча, параллелизм, многопоточность
Пакетирование является центральной концепцией производительности вставок в ClickHouse. Эффективный размер батча достигается через компромисс между:
- количеством записей в батче и временем обработки на сервере;
- параллелизмом на сервере и клиенте;
- накладными расходами на упаковку и распаковку данных.
Перед вставкой целесообразно обеспечить единый порядок обработки данных, особенно если применяется сортировка по PK. Пакетирование должно учитывать формат данных и доступную пропускную способность сети. В ситуациях высокой нагрузки параллелизм может быть достигнут за счет многопоточной отправки параллельных батчей или использования брокеров сообщений (например, Kafka) как промежуточного слоя, который буферизует данные и распределяет их по нескольким воркерам сервера.
Ниже приводятся ключевые аспекты настройки:
- размер батча: оптимальный диапазон зависит от скорости сети и внутренней обработки сервера; слишком маленькие батчи приводят к большему числу операций, слишком большие - к задержкам и более высоким требованиям к памяти;
- параллелизм: увеличение числа параллельных потоков может ускорить вставку, но с ростом числа потоков возрастает контекстная переключаемость и конкуренция за кэш;
- многопоточность: использование многопоточности как на стороне клиента, так и на стороне сервера должно соответствовать реальной аппаратной возможности и нагрузке.
Применение асинхронной вставки и использование внешних брокеров сообщений может существенно снизить влияние задержек клиентской стороны и повысить устойчивость к перегрузкам.
Форматы данных и структура вставляемых данных: простые vs сложные, бинарные vs текстовые
Форматы данных влияют на скорость упаковки, передачу и разбор на стороне сервера. Простые типы данных (числа, строки фиксированной длины, булевы значения) обрабатываются легче и быстрее, чем сложные структуры (массивы, вложенные документы, JSON), потому что требуют меньше операций декодирования и разборки. ClickHouse поддерживает множество форматов, что позволяет выбрать наиболее эффективный под конкретное приложение. Важной особенностью является факт, что бинарные форматы обычно обрабатываются быстрее текстовых, поскольку требуют меньше времени на парсинг текста и конвертацию типов данных.
Однако следует учитывать, что выбор формата зависит от того, как данные формируются на стороне клиента: простые типы допускают более эффективную сериализацию, в то время как сложные структуры требуют дополнительной обработки и могут увеличивать размер батча. Оптимальная стратегия - выбрать формат, который минимизирует вычислительную нагрузку на сервере при сохранении целостности данных и совместимости с последующим потреблением данных.
Сжатие данных может быть применено как на стороне клиента перед отправкой, так и на стороне сервера. Вариант сжатия на клиенте снижает сетевой трафик, но требует дополнительных вычислительных ресурсов. На сервере сжатие влияет на хранение, чтение и дальнейшие запросы, и требует оценки компромисса между экономией дискового пространства и задержками на обработку.
Настройки сжатия и их влияние на производительность
Сжатие - важный механизм экономии сетевых ресурсов и пространства на диске. Однако сжатие потребляет вычислительную мощность для кодирования данных и декодирования при чтении. Эффективность сжатия зависит от характера данных и выбранного алгоритма. В ClickHouse применяются различные алгоритмы сжатия, которые можно подбирать под конкретный формат и профиль нагрузки. Основной баланс достигается между следующими параметрами:
- скорость кодирования/декодирования: алгоритмы с высокой степенью сжатия часто требуют больше вычислительных ресурсов;
- размер сжатого блока: более крупные блоки дают лучшую компрессию, но требуют большего объема памяти;
- влияние на латентность: дополнительное время на сжатие может увеличить задержку вставки, особенно при больших объёмах данных;
- совместимость с форматом: некоторые форматы лучше сочетаются с определенными алгоритмами сжатия.
Практически целесообразно на начальном этапе определить профиль данных и выбрать компрессионный режим, который обеспечивает баланс между пропускной способностью и latency. В некоторых случаях целесообразно использовать слабое сжатие на входе и более интенсивное для долговременного хранения, если задача состоит в минимизации сетевого трафика и ускорении вставки.
Репликация, координация и надёжность: репликация, ZooKeeper/ClickHouse Keeper, проверки целостности
Репликация обеспечивает отказоустойчивость и доступность данных, но добавляет сетевые и вычислительные накладные расходы на синхронизацию между узлами. В кластерах ClickHouse репликация реализуется через специализированные механизмы, которые требуют координации между узлами. В классической конфигурации используется ZooKeeper - централизованная система координации состояний, управления метаданными и синхронизации операций. В современных реализациях возможно применение собственного решения ClickHouse Keeper, который обеспечивает ту же функциональность, но оптимизирован под особенности ClickHouse и обеспечивает более тесную интеграцию.
Проверки целостности данных и журналирование операций - важные элементы надежности. Эти механизмы влияют на производительность, поскольку требуют обработки метаданных и верификации. В высоконагруженных средах необходимо выбирать параметры репликации и координации, которые минимизируют задержки при сохранении ожидаемого уровня отказоустойчивости. Возможна настройка поведения при сбоев, частоты синхронизаций и режимов консистентности, что влияет на общую скорость вставки.
Интерфейсы взаимодействия: нативный протокол vs HTTP
ClickHouse предоставляет нативный протокол и HTTP-интерфейс для вставки данных. Нативный протокол обычно обеспечивает более низкие задержки и меньшую избыточность, что favorable при больших нагрузках и пакетных вставках. HTTP-интерфейс может быть удобен для интеграций через стандартные веб-совокупности, а также для ситуаций, когда требуется обход сложностей с открытыми пробросами портов или обходом некоторых ограничений сетевого уровня. Влияние интерфейса на скорость вставки обусловлено накладными расходами на сериализацию, обработку HTTP-заголовков, а также на обработку коннекций. В большинстве сценариев нативный протокол предпочтителен для достижения максимальной пропускной способности и более низких латентностей.
Формирование и обработка клиента: подготовка данных на стороне клиента: сортировка, формат, компрессия
Эффективная вставка начинается с подготовки данных на стороне клиента. В рамках этой подготовки разумно:
- пакетировать данные в разумные батчи, сохраняя баланс между количеством запросов и задержкой;
- выполнять сортировку данных по ключу сортировки на клиенте, чтобы снизить объём работы сервера по сортировке и ускорить создание блока в памяти;
- приводить данные к формату, наиболее эффективному для обработки сервером, чтобы минимизировать CPU-ресурсы на распаковку и декодирование;
- применять компрессию перед отправкой, чтобы уменьшить сетевой трафик и ускорить передачу больших объемов.
Если клиентская сторона обеспечивает эффективную подготовку данных, уменьшаются нагрузки на сервер и улучшается общая производительность вставки. В этом контексте выбор формата передачи и алгоритма компрессии на стороне клиента может быть критическим фактором, особенно при больших объемах и географически распределённых источниках.
Настройки клиента: синхронная vs асинхронная вставка, буферизация, интеграция с брокерами
Клиентская часть вставки может работать в синхронном или асинхронном режимах. В синхронном режиме каждый батч вставляется с ожиданием подтверждения сервера, что увеличивает задержку, но упрощает логику обработки ошибок. В асинхронном режиме клиент может продолжать отправку данных, не дожидаясь подтверждений, что существенно повышает пропускную способность и устойчивость к перегрузкам. Однако асинхронность требует более сложной логики обработки ошибок и подтверждений, а также подходов к повторной отправке и консистентности.
Буферизация на стороне клиента может значительно снизить число сетевых запросов и улучшитьок, если она корректно согласована с серверной обработкой. Интеграция с брокерами сообщений (например, Apache Kafka) позволяет потолок скорости на входе пропускать через буфер и распределять данные по нескольким воркерам сервера, тем самым сглаживая пики нагрузки и уменьшив задержку для отдельных батчей.
Процесс приема на сервере: распаковка, анализ формата, создание блока, сортировка PK, первичный индекс, сжатие, запись на диск
После получения данных сервер выполняет последовательный ряд действий:
- распаковка данных и декодирование формата (для сжатых батчей);
- анализ формата и конвертация в внутренний формат блока MergeTree;
- сортировка строк по столбцам первичного ключа (PK) внутри блока (если данные не отсортированы на клиенте);
- создание разреженного первичного индекса на базе PK;
- применение столбцового сжатия к каждому столбцу;
- запись готового блока на диск в структуру parts.
Этот набор операций определяет задержку вставки и общую производительность. Оптимизация на сервере чаще всего достигается через минимизацию повторной сортировки, эффективную организацию памяти под блоки и баланс между частотой фоновых операций слияния и реальной вставкой.
Оптимизационные стратегии: перенос подготовительных этапов на клиента, минимизация серверной загрузки
На практике одна из наиболее эффективных стратегий - перенести как можно больше подготовки данных на клиента. Это включает:
- пакетирование данных на клиенте с учётом ограничений пропускной способности сети;
- сортировку на стороне клиента по PK, чтобы сервер мог просто «принять» уже отсортированный блок, избегая чище вычислительных затрат;
- конвертацию в максимально эффективный для сервера формат;
- предварительную компрессию данных на стороне клиента для снижения сетевых затрат.
Эти подходы позволяют уменьшить временные издержки на серверах и освободить ресурсы для приема новых батчей. В результате общий throughput может вырасти благодаря снижению вычислительных затрат на серверной стороне.
Влияние сетевой инфраструктуры на вставку
Сетевые параметры являются критическими для скорости вставки в распределённых конфигурациях. Важно учитывать:
- пропускную способность канала между источником данных и кластером;
- задержки (latency) на маршруте;
- устойчивость сетевых узлов и качество связи, включая возможные потери пакетов;
- влияние сетевых очередей и MTU на фрагментацию и эффективность передачи.
Оптимизация сетевой инфраструктуры, в том числе проксирования, балансировки нагрузки и выбор оптимальных маршрутов, может существенно снизить задержки и повысить пропускную способность. В некоторых сценариях разумно использовать локальные каналы связи для снижения задержек между источником данных и ближайшими нодами кластера.
Метрики эффективности и оценка производительности: latency, throughput, I/O, memory
Для объективной оценки скорости вставки используются следующие метрики:
- latency (задержка) вставки: время от отправки данных до подтверждения записи на диске;
- throughput (пропускная способность): количество обработанных записей в единицу времени;
- I/O-окружение: интенсивность операций ввода-вывода, загрузка дисков;
- memory-использование: потребление ОЗУ в рамках формирования блоков и кэширования;
- нагрузочные тесты: сценарии пиковых нагрузок, тесты устойчивости и тесты для оценки предела пропускной способности.
Эти метрики должны анализироваться совместно с индикаторами надежности и целостности данных, чтобы обеспечить баланс между скоростью вставки и долгосрочной устойчивостью системы.
Кейсы применения в реальных сценариях: загрузка больших наборов, витрины, DWH
Реальные сценарии демонстрируют разнообразные паттерны вставки:
- загрузка больших наборов данных в витрину данных и DWH (data warehouse) на дневной или недельной основе; здесь требуется высокая пропускная способность и минимальная задержка;
- массовая загрузка логов или событий с высоким быстрым incoming-рейтом; требуется эффективная параллелизация и устойчивость к перегрузкам;
- загрузка витрин, ориентированных на частичные обновления и детерминированную сортировку по PK для последующих оптимизированных запросов.
У каждого сценария существует свой баланс между батчами, параллелизмом и режимами репликации. Важно подбирать параметры под конкретную рабочую нагрузку и требования к SLA.
Интеграция стеков: ETL/ELT, Kafka, очереди, конвейеры
Интеграционные стеки позволяют гибко управлять потоками данных и распределять нагрузку между клиентами и серверами. В практических решениях применяются:
- ETL/ELT-подходы (Extract, Transform, Load / Extract, Load, Transform) с различной степенью трансформации на стороне источника и на стороне хранилища;
- брокеры сообщений (Kafka, RabbitMQ) для буферизации потоков и обеспечения устойчивости к всплескам нагрузки;
- конвейеры обработки данных (data pipelines) с управлением параллелизмом, ретрансляцией и мониторингом.
Такие стеки позволяют динамически регулировать поток вставки, снижать риск перегрузок и повышать устойчивость к сбоям. Важно обеспечить согласование форматов данных и схемы между различными компонентами конвейера, чтобы избежать ошибок на этапе вставки.
Применение в экономических секторах: финансы, розничная торговля, телеком, здравоохранение
Различные секторы предъявляют уникальные требования к скорости вставки:
- финансы: высокие требования к консистентности и скорости загрузки событий транзакций, строгие SLA;
- розничная торговля: загрузка витрин, аналитика продаж в реальном времени, обработка большого объема событий;
- телеком: потоковые логи и метрики, массовая агрегация и анализ;
- здравоохранение: загрузка данных мониторинга пациентов и структурированных записей, требования к безопасности и конфиденциальности.
В каждом секторе оптимальные настройки батчей, формат данных, режимы сжатия и репликации будут отличаться в зависимости от требований к latency, throughput и надежности.
Анализ рисков, ограничений и уязвимостей: безопасность, устойчивость, мониторинг, риск-метрики
Любая система вставки несет риски: безопасность данных, неполадки при синхронизации между узлами, риск потери данных при сбоях, а также риск перегрузок и деградации производительности. Важные направления анализа включают:
- безопасность: ограничение доступа, шифрование в транзите и на диске, контроль целостности;
- устойчивость: репликация и резервирование, мониторинг доступности узлов и журналирования изменений;
- мониторинг: сбор и анализ метрик (latency, throughput, I/O, memory) и визуализация для своевременного реагирования;
- риск-метрики: определение порогов по SLA, отказоустойчивость и риск пробелов в консистентности, тестирование на стрессовых сценариях.
Эффективная стратегия - сочетать строгие политики безопасности и гибкие процедуры мониторинга, чтобы быстро выявлять и устранять проблемы, не снижающего общую производительность.
Конкурентный анализ решений и их дифференциация: сравнение с Druid, Pinot и др.
Сравнение ClickHouse с конкурентами требует учета ряда факторов, включая скорость вставки. Druid и Pinot предлагают альтернативные подходы к аналитике в реальном времени, но ClickHouse часто становится предпочтительным выбором для пакетной загрузки больших объемов данных и больших витрин. Основные дифференциаторы:
- архитектура и модель хранения: колоночная структура и MergeTree как ядро ClickHouse;
- поддерживаемые форматы и скорость вставки через нативный протокол;
- функциональность репликации и координации, масштабируемость и простота эксплуатации;
- набор функций для аналитического анализа, оптимизаторов запросов и поддержка широкого спектра форматов.
Понимание этих различий позволяет определить, какой стек больше соответствует конкретной задаче, требующей высокой скорости вставки и устойчивости.
Практические примеры и методика оценки: тесты, метрики, пороги
Практические примеры включают моделирование типовых сценариев вставки: загрузку витрин данных, непрерывную загрузку лент и пакетную загрузку больших наборов. Методика оценки включает:
- постановку целевых порогов по latency и throughput;
- проведение стресс-тестов с варьируемыми батчами и параллелизмом;
- мониторинг I/O, памяти и CPU на отдельных узлах;
- анализ влияния форматов данных, алгоритмов сжатия и протоколов на время вставки.
Результаты тестов позволяют определить оптимальные настройки: размер батча, уровень параллелизма, режимы сжатия и выбор движков таблиц, которые максимизируют пропускную способность без потери консистентности.
Рекомендации по реализации и внедрению
1.Определить требования к SLA в части скорости вставки и устойчивости, чтобы выбрать оптимальные параметры кластера: количество узлов, репликацию, конфигурацию Keeper.
2.Применить стратегию клиентской подготовки: батчинг, сортировку по PK и выбор эффективного формата данных и компрессии.
3.Оптимизировать выбор движков таблиц и настройку ключей сортировки, чтобы минимизировать количество мелких частей и ускорить последующую обработку.
4.Установить баланс между фоновой работой слияния и вставкой: минимизировать конкуренцию за ресурсы путем тонкой настройки параметров MergeTree.
5.Развернуть мониторинг по ключевым метрикам и регулярно проводить стресс-тесты, чтобы поддерживать предсказуемую производительность.
Направления дальнейшего развития и выводы
С точки зрения архитектуры и практики, развитие направлено на улучшение интеграций с брокерами сообщений, оптимизацию координации репликации и развитие настроек адаптивного батчирования. В контексте сетевой инфраструктуры дальнейшее развитие предполагает более гибкое распределение нагрузки по узлам, выбор оптимальных маршрутов и эффективное управление задержками. С точки зрения методологии, дальнейшее развитие включает расширение методик тестирования, формализацию пороговых значений и практик по автоматической настройке параметров на основе реальных профилей нагрузки. В целом, достижение высокой скорости вставки в ClickHouse требует системного подхода, который охватывает аппаратную основу, внутрненнюю архитектуру СУБД, клиентскую подготовку и сетевые аспекты, а также постоянное совершенствование методик мониторинга и автоматизации.
Итоговый обзор: синергия стратегий ускорения вставки
Сочетание оптимизации на стороне клиента (пакетирование, сортировка, формат, сжатие), грамотной конфигурации движков и ключей сортировки на уровне ClickHouse, сбалансированного использования фоновых процессов слияния и настройки репликации, а также учета сетевых особенностей образуют эффективную модель скоростной вставки. Ключевые преимущества достигаются через:
- продуманное батчирование и параллелизм;
- выбор форматов и алгоритмов сжатия в зависимости от характера данных;
- минимизацию серверной переработки за счет клиентской подготовки;
- устойчивость через отказоустойчивость и мониторинг.
Эти принципы в комплексе обеспечивают устойчивую скорость вставки при крупных объемах загрузок и разнообразных сценариях эксплуатации.
Вопрос-Ответ:
-
Вопрос: Какие основные факторы влияют на скорость вставки в ClickHouse?
Ответ: Влияние оказывают аппаратные ресурсы (CPU, RAM, диск, сеть), конфигурация движков и ключей сортировки, размер батча и параллелизм, формат и сжатие данных, режимы репликации и координации, а также интерфейсы и клиентская подготовка. -
Вопрос: Что важнее** - на стороне клиента или на стороне сервера при оптимизации скорости вставки?
Ответ: Эффективная оптимизация требует баланса между обеими частями. Частичная или полная передача подготовки на клиенте может снизить нагрузку на сервер и повысить общую пропускную способность, но должна сочетаться с правильной настройкой на сервере. -
Вопрос: Какое влияние оказывает репликация на скорость вставки?
Ответ: Репликация увеличивает задержку вставки из-за синхронизации между узлами. Ее влияние зависит от конфигурации сети, частоты синхронизаций и согласованности. В условиях высокой нагрузки может потребоваться балансировка между уровнем доступности и скоростью вставки. -
Вопрос: Какие форматы данных и какие алгоритмы сжатия эффективнее для вставки?
Ответ: Бинарные форматы чаще обрабатываются быстрее текстовых. На практике следует выбирать формат и алгоритм сжатия, которые минимизируют вычислительную стоимость кодирования/распаковки и не приводят к чрезмерному росту размера батчей. -
Вопрос: Какие метрики необходимы для контроля вставки?
Ответ: Latency (задержка), Throughput (пропускная способность), I/O, memory usage и устойчивость к нагрузкам, а также показатели по ошибкам и повторным попыткам. Эти метрики должны сочетаться с уровнем SLA и тестами на стресс. -
Вопрос: Какие шаги предпринять для быстрого внедрения в существующие пайплайны?
Ответ: Начать с клиентской подготовки: пакетирование и сортировка, выбор эффективного формата и компрессии, настройка нативного протокола, минимизация задержек на сервере за счет балансировки фоновых процессов и оптимизаторов. Затем включить мониторинг и тестирование под реальную нагрузку.


