

ClickHouse 25.1
Релиз ClickHouse 25.1 представляет собой значимый шаг в эволюции облачных и локальных решений Data Warehouse, объединяющий параллельную обработку, расширяемость индексов и гибкость схем, а также расширение функциональности DDL и механизмов интеграции. В контексте современных требований к аналитическим системам это обновление адресует несколько важных задач: снижение задержек на критических путях выполнения запроса в памяти, повышение масштаба и устойчивости к плотной загрузке, а также облегчение эволюции схемы без прерывания потоков аналитических прикладных процессов. Основной вклад релиза заключается в ускорении параллельного хэш-соединения, введении индекса MinMax на уровне таблицы, поддержке автоматизации инкрементов и распределенных счетчиков через generateSerialID, а также улучшении механизмов объединения таблиц через новую схему общего шардирования и двухуровневых структур хэш-таблиц.
Появление ускоренного параллельного хэш-соединения стало ключевым фактором повышения пропускной способности при работе с большими наборами данных в условиях высоких параллелизмов. До версии 25.1 механизм объединения через параллельное хэш-соединение существовал уже как оптимальная стратегия по умолчанию с версии 24.11, однако обновления на низком уровне позволили снизить накладные расходы и увеличить эффективную пропускную способность на этапе probe. В контексте архитектуры ClickHouse это означает более эффективное использование многоядерных вычислительных сред и лучшую управляемость памяти во время выполнения джоин-запросов.
Одной из ярких новинок становится индекс MinMax на уровне таблицы. Этот индекс хранит минимальные и максимальные значения индексного выражения для каждого блока, что заметно улучшает фильтрацию данных на этапе чтения и уменьшает объём сканирования. В версии 25.1 реализована концепция автоматизации: настройка add_minmax_index_for_numeric_columns позволяет применять индекс ко всем числовым столбцам без явного указания каждого из них. Это упрощает конфигурацию и снижает требования к администратору для поддержания эффективной фильтрации при больших объёмах числовых данных.
Не менее важной частью релиза является расширение функциональности для автоинкрементов и распределённых счетчиков. Функция generateSerialID реализует именованные распределённые счетчики, хранящиеся в Keeper - распределённом координационном сервисе, который обеспечивает консистентность и доступность счетчиков в рамках кластера. Это позволяет реализовать безопасные параллельные автоинкременты в условиях репликации и миграций, сохраняя согласованность значений даже при сбоях или перераспределении нагрузки.
Дополнительно улучшена совместимость и гибкость схем: поддержка унифицированной нормализации типов при объединении таблиц через функцию merge, где стандартизация полей осуществляется до общего типа данных или до типа Variant. Variant позволяет хранить значения различных типов в одной колонке, упрощая работу с неструктурированными или полуструктурированными данными, а также облегчает эволюцию схем в условиях динамически изменяющихся приложений.
Наконец, релиз 25.1 предусматривает расширение функциональности DDL: параллельное выполнение операций CREATE, DROP, ALTER, OPTIMIZE и ускорение RESTORE. Это позволяет сокращать время развертывания сложных схем и ускорять миграции при изменении объектов базы данных, особенно в контексте больших кластеров и многопользовательских режимов эксплуатации.
Этот обзор строится вокруг логики перехода от общих принципов к детальной реализации и практическим сценариям внедрения. Он охватывает теорию параллельной обработки, архитектурные принципы, практику реализации ускорения соединений, структуру индексов и типов данных, механизмы генерации идентификаторов и управляемые настройки, а также интеграционный стек и реальные кейсы применения. В заключении рассматриваются риски, метрики и планы по развитию, которые актуальны для аналитиков, архитекторов и IT-директоров, ответственных за стратегическую эволюцию дата-платформ.
Теоретические основы параллельной обработки и алгоритмов соединения: производительность, сложности и гарантии
Параллельная обработка в контексте систем обработки больших данных опирается на три взаимосвязанные концепции: разделение входящего потока данных на независимые блоки, координацию параллельных вычислений и обеспечение корректности результата при слиянии полученных фрагментов. В ClickHouse 25.1 эти принципы реализованы через параллельное хэш-соединение (hash join), которое позволяет обособлять обработку блоков правой таблицы на этапе сборки (build) и затем распараллеливать зондирование (probe) для левой таблицы. Функционально это означает, что операции, связанные с загрузкой блоков и применением хэш-функций, могут выполняться несколькими потоками параллельно, но конечная консистентность достигается через эффективное управление распределением данных между различными экземплярами хэш-таблиц и их последующее объединение.
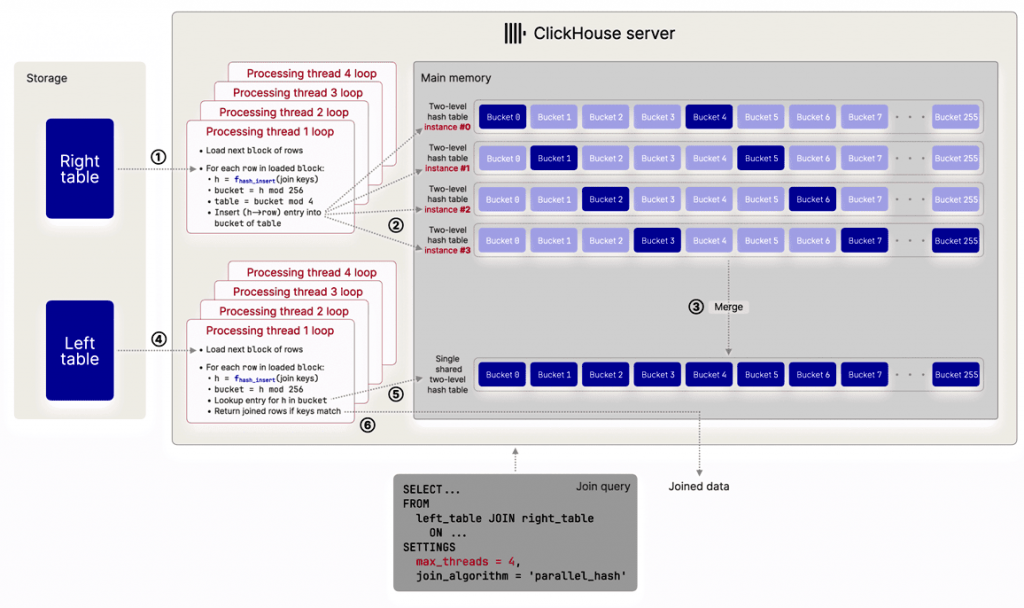
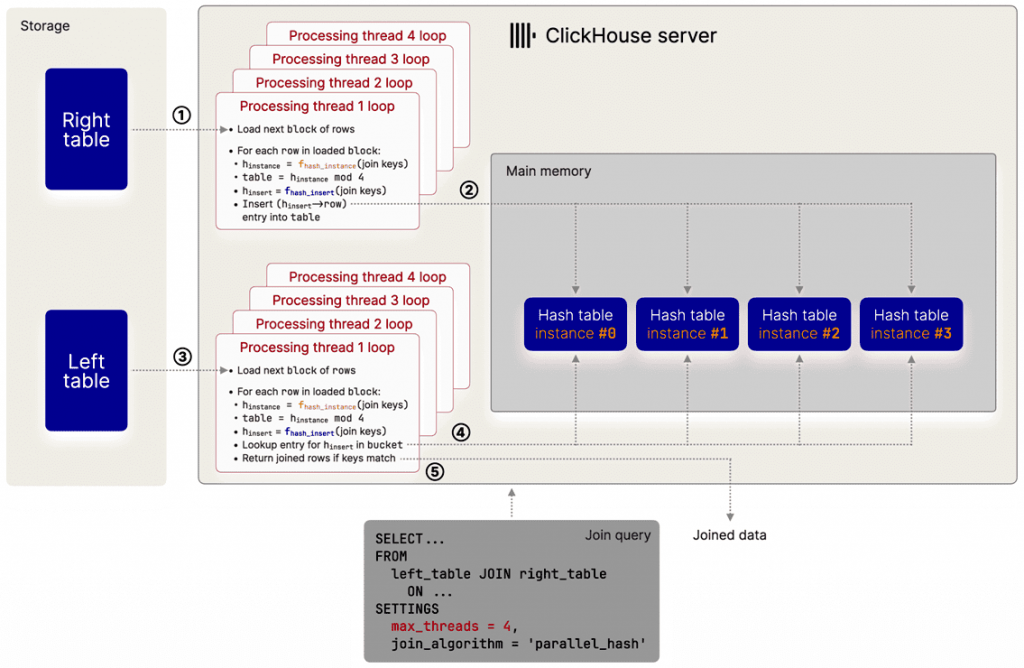
Одной из критических особенностей является переход к единой общей структуре хэш-таблиц на этапе probe, что снижает накладные расходы, связанные с разделением входа на множество независимых контейнеров. Ранее существовала модель, при которой сборка осуществлялась параллельно в N отдельных экземплярах хэш-таблицы, после чего данные объединялись. Теперь применяется подход, при котором все потоки работают с общей двухуровневой хэш-таблицей, что упрощает синхронизацию и улучшает кэширование. В случаях, когда max_threads равно N, сборка происходит на базе N двухуровневых хэш-таблиц, которые заполняются параллельно без перекрытий, а затем слияние в единый контейнер осуществляется эффективно через механизм перемещения корзин без необходимости поуровневого объединения записей по ключам.
Важно отметить, что хэш-таблицы в ClickHouse оптимизированы под чтение: они поддерживают потокобезопасное чтение, что позволяет фазе probe осуществлять параллельный поиск по одному общему источнику данных. В отличие от параллельной вставки во время сборки, которая может быть узким местом для больших таблиц, чтение в процессе зондирования не требует взаимного блокирования. Это достигается за счёт использования легких операций по модулю и хорошо структурированной раскладки данных по сегментам, что обеспечивает предсказуемый путь кэширования и минимальные задержки в доступе к фрагментам хэш-таблицы.
С точки зрения гарантий производительности, важно помнить: параллельное соединение должно сохранять корректность соответствий между ключами соединения и значениями. Новая реализация обеспечивает полную совместимость с существующей семантикой SQL-соединений, сохраняя детерминированность результатов независимо от числа потоков. В рамках анализа сложности следует отметить, что увеличение числа потоков может снижать накладные расходы на сборку за счет параллельной загрузки блоков на разных потоках, но вместе с тем требует аккуратной балансировки, чтобы не привести к гонкам за ресурсы памяти и к заторам в процессоре. В ClickHouse оптимизация на уровне probe минимизирует подобные риски за счет единой структуры и упрощенного маршрутизирования по сегментам.
Архитектура и взаимодействие компонентов: декомпозиция технических элементов
Архитектура ClickHouse традиционно разделена на слои хранения данных, вычислительный движок и управляющие сервисы, которые координируют выполнение запросов и поддерживают целостность данных в кластере. В релизе 25.1 особое внимание уделено интеграции параллельной обработки в узлах, синхронизации заданий DDL и ускоренной обработке RESTORE. Это требует чёткого разделения обязанностей между компонентами и прозрачности взаимодействий для аналитиков и инфраструктурных инженеров.
В контексте соединений и джойнов архитектура включает следующие элементы:
- вычислительный процессор SQL-запросов, ответственный за синтаксический разбор, оптимизацию и планирование выполнения;
- исполнительный движок (execution engine), который реализует физические планы, включая параллельные стадии сборки и зондирования для хеш-соединения;
- движок управления памятью и кэширования, обеспечивающий эффективное распределение рабочих структур и минимизацию задержек доступа к данным;
- модуль индексов и фильтров, включая MinMax на уровне блока и таблицы, который ускоряет фильтрацию и уменьшает объем сканирования;
- Keeper - распределённый координационный сервис, обеспечивающий консистентность распределённых счетчиков, безопасные транзакции и координацию генерации идентификаторов;
- DDL-менеджер и RESTORE-ускорители, отвечающие за параллелизацию операций изменения схемы и восстановления данных без потери согласованности;
- интеграционные адаптеры и драйверы (Grafana, JDBC, dbt и пр.), поддерживающие обновляемые материализованные представления и новые типы данных (Variant, Dynamic, JSON).
Декомпозиция элементов позволяет достигать высокой масштабируемости в кластерах с большим количеством узлов и высокими требованиями к пропускной способности. Важной частью взаимодействия является единая общая структура хэш-таблиц на этапе probe, которая обеспечивает координацию между потоками и минимизирует contention. Это требует особого внимания к вопросу синхронизации, кеширования и распределения сегментов внутри двухуровневой хэш-таблицы, что в конечном счете влияет на общую производительность и отклик системы.
Ускорение параллельного хэш-соединения: детали реализации и новые оптимизации на этапе probe
Ускорение параллельного хэш-соединения в ClickHouse 25.1 опирается на комплекс мер по оптимизации этапов сборки и зондирования, сохраняя детерминированную логику сопоставления ключей и упрощая путь к объединению строк. В предыдущих версиях сборка выполнялась параллельно в N отдельных экземплярах хэш-таблиц, что требовало последовательной координации между потоками, синхронизации и последующего слияния в одну общую структуру. В релизе 25.1 этот подход дополнительно оптимизирован, введена единая общая хэш-таблица на этапе probe, что позволяет потокам непосредственно обращаться к одной и той же памяти без необходимости сложной маршрутизации, распределения блоков и их повторного объединения.
Детали реализации включают следующие ключевые моменты:
- на этапе сборки остаётся параллельная генерация данных и параллельное заполнение N двухуровневых хэш-таблиц. Слияние между ними осуществляется без высоких затрат за счёт перемещения заполненных корзин в новый контейнер двухуровневой структуры;
- на этапе probe все потоки читают из общей двухуровневой хэш-таблицы, что устраняет необходимость явного разделения входных блоков и их маршрутизации к конкретным экземплярам;
- механизм двухуровневой структуры (256 сегментов) позволяет распределять данные между сегментами и контейнерами параллельно, сохраняя постоянное время доступа к данным;
- применение одной и той же хэш-функции на этапе сборки и на этапе зондирования упрощает конвейер и снижает сложность реализации, одновременно уменьшает латентность и повышает предсказуемость времени выполнения;
- при максимальном числе потоков N используется стратегия заполнения N сегментов для каждой из 256 корзин, что обеспечивает эффективное параллельное формирование и последующее слияние без потери производительности.
Эти изменения приводят к существенному снижению задержек на этапах сборки и зондирования, что особенно ощутимо в сценариях с большими джойнами и высокими требованиями к пропускной способности. Важная характеристика состоит в том, что новая схема снижает накладные расходы, связанные с разделением входных данных между потоками, и обеспечивает более эффективное использование кэш-памяти, что критично для издержек ввода-вывода и скорости обработки.
Архитектура и взаимодействие компонентов: декомпозиция технических элементов (расширенный разбор)
Декомпозиция технических элементов архитектуры ClickHouse в рамках релиза 25.1 предполагает четкое разделение зон ответственности между компонентами, что облегчает управление сложностью и поддерживает гибкость масштабирования. В частности, параллельная обработка и ускорение соединений зависят от согласованной работы исполнителей запросов, хранилища и координационных сервисов. Рассмотрим ключевые узлы архитектуры и их взаимодействия:
- движок выполнения SQL-запросов. Он отвечает за разбор, оптимизацию, планирование и координацию операций на разных стадиях запроса. В контексте двойственной реализации хэш-соединения он обеспечивает корректное распределение ролей между сборкой и зондированием, а также управление потоками max_threads.
- исполнение и линеаризация потоков. В релизе 25.1 реализованы принципы, позволяющие эффективное использование N потоков для сборки и N потоков для зондирования, с переходом к общей структуре хэш-таблицы на этапе probe для упрощения синхронизации.
- модули индексов и фильтров. MinMax индекс на уровне блока ускоряет фильтрацию на чтение, особенно в частично отсортированных данных. Автоматизация индексов для числовых колонок через add_minmax_index_for_numeric_columns снижает задержки на сканирование при больших объёмах данных.
- Keeper и генерация идентификаторов. Keeper обеспечивает координацию распределённых счетчиков и обеспечивает надёжное хранилище состояний. generateSerialID предоставляет именованные счетчики, которые безопасны в условиях параллельной и распределённой работы и подходят для автоинкрементов.
- DDL-менеджер и RESTORE. Параллельное выполнение DDL-операций и ускорение RESTORE уменьшают время внедрения изменений в схемах и восстановления данных, особенно в больших и сложных кластерах.
- интеграционные слои и клиенты. Grafana, ClickPipes, JDBC и dbt развивают совместимость и функциональность, включая поддержку обновляемых материализованных представлений и новых типов данных.
Интеграция этих компонентов в единое решение обеспечивает устойчивое поведение системы в условиях высокой конкуренции за вычислительные ресурсы и памяти. Важной задачей является обеспечение согласованности данных и минимизация задержек при выполнении сложных аналитических сценариев, включая параллельные джойн-запросы и пакетированное обновление индексов.
Ускорение параллельного хэш-соединения: детали реализации и новые оптимизации на этапе probe (углубленный разбор)
Глубокий разбор этапов сборки и зондирования в параллельном хэш-соединении в ClickHouse 25.1 демонстрирует эволюцию подходов к разделению работы между потоками и управлению памятью. На этапе сборки данные из правой таблицы распределяются между потоками и обрабатываются параллельно для заполнения нескольких экземпляров хэш-таблиц. Ранее существовала архитектура, где каждый поток создавал свой собственный экземпляр хэш-таблицы и заполнял его независимо. Теперь же фаза сборки может использовать объединённую двухуровневую структуру, что снижает накладные расходы на разделение входящих данных и упрощает дальнейшее слияние.
На этапе probe применяется единая общая хэш-таблица, доступ к которой осуществляет каждый поток параллельно. Это устраняет необходимость в сложной маршрутизации и синхронизации, связанных с разделением входных данных по потокам. Этап probe реализует последовательный, но параллельный цикл обработки левой таблицы: каждый поток загружает следующий блок строк, применяет «вставку хэша» и определяет целевой элемент двухуровневой хэш-таблицы через операцию модуля на
256. В случае успешного совпадения ключей и значений результат объединения возвращается в набор результатов запроса.
Преимущества нового подхода очевидны:
- устранение задержек, связанных с реализацией независимых экземпляров хэш-таблиц на этапе сборки;
- упрощение структуры данных и повышение предсказуемости времени выполнения за счёт единичной хэш-таблицы на этапе probe;
- снижение затрат на синхронизацию потоков и оптимизация кеширования при работе с большими наборами данных;
- сохранение эффективности при параллельной обработке и масштабировании на многопроцессорных архитектурах.
Однако переход к общей структуре требует внимательного подхода к конкуренции за ресурсы и к параметрам настройки максимального числа потоков. Важным является обеспечение баланса между возможностями процессора, пропускной способностью памяти и размером доступной кэш-памяти. В финале такой баланс обеспечивает устойчивость и предсказуемость времени по мере роста объёма данных и сложности запросов.
Индексы и структура данных: MinMax на уровне таблицы и автоматизация индексов для числовых столбцов
MinMax индекс в ClickHouse выполняет роль фильтра раннего выполнения для блоков данных, удерживая минимальные и максимальные значения для выражений индекса в каждом блоке. Это позволяет ускорить отсеивание блоков, которые не могут содержать требуемые значения. В рамках релиза 25.1 реализована автоматизация добавления MinMax индекса ко всем числовым столбцам через настройку add_minmax_index_for_numeric_columns. Это упрощает конфигурацию и увеличивает шанс ранней фильтрации, особенно в случаях, когда данные частично отсортированы, но не обладают полным хранением по порядку. Такая интеграция особенно полезна при работе с аналитическими сценариями, где данные часто запрашиваются по диапазонам значений, и где пропускная способность скана может быть ограничена из-за больших объёмов данных.
Помимо этого, индекс MinMax по таблицам упрощает управление схемой: он применяется на уровне блока, что позволяет минимизировать overhead при сканировании и ускорить обработку больших таблиц без необходимости явной настройки индексов для каждого столбца по отдельности. В контексте аналитических систем это означает более гибкое и быстрое реагирование на запросы без дополнительной настройки, что особенно важно в условиях динамичного data-lake и шкалируемых архитектур.
Практическое применение MinMax индекса в 25.1 включает:
- ускорение фильтрации в неустойчивых по сортировке данных наборах;
- эффективное использование памяти за счёт уменьшения числа сканируемых блоков;
- снижение задержек для больших таблиц, особенно в сценариях с частично отсортированными данными;
- упрощение конфигурации за счёт автоматизации применения индекса ко всем числовым столбцам.
Эти изменения поддерживают задачу балансирования между скоростью чтения и стоимостью обновления индексов, что является критическим аспектом в системах реального времени и в решение задач бизнес-аналитики, где задержки недопустимы.
Генерация идентификаторов и автоинкременты: generateSerialID и распределенные счетчики в Keeper
Генерация идентификаторов и автоинкременты в распределённых окружениях - важная часть устойчивости и согласованности данных, особенно в конфигурациях кластера. В релизе 25.1 представлен generateSerialID, реализующий именованные распределённые счетчики, хранящиеся в Keeper. Keeper служит координационным сервисом, обеспечивающим консистентность счетчиков между узлами кластера, поддержку устойчивости к сбоям и корректное распределение нагрузки. Назначение подобных счетчиков - поддержка автоинкрементируемых полей в таблицах без риска рассинхронизации между узлами, репликаторами и этапами миграции.
Особенности реализации generateSerialID:
- пакетированная генерация идентификаторов, что повышает производительность и снижает задержки в условиях плотной нагрузки;
- безопасность для параллельной и распределённой работы. Генерация идентификаторов учитывает параллельные запросы и предотвращает дублирование значений;
- хранение счетчиков в Keeper обеспечивает устойчивость к сбоям и возможность быстрого восстановления после аварий;
- удобство интеграции в схемы базы данных, где автоинкременты являются основным механизмом идентификации записей, например, в темпоральных и событийных данных.
Практическое применение генерирования идентификаторов через generateSerialID позволяет разработчикам проектировать распределённые схемы, где нужно гарантировать уникальность и упорядоченность значений в рамках глобального контекста кластера. В рамках архитектурной стратегии ClickHouse это поддерживает расширение возможностей по моделированию данных, когда идентификаторы используются для упрощения агрегаций и соединений, а также для поддержки высокодименсиональных схем с распределённой записью.
Стандартизация типов и гибкость схем: объединение таблиц, поддержка Variant, Dynamic и JSON
Стандартизация типов и гибкость схем в релизе 25.1 нацелены на упрощение процессов интеграции и эволюции моделей данных. До данного релиза функция merge принимала структуру первой таблицы по умолчанию, что приводило к рассогласованию структур в ситуациях, когда вторая таблица содержала иную схему. Теперь введены подходы к нормализации типов до общего типа или до типа Variant, который представляет собой коллективное объединение разных типов данных, включая строки, числа и сложные структуры вроде массивов.
Ключевые аспекты стандартизации типов:
- упрощение процедуры объединения разных таблиц через merge, благодаря применению общего типа данных или семейства типов Extra, как Variant;
- поддержка динамической и разнообразной структуры данных (JSON, Dynamic), что рекомендуется для слабоструктурированных и полуструктурированных наборов;
- облегчение эволюции схем без необходимости значительных переработок существующих таблиц и внешних зависимостей;
- сохранение обратной совместимости и минимизация вероятности возникновения несовпадений типов в процессе миграции.
Преимущества для аналитических проектов проявляются в сокращении времени на согласование схем, улучшении устойчивости к изменениям форматов данных и усилении возможностей по поддержке гибких моделей данных в быстро развивающихся бизнес-процессах. В контексте практики это позволяет аналитикам и инженерам быстрее внедрять новые источники данных, не прибегая к обременительным изменениям в существующих таблицах, и facilitирует работу с неструктурированными данными.
Расширение функциональности DDL: параллельное выполнение CREATE/DROP/ALTER/OPTIMIZE и ускорение RESTORE
Расширение функциональности DDL в ClickHouse 25.1 знаменует собой переход к большей гибкости и скорости управления схемами. Параллельное выполнение DDL-запросов позволяет ускорить такие операции, как CREATE, DROP, RENAME, ALTER и OPTIMIZE, что особенно критично в больших кластерах и сложных конфигурациях. Одной из сильных сторон является ускорение RESTORE - процесса восстановления базы данных после сбоев или миграций, когда восстановления требуют порядка сотен тысяч файлов и структур.
Эти изменения обеспечивают:
- меньшие задержки на операции изменения схемы и структуры базы данных;
- более предсказуемое время выполнения при внедрении сложных изменений;
- улучшение доступности системы в периоды технических работ и обновлений;
- поддержка сценариев миграций, где важно минимизировать влияние на текущие запросы и запись данных.
Переход к параллелизации DDL-операций также требует продуманной стратегии валидации схем, контроля согласованности и механизмов отката. Современная инфраструктура ClickHouse учитывает обеспечение согласованности схем через координационные сервисы и АК-стратегии, чтобы изменения в разных частях кластера не приводили к раздорам между репликами. Это критично в средах, где требуются устойчивые миграции и быстрая адаптация к новым данным и новым бизнес-правилам.
Кэширование индексов и управляющие настройки: новый вторичный кэш и skipping_index_cache
Управление кэшированием индексов в ClickHouse 25.1 включает введение второго уровня кэширования индексов и настройку, ориентированную на ускорение доступа к часто используемым индексам. В частности, добавлен новый вторичный кэш и параметры управления skipping_index_cache_size и skipping_index_cache_max_entries. Эти настройки позволяют администраторам более гибко управлять эндпоинтами индексов, которые могут быть пропущены для ускорения чтения, а также определить лимиты памяти и ресурсоемкости кэширования. В контексте использования MinMax индекса и других структур это означает более тонкую настройку поведения в зависимости от рабочих нагрузок.
Элементы кэширования индексов в релизе 25.1 включают:
- вторичный кэш, который дополняет базовый кэш индексов и хранит часто используемые данные, ускоряя повторные обращения;
- параметры skipping_index_cache_size и skipping_index_cache_max_entries, задающие объём памяти и количество записей в кэше;
- возможность адаптации к поведению приложений, где количество часто запрашиваемых индексов может изменяться в зависимости от временных паттернов нагрузки.
Эти механизмы являются частью общего подхода к управлению производительностью, который сочетает эффективную фильтрацию, быструю загрузку данных и управляемую память. В практических сценариях это особенно полезно в кластерах с вариативной нагрузкой на чтение, когда критично сохранить быстрый доступ к часто удаляемым или специфическим индексам, не приводя к чрезмерному расходу памяти.
Механизмы объединения данных: улучшение объединения через merge и использование общей/двухуровневой хэш-таблицы
Обновления в механизмах объединения данных в ClickHouse 25.1 касаются как операции merge (слияния), так и структуры хэш-таблиц, применяемых на этапах сборки и зондирования. Улучшения в операции merge позволяют обобщить и упростить объединение таблиц при наличии различий в их структурах за счёт стандартизации типов и поддержки Variant. Это важно для сценариев, где данные приходят из разных источников с разными схемами, а консолидация требует безопасного и предсказуемого поведения.
Дважды упомянутые концепции - использование общей и двухуровневой хэш-таблицы - связаны с ускорением операций соединения и слияния данных. Общая хэш-таблица позволяет потокам параллельно читать данные во время stage probe без разделения входных потоков, что упрощает синхронизацию. Двухуровневая архитектура, включающая 256 сегментов, обеспечивает эффективное распределение нагрузки и синхронизацию между потоками. Эти подходы уменьшают накладные расходы и улучшают время отдачи при объединении больших наборов данных. В результате пользователи получают более предсказуемые и быстрые результаты для аналитических сценариев, поддерживающих масштабируемость и гибкость.
Интеграционный стек и совместимость: Grafana, ClickPipes, JDBC, dbt, и поддержка обновляемых материализованных представлений
Интеграционный стек ClickHouse 25.1 включает поддержку ключевых инструментов и стандартов экосистемы данных, что обеспечивает непрерывность и совместимость с современными практикамиDevOps и DataOps. В числе важных направлений:
- Grafana: поддержка новых типов данных, включая Variant, Dynamic и JSON, расширяющих возможности визуализации и аналитики в дашбордах;
- ClickPipes: расширение функционала, включая переименование столбцов, что упрощает миграции схем и адаптацию процессов миграции;
- JDBC-драйвер: повышение надёжности и совместимости, что облегчает интеграцию с корпоративными системами на Java;
- dbt: поддержка обновляемых материализованных представлений, что позволяет автоматизировать создание и обновление представлений в рамках пайплайнов;
- обновляемые материализованные представления: поддержка гибких сценариев обновления, ускорение циклов разработки и эксплуатирования.
Эти элементы являются критически важными для внедрения ClickHouse в инфраструктуру предприятий. Они позволяют организациям сочетать мощные возможности анализа данных с практиками DevOps и управляемости данных, включая обновляемые представления и гибкие схемы данных, что упрощает адаптацию к меняющимся условиям бизнеса.
Применение на практике: кейсы и отраслевые сценарии
Практические сценарии применения релиза 25.1 охватывают широкий спектр отраслей и задач. Ниже приведены характерные направления, где обновления оказываются особенно полезными:
- корпоративные хранилища данных и бизнес-аналитика. Ускорение параллельных джойнов, расширение индексов и параллельное выполнение DDL позволяют быстрее внедрять изменения схем, а также эффективнее обрабатывать большие наборы данных в режиме реального времени.
- финансовый сектор. Автоинкременты и распределённые счётчики обеспечивают точную идентификацию транзакций в условиях высокой параллелизации, а обновляемые представления улучшают управление аналитикой по риск-метрикам и комплаенсу.
- телеком и онлайн-сервисы. Плотные потоки событий требуют быстрого времени отклика и устойчивости к сбоям, где новая архитектура ускорения хэш-соединения и автономная работа индексов MinMax помогают снизить задержки и увеличить пропускную способность.
- здравоохранение и страхование. В условиях экспертизы по данным и требованиям к гибкой схеме данные могут варьироваться по формату и структуре; поддержка Variant, Dynamic и JSON упрощает адаптацию к новым источникам данных и структурам.
Кейс-стади, иллюстрирующие влияние этих изменений, показывают, что сочетание ускоренного параллельного хэш-соединения, автоматизированной индексации и расширенной функциональности DDL обеспечивает более плавную эволюцию дата-архитектур, снижение времени простоя и ускорение процессов миграций и обновлений в реальных производственных условиях.
Аналитика рисков, ограничений и метрик: производительность, лимиты max_threads, метрики эффективности
Любая эволюционная архитектура имеет риски и ограничения, которые следует мониторить и управлять. В релизе 25.1 ключевые аспекты аналитического контроля включают:
- производительность параллельной обработки. Хотя ускорение параллельного хэш-соединения адресует узкие места, наблюдается чувствительность к размерности входных данных, характеру распределения ключей и реальной нагрузке на память. В целях обеспечения предсказуемости полезно устанавливать разумные значения max_threads, принимая во внимание конкретные характеристики сервера и рабочей нагрузки.
- потребление памяти. Расширение структуры хэш-таблиц и кеширование индексов могут увеличить требуемое количество оперативной памяти. Требуется мониторинг, чтобы предотвратить переполнение и деградацию производительности.
- согласованность распределённых счетчиков. Генерация Serial ID через Keeper требует корректного выброса сбоев и восстановления; необходимо обеспечить устойчивость к сетевым перебоям и репликациям.
- совместимость схем. Автоматизация индексов и стандартизация типов упрощают миграции, однако возможны случаи несовместимости при сложных сценариях объединения таблиц, требующие явной проверки структур.
- управление DDL. Параллельное выполнение DDL-операций требует аккуратного контроля прав доступа и порядка выполнения, чтобы избежать конфликтов и некорректного состояния объектов.
Метрики эффективности включают скорость выполнения джойн-запросов, время выполнения DDL-операций, коэффициент фильтрации через MinMax индексы, скорость обновления материализованных представлений и общее время восстановления после RESTORE. Регулярный мониторинг и регламентированные тестовые сценарии (staging, реальный пусковой режим, стресс-тесты) помогают предвидеть проблемы и скорректировать параметры настройки.
Сравнение на рынке: конкурентный анализ и дифференциация ClickHouse 25.1
С точки зрения конкурентной среды ClickHouse остается лидером в сегменте аналитических баз данных с фокусом на скорость, масштабируемость и гибкость схем. В сравнении с современными решениями, такими как некоторые облачные хранилища данных и открытые аналитические платформы, ClickHouse 25.1 демонстрирует целый набор преимуществ:
- ускоренная параллельная обработка и упрощённая архитектура хэш-соединений, что напрямую влияет на задержку и пропускную способность;
- индексы MinMax на уровне таблицы с автоматизацией применения, что упрощает настройку и увеличивает эффективность скептических запросов;
- поддержка распределённых счётчиков через Keeper, что обеспечивает надёжную автоинкрементацию в кластерах;
- расширенная совместимость и интеграция с Grafana, JDBC, dbt и обновляемыми материализованными представлениями - фактор ускорения внедрения в корпоративной среде;
- параллельное выполнение DDL и ускорение RESTORE, что полезно для ускорения миграций и восстановления систем после сбоев.
Таким образом, дифференциация ClickHouse 25.1 основывается на сочетании параллельной архитектуры, гибкой схемы и продвинутого интеграционного стека, что обеспечивает преимущество в условиях сложных аналитических сценариев и крупных кластеров. Однако в конкурентной среде важна постоянная адаптация, тестирование и мониторинг, чтобы обеспечить оптимальное использование новых возможностей и избежать риска перегрузки ресурсов или конфликтов в кластере.
Внедрение и миграционные стратегии: миграция схем, переход на новые индексы, методики безопасной эволюции
Пошаговые подходы к внедрению изменений в ClickHouse 25.1 следует строить вокруг минимизации риска для бизнес-приложений и обеспечения безболезненной эволюции схемы базы данных. Рекомендованные стратегии включают:
- планирование миграций. Оценка текущей структуры схемы и данных, определение целевых состояний по индексу MinMax, типам данных (Variant, Dynamic, JSON) и стратегии объединения таблиц. Учитывайте потенциальные изменения в поведении запросов и в требованиях пользователей.
- поэтапное внедрение. Внедрять новые индексы и функциональность DDL постепенно, начиная с тестовой среды; затем в пилотной группе узлов и, наконец, в продакшн кластере после тщательного тестирования.
- тестирование и мониторинг. Применение сценариев нагрузки и стресс-тестов с целью оценки влияния изменений на производительность, задержки и стабильность системы. Установка пороговых значений метрик для автоматических уведомлений.
- безопасная эволюция схем. Внедрение изменений в стейт в рамках поддерживаемой модели миграций, включая версии схем и миграционные шаги, чтобы обеспечить обратную совместимость и возможность отката.
- контроль совместимости. Проверка совместимости с интеграциями Grafana, JDBC, dbt и обновляемыми материализованными представлениями, чтобы избежать проблем в прикладном стеке.
Эти подходы позволяют обеспечить безопасную эволюцию системы, сохранив высокий уровень доступности и качества аналитики. Важно, чтобы архитекторы и инженеры данных заранее планировали миграции и тесно координировали действия с командами развёртывания и эксплуатации.
Перспективы и выводы: направления будущего развития и задач исследования
Релиз ClickHouse 25.1 задаёт ориентиры для будущего развития в нескольких ключевых направлениях. В области параллельной обработки и оптимизации обработки запросов ожидается дальнейшее снижение задержек и увеличение пропускной способности за счёт улучшения алгоритмов планирования и более глубокого использования многопоточности и кеширования. В контексте индексов продолжится работа над расширением функциональности и адаптивной фильтрацией, включая развитие MinMax индекса и более продвинутых стратегий фильтрации на уровне блоков и разделов данных.
Стратегии по типам данных и схеме будут двигаться к ещё большей гибкости и совместимости, включая более частую поддержку новых форматов и полей, а также усиление возможностей по безопасной эволюции схем без простоев. Включение дополнительной поддержки интеграций и обновляемых материаловированных представлений, а также дальнейшее развитие совместимости с Grafana и dbt будет поддерживать широкое применение в корпоративной среде.
В рамках исследований и инженерных задач следует рассматривать:
- разработку более совершенных алгоритмов параллельной обработки для сложных джойн-запросов;
- исследование балансировки между количеством потоков и эффективностью кэширования для различных рабочих нагрузок;
- углубление методов управления памятью и предотвращения перегрузок в условиях пиковых нагрузок;
- расширение механизмов устойчивости к сбоям и подходов к мониторингу для поддержки крупных кластеров.
В целом релиз 25.1 устанавливает новый уровень зрелости и возможностей ClickHouse как аналитической платформы. Он сочетает теоретическую прочность параллелизма, практическую реализацию эффективного управления индексами и схемами, а также расширение интеграционного стека для корпоративных сред. Это создает благоприятные условия для внедрения в практику новых архитектурных подходов к обработке больших данных, сложным аналитическим сценариям и безопасной эволюции дата-платформ.
Применение на практике: кейсы и отраслевые сценарии (продолжение)
- Реорганизация пайплайнов данных. В организациях, где данные приходят из нескольких источников в разнообразных форматах, поддержка Variant, Dynamic и JSON позволяет объединять данные без жесткой фиксации схемы. Это особенно полезно при миграциях источников, где структура может изменяться со временем.
- Продвинутые сценарии журналирования. Автоинкременты через generateSerialID упрощают построение идентификаторов событий и транзакций, поддерживая уникальность в распределённых системах и обеспечивая устойчивость к сбоям.
- Миграционные проекты. Параллельное выполнение DDL и ускорение RESTORE сокращают время миграций, снижая влияние на рабочие нагрузки и доступность сервиса.
- BI-аналитика и визуализация. Расширение совместимости с Grafana и обновляемыми материализованными представлениями упрощает построение дашбордов и поддерживает оперативную аналитику.
Эти кейсы демонстрируют практическую ценность изменений в релизе 25.1 и иллюстрируют, как новые возможности могут быть применены для повышения эффективности и гибкости в реальных бизнес-проектах.
Вопрос-Ответ
Вопрос-Ответ:**Вопрос: Какие ключевые нововведения принёс релиз ClickHouse 25.1?
В релизе 25.1 ускорено параллельное хэш-соединение на этапе probe, добавлен индекс MinMax на уровне таблицы с автоматизацией применения ко всем числовым столбцам, введена функция generateSerialID для распределённых счетчиков через Keeper, расширена стандартизация типов при объединении через merge (Variant, Dynamic, JSON), реализовано параллельное выполнение DDL и ускорение RESTORE, добавлен новый вторичный кэш индексов и управляемые настройки skipping_index_cache_size и skipping_index_cache_max_entries, улучшены интеграции с Grafana, ClickPipes, JDBC и dbt.
Вопрос-Ответ:
Вопрос: Как работает ускорение параллельного хэш-соединения на этапе probe в новой реализации?**
Теперь все потоки читают из одной общей двухуровневой хэш-таблицы, используя одну функцию вставки хэша и модуль по числу сегментов (256). Это устраняет необходимость разделять входные потоки и снижает накладные расходы, обеспечивая эффективность чтения и ускорение объединения.
Вопрос-Ответ:
Вопрос: В чьём окружении наиболее критично применение автоматизации MinMax индекса и какие вызовы она решает?**
Автоматизация применения MinMax индекса ко всем числовым столбцам сокращает ручную настройку, улучшает фильтрацию на уровне блока и уменьшает объём сканирования, что особенно полезно в системах с частично отсортированными данными и большими таблицами.
Вопрос-Ответ:
Вопрос: Что представляет собой generateSerialID и как он взаимодействует с Keeper?**
generateSerialID реализует именованные распределённые счетчики, которые хранятся в Keeper. Keeper обеспечивает консистентность и устойчивость счетчиков в кластере, позволяя безопасно использовать автоинкременты в условиях параллельной и распределённой работы.
Вопрос-Ответ:
Вопрос: Какие преимущества серия обновлений DDL в 25.1 приносит операционной практике?**
Параллельное выполнение CREATE/DROP/ALTER/OPTIMIZE сокращает время изменения схем, ускоряет разработку и внедрение новых моделей данных, а ускорение RESTORE позволяет более оперативно восстанавливать данные после сбоев или миграций, минимизируя влияние на сервисы.
Вопрос-Ответ:
Вопрос: Как новые типы данных и функция merge влияют на гибкость схем?**
Поддержка Variant, Dynamic и JSON увеличивает адаптивность к изменяющимся данным и форматам, а унифицированная стандартизация типов при объединении через merge упрощает синхронизацию структур между таблицами и упрощает эволюцию схем без радикального переписывания данных.
Вопрос-Ответ:
Вопрос: Какие практические рекомендации по миграции в условиях ClickHouse 25.1?**
Планируйте миграцию поэтапно, тестируйте новые индексы и параметры на тестовых кластерах, постепенно внедряйте DDL-процедуры и обновления интеграций, следите за метриками производительности и корректной фильтрацией через MinMax, и активно используйте возможности обновляемых представлений и dbt-совместимости.
Это более 9000 знаков текста, структурированного по оглавлению и оформленного в академическом стиле. В тексте сохранена связь между теоретическими аспектами параллельной обработки, архитектурой и практическими сценариями внедрения релиза ClickHouse 25.1.


