

Углубляемся в тонкости Apache Parquet с помощью ClickHouse - часть 2
Эта статья является второй частью серии статей, посвященной Parquet и ClickHouse. В рамках этой публикации мы рассмотрим формат Parquet и выделим ключевые аспекты, которые необходимо учитывать при чтении и записи файлов с помощью ClickHouse. Для более опытных пользователей Parquet мы обсудим способы оптимизации процессов записи файлов данного формата, а также некоторые лучшие практики, связанные с повышением производительности операций чтения с помощью распараллеливания.
В качестве примера мы продолжаем использовать набор данных о ценах на жилье в Великобритании, содержащий данные о ценах на недвижимость в Англии и Уэльсе за период с 1995 года до момента написания статьи. Помещаем их в общедоступный бакет s3: s3://datasets-documentation/uk-house-prices/parquet/. Чтение и запись файлов Parquet осуществляется с помощью ClickHouse-local, простой в использовании версии ClickHouse, которая идеально подходит для разработчиков. Самое главное это то, что ClickHouse Local и ClickHouse Server используют один и тот же код для чтения и записи Parquet, поэтому все советы и указания применимы к обеим версиям. Для получения более подробной информации прочитайте нашу предыдущую статью.
Обзор формата Parquet
Структура
Понимание формата файлов Parquet позволяет пользователям принимать взвешенные решения в процессе записи файлов, которые напрямую влияют на степень сжатия и последующую производительность операций чтения. В данной статье мы приводим упрощенное описание процессов, которое дает общее понимание вопроса.
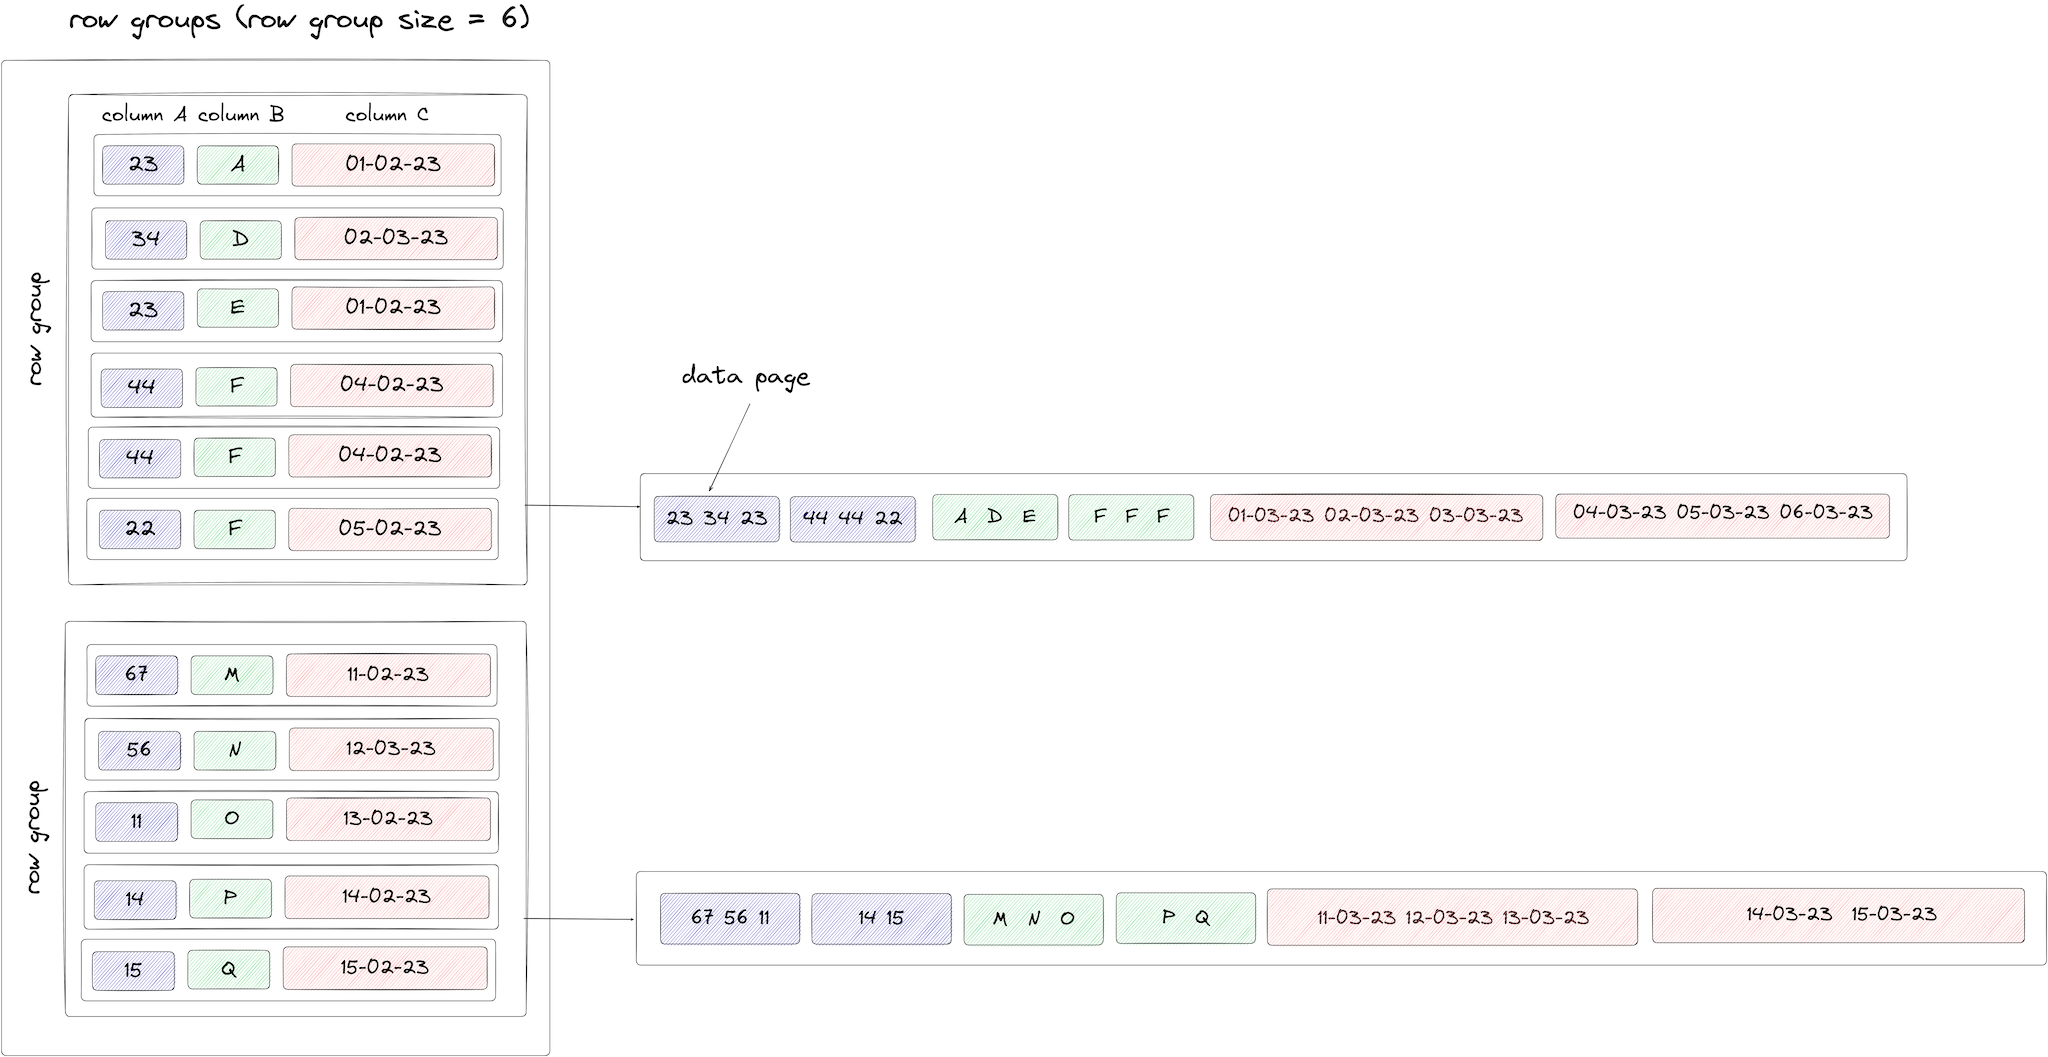
Формат Parquet опирается на три основные концепции, которые иерархически связаны между собой: группы строк, фрагменты столбцов и страницы.
На самом высоком уровне файл Parquet разделяется на группы строк. Группа строк содержит N –е количество строк, доступное на момент написания статьи.
Внутри каждой группы строк есть фрагмент столбец, каждый содержит данные соответствующего столбца и, таким образом, обеспечивает ориентацию по столбцам. В теории количество строк в каждом фрагменте может быть разным, но для упрощения повествования мы предполагаем, что оно идентично. Фрагменты состоят из страниц, на которых хранятся исходные данные. Максимальный размер каждой страницы данных является потенциально настраиваемым, но в настоящее время данная опция не доступна в ClickHouse. Значение по умолчанию - 1 МБ.

Визуализируем эти понятия и логическую структуру ниже. Для наглядности мы предполагаем, что размер группы строк составляет 10, всего мы имеем 19 строк, каждая из которых состоит из трех столбцов. Также будем считать, что размер страницы данных позволяет последовательно разместить три значения (за исключением последнего фрагмента на каждой странице для группы первой строки):
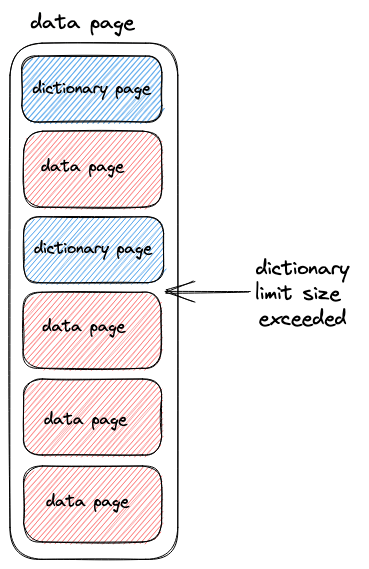
Существует два типа страниц: страницы данных и страницы словарей. Страницы словаря формируются тогда, когда к значениям в странице данных применяется кодирование. При записи файлов Parquet в ClickHouse данная опция включена по умолчанию. Страницы словаря и страницы данных чередуются, как показано ниже. Размер страницы словаря по умолчанию составляет 1 МБ. Если оно превышено, программа автоматически переходит к записи страниц данных, содержащих значения.
Выше приведено достаточно упрощенное описание формата Parquet. Пользователям, желающим получить более подробную информацию, мы настоятельно рекомендуем прочитать статью, посвященную уровням определения и повторениям, поскольку они крайне важны для полного понимания того, как страница данных работает с массивами данных, вложенными типами, а также со значениями NULL.
Несмотря на то, что Parquet официально считается форматом, основанным на столбцах, введение групп строк и последовательное хранение фрагментов столбцов означает, что он вполне может рассматриваться и как гибридный формат, что позволяет достаточно легко реализовывать проекции и push-down обработку.
Метаданные, проекции и push-down обработка
Помимо значений данных формат Parquet включает в себя метаданные, указанные в конце файла, которые включают в себя ссылки на группу строк, фрагменты столбцов и страницы.
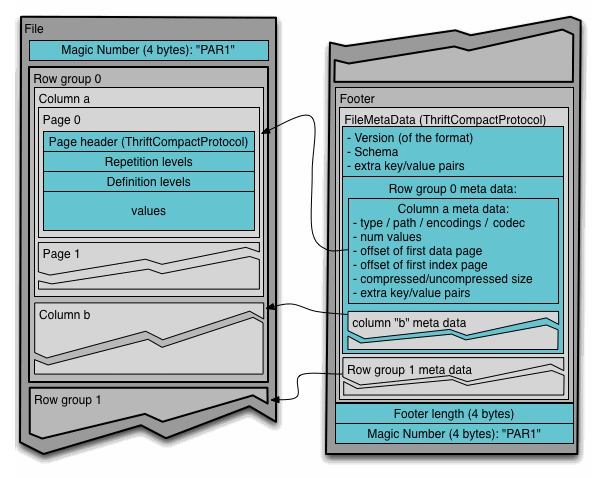
Помимо хранения схемы данных и информации, необходимой при декодировании, например, касательно используемых кодировок, Parquet содержит информацию, которую могут использовать системы запросов для пропуска фрагментов столбцов. Предполагается, что пользователь сначала прочитает метаданные файла (чтобы найти все интересующие его фрагменты столбцов). Это называется projection pushdown и предназначено для минимизации операций ввода-вывода.
Кроме того, Вы можете включить статистику на уровне группы строк, описывающую минимальное и максимальное значение каждого столбца, что позволяет пользователю рассматривать эту информацию в сравнении с любым предикатом (предложение WHERE при запросе на SQL), пропуская фрагменты столбцов. В настоящее время в ClickHouse этот предикат не реализован, однако в ближайшее время должен быть добавлен. Наконец, официальная спецификация позволяет создавать отдельные файлы метаданных, ссылающиеся на несколько файлов Parquet, например, по одному на столбец. В настоящее время ClickHouse не поддерживает эту возможность, но мы планируем ее добавить.
Чтение и запись групп строк
У пользователей ClickHouse всегда есть возможность проконтролировать количество записываемых групп строк в целях увеличения степени распараллеливания при чтении - подробнее читайте в разделе «Распараллеленное чтение». Если Вы хотите проконтролировать количество групп рядов при записи, рекомендуем использовать синтаксис INSERT INTO FUNCTION <file/s3>. Настройки этого синтаксиса позволяют легко определить количество групп строк, при этом количество строк должно быть равно:
- min_insert_block_size_bytes - минимальное количество байт в блоке, при этом блоки меньшего размера сжимаются в блоки большего размера. Это ограничивает количество строк размером в байтах (по умолчанию - 256 МБ без сжатия), ИЛИ
- min_insert_block_size_rows - минимальное количество строк в блоке, который может быть вставлен в таблицу, при этом блоки меньшего размера сжимаются в блоки большего размера, ИЛИ
- output_format_parquet_row_group_size: размер группы строк
Пользователи могут настроить эти значения в зависимости от общего количества строк, их среднего размера или целевого количества групп строк.
В случае запросов SELECT, использующих предложение FORMAT (например, SELECT * FROM uk_price_paid FORMAT Parquet) или INTO OUTFILE, факторы, определяющие размер группы, более сложны. Все эти подходы, как правило, приводят к появлению слишком большого количества групп строк в файлах, что негативно сказывается на производительности сжатия и операций чтения. Именно поэтому мы рекомендуем использовать подход INSERT INTO FUNCTION.
В результате применения 2 разных подходов к экспорту файлов Parquet мы получаем 2 разных размера файлов. Если Вы уже прочитали самую первую статью нашей серии, то с легкостью объясните, почему так происходит. Все дело в том, что меньшие размеры групп строк не так хорошо сжимаются. В целом, нашим читателям мы рекомендуем использовать подход INSERT INTO FUNCTION <file/s3>, поскольку по умолчанию он использует более релевантные значения и позволяет контролировать размеры групп строк.
Другие инструменты для записи файлов Parquet, а также официальные библиотеки Apache Arrow (используемые ClickHouse), также позволяют эффективно настраивать количество групп строк.
Типы и шифрование
Parquet - это двоичный формат файлов, в котором значения столбцов могут быть представлены следующими типами: булевым, числовым, байтовым массивом (двоичным) или двойным массивом фиксированной длины. Эти примитивные типы могут быть аннотированы информацией, указывающей на то, как они должны быть интерпретированы в целях создания «логических типов», таких как String и Enum. Например, логический тип String кодируется в байтовый массив с аннотацией, указывающей на кодировку UTF8.
С момента своего появления Parquet претерпел множество изменений, связанных с тем, как можно кодировать данные:
- Кодирование по словарю создает словарь всех различных значений столбца, заменяя исходное значение его соответствующим индексом в словаре. Это особенно эффективно для столбцов с низкой кардинальностью и помогает обеспечить согласованную производительность для разных типов столбцов. Это может быть применено к числовым типам и типам на основе байтовых массивов.
- Закодированные значения , булевы значения, а также RLE , что позволяет сжимать столбцы, заменяя повторяющиеся подряд значения одним числом, обозначающим повтор. В этом случае более сильное сжатие достигается в случае, когда подряд встречается несколько одинаковых значений. Таким образом, кардинальность столбца также напрямую влияет на эффективность сжатия. Обратите внимание и на то, что RLE отлично сочетается с упаковкой битов, что позволяет минимизировать количество битов, необходимых для организации хранения.
- Дельта-кодирование может быть применено к целочисленным значениям. В этом случае вместо реального значения (кроме первого) хранится дельта между несколькими значениями. Это особенно эффективно в том случае, когда последовательные значения имеют небольшие или постоянные изменения, например значения DateTime с миллисекундной детализацией.
В настоящее время доступны и другие методы кодирования, в том числе разделение байтового потока.
В настоящее время ClickHouse при записи файлов Parquet по умолчанию использует кодировки, что позволяет использовать кодировку словаря. Кодировка, используемая для столбца, не может управляться с помощью настроек, что не позволяет использовать дельта-кодировку для целых чисел, хотя, вполне ожидаемо, что в самое ближайшее время такая возможность будет реализована.
При чтении и при записи типы Parquet должны быть преобразованы в типы ClickHouse.
Строки
Файлы, созданные ClickHouse, также будут использовать BYTE_ARRAY. Этого вполне достаточно, если Вы собираетесь впоследствии читать эти файлы с помощью ClickHouse, так как это соответствует нашему внутреннему решению, где байты хранятся так, как они есть (с отдельными вариантами функций, которые работают в предположении, что строка содержит набор байтов, представляющих текст в кодировке UTF-8, например, lengthUTF8). Однако некоторые приложения могут потребовать, чтобы строки были представлены логическим типом String. В этих случаях перед записью файлов можно установить параметр output_format_parquet_string_as_string=.
Enum
Благодаря последним доработкам данные типа Enum в ClickHouse будут сериализовываться как Int8/Int16 при записи файлов Parquet в будущих версиях ClickHouse. Строки в файлах Parquet также будут преобразованы в ClickHouse Enums, где это возможно. Parquet Enums могут быть прочитаны как данные ClickHouse Enum.
Обзор структуры Parquet
До определенного момента для просмотра структуры файла Parquet пользователям приходилось использовать сторонние инструменты, такие как инструменты -Parquet. В готовящемся выпуске ClickHouse 22.4 пользователи cмогут получить эти данные с помощью простого запроса благодаря новому формату ParquetMetadata. Чуть позже мы будем использовать его для запроса метаданных для нашего файла Parquet с ценами на жилье, который выведет их в виде одной строки. Для удобства чтения мы также указали выходной формат PrettyJSONEachRow (также реализованный в версии 22.4 ) и показали только образец метаданных. Обратите внимание на то, что вывод включает в себя количество групп строк, используемые кодировки и статистику столбцов, такую как размеры и степень сжатия.
Shell
./clickhouse local --query "SELECT * FROM file('house_prices.parquet', ParquetMetadata) FORMAT PrettyJSONEachRow"
{
   "num_columns": "14",
   "num_rows": "28113076",
   "num_row_groups": "53",
   "format_version": "2.6",
   "metadata_size": "65503",
   "total_uncompressed_size": "365131681",
   "total_compressed_size": "255323648",
   "columns": [
       {
           "name": "price",
           "path": "price",
           "max_definition_level": "0",
           "max_repetition_level": "0",
           "physical_type": "INT32",
           "logical_type": "Int(bitWidth=32, isSigned=false)",
           "compression": "LZ4",
           "total_uncompressed_size": "53870143",
           "total_compressed_size": "54070424",
           "space_saved": "-0.3718%",
           "encodings": [
               "RLE_DICTIONARY",
               "PLAIN",
               "RLE"
           ]
       },
       ...
   ],
   "row_groups": [
       {
           "num_columns": "14",
           "num_rows": "1000000",
           "total_uncompressed_size": "10911703",
           "total_compressed_size": "8395071",
           "columns": [
               {
                   "name": "price",
                   "path": "price",
                   "total_compressed_size": "1823285",
                   "total_uncompressed_size": "1816162",
                   "have_statistics": 1,
                   "statistics": {
                       "num_values": "1000000",
                       "null_count": "0",
                       "distinct_count": null,
                       "min": "50",
                       "max": "6250000"
                   }
               },
               ...
           ]
       },
       ...
   ]
}
Сжатие данных
По сравнению с другими форматами Parquet обладает исключительными свойствами сжатия. Вы можете убедиться в этом, обратив внимание на таблицу, приведенную ниже, где мы сравниваем размеры файлов, содержащих данные о ценах на жилье, представленных в форматах CSV, JSON и Parquet. В нашем примере мы экспортируем данные без предложения ORDER BY, полностью полагаясь на обычный порядок ClickHouse (случайный, а не детерминированный) и используя ClickHouse - Local, а также файловую функцию:
SQL
INSERT INTO FUNCTION file('house_prices.<format>.<compression>') SELECT * FROM uk_price_paid
NB: Ни в коем случае не добавляйте расширение сжатия к формату Parquet, например, house_prices.parquet.gzip. Это приведет к повторному сжатию файла Parquet сразу же после его записи –совершенно неоправданные дополнительные расходы, польза от которых минимальна.
|
Уровень сжатия |
CSV |
JSONEachRow |
Parquet |
|
None |
3.5 Гб |
6.9 Гб |
348 Гб |
|
LZ4 (1) |
459 Гб |
493 Мб |
244 Мб |
|
GZIP (6) |
417 Мб |
481 Мб |
183 Мб |
|
ZSTD (1) |
388 Мб |
434 Мб |
196 Мб |
|
Snappy |
Не применимо |
Не применимо |
241 Мб |
|
XZ (6) |
321 Мб |
321 Мб |
Не применимо |
|
BZIP2 (6) |
233 Мб |
248 Мб |
Не применимо |
|
Brotli (1) |
360 Мб |
400 Мб |
174 Мб |
Таким образом, Parquet даже без сжатия всего на 40 % больше, чем наилучшая альтернатива CSV с BZIP2. Со сжатием Brotli Parquet на 30 % меньше, чем этот супер - сжатый CSV. BZIP2 обеспечивает наивысшую степень сжатия для текстовых форматов, однако подразумевает сравнительно большие временные затраты. Это отражено в табличке, приведенной ниже, где приведены временные показатели процессов сжатия (самый быстрый из 3 запусков). Хотя скорость выполнения сжатия во многом зависит от версии ClickHouse и аппаратного обеспечения (Mac Pro 2021), скорость записи Parquet вполне сопоставима со скоростью записи всех сжатых текстовых форматов, при этом соответствующие расходы минимальны. По сравнению с CSV с BZIP2, лучшее сжатие Parquet (Brotli) выполняется почти в 10 раз быстрее. Несмотря на то, что кодирование Parquet в настоящее время является однопоточным (в отличие от форматирования текста), данный формат имеет достаточно хорошие показатели по производительности записи. Мы считаем, что анонсированные доработки, направленные на распараллеливание кодирования Parquet, еще больше повлияют на время записи.
|
Уровень сжатия |
CSV |
JSONEachRow |
Parquet |
|
None |
2.14 сек |
4.68 сек |
11.78 сек |
|
LZ4 (1) |
16.6 сек |
24.4 сек |
12.4 сек |
|
GZIP (6) |
14.1 сек |
19.6 сек |
17.56 сек |
|
ZSTD (1) |
6.5 сек |
11.3 сек |
12.5 сек |
|
Snappy |
Не применимо |
Не применимо |
12.3 сек |
|
XZ (6) |
176 сек |
173 сек |
Не применимо |
|
BZIP2 (6) |
362.5 сек |
837.8 сек |
Не применимо |
|
Brotli (1) |
14.8 сек |
23.7 сек |
31.7 сек |
NB: По умолчанию при сжатии файлов Parquet ClickHouse использует кодек LZ4 (хотя может быть выбран и любой другой кодек - в зависимости от совместимости с такими инструментами, как Spark). В этом состоит главное отличие Parquet от Apache Arrow, который по умолчанию использует Snappy. Однако и это можно изменить с помощью параметра output_format_parquet_compression_method.
Приведенные выше результаты тестов не учитывают родной формат ClickHouse. При перемещении данных между экземплярами ClickHouse, где нет необходимости выбирать какой-либо формат ,независимый от хранилища, , мы рекомендуем остановиться на сжатии ZST – благодаря этому Вы получите размер файла, вполне сопоставимый с Parquet, а также самый быстрый формат для импорта в ClickHouse.
SQL
INSERT INTO FUNCTION file('house_prices.native.zst') SELECT *
FROM uk_price_paid
-rw-r--r--   1 dalemcdiarmid  wheel   189M 26 Apr 14:44 house_prices.native.zst
Упорядочивание данных
Внимательный читатель мог заметить, что кодирование RLE основано на последовательности значениях. Поэтому вполне логично предположить, что этот метод сжатия можно улучшить, упорядочив данные при записи с помощью запроса ORDER BY . При записи большого количества строк из таблицы этот подход имеет свои ограничения, поскольку порядок сортировки может быть ограничен объемом памяти: количество затраченной памяти пропорционально объему данных, подлежащих сортировке. В этом случае пользователь может воспользоваться одним из наших советов:
- Использовать параметр max_bytes_before_external_sort. Если он включен, то, как только объем данных для сортировки достигнет указанного количества байт, собранные данные будут сразу же отсортированы и перемещены во временный файл. Значение данного параметра должно меньше, чем значение параметра max_memory_usage .
- Если у выражения ORDER BY есть префикс, совпадающий с ключом сортировки таблицы, можно использовать настройку optimize_read_in_order. Она включена по умолчанию и означает то, что используется упорядочивание данных, что позволяет избежать проблем с нехваткой памяти. Обратите внимание на то, что отключение этой настройки дает преимущества в производительности, в том случае, когда до выполнения условия WHERE необходимо прочитать достаточно много строк.
В большинстве случаев упорядочивание таблицы ClickHouse (с помощью ORDER BY) оптимизировано с целью повышения производительности запросов и сжатия данных. Хотя вариант 2 является наиболее предпочтительным, результаты подходов могут быть разными. Для того чтобы выявить недостаточно сжатые столбцы и возможных кандидатов для предложения ORDER BY, пользователи могут просмотреть метаданные Parquet, как было показано выше. Оптимальное сжатие достигается в том случае, когда первыми в предложении ORDER BY располагаются столбцы, содержащие ключи с наименьшей кардинальностью (по аналогии с ClickHouse).
Используя ключ ORDER BY таблицы цен на жилье в Великобритании (postcode1, postcode2, addr1, addr2), мы повторили экспорт Parquet с использованием GZIP. Такое решение уменьшит наш файл Parquet примерно на 20 % до 148 МБ за счет снижения производительности записи. Опять же, для того, чтобы определить степень сжатия каждого столбца, мы можем использовать новые метаданные ParquetMetadata.
SQL
INSERT INTO FUNCTION file('house_prices-ordered.parquet') SELECT *
FROM uk_price_paid
ORDER BY
    postcode1 ASC,
    postcode2 ASC,
    addr1 ASC,
    addr2 ASC
0 rows in set. Elapsed: 38.812 sec. Processed 28.11 million rows, 2.68 GB (724.34 thousand rows/s., 69.07 MB/s.)
-rw-r--r--  1 dalemcdiarmid  wheel   148M 26 Apr 13:42 house_prices-ordered.parquet
-rw-r--r--  1 dalemcdiarmid  wheel   183M 26 Apr 13:44 house_prices.parquet
Shell
./clickhouse local --query "SELECT * FROM file('house_prices.parquet', ParquetMetadata) FORMAT PrettyJSONEachRow"
{
  "num_columns": "14",
  "num_rows": "28113076",
  "num_row_groups": "53",
  "format_version": "2.6",
  "metadata_size": "65030",
  "total_uncompressed_size": "365131618",
  "total_compressed_size": "191777958",
  "columns": [{
     "name": "postcode1",
     "path": "postcode1",
     "max_definition_level": "0",
     "max_repetition_level": "0",
     "physical_type": "BYTE_ARRAY",
     "logical_type": "None",
     "compression": "GZIP",
     "total_uncompressed_size": "191694",
     "total_compressed_size": "105224",
     "space_saved": "45.11%",
     "encodings": [
       "RLE_DICTIONARY",
       "PLAIN",
       "RLE"
     ]
    },
INSERT INTO FUNCTION file('house_prices-ordered.parquet') SELECT *
FROM uk_price_paid
ORDER BY
    postcode1 ASC,
    postcode2 ASC,
    addr1 ASC,
    addr2 ASC
./clickhouse local --query "SELECT * FROM file('house_prices-ordered.parquet', ParquetMetadata) FORMAT PrettyJSONEachRow"
{
  "num_columns": "14",
  "num_rows": "28113076",
  "num_row_groups": "51",
  "format_version": "2.6",
  "metadata_size": "62305",
  "total_uncompressed_size": "241299186",
  "total_compressed_size": "155551987",
  "columns": [
  {
     "name": "postcode1",
     "path": "postcode1",
     "max_definition_level": "0",
     "max_repetition_level": "0",
     "physical_type": "BYTE_ARRAY",
     "logical_type": "None",
     "compression": "GZIP",
     "total_uncompressed_size": "29917",
     "total_compressed_size": "19563",
     "space_saved": "34.61%",
     "encodings": [
       "RLE_DICTIONARY",
       "PLAIN",
       "RLE"
     ]
},
Распараллеливание процесса чтения файла
Исторически сложилось так, что чтение файлов Parquet в ClickHouse было последовательной операцией. Это ограничивало производительность и означало то, что пользователи, желающие распараллелить чтение, должны были разделить свои файлы Parquet. Если в пути указан шаблон glob, ClickHouse будет распараллеливать чтение по набору файлов. Мы продемонстрировали эту разницу ниже, используя определение средней цены за год для одного файла по сравнению с 29 файлами (разделенными по годам). Все файлы здесь записаны с помощью GZIP и с использованием ключа ORDER BY, показанного ранее, и мы используем самый быстрый из трех запусков.
SQL
SELECT
    toYear(toDate(date)) AS year,
    round(avg(price)) AS price,
    bar(price, 0, 1000000, 80)
FROM file('house_prices.parquet')
GROUP BY year
ORDER BY year ASC
┌─year─┬──price─┬─bar(round(avg(price)), 0, 1000000, 80)─┐
│ 1995 │  67937 │ █████▍                                 │
│ 1996 │  71513 │ █████▋                                 │
│ 1997 │  78538 │ ██████▎                                │
│ 1998 │  85443 │ ██████▊                                │
│ 1999 │  96040 │ ███████▋                               │
│ 2000 │ 107490 │ ████████▌                              │
│ 2001 │ 118892 │ █████████▌                             │
│ 2002 │ 137957 │ ███████████                            │
│ 2003 │ 155895 │ ████████████▍                          │
│ 2004 │ 178891 │ ██████████████▎                        │
│ 2005 │ 189361 │ ███████████████▏                       │
│ 2006 │ 203533 │ ████████████████▎                      │
│ 2007 │ 219376 │ █████████████████▌                     │
│ 2008 │ 217043 │ █████████████████▎                     │
│ 2009 │ 213423 │ █████████████████                      │
│ 2010 │ 236115 │ ██████████████████▉                    │
│ 2011 │ 232807 │ ██████████████████▌                    │
│ 2012 │ 238385 │ ███████████████████                    │
│ 2013 │ 256926 │ ████████████████████▌                  │
│ 2014 │ 280024 │ ██████████████████████▍                │
│ 2015 │ 297285 │ ███████████████████████▊               │
│ 2016 │ 313548 │ █████████████████████████              │
│ 2017 │ 346521 │ ███████████████████████████▋           │
│ 2018 │ 351037 │ ████████████████████████████           │
│ 2019 │ 352769 │ ████████████████████████████▏          │
│ 2020 │ 377149 │ ██████████████████████████████▏        │
│ 2021 │ 383034 │ ██████████████████████████████▋        │
│ 2022 │ 391590 │ ███████████████████████████████▎       │
│ 2023 │ 365523 │ █████████████████████████████▏         │
└──────┴────────┴────────────────────────────────────────┘
29 rows in set. Elapsed: 0.182 sec. Processed 14.75 million rows, 118.03 MB (81.18 million rows/s., 649.41 MB/s.)
SELECT
    toYear(toDate(date)) AS year,
    round(avg(price)) AS price,
    bar(price, 0, 1000000, 80)
FROM file('house_prices_*.parquet')
GROUP BY year
ORDER BY year ASC
…
29 rows in set. Elapsed: 0.116 sec. Processed 26.83 million rows, 214.63 MB (232.17 million rows/s., 1.86 GB/s.)
В данном случае мы привели пример с файловой функцией. То же самое применимо и к другим табличным функциям, таким как s3. Для больших файлов эта разница, скорее всего, будет более ощутимой. К счастью, недавние доработки по распараллеливанию этой работы внутри файла значительно повысили производительность. В настоящее время все эти усовершенствования касаются только функций функциям s3 и UR. По сути, это самые первые попытки улучшить распараллеливание. Будущие версии ClickHouse будут распараллеливать чтение и декодирование одного файла Parquet, причем количество потоков будет регулироваться параметром max_threads (по умолчанию равному количеству ядер процессора). Для того чтобы наглядно показать разницу в производительности с изменениями и без них, мы запросили один файл Parquet с помощью вышеупомянутого запроса. Обратите внимание на то, что эти файлы находятся на s3:
SQL
SELECT
    toYear(toDate(date)) AS year,
    round(avg(price)) AS price,
    bar(price, 0, 1000000, 80)
FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/uk-house-prices/parquet/house_prices_all.parquet')
GROUP BY year
ORDER BY year ASC
29 rows in set. Elapsed: 18.017 sec. Processed 28.11 million rows, 224.90 MB (1.56 million rows/s., 12.48 MB/s.)
//with changes
SET input_format_parquet_preserve_order = 0
SELECT
    toYear(toDate(date)) AS year,
    round(avg(price)) AS price,
    bar(price, 0, 1000000, 80)
FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/uk-house-prices/parquet/house_prices_all.parquet')
GROUP BY year
ORDER BY year ASC
29 rows in set. Elapsed: 8.428 sec. Processed 26.69 million rows, 213.49 MB (3.17 million rows/s., 25.33 MB/s.)
Таким образом, Вы убедились в том, что производительность в данном случае гораздо выше.
Важность групп строк
В данном случае распараллеливание достигается на уровне групп строк. Для того, чтобы избежать чрезмерного потребления памяти, параметр input_format_parquet_max_block_size следит за тем, сколько данных можно декодировать за раз в каждом потоке, и таким образом определяет объем несжатых данных, хранящихся в памяти. Возможность контролировать этот параметр особенно полезна при работе с сильно сжатыми данными или при наличии большого количества потоков, что может привести к большим затратам памяти.
Поскольку распараллеливание в настоящее время выполняется на уровне групп строк, пользователи, возможно, захотят учесть в своих файлах количество групп строк. Как было показано ранее, для определения количества групп рядов можно использовать ClickHouse Local:
Shell
clickhouse@dclickhouse % ./clickhouse local --query "SELECT num_row_groups FROM file('house_prices.parquet', ParquetMetadata)"
53
Информация о том, как с помощью настроек можно управлять количеством групп строк при записи файлов Parquet с помощью ClickHouse, предоставлена выше.
Для полного распараллеливания количество групп строк должно быть как минимум равно количеству ядер процессора. Ниже мы запрашиваем версию файла house_price.parquet, содержащую только одну группу рядов. Обратите внимание на производительность запроса.
SQL
SET input_format_parquet_preserve_order = 0
SELECT
    toYear(toDate(date)) AS year,
    round(avg(price)) AS price,
    bar(price, 0, 1000000, 80)
FROM s3('https://datasets-documentation.s3.eu-west-3.amazonaws.com/uk-house-prices/parquet/house_prices-1-row-group.parquet')
GROUP BY year
ORDER BY year ASC
29 rows in set. Elapsed: 19.367 sec. Processed 26.64 million rows, 213.12 MB (1.05 million rows/s., 8.40 MB/s.)
И наоборот, большое количество групп строк, значительно превышающее количество ядер, также может негативно сказаться на производительности. В частности, это может привести к множеству крошечных чтений и увеличить задержку ввода-вывода, что будет особенно заметно в том случае, если в виду фрагментации чтения будет считываться всего несколько столбцов, мы можем немного смягчить данный эффект, выбрав все столбцы, так как в этом случае все соседние чтения будут объединены. Очень важно соблюдать баланс между параллельным декодированием и эффективным чтением. Наиболее оптимальный размер группы строк находится в диапазоне от 100 КБ до 10 МБ.
ClickHouse хранит в памяти сжатые данные для каждой считываемой группы строк (а также количество потоков * input_format_parquet_max_block_size` для несжатых данных). Поэтому большие группы строк будут занимать достаточно много памяти. По большому счету, значения, установленные по умолчанию, как правило, разумны, но на машинах с большим количеством ядер или в средах с малым количеством памяти пользователи могут увеличить количество групп строк и привести их размер в соответствие с доступной памятью и количеством потоков. При чтении файлов обязательно учитывайте перерасход памяти.
Наконец, обратите внимание на то, что ранее мы установили параметр input_format_parquet_preserve_order = 0. Значение по умолчанию 1 используется для обратной совместимости и обеспечивает возврат данных в исходном порядке, то есть по одной группе строк за один раз, что ограничивает возможность распараллеливания работы.
Небольшое примечание касательно S3
Да, параллельное чтение файлов Parquet дает ощутимые преимущества при выполнении запросов, однако на абсолютное время выполнения запросов можно повлиять и другими способами. Например, функция s3Cluster использует несколько файлов для распределения чтения по всем узлам кластера, при этом узел-инициатор создает соединение со всеми узлами кластера, а затем динамически отправляет каждый файл, соответствующий шаблону glob. Такая схема увеличивает как распараллеливание, так и производительность. Локальность региона и пропускная способность сети Вашего экземпляра сервера также могут существенно повлиять на производительность запросов.
Ранее мы отметили влияние небольших групп строк (и, соответственно, небольших фрагментов столбцов) на производительность операций чтения. Это также может потенциально повлиять и на оплату услуг S3. При запросе данных из S3 запрос GET выполняется на каждый фрагмент столбцов. Поэтому больший размер группы строк должен уменьшить количество блоков столбцов и результирующих GET-запросов, что потенциально снижает затраты. Пользователям придется как следует поэкспериментировать, чтобы добиться оптимального соотношения стоимость/производительность.
Множество файлов и форматы Data Lake
Хотя Parquet и зарекомендовал себя как формат файлов данных для Data Lake, все же таблицы обычно представляются в виде набора файлов, расположенных в бакетах или в папках. ClickHouse можно использовать для чтения нескольких файлов Parquet в каталоге, но это работает только для специальных запросов. Управление большими наборами данных становится слишком сложным, нет возможности отслеживать эволюции схем или согласованность записи. Фильтрация данных потребует открытия и чтения всех данных, что негативно сказывается на производительности и неизбежно ведет к увеличению затрат.
Современные форматы данных, такие как Apache Iceberg, призваны решить все вышеперечисленные проблемы, предоставляя файлам, хранящимся в Data Lake, функционал, присущий таблицам SQL:
- Эволюция схемы для отслеживания изменений в таблице с течением времени;
- Возможность создания моментальных снимков данных, определяющих конкретную версию. Эти версии можно запрашивать, позволяя пользователям «путешествовать во времени»;
- Поддержка быстрого отката к предыдущим версиям данных;
- Автоматическое разбиение файлов на партиции при фильтрации – ранее пользователям приходилось выполнять эту рискованную задачу вручную;
- Метаданные, которые могут использовать системы запросов для расширенного планирования запросов и фильтрации.
Эти возможности таблиц обычно предоставляются в файлах манифеста, в которых хранится история базовых файлов данных с полным описанием их схемы и разбиения. Такая абстракция позволяет сохранять неизменяемые снимки, эффективно организованные в иерархическую структуру, которая отслеживает все изменения в таблице с течением времени.
Подробнее об этом мы поговорим в наших последующих публикациях.
Заключение и планы на будущее
В этой статье мы подробно рассмотрели формат Parquet, важнейшие настройки ClickHouse, а также тонкости, которые стоит учесть при чтении и записи файлов. Мы также рассказали Вам о последних разработках, касающихся распараллеливания.
Несмотря на достигнутые результаты мы никогда не перестаем работать над совершенствованием формата Parquet. В частности, мы планируем сделать следующее:
- Использование метаданных об условиях в любом предложении WHERE потенциально может еще больше повысить производительность запросов, содержащих условия диапазона, например, фильтрацию по дате. Эти метаданные также могут быть использованы для улучшения специфических функций агрегирования, таких как count;
- Пока при записи файлов Parquet пользователь не может управлять кодировкой, используемой для столбцов. Доработки в данном направлении здесь позволят нам использовать другие методы сжатия, такие как Delta для кодировки даты-времени и числовых значений или отключение кодировки словаря для определенных столбцов;
- API Arrow предоставляет несколько настроек при записи файлов, в том числе возможность ограничивать размер словаря;
- Распараллеливание чтения - это практически бескрайнее е поле для улучшений. Мы очень надеемся на то, что распараллеливание кодирования окажет значительное влияние на производительность записи.
Мы работаем не только над устранением недостатков и слабых мест, о которых мы говорили выше, но планируем внедрить важные и весьма полезные оптимизации, в частности, усовершенствованную поддержку логических типов и обеспечение правильной идентификации Null-столбцов.


