

Управление данными: источники, качество, лицензии и хранение
Добро пожаловать в главу курса по управлению данными для корпоративных AI-агентов. Управление данными — это не просто сбор и хранение. Это системная практика, которая охватывает источники, качество, юридические и лицензионные рамки, безопасность и эффективное хранение. В корпорациях данные — это актив, который влияет на решения, а значит требует продуманной политики, процессов и инструментов. Ниже мы разберем, как выстроить устойчивую инфраструктуру данных, которая поддерживает надежное обучение и использование AI-агентов в бизнес-процессах.
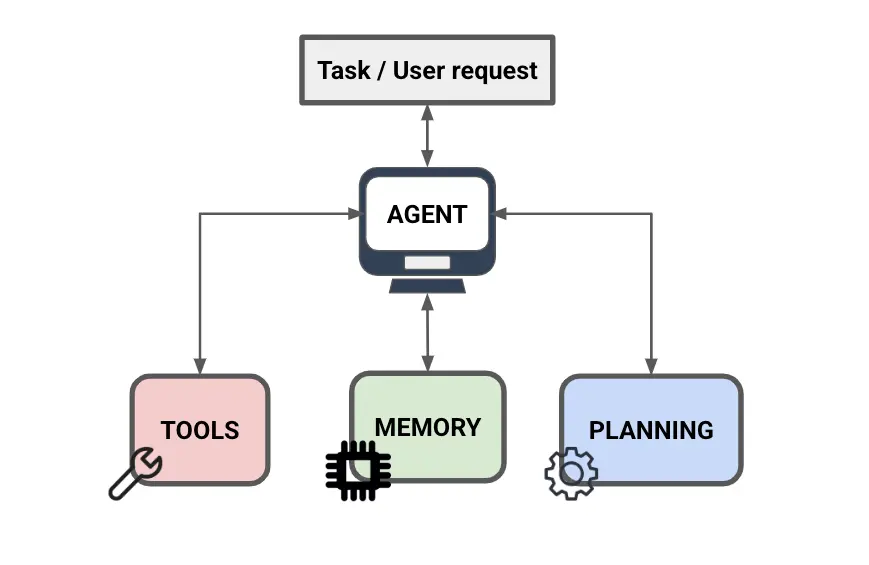
Что такое управление данными для AI-агентов
- Управление данными — это жизненный цикл данных: от источников и сбора до хранения, обработки, качества, лицензирования и удаления. Для AI-агентов это жизненно важно, так как качество и правовой статус данных прямо влияют на работу моделей, риски ошибок и юридическую чистоту решений.
- Основные принципы: прозрачность (data lineage), управляемость (data governance), качество (data quality), безопасность и доступ (privacy and access control), соответствие лицензиям и требованиям регуляторов.
Ключевые концепции и термины
- Источники данных: внутренние и внешние, структурированные и неструктурированные, потоковые и пакетные.
- Метаданные: данные о данных — источник, владельцы, формат, схема, лицензия, дата создания, обновления.
- Data lineage: трассировка происхождения данных — от источника до моделей и результаты.
- Каталог данных (data catalog): реестр и поиск по данным, включающий метаданные и лицензии.
- Качество данных: точность, полнота, согласованность, актуальность, своевременность, достоверность.
- Лицензии на данные: юридические условия использования, ограничения на переработку, совместное использование, распространение.
- Хранение данных: выбор форматов, архитектуры и инфраструктуры хранения (датакейп, data lake, data lakehouse).
- Правовой риск: персональные данные, соблюдение закона о защите данных, санкции за нарушение.
Контекст для корпоративной практики
- В условиях AI-агентов данные чаще проходят через конвейеры ETL/ELT, обновляются и используются для обучения и постановки задач в реальном времени. Это требует согласованных политик, контроля версий, аудита доступа и четких контрактов на использование данных.
Источники данных: виды, плюсы и риски
Внутренние источники
- ERP, CRM, HR-системы, финансовая отчетность, операционные базы данных.
- Преимущества: актуальность, прямой контроль, понятная политика доступа.
- Риски: качество данных может быть разным, наличие дубликатов, сложность согласования форматов.
Внешние источники
- Публичные открытые данные (Open Data), отраслевые каталоги, поставщики внешних данных, технологические пайплайны через API.
- Преимущества: обогащение данных, дополнительные признаки для моделей.
- Риски: лицензия, стоимость, обновления, задержки в доступе.
Структурированные и неструктурированные данные
- Структурированные: таблицы, схемы, базы данных.
- Неструктурированные: текст, изображения, аудио/видео, логи.
- Объединение требует нормализации, эмбеддингов и согласованных правил обработки.
Потоковые и пакетные данные
- Потоки: данные в реальном времени или near-real-time (Kafka, Kinesis, ППС-сообщения).
- Пакетные: данные за период, загрузка по расписанию.
Метаданные, lineage и каталогизация
- Метаданные — это ключ к управлению данными: кто владелец, какие лицензии, какие качество и форматы.
- Data lineage позволяет видеть путь данных: источник -> преобразование -> результат. Это критично для аудита и доверия к моделям.
- Каталог данных (data catalog) упрощает поиск и понимание доступных данных, хранит политики лицензирования и сроки хранения.
Качество данных: концепции и методики
Основные характеристики качества данных: точность, полнота, достоверность, согласованность, непротиворечивость, актуальность.
Метрики качества:
- Coverage (покрытие): доля заполненных значений в колонке или наборе данных.
- Validity (валидность): доля значений, удовлетворяющих формату или бизнес-правилам.
- Consistency (согласованность): отсутствие противоречий между связанными наборами.
- Timeliness (своевременность): задержка или частота обновлений.
Подходы:
- Data profiling: анализ структуры и статистик данных.
- Data validation: проверка значений на соответствие правилам.
- Data quality gates: пороги качества, которые должны быть достигнуты для продвижения данных в пайплайны.
- Data contracts: формальные соглашения между источниками и потребителями данных.
Лицензии и правовые аспекты
Типы лицензий на данные:
- Свободные лицензии: Public Domain, Creative Commons (CC BY, CC0 и т.д.).
- Коммерческие лицензии: данные предоставляются на условиях оплаты и ограничений.
- Пример контрактов: ограничение на переработку, требование указания источника, запрет на обратную передачу третьим лицам.
Вопросы лицензирования в контексте обучения моделей:
- Можно ли использовать лицензированные данные для обучения AI-моделей?
- Какие ограничения применяются к выводам/моделям, обученным на таких данных?
- Требуется ли привязка по источнику или совместное использование (copyleft) выводов?
Соответствие требованиям:
- Юр. лица обязаны соблюдать законы о защите данных (напр., персональные данные).
- В России — Закон о персональных данных (ФЗ-152) и регуляторы, требования к локализации и хранению.
Хранение данных: архитектуры и форматы
Архитектуры хранения
- Data lake: хранение сырых форматов в оздоравливаемом виде (Parquet, ORC, Avro) — гибкость и экономия пространства.
- Data warehouse: структурированные данные для быстрых аналитических запросов.
- Data lakehouse: объединение преимуществ lake и warehouse (обеспечивает транзакционность и качество).
Форматы данных
- Parquet, ORC, Avro — эффективны для столбцового хранения, поддерживают схемы и компрессию.
- JSON, Avro для полуструктурированных данных.
Безопасность и доступ
- Шифрование данных в покое и в передаче.
- IAM, политики доступа, ролевой контроль.
- Аудит и требования к логированию доступа.
Инструменты и примеры решений
- Облачные решения (облака): хранение объектов и управляемые сервисы обработкой.
- Open-source: MinIO как S3-совместимое хранилище, Apache Hudi/Iceberg/Delta Lake для lakehouse-слоя.
- Российские решения и практики: использование локальных ЦОДов и российских средств защиты информации; использование ClickHouse для аналитики в локальных кластерах и интеграция с локальным хранением данных.
Безопасность, приватность и соответствие
- Защита персональных данных и конфиденциальной информации.
- Анонимизация и псевдонимизация данных перед обучением моделей.
- Политики минимизации данных: сбор только того, что нужно для бизнес-задач.
- План реагирования на инциденты и аудит доступа.
Практические примеры
Ниже приведены конкретные кейсы и инструкции по внедрению управления данными в реальных условиях, включая open-source решения и российские практики.
Пример 1: Open-source стек для управления данными (каталог, качество, хранение)
Цель: создать локальный стек на базе открытых инструментов для каталога данных, контроля качества, lineage и хранения.
Компоненты:
- CKAN или DataHub в качестве каталога данных.
- Great Expectations для контроля качества.
- Apache Atlas или OpenLineage для lineage и governance.
- Delta Lake (или Apache Iceberg) для data lakehouse слоя.
- MinIO как S3-совместимое хранилище.
- Apache Airflow для оркестрации пайплайнов.
Пример архитектуры:
- Внутренние источники -> ETL/ELT пайплайн (Airflow) -> Data Lake (Parquet/Delta Lake) -> Каталог данных (CKAN/DataHub) -> Инструменты качества (Great Expectations) -> Модели/аналитика.
Практический шаги:
- Развернуть CKAN или Amundsen/DataHub на локальном сервере или в частном облаке.
- Настроить MinIO как S3-совместимое хранилище.
- Создать пайплайн ETL/ELT (Airflow) для загрузки данных в data lake (Parquet).
- Інтегрировать Great Expectations для проверки качества на каждом шаге.
- Включить lineage через OpenLineage или Atlas.
- Определить политики доступа и лицензирования в каталоге данных.
Пример кода: база Python для проверки качества с Great Expectations
# Установка: pip install great-expectations
import great_expectations as gep
from great_expectations.dataset import PandasDataset
import pandas as pd

class DataFrameDataset(PandasDataset):
    @ PandasDataset.my_custom_expectation
    def expect_row_count_to_be(self, value):
        return self.get_row_count() == value

df = pd.read_parquet("data/sales.parquet")
df_ge = DataFrameDataset(df)
result = df_ge.expect_column_values_to_be_in_set(
    column="region",
    value_set=["NA", "EU", "APAC"]
)
print(result.success)
Этот код демонстрирует базовую проверку набора значений столбца региона. В реальном проекте добавляются проверки на полноту, уникальность ключей, дубликаты, соответствие схемам и т.д.
Важные детали
- Лицензии: в каталоге данных хранится лицензия на каждую запись данных и контракт на использование данных. Это критично для соблюдения прав.
- lineage: каждое преобразование фиксируется, чтобы можно было понять, как данные превратились в обучающие наборы.
Пример 2: Российские практики и источники данных
Открытые порталы данных
- data.gov.ru — российский портал открытых данных, где можно найти наборы данных с лицензиями и условиями использования.
- data.mos.ru — открытые данные Москвы, доступ к наборам для анализа городских сервисов и процессов.
Архитектурная пригодность
- Часто наборы на порталах имеют лицензии, которые допускают использование в коммерческих целях, но требуют указания источника и соблюдения условий лицензирования.
- Для корпоративного использования такие источники можно обогатить внутренними данными и использовать в рамках соблюдения внутренних политик.
Технологическая часть
- Часто данные из порталов индексируются в CKAN-локальных инсталляциях для единообразного доступа внутри компании.
- Для аналитики часто используют ClickHouse для быстрой агрегации и аналитики по большим наборам данных, особенно в российских организациях.
Пример 3: Российское решение для аналитики и хранения
ClickHouse как пример российского происхождения аналитической СУБД
- Применение: быстрые аналитические запросы по большим объемам данных, широкий набор готовых интеграций и экосистемы.
- Интеграции: совместим с Parquet/ORC источниками, поддерживает ingestion через Python-обертки и коннекторы.
Яндекс.Облако и локальная инфраструктура
- Яндекс.Облако предоставляет объекты хранения, базы данных и сервисы аналитики, пригодные для построения data lake и аналитических пайплайнов в рамках российского суверенного рынка.
- Поддержка шифрования, IAM-прав доступа и аудитов позволяет соблюдать требования регуляторов.
Практические инструкции: как начать
Шаги для быстрого старта:
- Определите наборы данных и их лицензии. Сделайте карту источников и владельцев.
- Выберите каталог данных (CKAN/DataHub) и хранилище (MinIO или локальное S3-совместимое).
- Настройте пайплайн ingest/ETL (Airflow) и загрузите данные в data lake.
- Включите качество данных (Great Expectations) и lineage (OpenLineage/Atlas).
- Создайте политики доступа и лицензирования внутри каталога данных.
- Проведите анализ на тестовых моделях, чтобы проверить корреляции между качеством данных и точностью моделей.
Архитектура управления данными
Стек
- Источники данных -> конвейер обработки (Airflow/Prefect) -> Data lakehouse (Delta Lake/Apache Iceberg + Parquet) -> Каталог данных (CKAN/DataHub) -> Метрики качества (Great Expectations) -> Аналитика и модели.
Принципы проектирования
- Разделение ролей: владелец набора данных, администратор каталога, потребитель данных.
- Контракты на данные: договоры об использовании данных, указания по лицензиям.
- Контроль версий: версии наборов данных и моделей, чтобы можно было откатиться.
- Логирование и аудит: запись действий доступа и изменений.
Форматы данных и хранение
Форматы
- Parquet/ORC для аналитики и столбцовых структур.
- Avro/JSON для полуструктурированных данных и API-выдачи.
Хранение
- Data lakehouse: хранение в формате حديث (Parquet) с транзакцией и схемой.
- Ключевые аспекты: шифрование, региональные требования, режимы резервного копирования и аварийного восстановления.
Безопасность и доступ
Ролевой доступ и политики
- Определение ролей: data owner, data steward, data consumer, data engineer.
- Политики доступа к данным в каталоге и в хранилище.
Защита данных
- Шифрование на диске и в передаче.
- Анонимизация и псевдонимизация рядом с источниками данных, чтобы уменьшить риск утечки PII.
Соответствие и аудит
- Ведение журналов, уникальные идентификаторы наборов данных, отслеживание лицензий и использования.
Интеграция и практическая настройка
Интеграция CKAN/DataHub с источниками данных
- Скрипты импорта метаданных и лицензий.
- Автоматическое обновление статусов лицензий и признаков качества.
Инструменты контроля качества
- Great Expectations: создание набора правил (expectations) для конкретных полей и бизнес-правил.
- Встраивание в пайплайны для автоматической проверки данных при загрузке.
Линейность и отслеживание
- OpenLineage помогает обеспечить прозрачность происхождения данных и их трансформаций.
Пример конфигурации YAML для DAG Airflow
# example workflow YAML (conceptual)
dag:
  id: data_ingest_raw_to_lake
  plan:
    - fetch_source: "crm_system"
    - transform: "normalize_and_validate"
    - load: "parquet_to_delta"
Пример конфигурации лицензий в каталоге (упрощённый JSON)
{
  "dataset_id": "sales_2024_q1",
  "license": "CC-BY-4.0",
  "restrictions": ["no_derivatives_without_attrib"],
  "owner": "Data Governance",
  "license_url": "https://creativecommons.org/licenses/by/4.0/"
}
Примеры технических решений (open-source и российские)
Open-source решения
- CKAN: открытая платформа для публикации и управления открытыми данными.
- Amundsen/DataHub: современные инструменты для поиска и обнаружения данных в больших организациях.
- Great Expectations: библиотека для проверки качества данных.
- OpenLineage/Apache Atlas: управление lineage и метаданными.
- Delta Lake / Apache Iceberg: форматы и механизмы управления версионностью в data lake.
- MinIO: S3-совместимое хранилище объектов.
- ClickHouse: аналитическая СУБД с русскоязычной экосистемой и активным использованием в отраслевых решения.
Российские практики и инфраструктура
- Порталы открытых данных России (data.gov.ru, data.mos.ru) как источники легитимных наборов данных с лицензиями.
- ClickHouse как надёжная российская база для аналитики и хранения больших наборов данных.
- Яндекс.Облако: отечественный облачный провайдер, предлагающий сервисы хранения, управления доступом и аналитики, пригодные для построения локальных и гибридных архитектур данных в рамках суверенного рынка.
- Локализация инфраструктуры и соответствие требованиям по локализации данных и защите информации.
Риски и ограничения внедрения
Правовые и регуляторные риски
- Неправильное использование лицензированных данных для обучения моделей.
- Нарушение условий лицензий: копирование, распространение, переработка.
- Обязательства по защите персональных данных: санкции за нарушение PDPL (в России — закон о персональных данных).
Технические риски
- Низкое качество исходных данных, что приводит к деградации моделей.
- Непоследовательность форматов и схем данных между источниками.
- Угроза безопасности: утечки, несанкционированный доступ, неправильная настройка IAM.
- Vendor lock-in: зависимость от конкретной платформы или решений.
Организационные риски
- Несогласованность между отделами data owner, data engineering и data science.
- Недостаточное документирование и аудит данных.
- Сложности внедрения контроля lineage и лицензирования без поддержки руководства.
Этические и бизнес-риски
- Использование данных без прозрачности и понятной лицензии может привести к юридическим рискам и падению доверия.
- Модели, обученные на нерегламентированных данных, могут демонстрировать дискриминацию или искажённые выводы.
Выводы
- Управление данными — основа надёжной и ответственной эксплуатации AI-агентов в корпоративной среде.
- Ключевые элементы: точные источники, прозрачное происхождение данных (lineage), высокое качество набора данных, ясные лицензионные условия и надёжное хранение.
- Инструменты и практики должны быть встроены в рабочие процессы: каталог данных, инструменты проверки качества, контроль доступа, и аудиты.
- Важно сочетать open-source и локальные(российские) решения: они позволяют адаптировать инфраструктуру под требования законности, локализации и специфических бизнес-процессов.
- Постоянный мониторинг, ревизия политик лицензирования и обновление инфраструктуры — залог устойчивости и безопасности.
FAQ — Вопросы и ответы
1) Что такое lineage данных и зачем он нужен в корпоративной среде?
- Lineage данных — это прозрачная карта происхождения данных: от источника до конечного использования. Он нужен для аудита, понимания происхождения ошибок, контроля того, какие данные влияют на модели и выводы, и для соблюдения регуляторных требований. Без lineage трудно понять, почему модель дала определенный результат или как изменились данные со временем.
2) Какие метрики качества данных являются базовыми и как их измерять?
- Базовые метрики: полнота (coverage), валидность (validity), точность (accuracy), согласованность (consistency), актуальность (timeliness), уникальность (uniqueness). Измерение обычно включает profiling набора данных, создание наборов правил и автоматическую проверку на каждом этапе конвейера.
3) Как выбрать лицензию на данные и как отразить это в каталоге?
- Выбор лицензии зависит от источника и бизнес-условий. В каталоге данных стоит хранить: название набора, лицензию, ограничения на использование, URL лицензии и владение данными. Важно указывать требования по атрибуции источника и ограничения на переработку. Для обучающих наборов нужно отдельно проверить, разрешено ли использование для обучения моделей.
4) Какие open-source инструменты наиболее подходят для начала проекта управления данными?
- CKAN/DataHub для каталога, Delta Lake или Apache Iceberg для data lakehouse, MinIO для хранения, Great Expectations для качества, OpenLineage/Atlas для lineage, Airflow для оркестрации. Эти инструменты хорошо документированы и поддерживаются широкой сообществом и компаниями.
5) Какие российские практики можно применить сразу и какие особенности учитывать?
- Используйте порталы открытых данных России (data.gov.ru, data.mos.ru) как источники для обогащения внутренних наборов данных. Применяйте российские решения для хранения и анализа данных (например, ClickHouse для аналитики в локальных инфраструктурах). Важно учитывать требования локализации и защиты информации, а также возможность интеграции с отечественными облачными и локальными сервисами.
6) Какие риски существуют при обучении моделей на внешних данных?
- Риски лицензирования, правовые ограничения, качество и согласованность данных, вероятность использования персональных данных без должной анонимизации, а также риск введения смещений в модель в зависимости от происхождения данных.
7) Как минимизировать риск утечки данных в процессе управления данными?
- Применяйте шифрование в покое и в передаче, ролевой доступ и минимизацию прав, аудит доступа и логирование, а также мониторинг использования данных. Важно внедрять анонимизацию и псевдонимирование для персональных данных, когда это возможно.
8) Какой подход к хранению данных лучше выбрать для AI-агентов?
- Разумно сочетать data lakehouse архитектуру с использованием Parquet/ORC форматов и поддержкой транзакционных операций. Так формируется гибкая, масштабируемая, безопасная и аналитически эффективная система.
9) Что нужно включать в договор на использование внешних данных в обучении моделей?
- Включите условия лицензирования, ограничения на использование, требования к атрибутивности, запрет на обратное распространение, сроки использования и возможности аудита соблюдения условий.
10) Какие шаги можно предпринять, чтобы внедрить управление данными в нашей компании за 90–120 дней?
- План: (1) определить источники и владельцев данных; (2) выбрать инструменты каталога и хранения; (3) запустить небольшой пилотный пайплайн с тремя наборами данных; (4) внедрить контроль качества и lineage на пилоте; (5) определить роли, политики и процесс аудита для развертывания в масштаб; (6) подготовить документацию и обучить команду.


