

Управление ресурсами и производительностью: очереди, параллелизм
В современных хранилищах данных на базе Greenplum ресурсы (CPU, память, сетевые каналы и I/O) распределены между множеством параллельно выполняющихся запросов на сегментах. Эффективное управление ресурсами и грамотная настройка параллелизма позволяют обеспечить предсказуемую производительность, справедливый доступ к вычислительным мощностям и уменьшить риск перегрузки системы в пиковые периоды. Эта глава посвящена концепциям очередей ресурсов, параллелизму исполнения запросов, методологиям планирования нагрузки и практическим подходам к реализации в контексте Greenplum: от теории до технических деталей настройки, примеров и рисков.
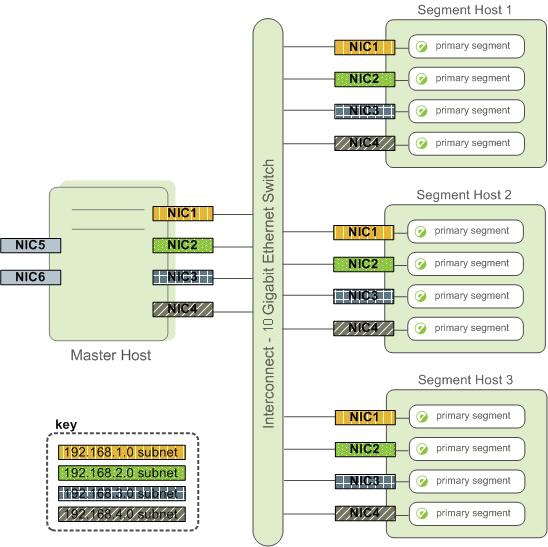
Мы будем говорить о следующих аспектах:
- что такое очереди ресурсов (Resource Queues) и как они управляют параллельной обработкой;
- как в Greenplum реализуется параллелизм на разных уровнях (между сегментами и внутри них);
- принципы планирования нагрузки, распределение ресурсов и политики приоритизации;
- практические примеры настройки очередей и мониторинга создательной среды;
- риски, ограничения и лучшие практики для безопасного внедрения;
- полезные инструменты и российские решения для мониторинга и сопровождения.
Ключевые идеи:
- правильное определение очередей ресурсов позволяет ограничивать потребление памяти и CPU для отдельных пользователей, проектов или задач;
- грамотный параллелизм снижает задержки и обеспечивает масштабируемость при росте объема данных;
- мониторинг и корректная настройка конфигураций являются критическими для устойчивой производительности.
Основные понятия
- Очередь ресурсов (Resource Queue, WLM): механизм управления распределением вычислительных ресурсов между concurrently выполняемыми запросами в системе Greenplum. Очереди позволяют ограничить память, CPU и число параллельных выполнения, чтобы избежать перегрузки сегментов и инстанций.
- Класс ресурсов (Resource Class): категория потребления ресурсов, привязанная к очереди. Определяет потребление CPU и памяти для каждого активного запроса внутри очереди.
- Конкурентность (Concurrency): число одновременных запросов, которые допускаются в очереди. Высокая конкурентность может привести к высокой параллельности, но и к росту contention за ресурсы.
- Параллелизм запросов: способ разделения работы запроса на несколько процессов/потоков, которые выполняются на разных сегментах. В Greenplum применяются концепции межсегментарной параллелизации (между сегментами) и внутрисегментарной параллелизации (в рамках одного сегмента или фигуры планирования).
- Распределение данных: выбор ключей разбиения (distribution keys) влияет на эффективность параллелизма. Неправильное распределение может привести к data skew и узким местам.
- Планирование и исполнительная часть: план запроса в Greenplum строится с учетом распределения данных и доступных ресурсов. Параллелизм и очереди влияют на топологию плана выполнения и очередность исполнения.
Архитектура Greenplum и роль ресурсоориентированной настройки
Greenplum организует вычисления как MPP-архитектуру: мастер-узел координирует выполнение запросов, сегменты осуществляют вычисления, а межсегментный обмен данными осуществляется через сетевое соединение. Управление ресурсами распространяется на все сегменты: каждая очередь ресурсов может формировать собственную политику потребления памяти, CPU и параллелизма, что важно для многопользовательской среды, где разные проекты имеют разные требования к SLA.
Ключевые моменты:
- распределение ресурсов должно учитывать не только текущую нагрузку, но и предсказания по росту трафика;
- целевые политики должны учитываться в рамках бизнес-правил: приоритеты проектов, временные окна (рабочая нагрузка против поддержки SLA);
- мониторинг является неотъемлемой частью поддержания устойчивой производительности: знание, какие очереди и какие запросы потребляют ресурсы, позволяет своевременно реагировать.
Типы параллелизма и как они работают в Greenplum
- Внутренний параллелизм (intra-query): разделение работы одного запроса на несколько операционных узлов внутри плана выполнения. Это достигается за счет параллелизма сквозной обработки, распределения операций по сегментам.
- Внешний параллелизм (inter-query): одновременная реализация нескольких запросов с разделением их задач между сегментами и мастер-узлом. Очереди ресурсов управляют количеством таких параллельных запросов.
- Размещение данных и движение данных: эффективное партиционирование и распределение на сегментах минимизирует простои при обмене данными и влияет на реальную эффективность параллелизма.
- Влияние параллелизма на задержку: чрезмерная параллельность может привести к контентии (resources contention), повлиять на задержки очередей и снизить общую производительность при конкуренции за память.
Методологии планирования нагрузки
- Capacity planning (планирование пропускной способности): прогнозирование будущей нагрузки и резервирование ресурсов под рост бизнеса.
- SLA-driven WLM: построение очередей и политик на основе требований SLA, целевых latency и throughput.
- Profiling and baselining (профилирование и базовые показатели): сбор статистик по нормальным режимам работы, чтобы выявлять аномалии.
- Постоянная итерация и адаптация: в реальном мире нагрузки меняются, поэтому конфигурации должны обновляться на основе мониторинга и анализа.
Метрики и индикаторы эффективности
- Throughput (объем обработанных данных за единицу времени).
- Latency (задержка ожидания в очереди и времени выполнения запроса).
- Queue wait time (время ожидания в очереди ресурсов).
- CPU и memory utilization по сегментам.
- Disk I/O и сетевые задержки (межсегментное взаимодействие).
- Data skew и неравномерность распределения данных по сегментам.
Практические примеры
Ниже приведены практические сценарии, иллюстрирующие настройку очередей, мониторинг и оптимизацию параллелизма в Greenplum. Обратите внимание: конкретный синтаксис для создания и настройки очередей ресурсов зависит от версии Greenplum; используйте официальную документацию вашей версии для точного формата команд.
Пример 1: базовая настройка очереди ресурсов для разделения нагрузки
Цель: создать две очереди ресурсов — default и high_priority — с разной конкурентностью и лимитами памяти, чтобы верхний уровень запросов не перегружал общую систему.
- Предпосылки: Greenplum настроен; есть базовая административная роль.
-
Что делаем:
- создаем очереди с различной конкуруонностью и лимитами памяти;
- назначаем пользователей или группы к очередям;
- применяем изменения и проверяем влияние на текущую нагрузку.
Пример псевдосинтаксиса (версия и точные ключи зависят от вашей сборки):
-- Пример создания очередей (уточните синтаксис для вашей версии)
CREATE RESOURCE QUEUE default_queue
WITH (
  MEMORY_LIMIT = '40%',
  CONCURRENCY = 10
);

CREATE RESOURCE QUEUE high_priority_queue
WITH (
  MEMORY_LIMIT = '70%',
  CONCURRENCY = 4
);

-- Назначение пользователей или ролей к очередям
ALTER USER alice SET RESOURCE_QUEUE = high_priority_queue;
ALTER USER bob SET RESOURCE_QUEUE = default_queue;

-- Применение изменений (перезагрузка конфигурации в зависимости от версии)
ALTER SYSTEM REFRESH RESOURCE_QUEUE;
Комментарии:
- MEMORY_LIMIT может быть задан в процентах или в памяти (MB/GB), в зависимости от версии.
- CONCURRENCY ограничивает число параллельно активных запросов в очереди.
- Реальная команда может иметь другие параметры (например, CPU quotas, GPU-эквиваленты отсутствуют в Greenplum, но могут быть их аналоги в вашем окружении).
Что это дает:
- запросы в high_priority_queue получают больше доступной памяти и меньше задержек при конкуренции;
- очереди по умолчанию не «затирают» ресурсы, и мелкие задачи продолжают выполняться в default_queue.
Пример 2: мониторинг и настройка через gpperfmon и Grafana
gpperfmon — инструмент мониторинга производительности Greenplum, который собирает метрики по всем сегментам и мастеру. Он обычно ставится вместе с Grafana для визуализации. Цель примера — понять, как визуально отслеживать нагрузку на очереди и параллелизм.
Шаги:
- Убедиться, что gpperfmon запущен и собирает данные.
- Открыть Grafana и подключить источник данных к базе gpperfmon.
-
Настроить панель, отображающую:
- загрузку памяти по очередям;
- количество активных запросов в каждой очереди;
- среднюю задержку (queue wait time);
- распределение CPU по сегментам.
- Использовать готовые дашборды или адаптировать под конкретную схему.
Пояснения по результатам:
- рост средней очереди wait time может сигнализировать о нехватке памяти или CPU;
- увеличение количества активных запросов в очереди без пропорционального роста throughput может указывать на контентии за счет нехватки памяти.
Пример 3: настройка параллелизма через конфигурацию планирования
Цель: управлять параллелизмом на уровне выполнения запросов, чтобы избежать чрезмерного распределения данных и конкуренции.
Идея: уменьшить уровень параллелизма там, где данные хорошо распределены и нагрузка умеренная, и увеличить там, где данные распыляются неравномерно или есть узкие места.
Пример концептуального подхода:
-- В зависимости от версии: настройка параметра параллелизма на уровне планирования
SET gp_enable_parallel_hash_join = on;
SET gp_enable_redistribute_join = on;

-- Контроль количества параллельных планов
SET max_parallel_workers_per_gather = 4;

-- Ограничение параллелизма для конкретной операции через планировщик
-- (конкретный синтаксис зависит от версии; чаще это делается через конфигурацию планировщика)
Пояснения:
- Понижение max_parallel_workers_per_gather уменьшает количество параллельных «гather» операций, что может снизить contention при ограниченных ресурсах.
- Включение параллельного хэш-соединения и расшаривания может улучшить скорость для больших таблиц, но требует достаточной памяти и пропускной способности сети.
Пример 4: практическая работа с данными и распределением
Параметр distributions и data skew существенно влияют на эффективность параллелизма. Пример практического подхода:
- Используйте распределение по ключу (distribution key) с хорошим уровнем равномерности. Избегайте распределения по неравномерно тем же значениям.
- При больших таблицах рассматривайте вертикальное и горизонтальное партиционирование, чтобы запросы могли выполняться локально на сегментах, снижая межсегментное общение.
Пример сценария:
- Есть факт-таблица с ключами customer_id, region_id.
- Распределение по customer_id даёт равномерное распределение по сегментам в большинстве случаев.
- Для больших справочников применяйте сортируемые сегменты и индексирование, чтобы ускорить фильтрацию.
Пример 5: российские инструменты и локальный стек
-
Мониторинг и управление часто сопровождается отечественными инструментами для IT-инфраструктуры:
- Zabbix — российский инструмент мониторинга, хорошо известен в инфраструктурных проектах и может интегрироваться с Greenplum через сбор метрик и алертинг.
- Prometheus + Grafana — открытое решение, активно применяется в отечественных проектах для мониторинга баз данных и серверов; можно использовать экспортёры специально для системных метрик VM/OS и сетевых узлов.
- Другие отечественные средства администрирования: скрипты PowerShell/Bash для автоматизации конфигураций, централизованный сбор логов и алерт-интеграции.
Практический вывод: сочетание gpperfmon (или аналогов) + Prometheus/Grafana + Zabbix даёт гибкость для мониторинга очередей, параллелизма и узких мест, а также расширяемость в виде адаптивной алерт-системы.
Конфигурационные параметры очередей и их влияние
- MEMORY_LIMIT: верхний предел памяти, выделяемой очереди. В Greenplum это ключевой параметр, определяющий, сколько памяти может потреблять совокупность активных запросов в очереди.
- CONCURRENCY: максимальное число одновременных запросов в очереди. Более высокая конкуренция может привести к большему параллелизму, но и к большему риску перегрузки сегментов.
- CPU quotas (если поддерживаются): ограничения на долю CPU, выделяемую очереди. Эти параметры позволяют «скормить» очереди по приоритетам.
- INIT_TIMEOUT / MAX_RUN_TIME: временные ограничения на выполнение запросов внутри очереди, что помогает избегать «застревания» долгих запросов.
Важно помнить:
- Правильная настройка должна основываться на реальных данных по нагрузке: сколько памяти используется текущими запросами, как долго они работают, сколько запросов выполняется одновременно.
- В случае резкого роста нагрузки проще начать с более агрессивной памяти и умеренной конкуренции, затем корректировать по факту.
Мониторинг и диагностика
- gpperfmon: предоставляет данные по загрузке сегментов, очередям, выполненным запросам, задержкам и т.д.
- Grafana dashboards: позволяют видеть в реальном времени состояние очередей, использования памяти и CPU, а также history для трендов.
- SQL-графики и системные метрики: сбор план-файлов, анализ версий планировщика и статистик; изучение причин задержек через EXPLAIN ANALYZE и сравнение планов.
Практические советы по настройке
- Начинайте с базовой конфигурации очередей, затем добавляйте дополнительную очередь под критичные задачи.
- Прежде чем менять параметры, запланируйте тестовый прогон с реальной нагрузкой и соберите базовую метрику.
- Введите политику fairness: чтобы долгие задачи не «пожирали» ресурсы, используйте ограничение конкурурности и памяти.
- В целях устойчивости держите резерв ресурсов: выделяйте отдельные ресурсы для критических процессов (バックграундная обработка, нагрузочные тесты) и для обычной аналитики.
- Регулярно выполняйте вакуум/анализ и поддерживайте сбалансированность распределения данных по сегментам, чтобы избежать data skew.
Риски и ограничения
- Неправильная настройка очередей может привести к перегрузке сегментов, повышенным задержкам и ухудшению общего throughput.
- Data skew: если распределение данных по сегментам неравномерное, часть сегментов может перегружаться больше других.
- Недостаток памяти: слишком агрессивные параметры MEMORY_LIMIT могут привести к нехватке памяти на сегменте и сбоям запросов.
- Контентия между запросами: большая конкуренция за CPU или I/O может привести к тому, что долгие запросы «заглушают» короткие, что ухудшает SLA.
- Версия и совместимость: конкретный синтаксис создания очередей, параметров и команд может различаться между версиями Greenplum. Введение изменений без тестирования рискует нарушить работу кластера.
- Мониторинг и телеметрия: без полноценного мониторинга можно пропустить ухудшение производительности или рост очередей.
Меры снижения рисков:
- Пошаговый подход к внедрению: сначала тестовая среда, затем пилотная эксплуатация, потом переход в прод.
- Нормализация нагрузки: профилирование и baselining, чтобы понять «нормальные» показатели для конкретной среды.
- Постоянный мониторинг очередей и планов выполнения: уважайте SLA и не позволяйте одной очереди «забивать» систему.
- Верификация в тестовой среде перед реальным применением изменений.
- Документация изменений и аудируемые настройки (через систему версий и changelog).
Выводы
Управление ресурсами и производительностью через очереди и параллелизм в Greenplum — это ключевой элемент устойчивого внедрения хранилища данных. Правильная настройка очередей ресурсов и контроль за параллелизмом позволяют:
- обеспечить предсказуемую задержку и throughput;
- предотвратить перегрузку сегментов и «ночные» очереди;
- поддерживать SLA для разных проектов и пользователей;
- гибко масштабировать систему в условиях роста объема данных.
Практические примеры, мониторинг и интеграция с отечественными инструментами дают возможность не только поддерживать работоспособность, но и активно улучшать производительность, адаптируя систему под бизнес-цели.
FAQ (Вопрос–Ответ)
1) Что такое очереди ресурсов в Greenplum и зачем они нужны?
- Очереди ресурсов (Resource Queues) позволяют ограничивать и распределять вычислительные ресурсы между различными запросами и пользователями. Они помогают поддерживать устойчивую производительность, предотвращают перегрузку сегментов и позволяют обеспечить SLA для разных бизнес-подразделений.
2) Какой параллелизм влияет на производительность и как его настраивать?
- Параллелизм влияет на то, как запросы распараллеливаются между сегментами и внутри них. Слишком высокий параллелизм может вызывать contention за память и CPU, приводя к задержкам; слишком низкий — к недоиспользованию ресурсов. Настройка проводится через параметры планирования выполнения (например, max_parallel_workers_per_gather) и параметры очередей (CONCURRENCY, MEMORY_LIMIT). Важно тестировать на реальных сценариях.
3) Как понять, что у меня узкое место — очередь или параллелизм?
- Аналитика на gpperfmon и Grafana помогает увидеть, какие очереди переполнены (high wait time), какие запросы работают дольше обычного, и где наблюдается недоиспользование ресурсов. Если ожидание в очереди длительное, возможно необходима модернизация очереди или перераспределение данных; если длительное время в операциях внутри планов — увеличить параллелизм или перераспределить данные.
4) Какие открытые инструменты можно использовать для мониторинга Greenplum в связке с очередями?
- gpperfmon для сбора метрик, Grafana для визуализации, Prometheus как сборщик метрик, Zabbix как отечественный инструмент мониторинга. Эти инструменты помогают строить дашборды по загрузке памяти, CPU, очередям и задержкам.
5) Какие риски связаны с внедрением очередей и как их минимизировать?
- Основные риски: перегрузка сегментов, data skew, нехватка памяти, конфликт за ресурсы. Минимизировать можно через тестирование на ножноэтапах, постепенную настройку с baselining, мониторинг, и корректировку параметров очередей и распределения данных.
6) Есть ли примеры российских инструментов для поддержки Greenplum?
- Да: Zabbix и другие отечественные решения для мониторинга инфраструктуры. Также широко применяются Prometheus + Grafana в сочетании с отечественным софтом для логирования и алертинга. В совокупности это обеспечивает локализацию процессов мониторинга и резервы для адаптации под российские требования.
7) Какой подход следует использовать для распределения данных по сегментам, чтобы не было дисбаланса?
- Важно выбирать distribution key с хорошей равномерностью и избегать горячих точек. При больших таблицах применяйте партиционирование, чтобы запросы попадали в локальные сегменты и минимизировали межсегментное общение. Регулярно проверьте балансировку нагрузки и периоды перераспределения данных.
8) Что делать в случае изменений в нагрузке (пиковые периоды)?
- Поддерживайте гибкость: заранее создавайте запас ресурса для пиков, используйте динамическую коррекцию CONCURRENCY и MEMORY_LIMIT, а также подготовьте дополнительные очереди под новые нагрузки. Настройку лучше проводить поэтапно, с тестами и мониторингом.
9) Какую роль играет distribution policy в управлении параллелизмом?
- Distribution policy определяет, как данные распределяются между сегментами. Оно критично для параллелизма: правильное распределение снижает межсегментное общение и узкие места, увеличивает эффективность выполнения запросов и общую производительность.
10) Какие шаги предпринять, чтобы внедрить управление ресурсами на проде безопасно?
- Шаги: (1) аудит текущей нагрузки и планирования ресурса; (2) настройка базовых очередей с минимальными параметрами; (3) внедрение мониторинга (gpperfmon, Grafana, Zabbix); (4) тестирование на тестовом окружении под реальной нагрузкой; (5) поэтапный переход в прод, с rollback-планами и документированными изменениями.


