

Версионирование признаков и пайплайнов
Версионирование признаков и пайплайнов — ключевой элемент устойчивого ML-цикла в условиях Lakehouse. Когда вы храните признаки и управляете пайплайнами в единой системе, важно не просто собрать данные в один источник и обучать модели, а обеспечить возможность отслеживания изменений: какие признаки, какие версии датасетов и какие версии пайплайнов повлияли на результат модели. Это критично для повторяемости экспериментов, воспроизведения результатов, аудита и регуляторных требований, особенно в организациях с высоким уровнем нормативной и бизнес-ответственности.
Цель главы — дать системное понимание версионирования признаков и пайплайнов, показать как это реализуется на практике в современных lakehouse-архитектурах, разобрать плюсы и минусы разных подходов, привести реальные примеры (open-source и российские решения) и дать практические рецепты внедрения. Мы рассмотрим теоретические основы, паттерны проектирования, практические примеры реализации, расширим тему с точки зрения инфраструктуры, мониторинга и обеспечения соответствия требованиям безопасности и локализации данных.
Ключевые понятия, которые нужно усвоить в этой главе:
- версия признака (feature version) и версия набора признаков (feature set version)
- версия пайплайна (pipeline version) и управление конфигурацией через GitOps
- версия дата-ливня (data lineage) и трассируемость изменений
- офлайн- vs онлайн-хранение признаков и их синхронизация
- совместная работа аналитиков и дата-сайентистов через единый репозиторий признаков и тестовую среду
Ниже мы будем называть вещи своими именами: признаки — это колонки в таблицах признаков, версии — это конкретный набор значений признаков за фиксированное время или версию набора признаков, пайплайны — это конвейеры извлечения, обработки и подготовки признаков, которые можно версионировать и воспроизводить.
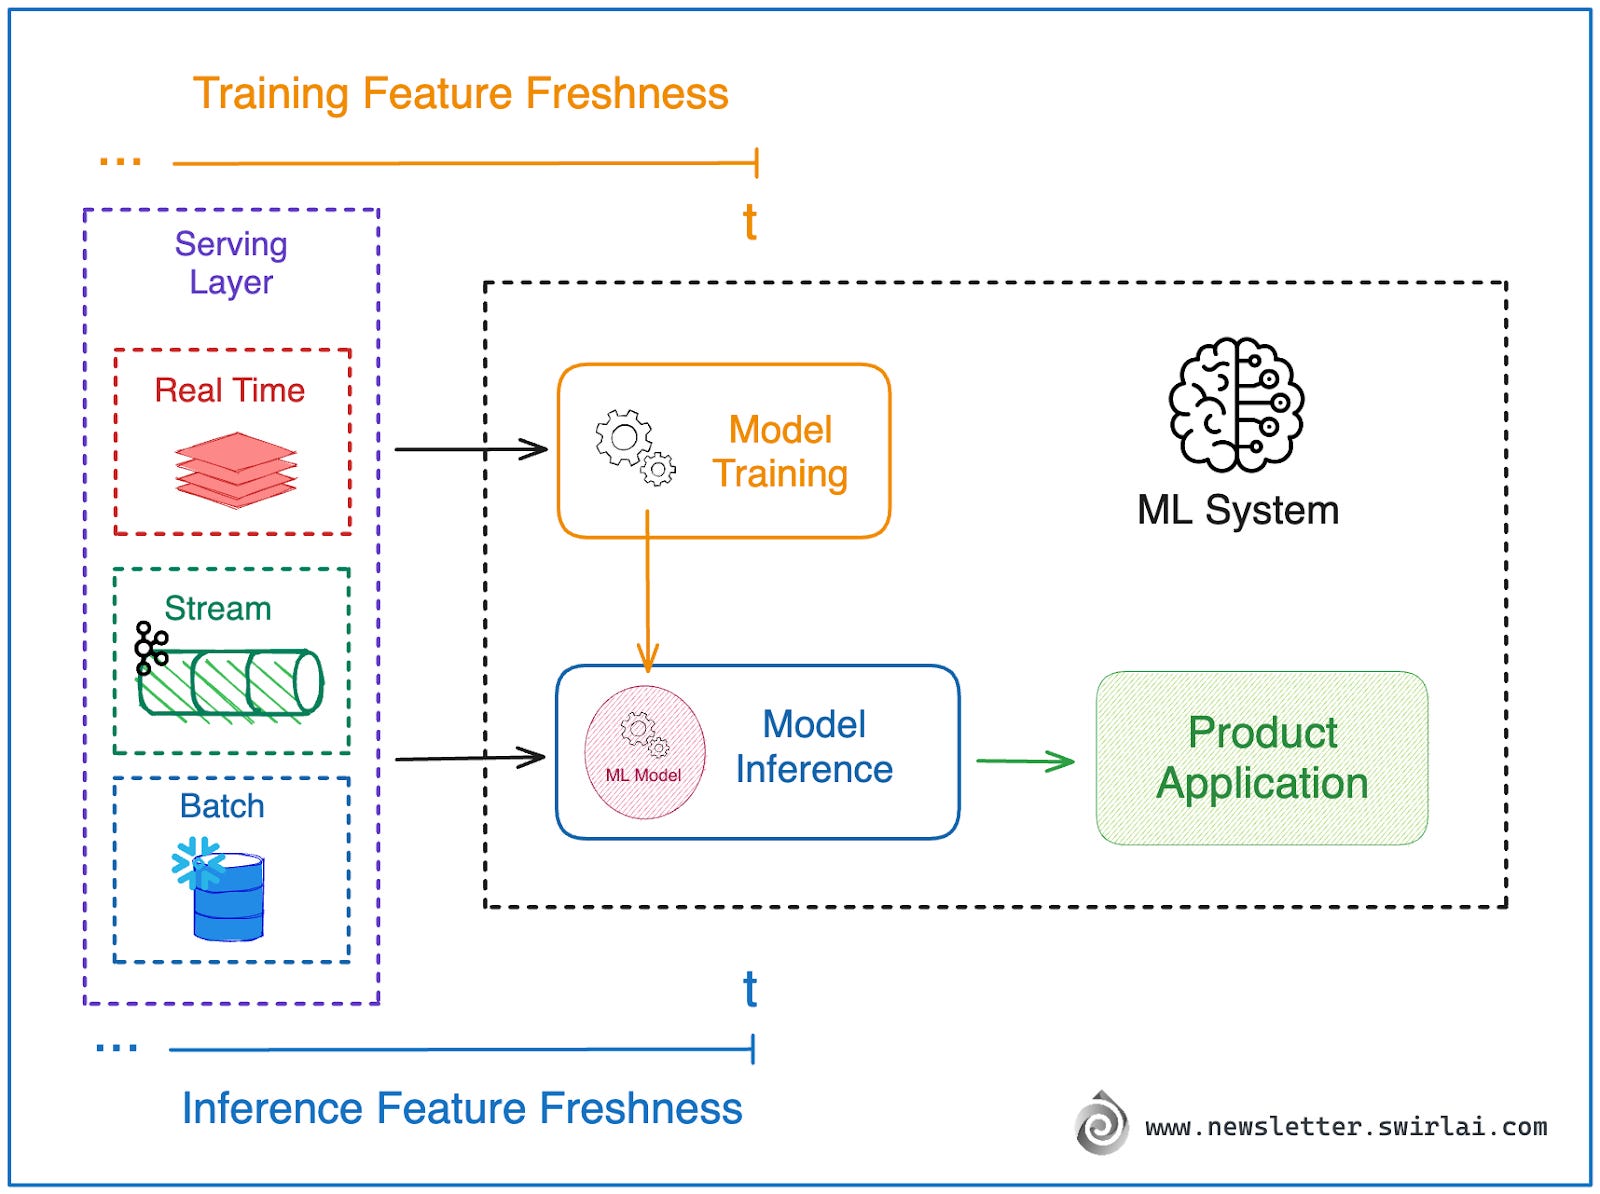
Что такое версия признаков и зачем она нужна
- Иммутабельность. Версии предполагают неизменность результата в рамках конкретной версии: данные признаков можно “зафиксировать” в момент формирования features‑slice.
- Повторяемость экспериментов. По одному и тому же набору конфигураций и версий можно повторять эксперимент и получать сопоставимые результаты.
- Эволюция признаков. Со временем признаки меняются: новые признаки добавляются, старые удаляются или изменяют свой тип. Версии позволяют хранить историю таких изменений и возвращаться к нужной ступени эволюции.
- Влияние на продакшн. В продакшене модель должна работать на конкретной версии признаков. Если признаки обновляются без контроля версий, легко сломать воспроизводимость и привести к деградации качества.
Версии пайплайнов и связь с версиями признаков
- Подробнее о паттерне GitOps для пайплайнов: хранение конфигураций, сценариев обработки и параметров в Git, привязка каждого развёртывания к конкретной версии кода и к конкретной версии данных.
- Пайплайн как код. Любая правка в пайплайне (например, изменение шага очистки, изменение параметра объединения) создаёт новую версию пайплайна. Это важно для аудита и отката.
- Обновление зависимостей. Версии признаков и версионированные пайплайны должны иметь явные зависимости друг от друга (поправка в скрипте преобразования — новая версия пайплайна; изменение схемы признаков — новая версия признаков).
Архитектура версионирования в Lakehouse
- Офлайн- и онлайн-слои. Офлайн-хранилище признаков хранит исторические версии (датасеты, таблицы признаков). Онлайн-хранилище — быстрый доступ к текущей версии признаков. Связь между слоями обеспечивает согласованность.
- История и временные измерения. Версии могут определяться временем создания (snapshot), конкретной миграцией схемы, или версией набора признаков (например, v1, v2).
- Метаданные и lineage. Важно хранить метаданные: какие признаки входят в какую версию, какие источники, какие преобразования применялись, кто создал версию, когда и почему. Это обеспечивает аудируемость и доверие к данным.
Подходы к реализации: обзор паттернов
- Паттерн по имени версии: каждая версия признаков получают собственное имя/суффикс (например, customer_features_v1, customer_features_v2). Простота и понятность, но требует аккуратного управления именами.
- Паттерн через временные слои: хранение денормализованных признаков с полем «valid_from» и «valid_to» (sliced by time). Версии вычисляются через интервалы времени; полезно для временной согласованности.
- Паттерн с датасетами и артефактами: хранение версий датасетов и преобразований в артефактах нейронной/аналитической цепи (например, MLflow/DVC/Metaflow артефакты). Легко интегрируется с экспериментами.
- Табличное версионирование с помощью Spark/Delta/Iceberg: хранение версий в виде отдельных таблиц или версиируемой схемы, поддержка времени жизни записей и «time travel».
Роли и обязанности в контексте версионирования
- Аналитики и дата‑учёные. Определяют бизнес‑логика и признаки, создают версии признаков, валидируют их качество.
- Инженеры по данным. Обеспечивают инфраструктуру версионирования: хранение версий признаков, управление пайплайнами, мониторинг изменений.
- Руководители проектов. Следят за соблюдением сроков выпуска версий, регламентируют доступ и аудит.
- Безопасность и комплаенс. Обеспечивают соответствие требованиям локализации данных, сохранности и шифрования, а также процедуры доступа к данным.
Метрики качества версионирования
- Покрытие тестами новой версии признаков.
- Латентность и пропускная способность: как новая версия влияет на конвейеры.
- Стабильность результата: сравнение метрик модели между версиями признаков.
- Корреляция между версиями признаков и изменением бизнес‑метрик.
Практические примеры
Ниже приведены практические сценарии и примеры реализации на разных стеке: open‑source решения и отечественные подходы.
1) Open-source стек: Feast + Delta Lake (и Iceberg) + MLflow + Dagster
Это один из распространённых стеков для проектов MLops, связанных с версионированием признаков и пайплайнов. Ниже приведены концептуальные примеры и пояснения.
Архитектура:
- Офлайн-хранилище признаков: Delta Lake (или Apache Iceberg) на базе Spark/Databricks или локального Hadoop-подобного кластера.
- Онлайн‑Store признаков: Redis, Redis‑кэш или Opensearch/ClickHouse в зависимости от задержки и требований.
- Управление экспириментами: MLflow для логирования версий моделей, параметров и метрик.
- Оркестрация пайплайнов: Dagster или Airflow с поддержкой версий конфигураций.
- Репозиторий кода и артефактов: Git + DVC/MLflow для артефактов данных.
Пример кода: определение версии признаков (концептуальный Python‑пример через Feast)
# Концептуальная иллюстрация. Реальные API Feast зависят от версии.
from feast import Feature, FeatureView
from datetime import timedelta
from typing import List

# Определение признаков в версии v1
customer_features_v1 = FeatureView(
    name="customer_features_v1",  # версия v1 признаков
    entities=["customer_id"],
    ttl=timedelta(days=30),
    features=[
        Feature(name="avg_purchase_value", dtype="float32"),
        Feature(name="days_since_last_purchase", dtype="int64"),
        # можно добавлять новые признаки в future версии
    ],
    online=True,
    # источники данных offline/online
)

# Версия v2: добавление нового признака
customer_features_v2 = FeatureView(
    name="customer_features_v2",
    entities=["customer_id"],
    ttl=timedelta(days=60),
    features=[
        Feature(name="avg_purchase_value", dtype="float32"),
        Feature(name="days_since_last_purchase", dtype="int64"),
        Feature(name="num_transactions_last_7d", dtype="int64"),  # новый признак
    ],
    online=True,
)
Как работать с версиями:
- Создавайте отдельные FeatureView для каждой версии признаков (v1, v2, ...).
- В пайплайнах указывайте, какую версию признаков выдает вашей обучающей/онлайн-сценарий.
- Для воспроизводимости храните манифест (описание версий) в Git и связывайте его с экспериментами через MLflow.
Преимущества:
- Простая трассируемость версий признаков.
- Гибкость: можно параллельно поддерживать несколько версий для A/B тестирования.
- Совместимость с дата‑лейнингом и аудиторией.
Чем грозит сложность:
- Рост числа версий усложняет governance.
- Необходимо тщательное управление зависимостями между версиями признаков и версиями пайплайнов.
2) Open-source стек: Delta Lake или Apache Iceberg для версионирования таблиц признаков
В Delta Lake версии достигаются через time travel: вербальная концепция «версия» реализуется через точки времени или версии транзакций.
-- Пример для Delta Lake: чтение признаков на конкретной версии
SELECT * FROM analytics.customer_features VERSION ASOF 5;
В Iceberg/Apache Spark аналогичные паттерны можно реализовать через Snapshot-based чтение, а также через разделение данных на временные слои и именование версий таблиц (customer_features_v1, customer_features_v2).
Преимущества:
- Физическое хранение версий данных.
- Удобное исследование прошлого состояния признаков.
Риски:
- Нужно atento управлять устаревшими версиями, чтобы не перегружать схему и хранение.
3) Российские решения и локальные практики
Российские компании часто используют локальные развёртывания на базе открытого ПО и инфраструктурных компонентов с расчётом на локализацию данных, требования к безопасности и соответствие законодательству. Например:
- Использование ClickHouse в качестве хранилища признаков и бизнес-логики. Настройка версионирования через именование таблиц (например, признаки_клиентов_v1, признаки_клиентов_v2) и устройство ежедневных версий: каждая версия хранится как отдельная таблица, или же реализуются версионные признаки через поля valid_from/valid_to.
- Интеграция с системами оркестрации: Airflow или Dagster для запуска пайплайнов и отслеживания версий конфигураций.
- Сочетание MLflow или DVC с локальными хранилищами артефактов для воспроизводимости экспериментов и версий моделей.
Пример российского подхода (концептуально, без привязки к конкретной коммерческой платформе):
- Офлайн‑таблица признаков в ClickHouse с двумя версиями: customer_features_v1 и customer_features_v2.
- Онлайн‑store на Redis с текущей версией признаков.
-
Пайплайн, который:
- извлекает данные из источников,
- применяет преобразования,
- сохраняет версию признаков в ClickHouse (в отдельной таблице/схеме),
- регистрирует версию и параметры в MLflow для воспроизводимости.
Пример конфигурации интеграции (концептуальный код):
# Пример YAML-конфига для оркестратора
versioned_pipelines:
  - name: customer_features_pipeline
    version: 2
    steps:
      - extract_from_source:
          source: crm
      - compute_features:
          script: features.py
      - store_offline:
          table: analytics.customer_features_v2
      - store_online:
          cache: redis://localhost:6379/online/customer_features_v2
Практический совет: используйте гибридный подход — офлайн‑слой хранит «версии» (v1, v2, …), онлайн‑слой держит текущую активную версию. Это упрощает откат к прошлым версиям и ускоряет тестирование новых признаков в продакшне.
Важные для России аспекты:
- Локализация данных и требования к хранению персональных данных (помните о 152-ФЗ и связанных нормах).
- Соответствие отраслевым регламентам и стандартам безопасности.
- Возможности локального развертывания и минимальные задержки доступа к данным.
Примеры интеграций в российском контексте:
- ClickHouse + MLflow + локальные пайплайны на Apache Airflow или Dagster.
- Использование явного слежения за версиями через именование таблиц и артефактов в репозитории кода.
4) Яндекс DataSphere и другие отечественные решения как контекст
Яндекс DataSphere (пример российского контекста) — платформа, ориентированная на управление данными и экспериментами в рамках ML‑цикла. В рамках DataSphere можно:
- хранить наборы признаков и версии методик обработки;
- управлять экспериментами и отслеживать результаты;
- интегрироваться с локальными хранилищами и кластерами обработки данных.
Применение в связке с внешним feature store:
- DataSphere может выступать как репозиторий артефактов и как координатор экспериментов.
- Feast/Open source для самой функциональности feature store можно использовать как дополнение, а DataSphere — как платформа для управления экспериментами и метаданными.
Практическая польза:
- Екатерина в крупной российской компании может держать данные и признаки в локальной среде, но при этом иметь централизованную систему учёта версий и аудита именно за счет DataSphere.
Важно: конкретные функциональности и интеграции зависят от версий и продуктов. Приведённые сценарии служат ориентиром для проектирования архитектуры и дискуссии с архитекторами данных.
Архитектура «версии признаков» как паттерн
- Офлайн‑слой признаков (Feature Store): таблицы с версиями, снапшеты или разделённые таблицы.
- Онлайн‑слой признаков: кэш текущей версии признаков, поддерживающий готовность к запросам в продакшне.
- Метаданные и lineage: хранение зависимостей, источников, версий и владельцев.
- Управление схемами: поддержка эволюции схем, обратная совместимость (backward compatibility) и прогнозируемая forward‑совместимость.
- Контроль доступа: кто может создавать версии признаков, кто может их использовать в обучении и предиктах.
Механизмы контроля версий
- Версионирование признаков: суффиксы имен (например, customer_features_v1, customer_features_v2) или версионные маркеры в metadata.
- Версионирование пайплайнов: хранение кода пайплайна, параметров, конфигураций в Git; привязка конкретной версии пайплайна к эксперименту и к версиям признаков.
- Триггеринг и откат: возможность откатываться к определённой версии признаков и пайплайна в продакшне; поддержка rollback‑планов.
Механизмы тестирования и контроля качества
- Юнит‑ и интеграционные тесты для новых версий признаков.
- Валидации на предмет дрифтинга признаков и качества данных.
- Встроенная эмуляция in‑line для репродуцируемых экспериментов: воспроизводимость пайплайна и признаков.
- Мониторинг задержек и сбоев в пайплайнах.
Важные архитектурные решения
- Выбор уровня версионирования: таблицы, визуализируемые версии таблиц, или «версии» на уровне инструментов (Feast, Delta Lake, Iceberg).
- Совместимость онлайн и офлайн: как обеспечить согласованность версий между онлайн‑слоем и офлайн‑слоями.
- Эффективность хранения: срок хранения старых версий, TTL, чистка нелепых или устаревших версий.
- Безопасность: управление доступом к версиям и данным, шифрование в спящем и активном состояниях, аудит действий.
Пример таблицы сравнения паттернов версионирования
| Паттерн | Преимущества | Недостатки | Примеры реализации |
|---|---|---|---|
| Версии по имени (v1, v2) | Простота, ясность; лёгкое аудирование | Может привести к большему числу артефактов, путаница в названиях | Feast FeatureView версии; таблицы признаков с суффиксами |
| Временные слои (valid_from/valid_to) | Естественная временная трассируемость | Сложнее управлять очисткой старых версий | Delta Lake/ Iceberg со временем жизни записей |
| Табличное версионирование (несколько таблиц) | Чётко отделённые версии | Увеличение количества таблиц; риск несогласованности | customer_features_v1, customer_features_v2 и т.д. |
| Метаданные + артефакты (MLflow/DVC) | Глобальная управляемость артефактами | Не всегда встроено в главную аналитическую логику | MLflow для экспериментов; DVC для датасетов |
Риски и ограничения
- Сложность управления версиями: увеличение числа версий требует дисциплины, регламентов и автоматизации.
- Стоимость хранения: версия признаков может приводить к росту объема данных. Важно управлять TTL и правилами архивации.
- Совместимость и регрессии: новая версия признаков может нарушить совместимость с обученной моделью; необходимы тесты регрессии.
- Вопросы данных и приватности: в условиях российского рынка — строгость локализации и доступ к данным; соответствие законодательству ФЗ-152 и регуляторным нормам.
- Время на внедрение: настройка и поддержка версионирования требуют времени и ресурсов, особенно в рамках крупных организаций.
Риски и ограничения внедрения (детализированная часть)
- Внедрение требует культуры и процессов: соглашение между командами аналитиков, дата‑инженеров и DevOps; регламенты по именованию версий; процессы ревью.
- Управление зависимостями: изменения в признаках часто зависят от источников данных и преобразований; требуется прозрачная карта зависимостей.
- Нагрузка на инфраструктуру: хранение и обработка версий может потребовать масштабирования кластера хранения и вычислений.
- Мониторинг и критичность: продвинутые стратегии версионирования требуют мониторинга по нескольким уровням: данные, признаки, пайплайны, эксперименты, модели.
- Законодательство и безопасность: при локальном хранении данных в РФ — соблюдение локализации, доступа, аудита и защиты персональных данных.
Выводы
- Версионирование признаков и пайплайнов — необходимый элемент современного ML‑ожерелья, позволяющий обеспечить воспроизводимость, управляемость и гибкость в условиях Lakehouse.
- Существуют разные паттерны и реализации: от простого именования версий до сложных сценариев с временными слоями и версионированием пайплайнов. Выбор подхода зависит от размеров данных, требований к latency, регуляторных ограничений и структуры организации.
- Open-source решения ( Feast, Delta Lake / Iceberg, MLflow, Dagster) дают прозрачность, гибкость и широкую экосистему. Российские подходы — локализация данных, безопасность и интеграция с отечественными системами (например, локальные хранилища и инструменты оркестрации) — обеспечивают соответствие требованиям рынка и регуляторной среды.
- Правильная реализация требует: четкой архитектуры, согласованных процессов, тестирования версий, мониторинга и аудита. Только так можно минимизировать риски и обеспечить устойчивость продвинутой аналитики и ML‑экспериментов в lakehouse‑архитектуре.
FAQ (Вопрос–Ответ)
1) Что такое версия признаков и почему она нужна в ML‑проектах?
- Версия признаков — это зафиксированная итерация набора признаков за конкретный момент/условие. Она нужна для воспроизводимости экспериментов, аудита изменений, контроля качества данных и корректного развёртывания в продакшн. Без версий невозможно точно повторно воспроизвести обучение или предикт на продакшне.
2) Как выбрать паттерн версионирования: имя версии vs временные слои?
- Если требуется простота и ясность, начинайте с имени версии (v1, v2). Для длительных проектов с частой эволюцией и необходимостью точной временной трассируемости подойдут временные слои (valid_from/valid_to) или версионирование таблиц. В большинстве сценариев разумно комбинировать: хранить версии признаков как отдельные таблицы (или View) и снабжать их временными метаданными.
3) Какие инструменты лучше использовать для открытого стека?
- Feast для определения и доступа к признакам, Delta Lake или Apache Iceberg для офлайн‑версий признаков, MLflow для экспериментов и моделей, Dagster или Airflow для оркестрации пайплайнов. Такой стек обеспечивает прозрачность версий, воспроизводимость и хорошую интеграцию с Lakehouse.
4) Какие риски существуют при внедрении версионирования и как их минимизировать?
Риски: рост числа версий, сложность поддержки, дороговизна хранения, регуляторные требования. Минимизировать можно через:
- четко регламентированные правила именования и управления версиями;
- автоматическое тестирование и регрессионное тестирование;
- контроль доступа и аудит;
- политики архивации и очистки устаревших версий;
- мониторинг метрик качества и вовремя откаты.
5) Как версионирование помогает в локализации данных и соблюдении регуляторных требований в России?
- Версии позволяют хранить историю использования признаков и обеспечить возможность аудита. При локализации данных можно держать данные и признаки в локальном дата‑центре с отдельными версиями и ограниченным доступом, соблюдая требования ФЗ‑152 и регуляторные нормы. Аудиторские метаданные и контроль доступа поддерживают соответствие.
6) Примером какого Russian‑ориентированного стека можно воспользоваться?
- Пример российской практики: локальные схемы с ClickHouse в качестве офлайн‑хранилища признаков, онлайн‑кэш на Redis, оркестрация через Airflow или Dagster, артефакты и эксперименты — через MLflow/DVC. Для отечественных проектов это часто наиболее доступный и безопасный путь, который можно расширять за счет интеграции с отечественными платформами (для управления экспериментами и данными) в зависимости от инфраструктуры компании.
7) Как связать версию признаков с версией пайплайна?
- Связь можно реализовать через Git‑определение пайплайнов и явное указание версии признаков в каждом эксперименте. В MLflow/Dork проектах можно сохранять зависимость между версиями признаков и параметрами пайплайна в экспериентах, чтобы воспроизвести обучающие повторения и сравнения.
8) Как обеспечить тестирование новых версий признаков?
- Автоматические тесты на корректность данных (валидаторы схемы, проверки дрифта), тестирование на подвыборках, регрессионные тесты на метриках модели, а также A/B‑модельные эксперименты. Важно иметь сигнатуры тестов, которые запускаются при каждом выпуске новой версии.
9) Какие критерии выбора хранилища признаков (offline vs online)?
- Offline‑хранилище — исторические версии и наборы признаков; онлайн‑хранилище — доступ в реальном времени для моделей продакшна. Выбор зависит от latency требований, бюджета и сложности консистентности. Для задач с низкой задержкой предпочтение онлайн‑_STORE — Redis/kv‑хранилища; для сложной аналитики и версионирования — офлайн‑хранилище с поддержкой версий (Delta Lake, Iceberg).
10) Какие преимущества дают российские решения в контексте версионирования признаков?
- Локальная инфраструктура, снижение задержек доступа к данным, соответствие локальным нормам и требованиям к безопасной обработке персональных данных, потенциал интеграции с отечественными платформами и сервисами. Это особенно ценно для крупных российских организаций, банков и госкомпаний, где вопросы приватности и локализации играют критическую роль.
Если вы рассматриваете переход к архитектуре Lakehouse, мы поможем оценить текущую data-инфраструктуру, спроектировать целевую архитектуру и подготовить поэтапный план внедрения. Узнайте больше о Lakehouse.


